목차
언어 AI: 단어의 개수에서 다음 토큰 생성까지
“I deposited money at the bank”와 “I sat on the bank of the river”를 컴퓨터에 주면 두 bank를 어떻게 구별할까? 문자열을 그대로 비교하면 같은 철자라는 정보밖에 없다. 언어 AI는 텍스트를 수치로 바꾸고, 그 수치 사이의 관계를 학습하면서 이 문제를 풀어 왔다. 여기서는 단어 빈도 → 단어 임베딩 → 문맥을 반영한 표현 → 토큰 생성 순서로 살펴본다. 각 방법은 앞선 방법이 놓친 정보를 다루기 위해 등장했다.
1. BoW로 언어 표현
BoW(bag-of-words)는 텍스트를 벡터로 바꾸는 출발점으로 이해하면 좋다. BoW 자체가 다음 단어의 확률을 예측하는 언어 모델은 아니다. 문서에 어떤 단어가 몇 번 나왔는지를 세어서 분류·검색 모델에 넣을 특성을 만든다.
작동방식
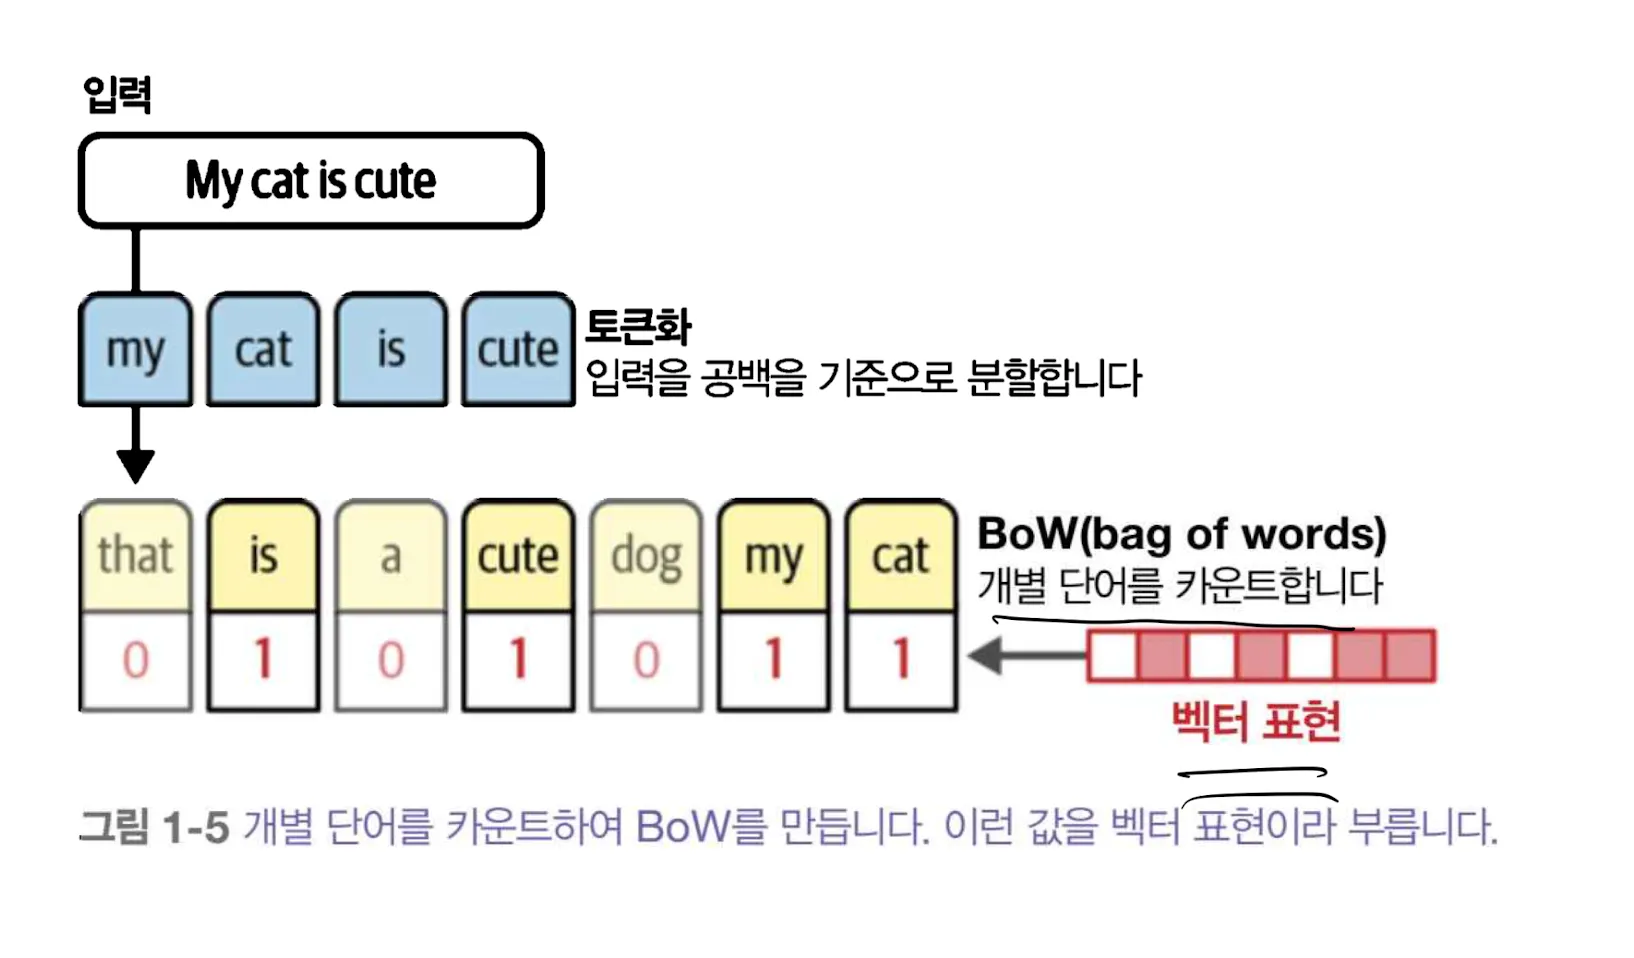
예를 들어 “고양이가 잔다”와 “개가 잔다”를 같은 규칙으로 토큰화하고 어휘를 [고양이가, 개가, 잔다]로 정하면 각각 [1, 0, 1], [0, 1, 1]이 된다. 벡터의 같은 위치가 항상 같은 단어를 가리키므로 분류기에 넣기 쉽다. 그러나 어휘가 커질수록 대부분의 칸은 0이 되고, 같은 의미를 다른 말로 썼을 때 두 문장이 멀어질 수 있다.
-
BoW 모델의 첫 단계 : 문장을 개별 단어 또는 부분 단어(subword)(토큰token)로 분할하는 과정인 토큰화(Tokenization)
-
간단한 기준은 공백 분할이다. 다만 한국어의 조사나 띄어쓰기 변형, 공백 없이 쓰는 언어를 처리할 때는 형태소 또는 부분 단어 단위가 필요할 수 있다. 아래 그림은 교육용으로 단순화한 토큰화 과정이다.
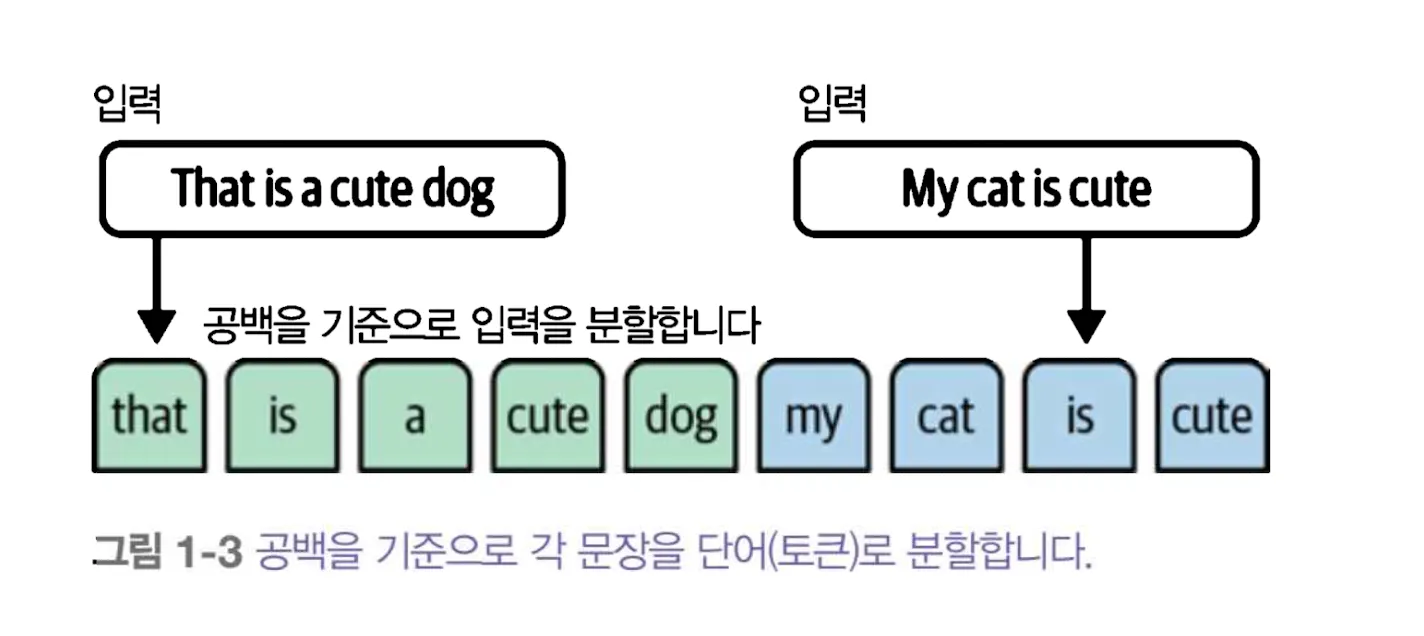
토큰화를 한 다음 각 문장의 고유한 단어를 모두 합쳐 어휘사전(vocabulary)를 생성하여 문장을 표현
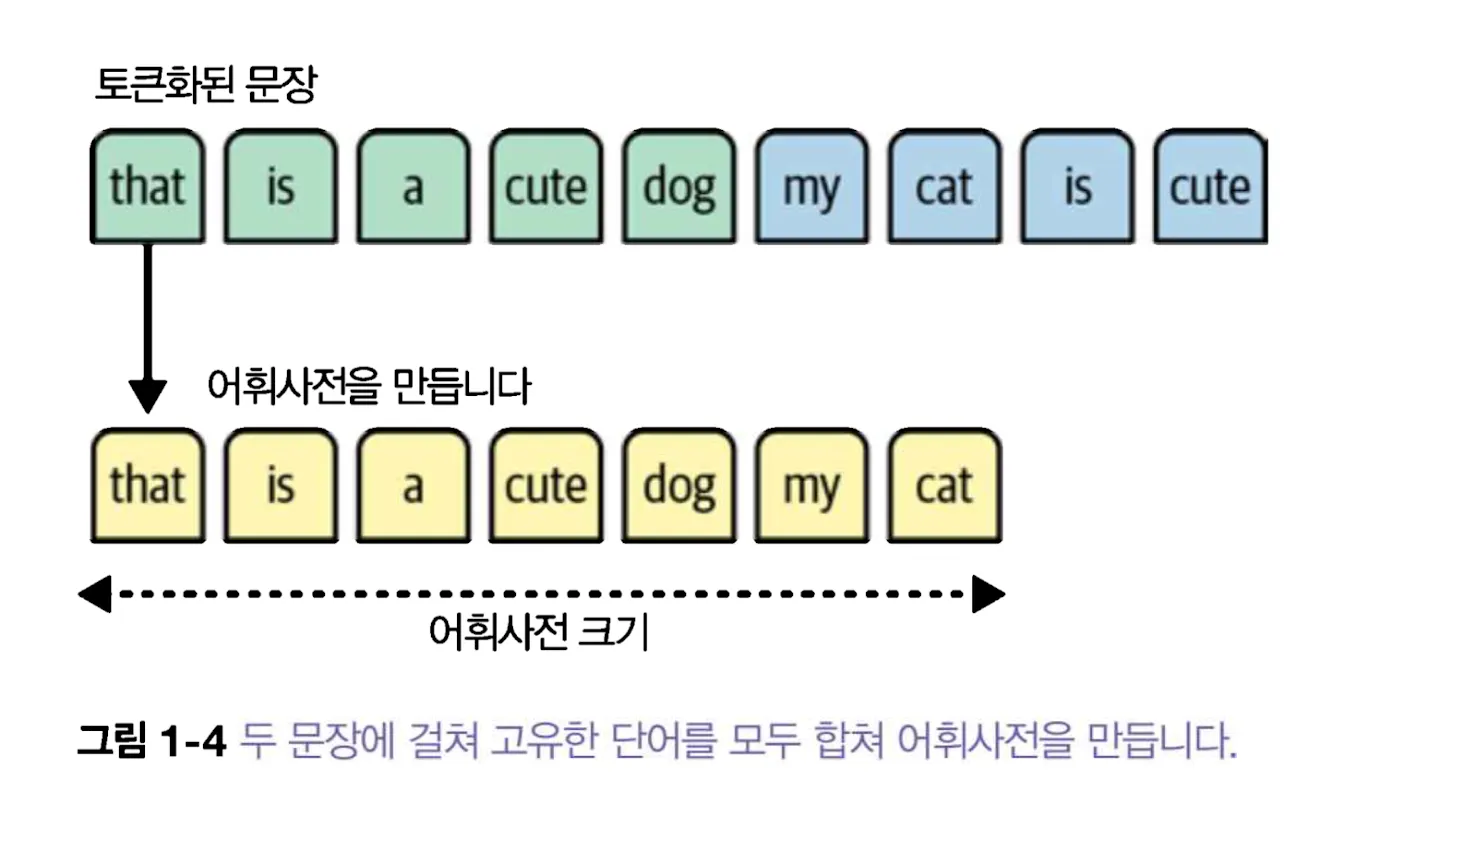
어휘사전의 각 칸에 등장 횟수를 적으면 BoW 벡터가 된다. “개가 고양이를 쫓는다”와 “고양이가 개를 쫓는다”는 토큰화 방법에 따라 거의 같은 빈도 벡터가 될 수 있다. 단어의 순서와 문맥을 버리는 것이 핵심 한계다. 빈도가 중요한 스팸 분류나 문서 검색의 기준선으로는 여전히 쓸모가 있지만, 누가 누구를 쫓았는지를 읽으려면 다른 표현이 필요하다.
단어가 같은 문서에 자주 등장한다는 정보는 담지만, 같은 뜻의 다른 단어나 다의어의 문맥까지 직접 표현하지 못한다.
2. 밀집 벡터 임베딩으로 더 나은 표현 생성
word2vec은 단어를 수백 차원의 밀집 벡터로 학습한다. BoW에서 어휘마다 한 칸을 마련했다면 여기서는 단어마다 같은 길이의 작은 벡터를 부여한다. 자주 비슷한 문맥에 등장하는 단어가 학습 과정에서 관련된 표현을 갖게 된다.
임베딩은 모델이 학습한 수치 표현이다. 좌표 하나가 ‘왕족 여부’처럼 사람이 붙인 고정된 뜻을 가지는 것은 아니다. 벡터 전체의 상대적 위치와 방향이 유사도를 판단하는 단서가 된다.
word2vec의 대표적인 학습 방식은 CBOW와 Skip-gram이다. CBOW는 주변 단어들에서 가운데 단어를, Skip-gram은 가운데 단어에서 주변 단어를 예측한다. 예를 들어 “고양이가 소파에서 잔다”에서 소파에서 주변의 고양이가, 잔다를 맞히도록 조정하는 식이다. 예측 오차를 줄이는 동안 가중치가 바뀌며 단어 임베딩도 갱신된다. 이 가중치를 모델의 파라미터라고 부른다.
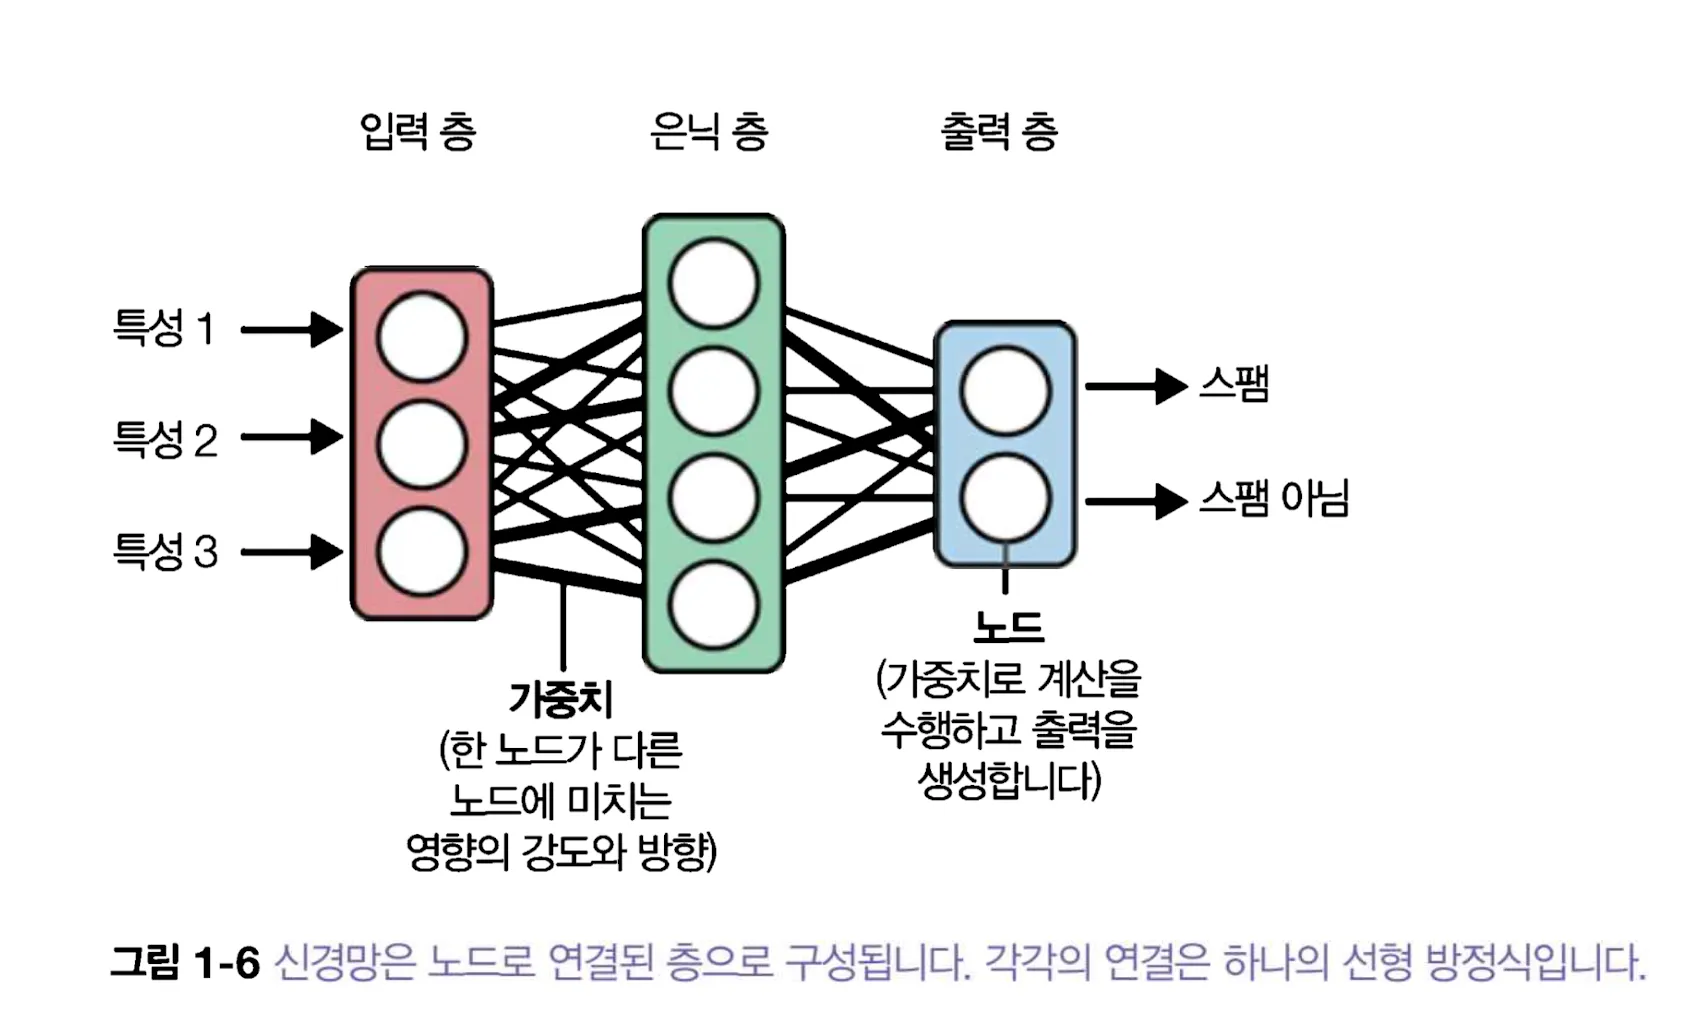
따라서 word2vec은 일반적인 생성 모델처럼 문장의 다음 단어를 계속 생성하는 모델이 아니다. 주변 단어를 예측하는 학습 문제를 풀고 그 결과로 단어 벡터를 얻는다.
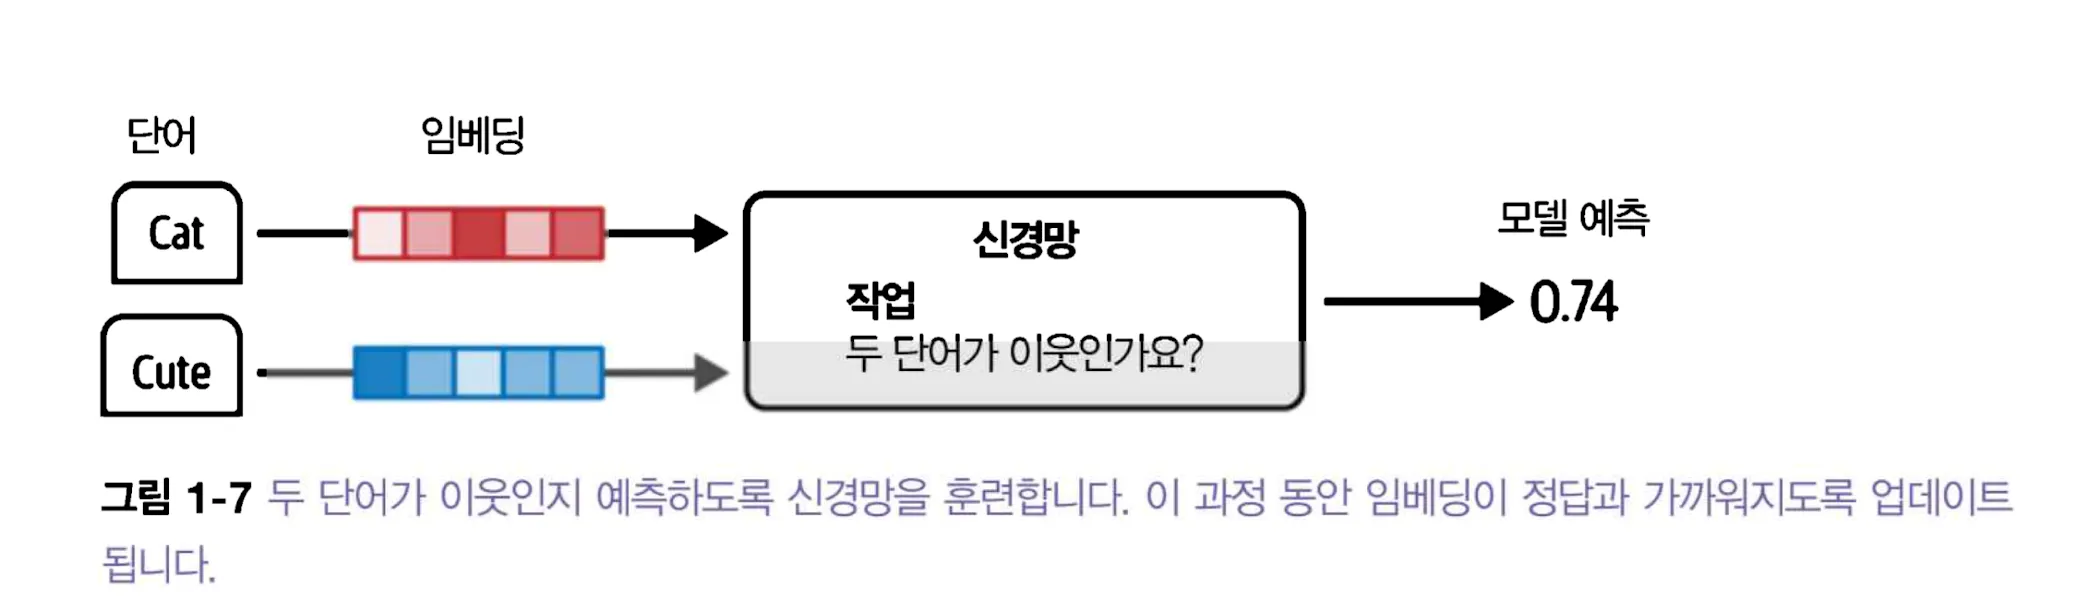
벡터 길이는 학습 설정으로 정한다. 차원을 늘리면 더 복잡한 관계를 표현할 여지가 있지만 메모리와 계산량도 늘어난다. 아래 그림의 개별 축은 이해를 돕는 비유이며 실제 학습된 차원마다 사람이 읽을 수 있는 속성이 대응하지는 않는다.
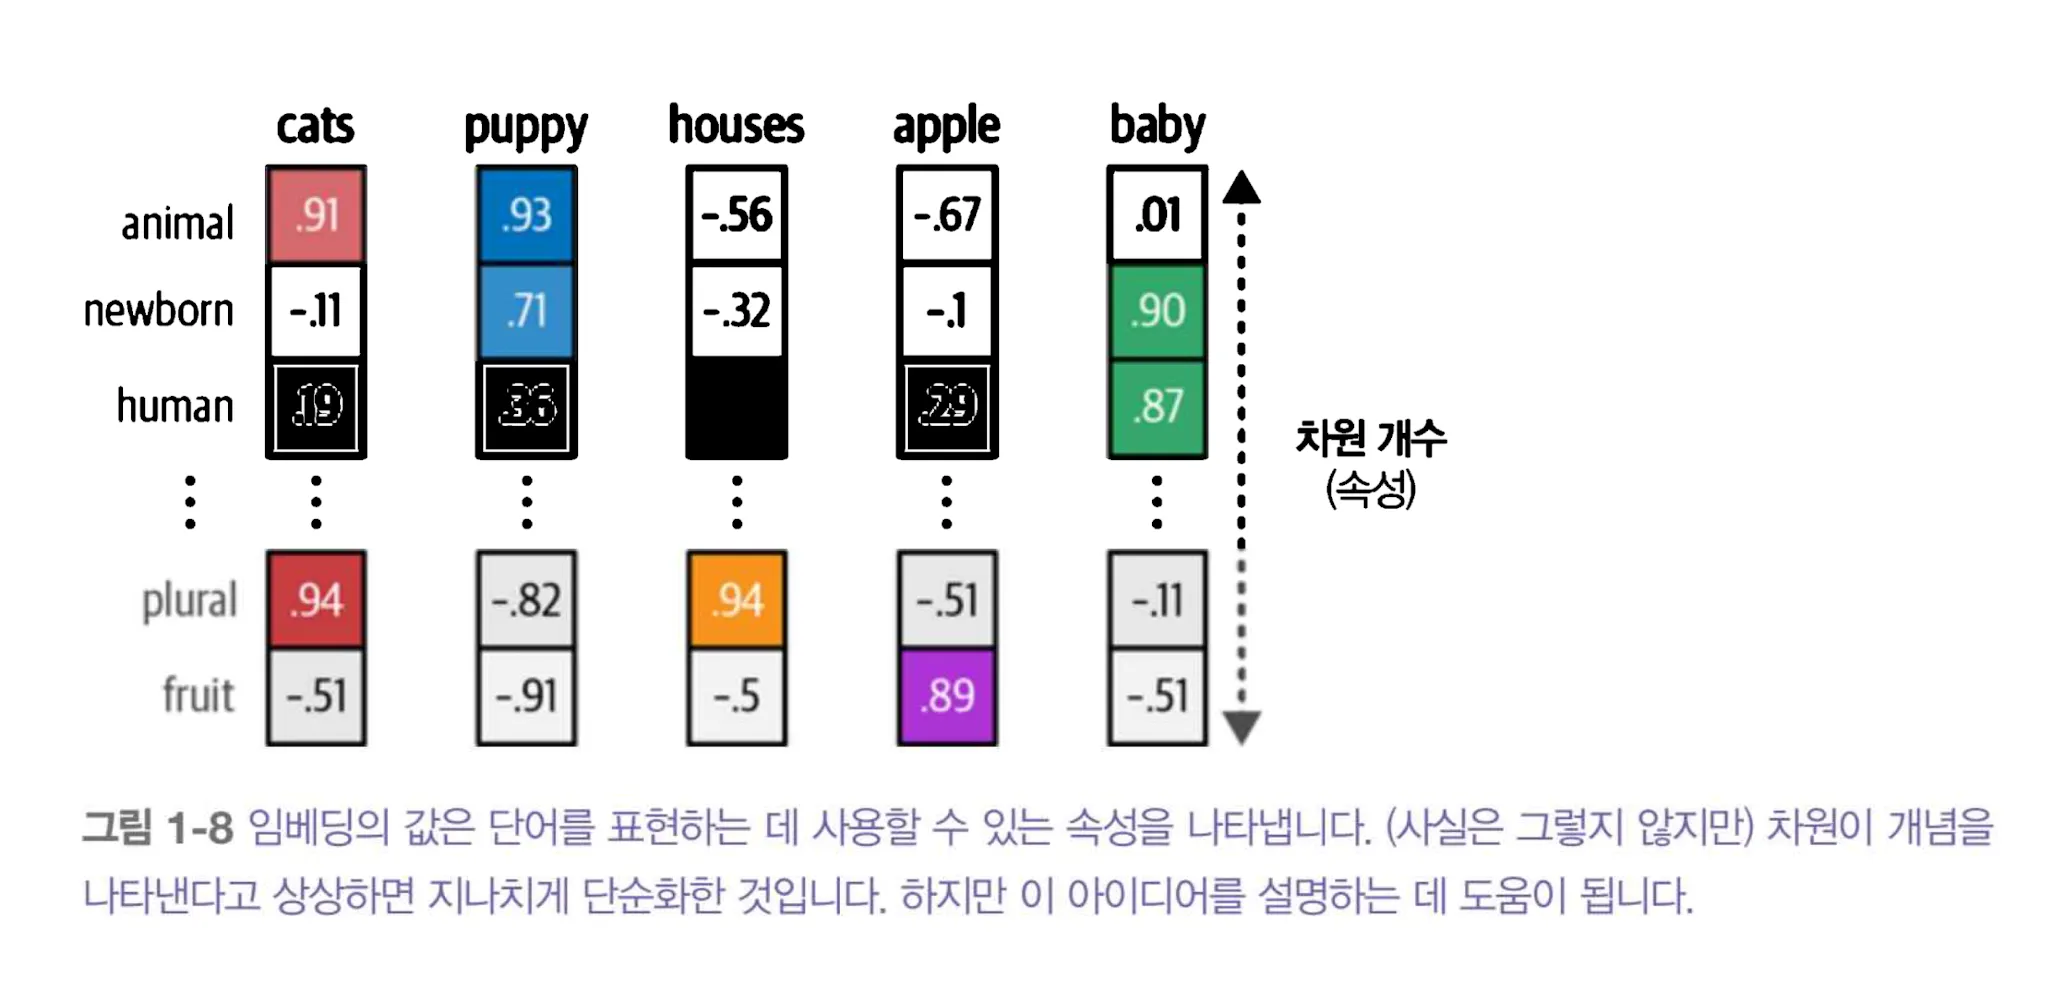
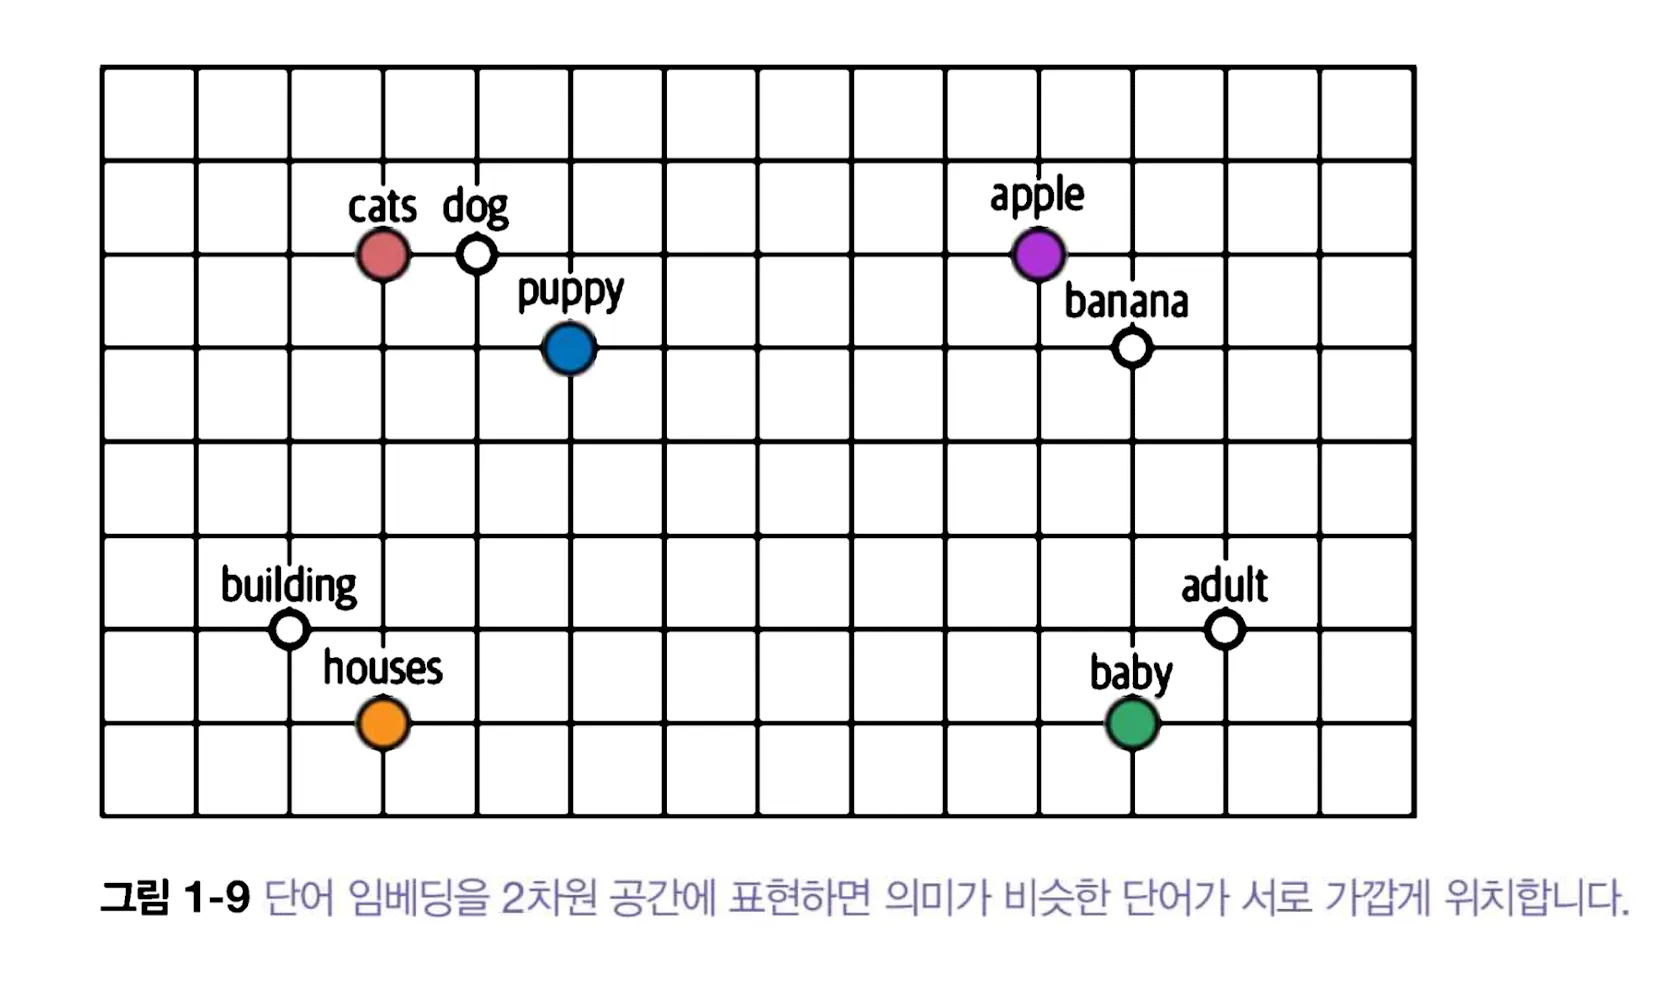
임베딩은 단어 사이에 있는 유사성을 측정할 수 있으므로, 다양한 거리 측정 방법을 사용해 한 단어가 다른 단어와 얼마나 가까운지 판단 가능.
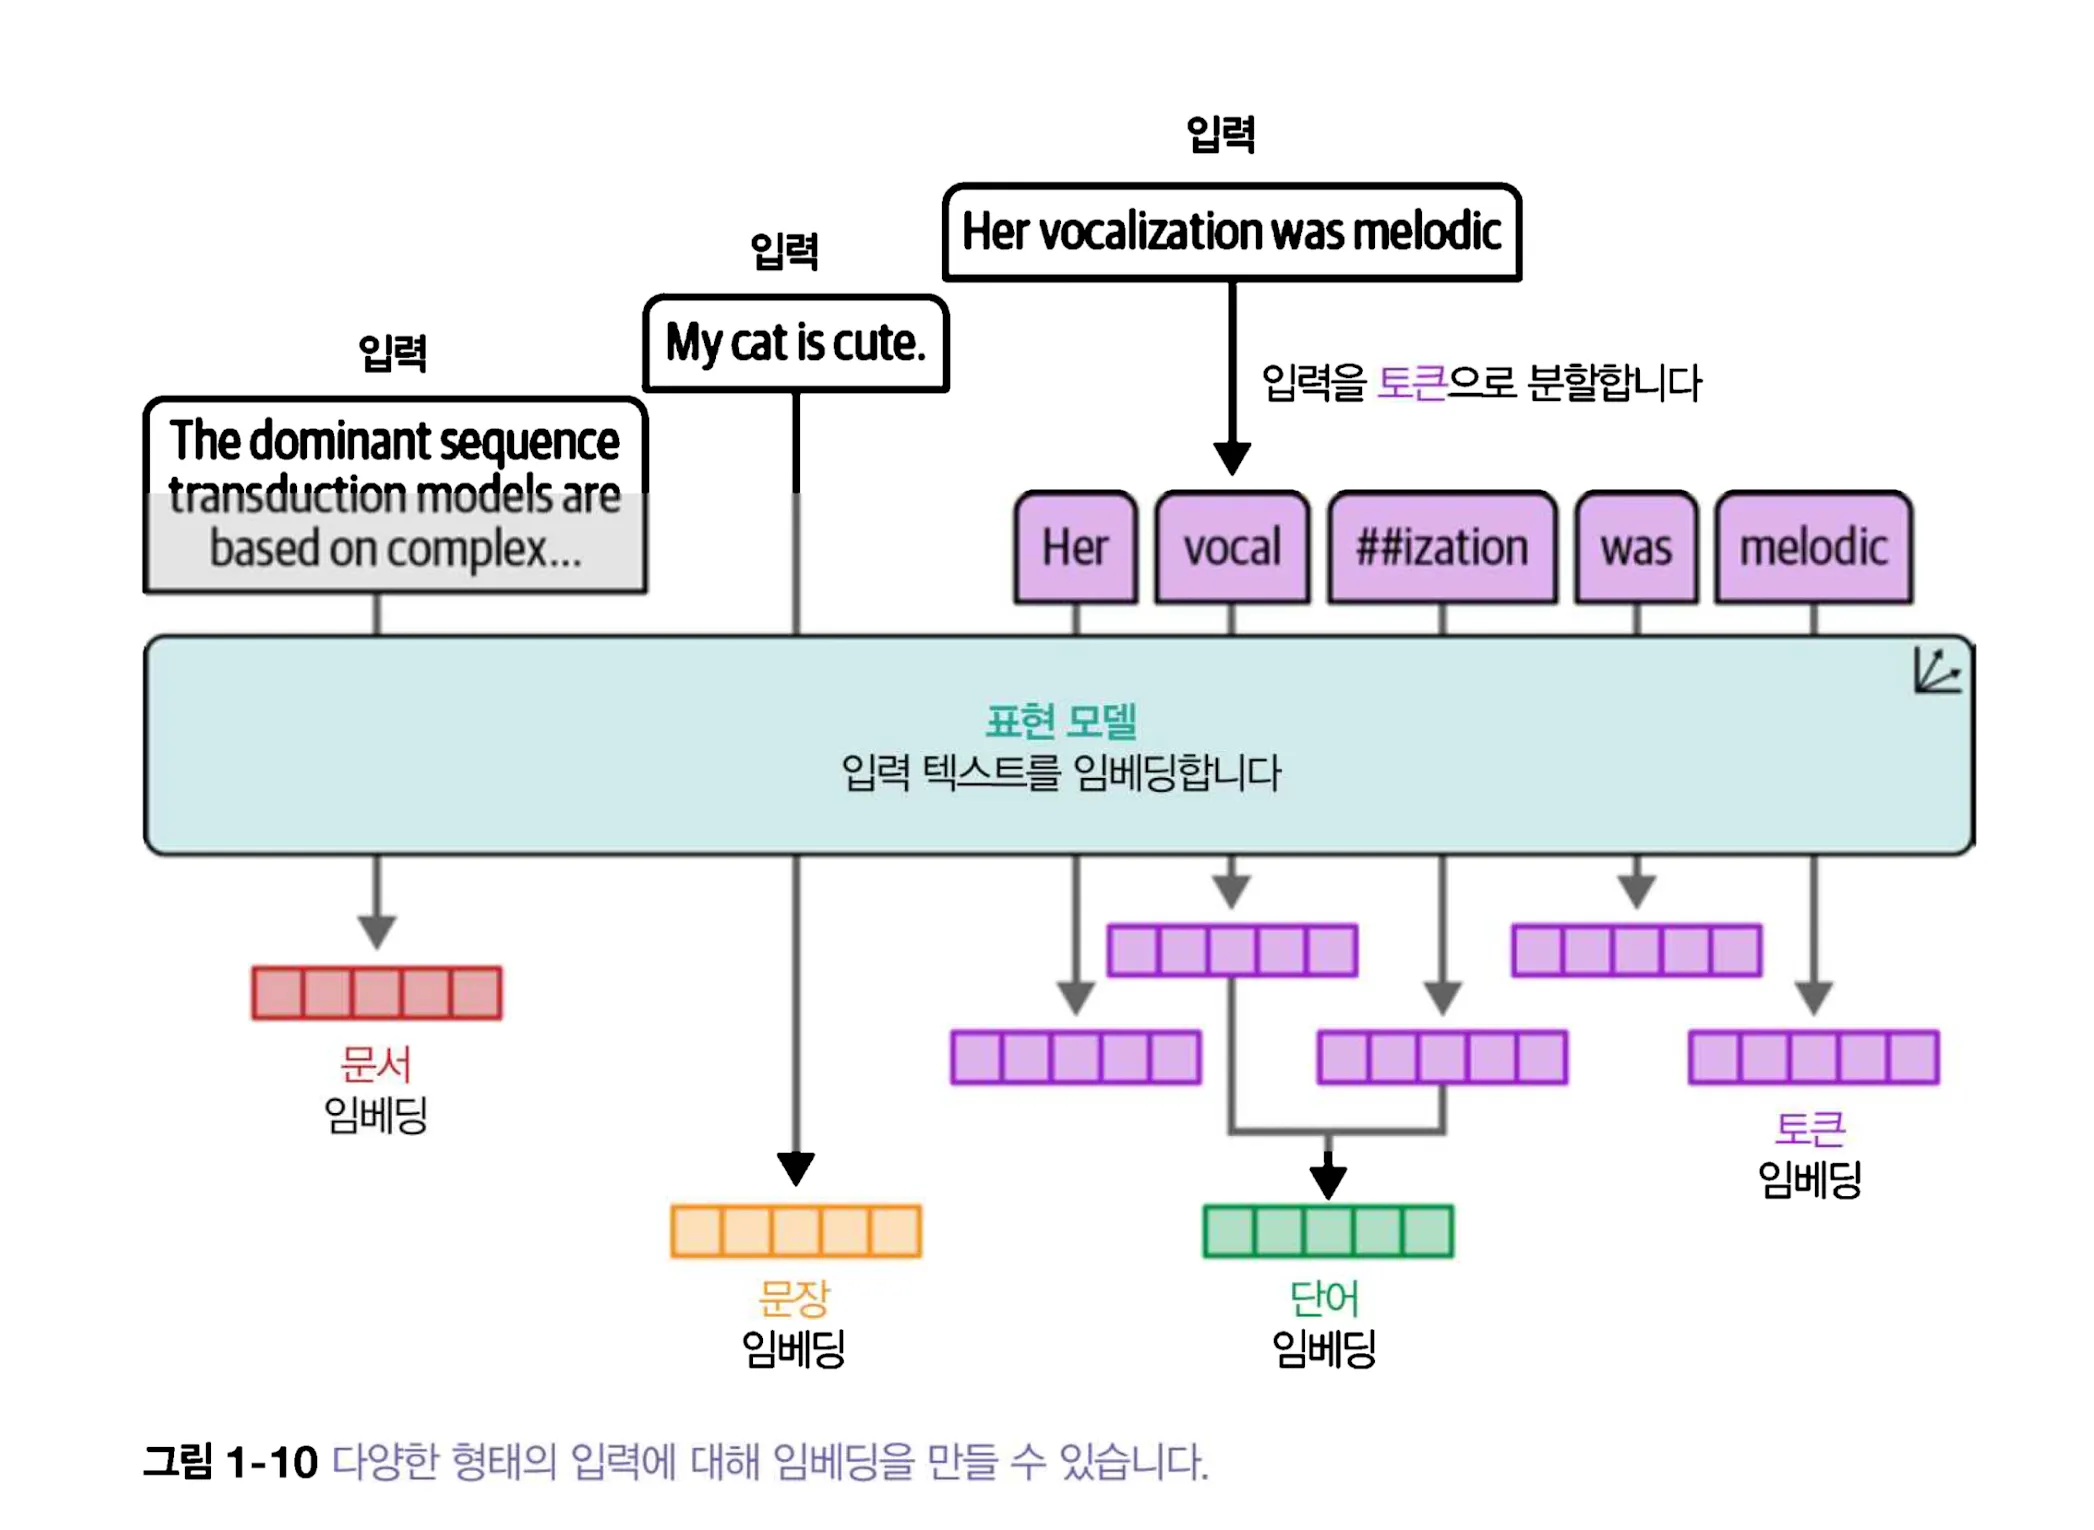
표현의 단위도 구별해야 한다. BoW는 문서 전체를 희소 빈도 벡터로, word2vec은 개별 단어를 정적 밀집 벡터로 표현한다. 문장 임베딩은 문장 전체를 하나의 벡터로 만드는 별도의 방법이다. 같은 ‘벡터’라도 무엇을 한 점으로 표현하는지 먼저 확인해야 검색과 분류 결과를 해석할 수 있다.
3. 어텐션을 사용한 문맥 인코딩과 디코딩
문장을 벡터 하나로 압축한 다음 다른 문장으로 풀어내는 인코더-디코더 구조를 생각해 보자. 번역에서는 인코더가 원문을 읽고 디코더가 번역문을 순서대로 생성한다. 이와 같은 입력 시퀀스를 출력 시퀀스로 바꾸는 작업을 Seq2Seq라고 한다. 번역, 요약, 문법 교정에 쓰인다. T5와 MarianMT는 이런 구조의 모델이며, 뒤에서 살펴볼 BERT는 인코더만 사용하는 다른 계열이다.
word2vec으로 학습한 bank 벡터는 은행 문장과 강둑 문장에서 같다. 이 정적 표현만으로는 어느 뜻인지 구별하기 어렵다. 단어의 표현을 해당 문장 안에서 다시 계산해야 한다.
초기의 Seq2Seq 모델은 순환 신경망(RNN)을 많이 사용했다. RNN 인코더는 앞 단어를 읽은 상태를 다음 단어에 전달하고, 디코더도 이미 출력한 단어와 상태를 사용해 다음 단어를 만든다. 정적 단어 벡터와 달리 각 위치의 은닉 상태는 앞서 읽은 문맥을 반영한다.
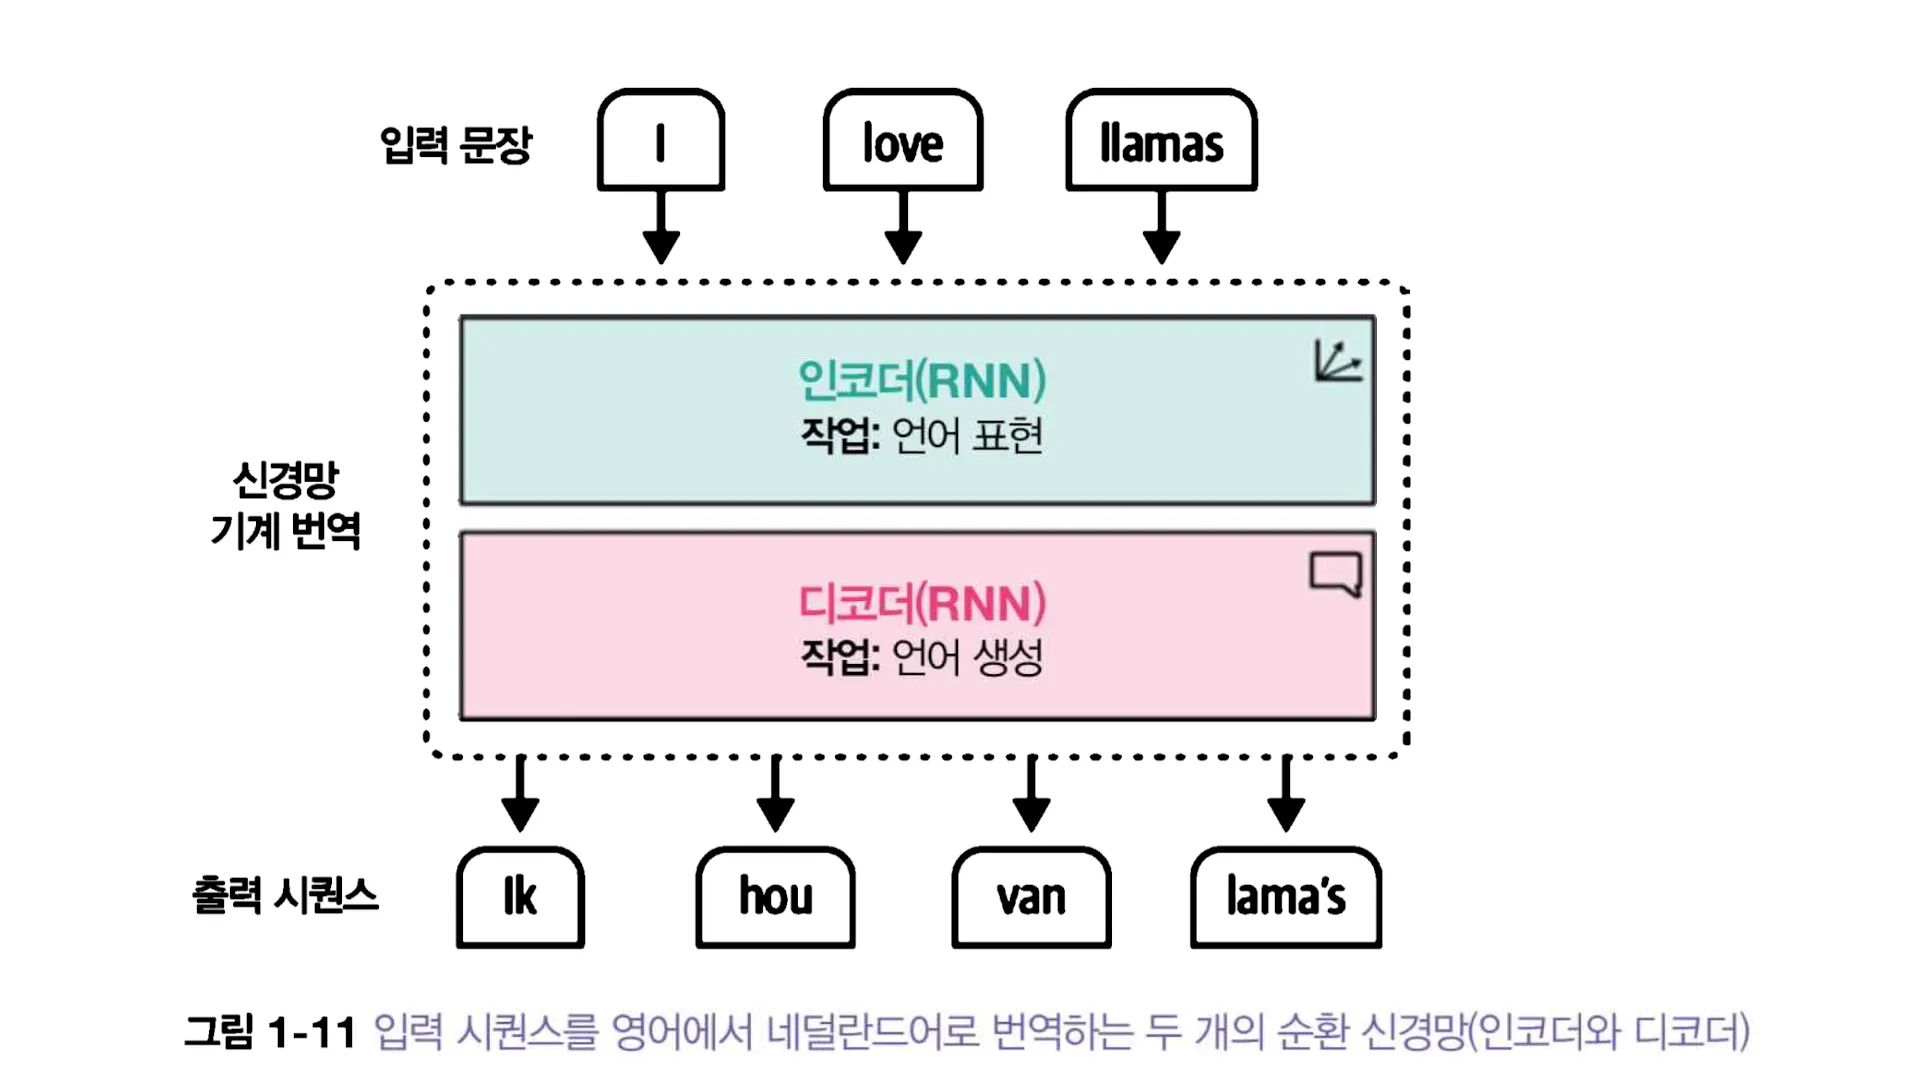
디코더의 생성은 자기회귀적(autoregressive)이다. 이전에 생성한 출력을 조건으로 다음 출력을 고른다. 인코더가 입력을 순서대로 읽는 과정과 디코더가 출력을 자기회귀적으로 만드는 과정은 구분해야 한다.
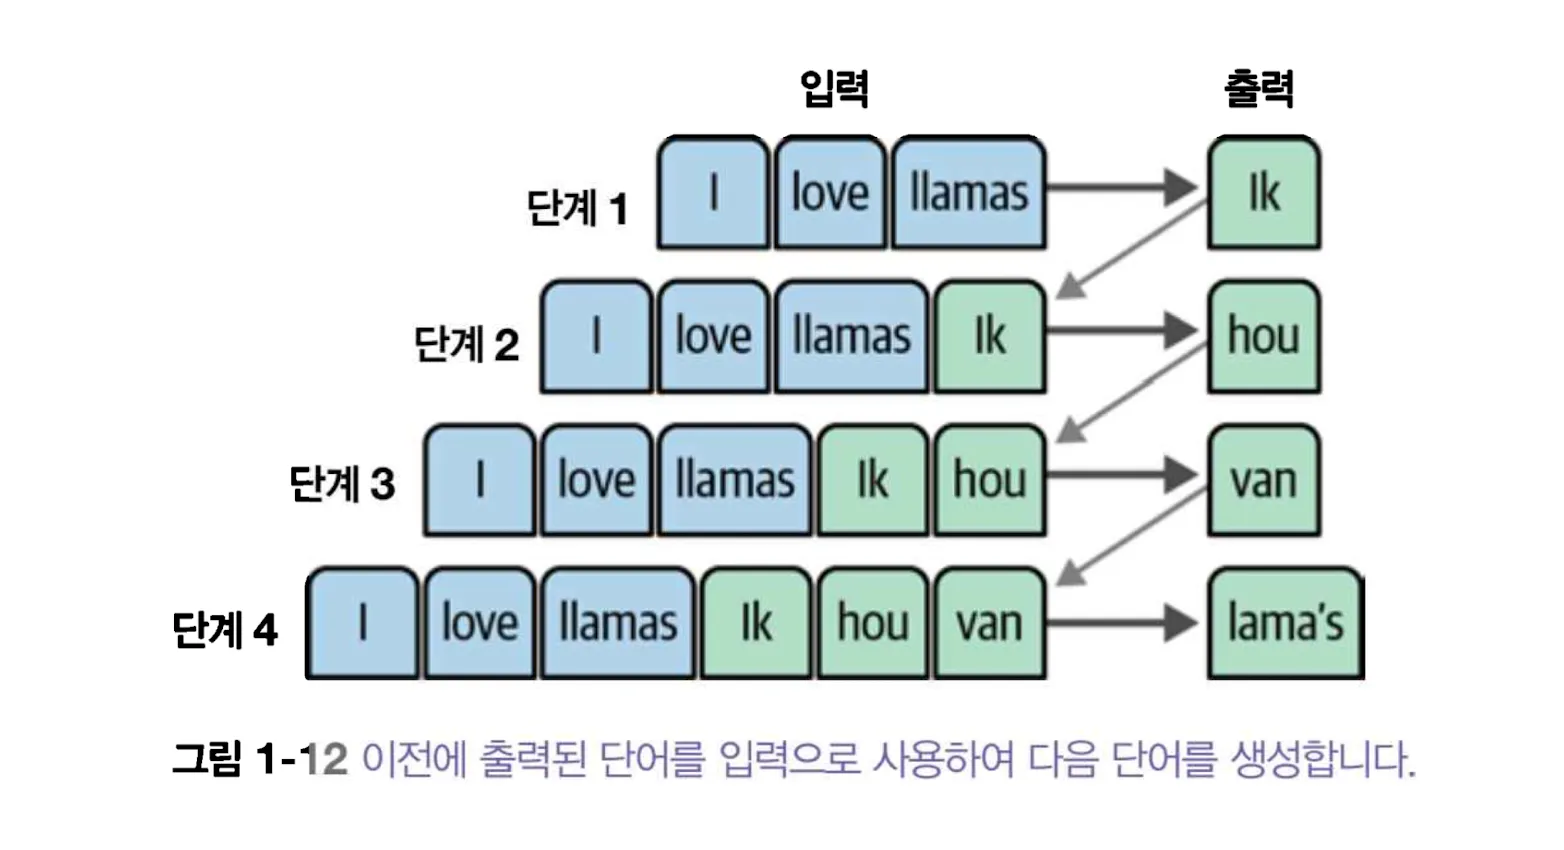
인코딩 단계의 목표는 입력을 가능한 잘 표현하여 디코더의 입력으로 사용되는 임베딩의 형태로 문맥을 생성
입력 및 출력은 한 번에 하나씩 순차적으로 처리
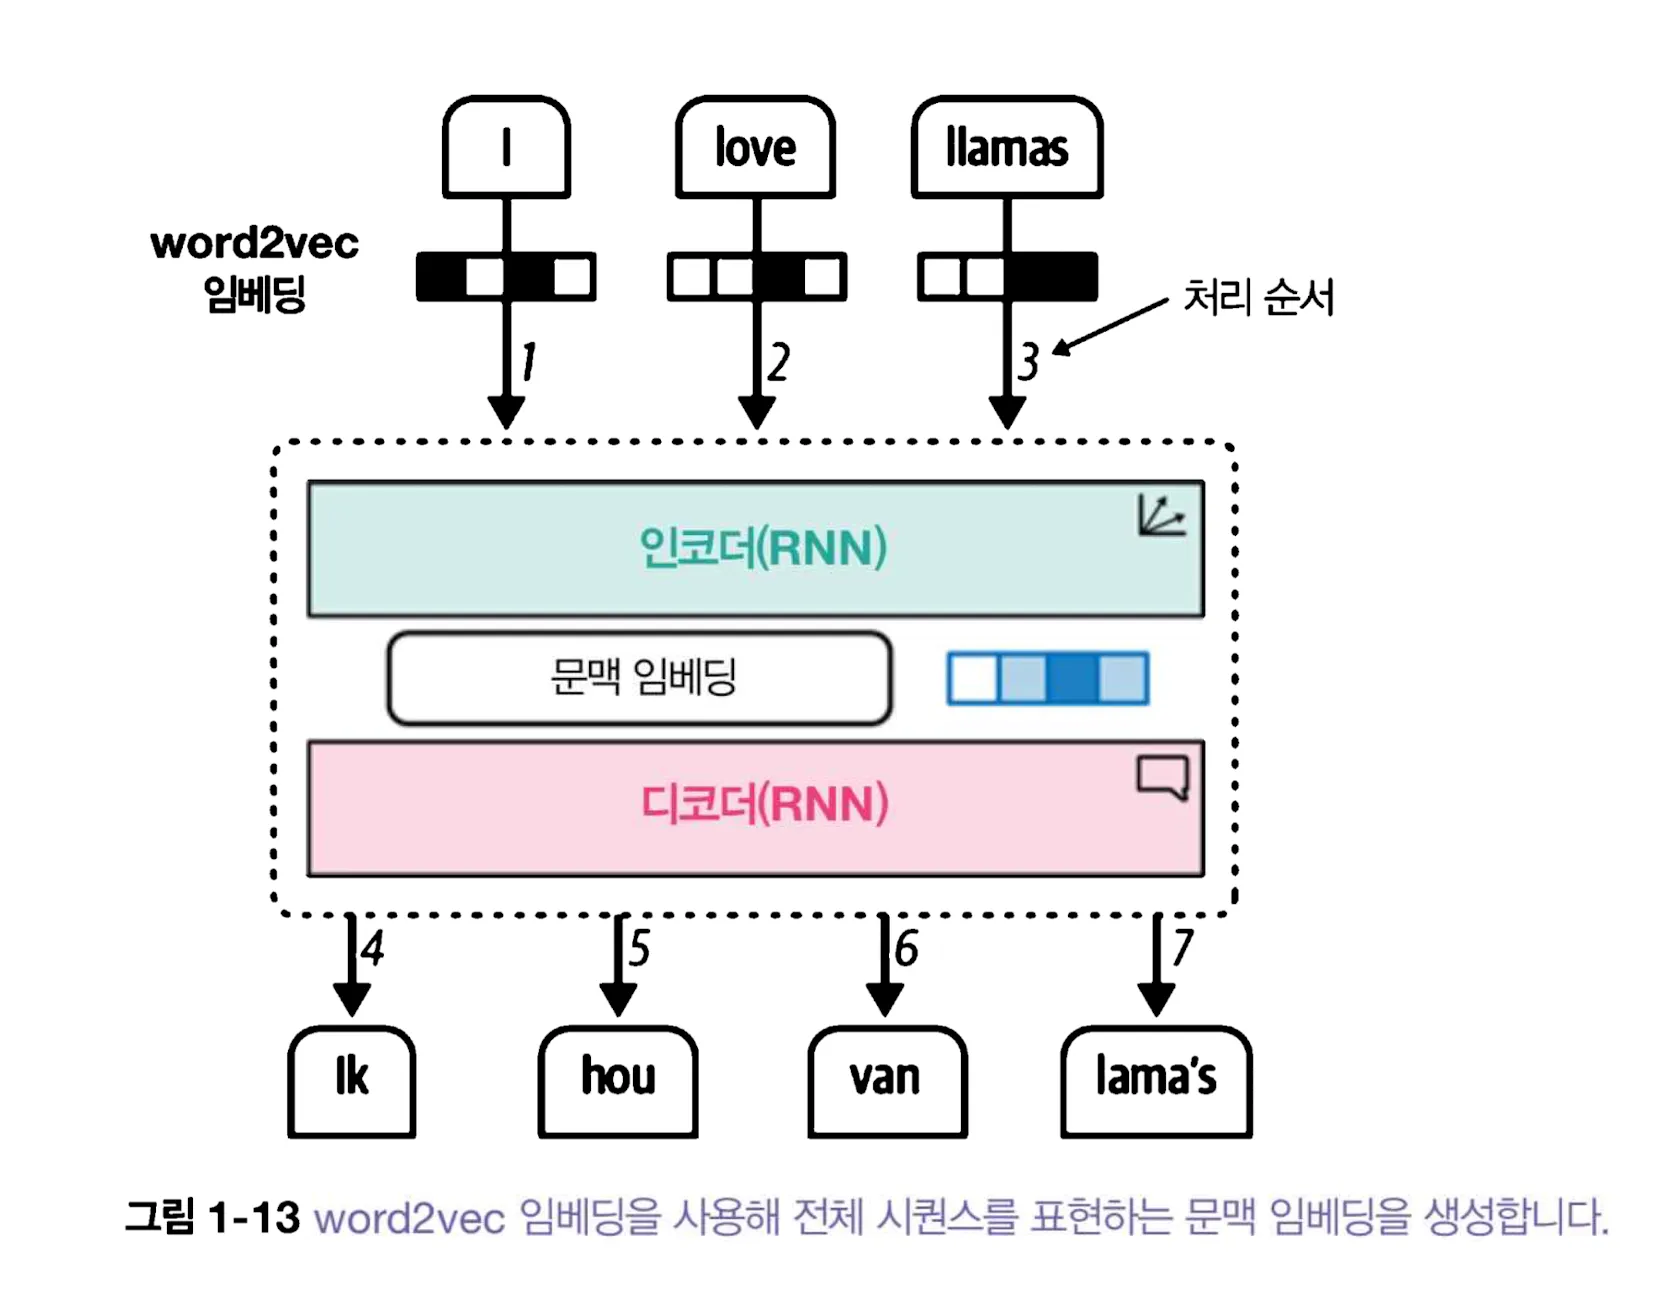
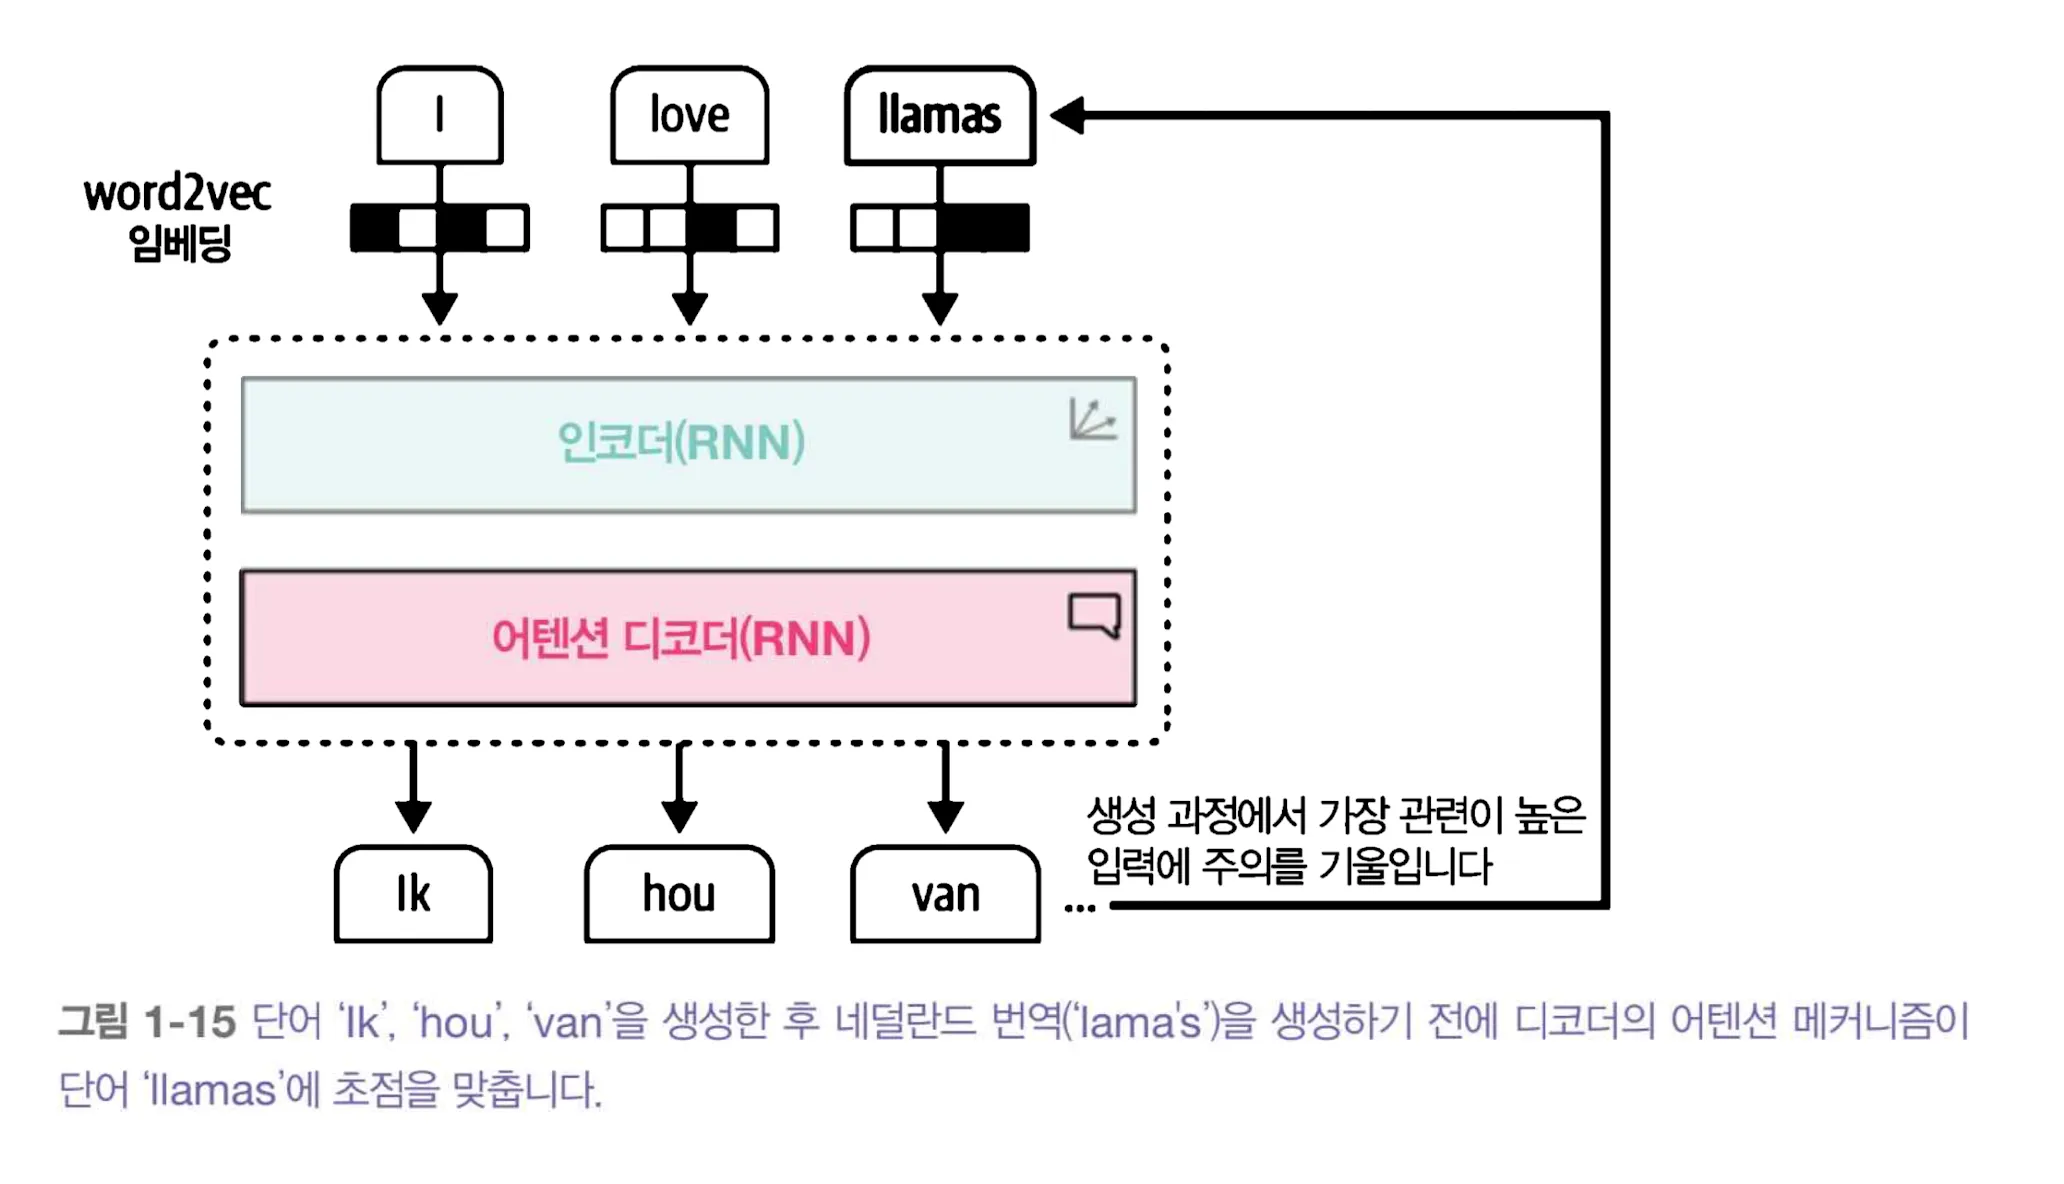
입력 전체를 마지막 은닉 상태 하나에 압축하면 긴 문장의 앞부분 정보가 출력까지 보존되기 어렵다. 어텐션(attention)은 디코더가 출력 위치마다 인코더의 여러 은닉 상태를 다시 참조하게 만든다. 번역문에서 명사를 생성할 때는 원문의 명사 쪽에, 동사를 생성할 때는 동사 쪽에 더 큰 가중치를 줄 수 있다. 가중치는 고정된 단어 중요도가 아니라 현재 출력 위치에 대한 관련도다.
아래 번역 예시 그림에서는 네덜란드어 lama’s에 대응하는 영어 llamas를 생성할 때 두 위치를 연결해 보여 준다. 같은 출력 위치에서 I 같은 다른 입력 위치는 상대적으로 낮게 반영될 수 있다. 실제 가중치는 모델과 문맥에 따라 달라진다.
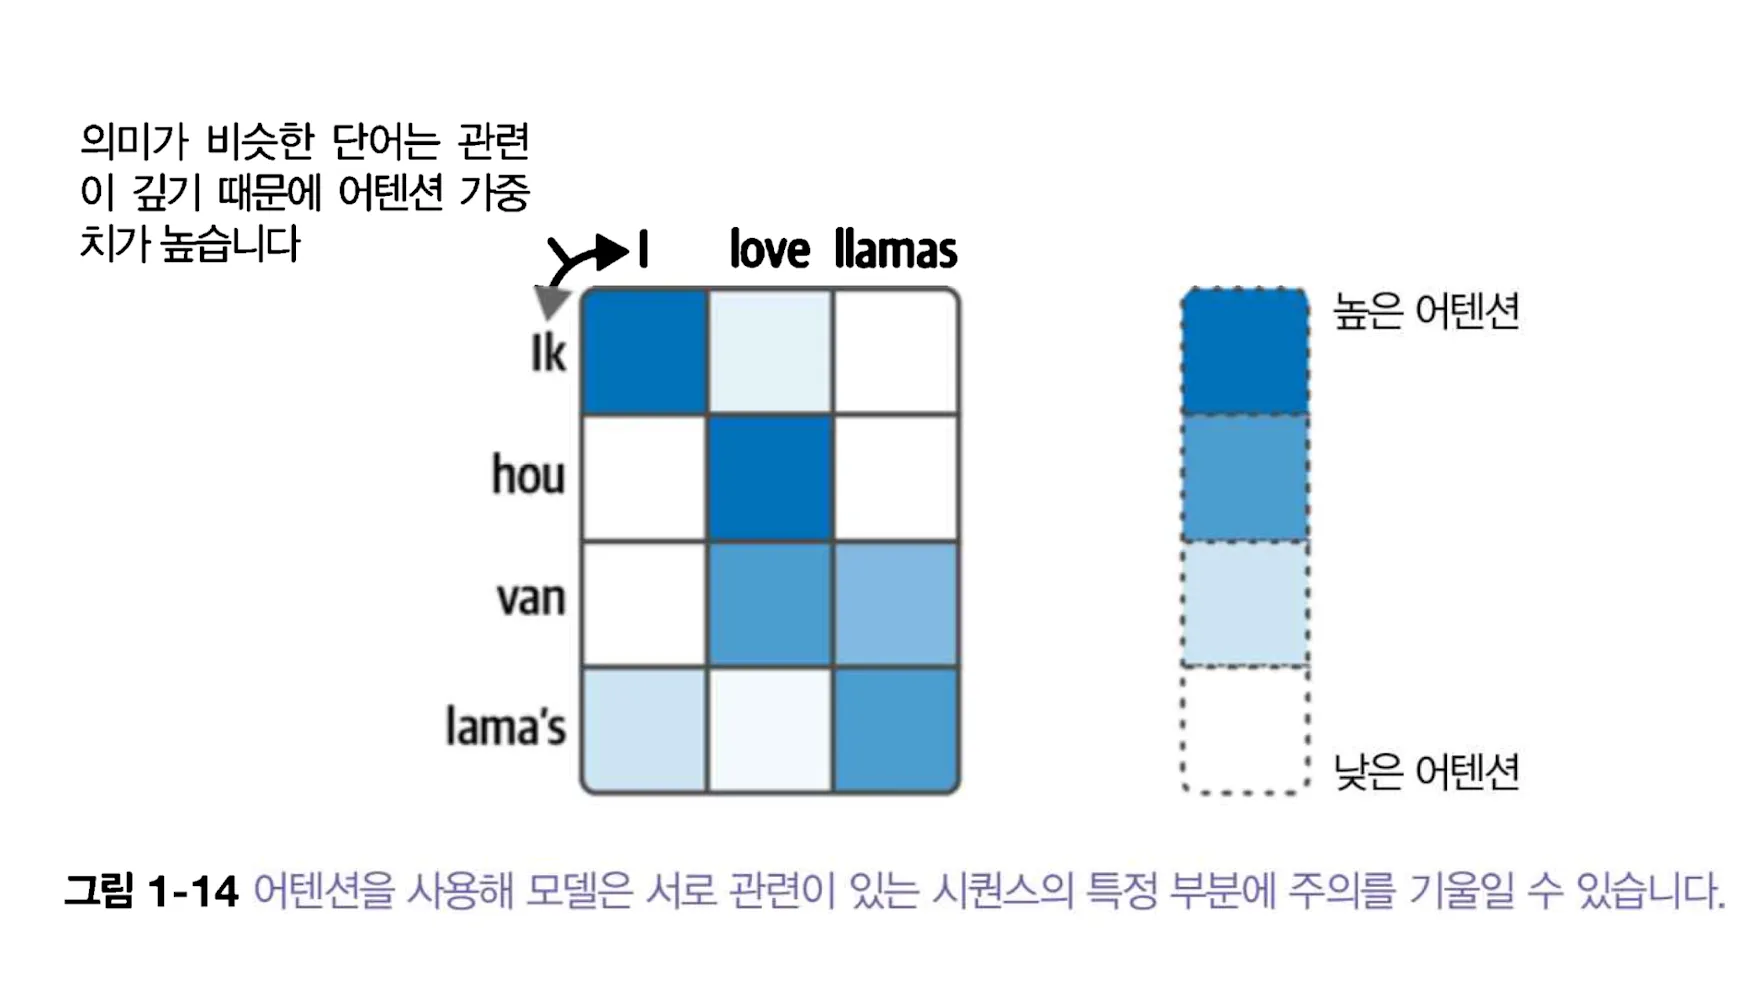
그림처럼 디코더의 한 출력 단계에서 모든 입력 위치에 점수를 매기고, 점수를 정규화한 뒤 각 위치의 정보를 가중 합산한다. 이렇게 만든 문맥 벡터가 그 시점의 단어 예측에 참여한다. 입력이 길어도 무조건 잘 번역된다는 뜻은 아니다. 입력 길이, 데이터 품질, 학습 방식에 따른 제약은 여전히 남는다.
4. Attention Is All You Need
2017년 논문 Attention Is All You Need는 순환 구조 없이 어텐션을 중심으로 한 트랜스포머를 제안했다. 원래 모델은 번역을 위한 인코더-디코더 구조였다. 여기서 나온 블록과 어텐션 방식이 이후 여러 언어 모델의 바탕이 되었다.
핵심은 순환 계산을 제거하고 어텐션·위치 정보·피드포워드 층을 조합했다는 점이다.
원본 트랜스포머의 디코더 출력은 자기회귀적으로 생성된다. 반면 인코더는 입력의 여러 위치를 함께 처리한다. 모델 전체를 단순히 ‘이전 단어만 보는 구조’로 이해하면 인코더와 디코더의 차이를 놓치게 된다.
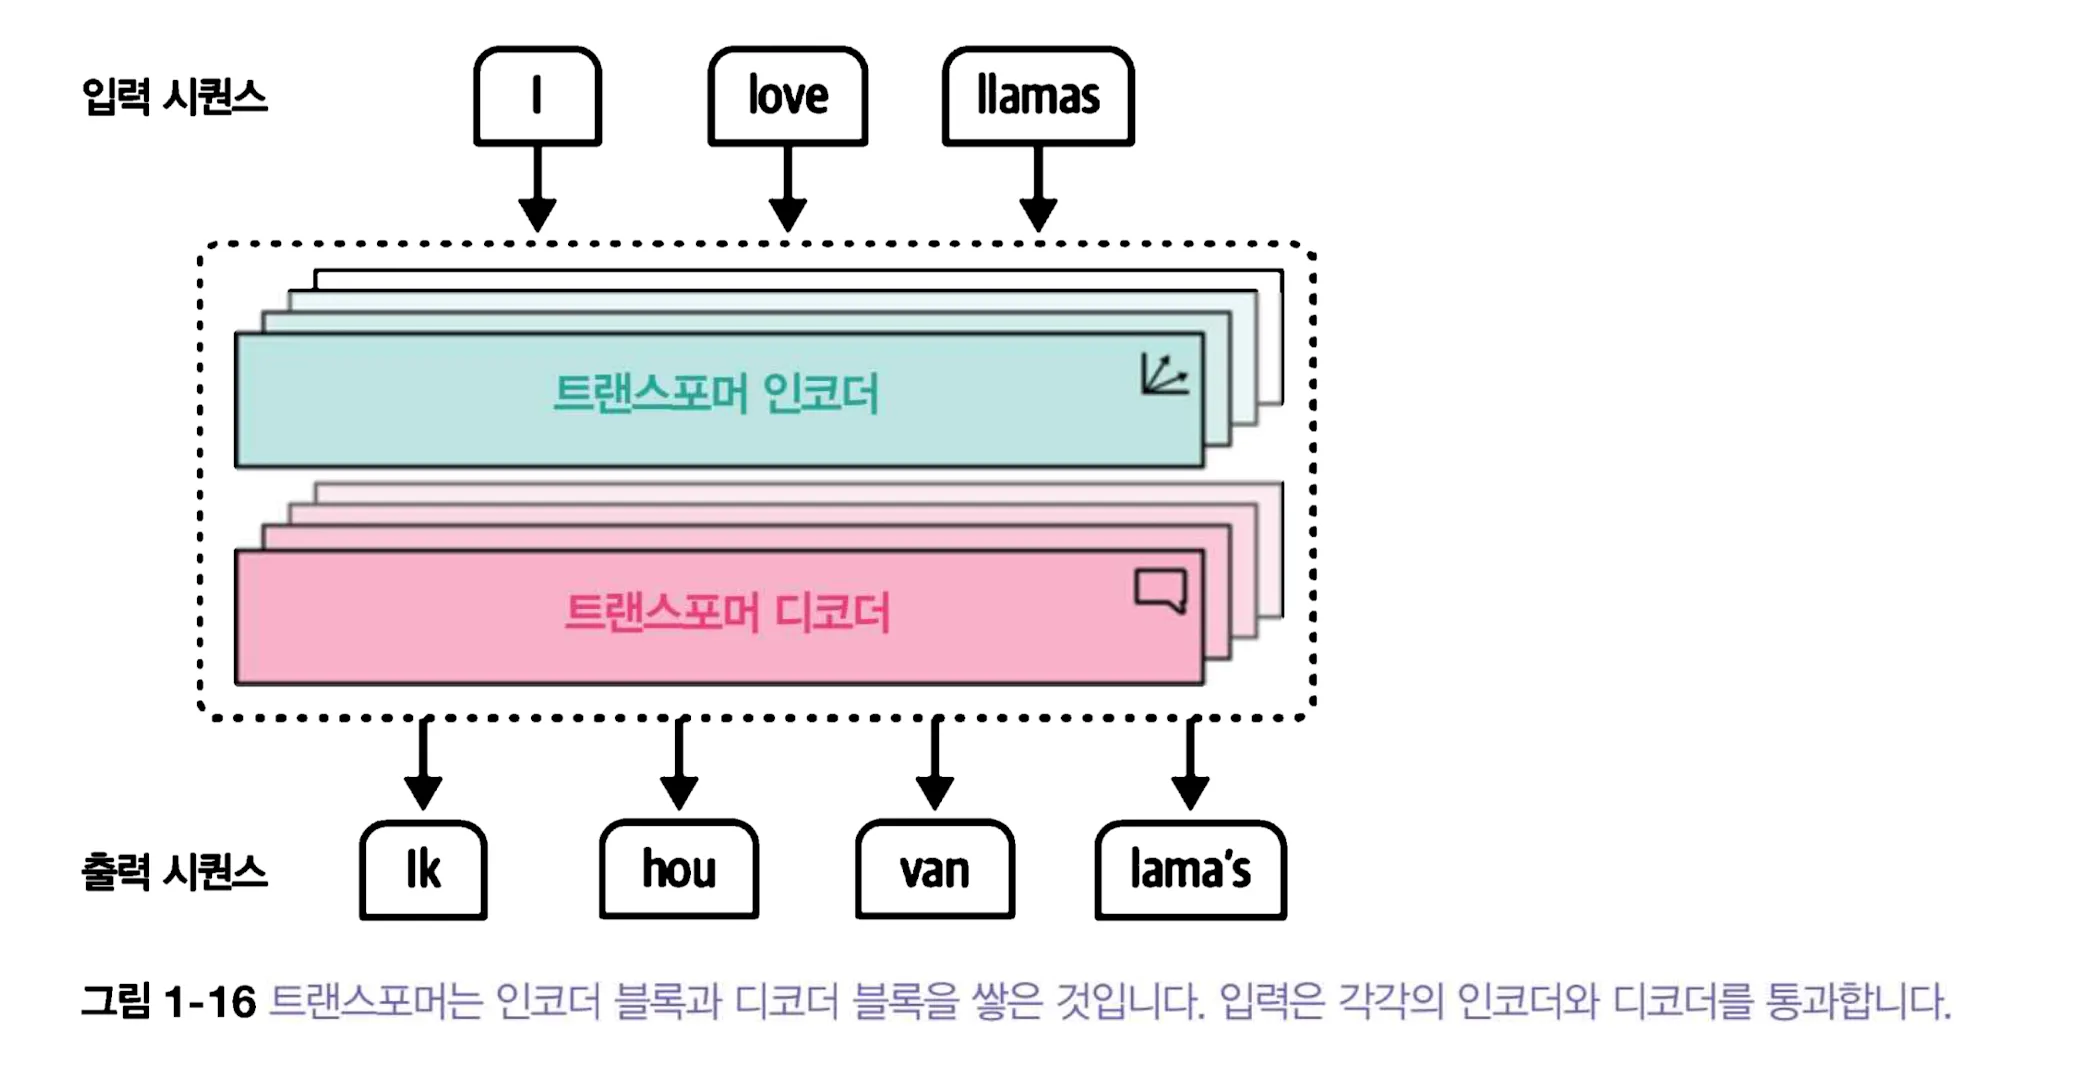
인코더와 디코더 블록은 어텐션 기능이 포함된 RNN을 활용하는 대신 어텐션을 중심으로 구동
트랜스포머의 인코더 블록은 셀프 어텐션(self-attention)과 피드포워드 신경망(feedforward neural network)로 구성
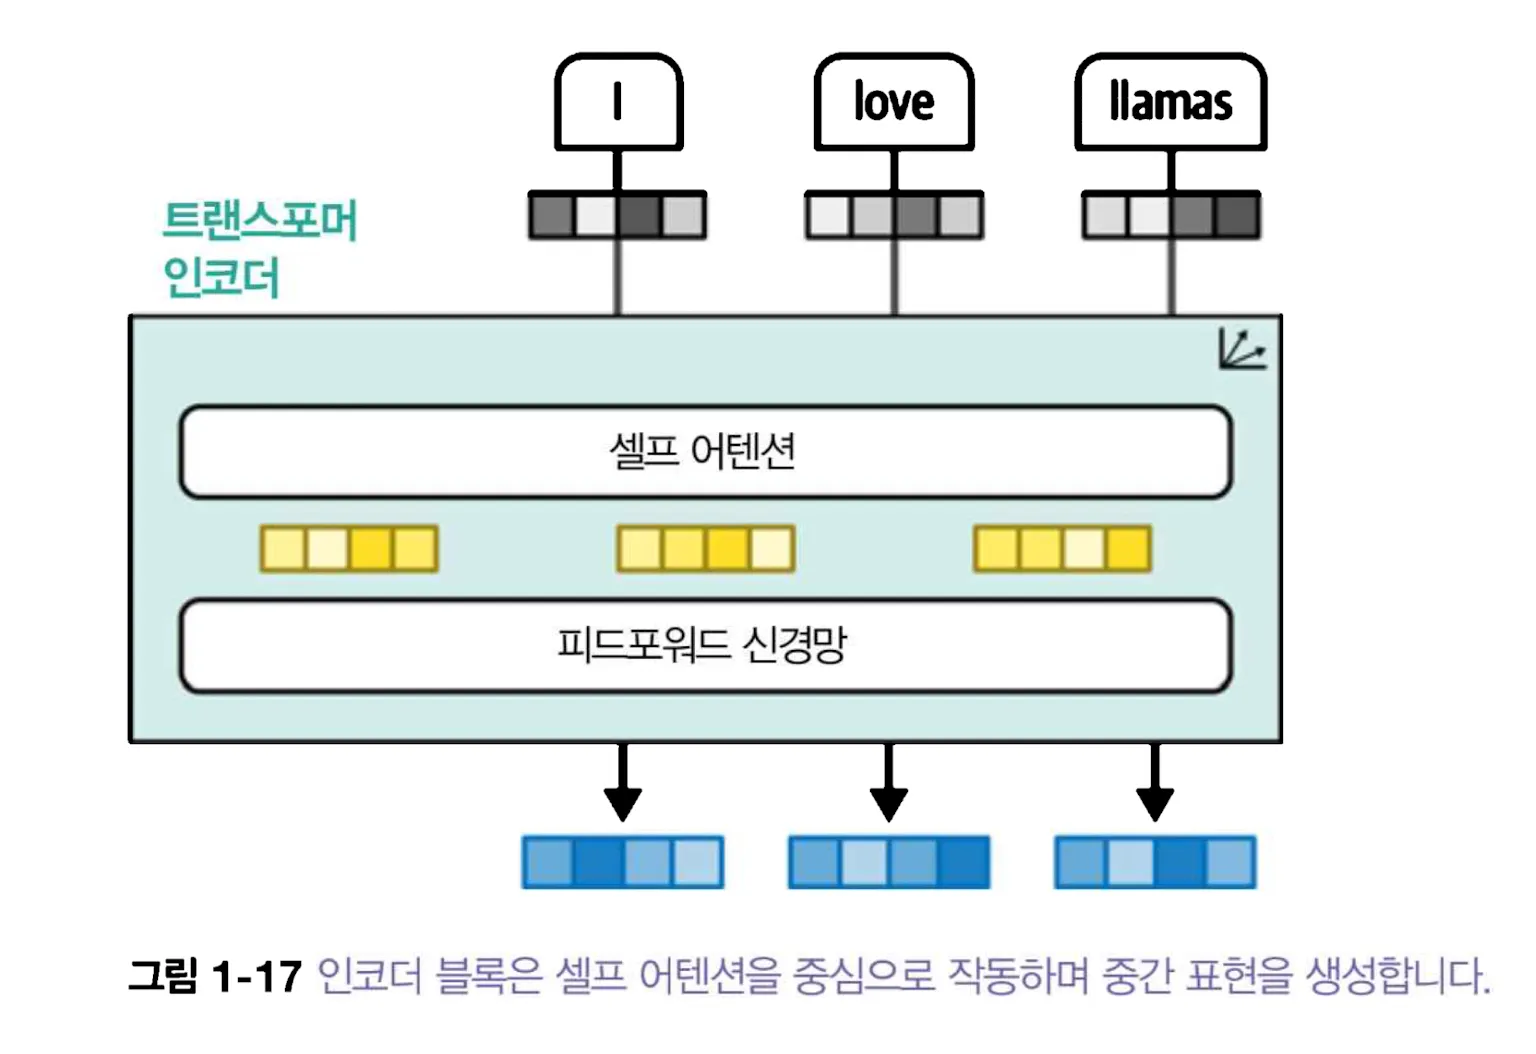
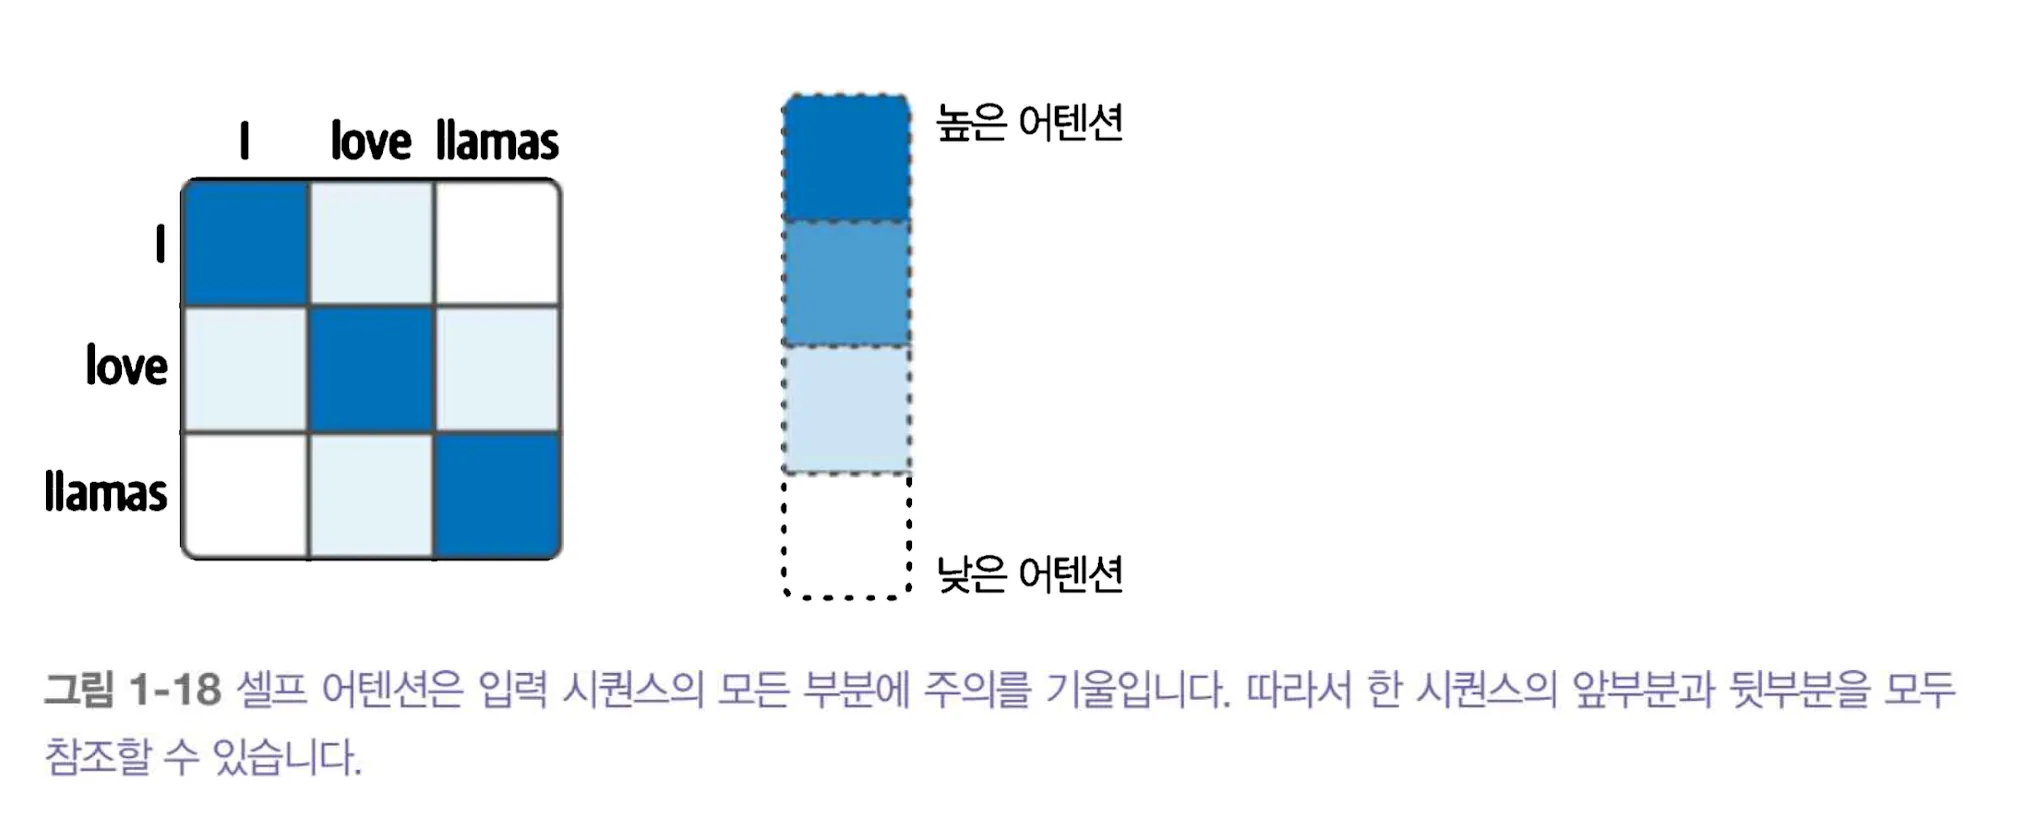
셀프 어텐션은 같은 시퀀스의 위치들끼리 정보를 주고받는다. 훈련할 때는 마스크가 허용하는 범위에서 여러 위치의 계산을 병렬화할 수 있다. 다만 디코더가 실제로 문장을 생성할 때는 아직 생성되지 않은 다음 토큰을 모른다. 따라서 한 번에 한 토큰씩 출력하는 제약은 남는다.
디코더는(입력에서 관련된 부분을 찾기 위해) 인코더의 출력에 주의를 기울이는 별도의 층이 추가
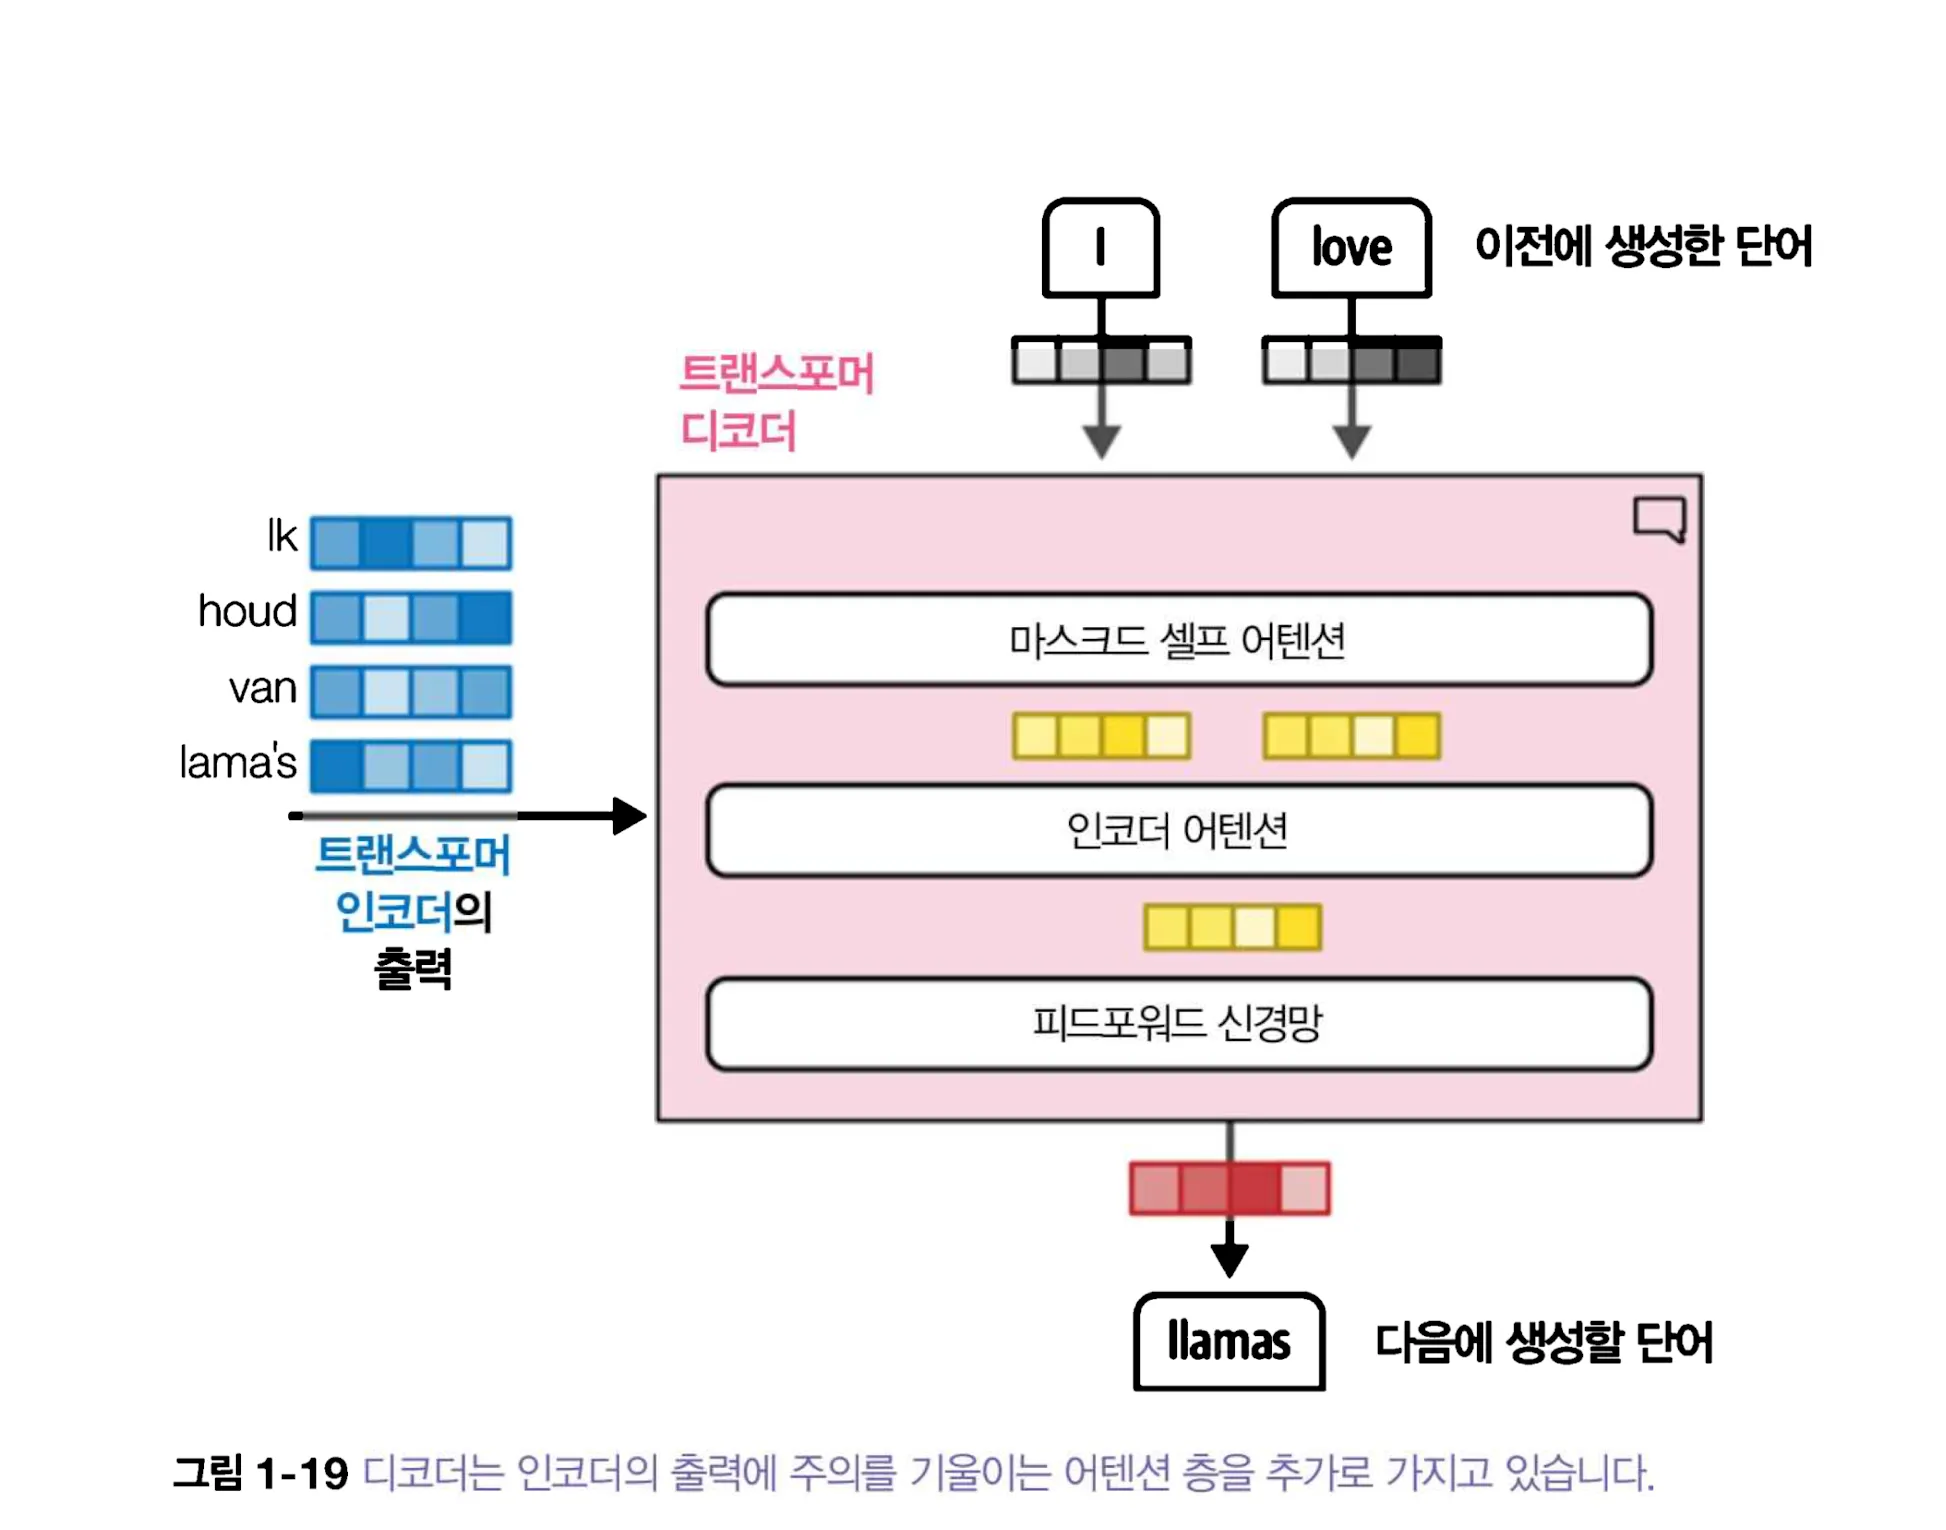
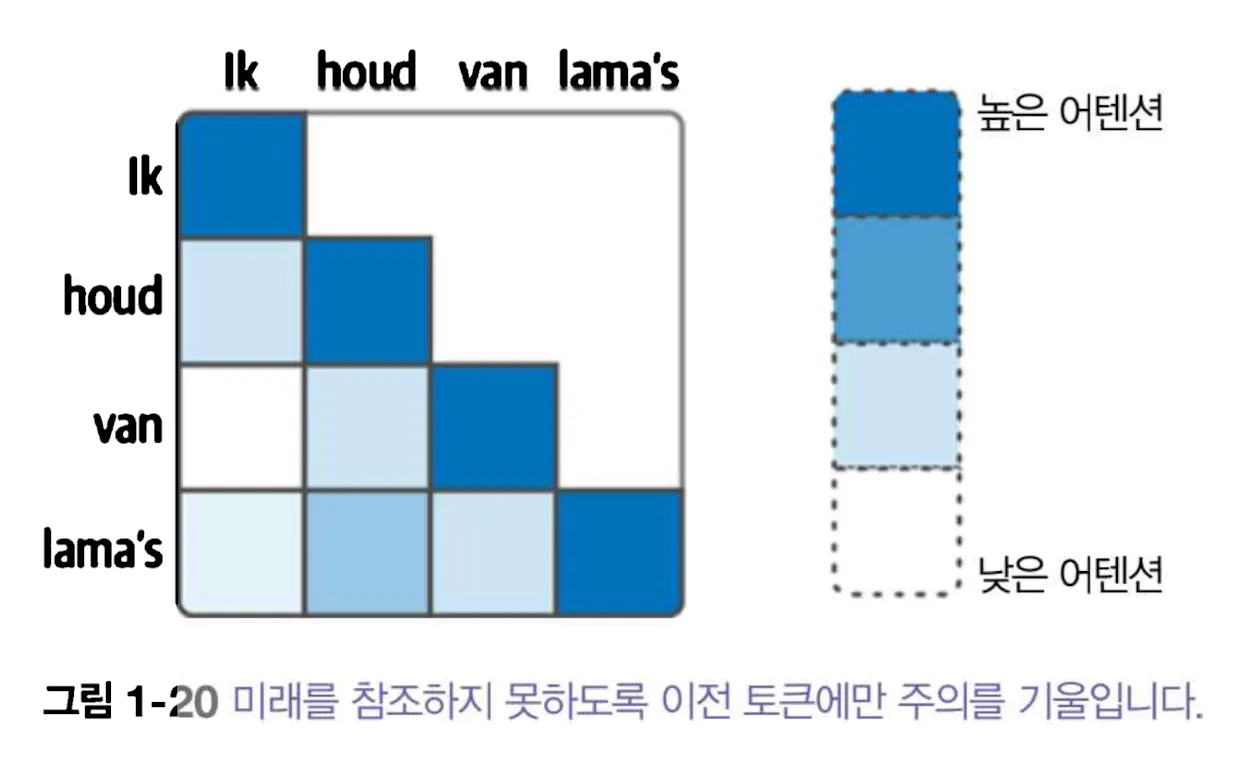
디코더의 셀프 어텐션 층은 미래의 위치를 마스킹(Masking)하여 출력을 생성할 때 정보 누출을 방지하기 위해 앞선 위치에만 주의를 기울일 수 있다.
이 구성 요소는 BERT처럼 표현을 학습하는 모델과 GPT처럼 다음 토큰을 생성하는 모델에 다르게 조합된다. 아래에서는 입력을 어떻게 참조하는지와 학습 목표가 무엇인지를 기준으로 계열을 나눈다.
4-1. 표현 모델: 인코더 기반 모델
인코더는 입력된 문장을 ‘이해‘하고 그 의미를 고차원적인 벡터(숫자)로 변환하는 데 최적화되어 있다.
-
특징: 양방향(Bidirectional) 맥락 파악이 가능. 문장 전체를 한꺼번에 보고 각 단어가 앞뒤 단어들과 어떤 관계인지 분석.
-
학습 방식: 문장의 중간 단어를 가리고(Masking) 맞히는 ‘마스크 언어 모델링(MLM)‘을 주로 사용.
-
대표 모델: BERT, RoBERTa, ALBERT
-
주요 용도: 문장 분류 (스팸 메일 분류 등)
- 개체명 인식 (NER: 인물, 장소 추출)
- 질의응답 (주어진 지문에서 정답 찾기)
원본 트랜스포머 모델의 경우 인코더-디코더 구조라서 번역 작업에는 적합하지만, 텍스트 분류같은 작업에는 쉽게 사용하기 어렵다.
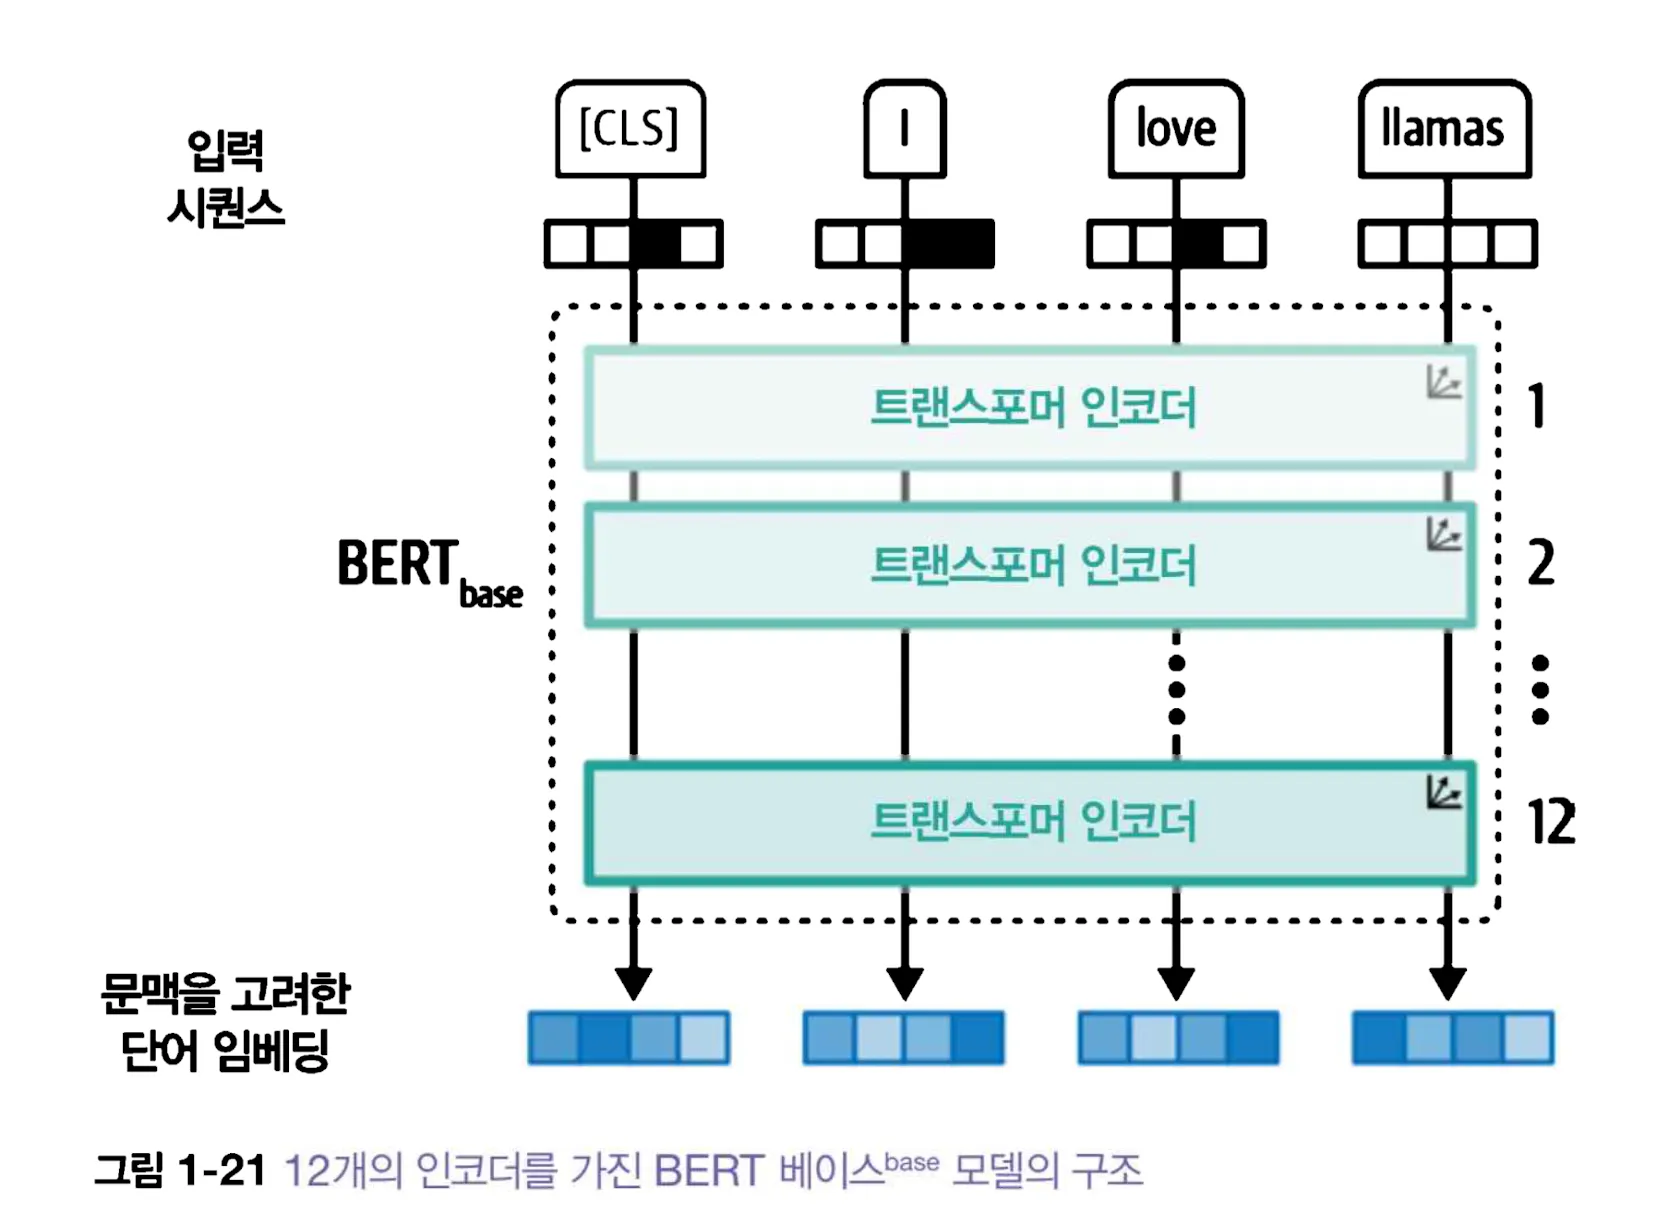
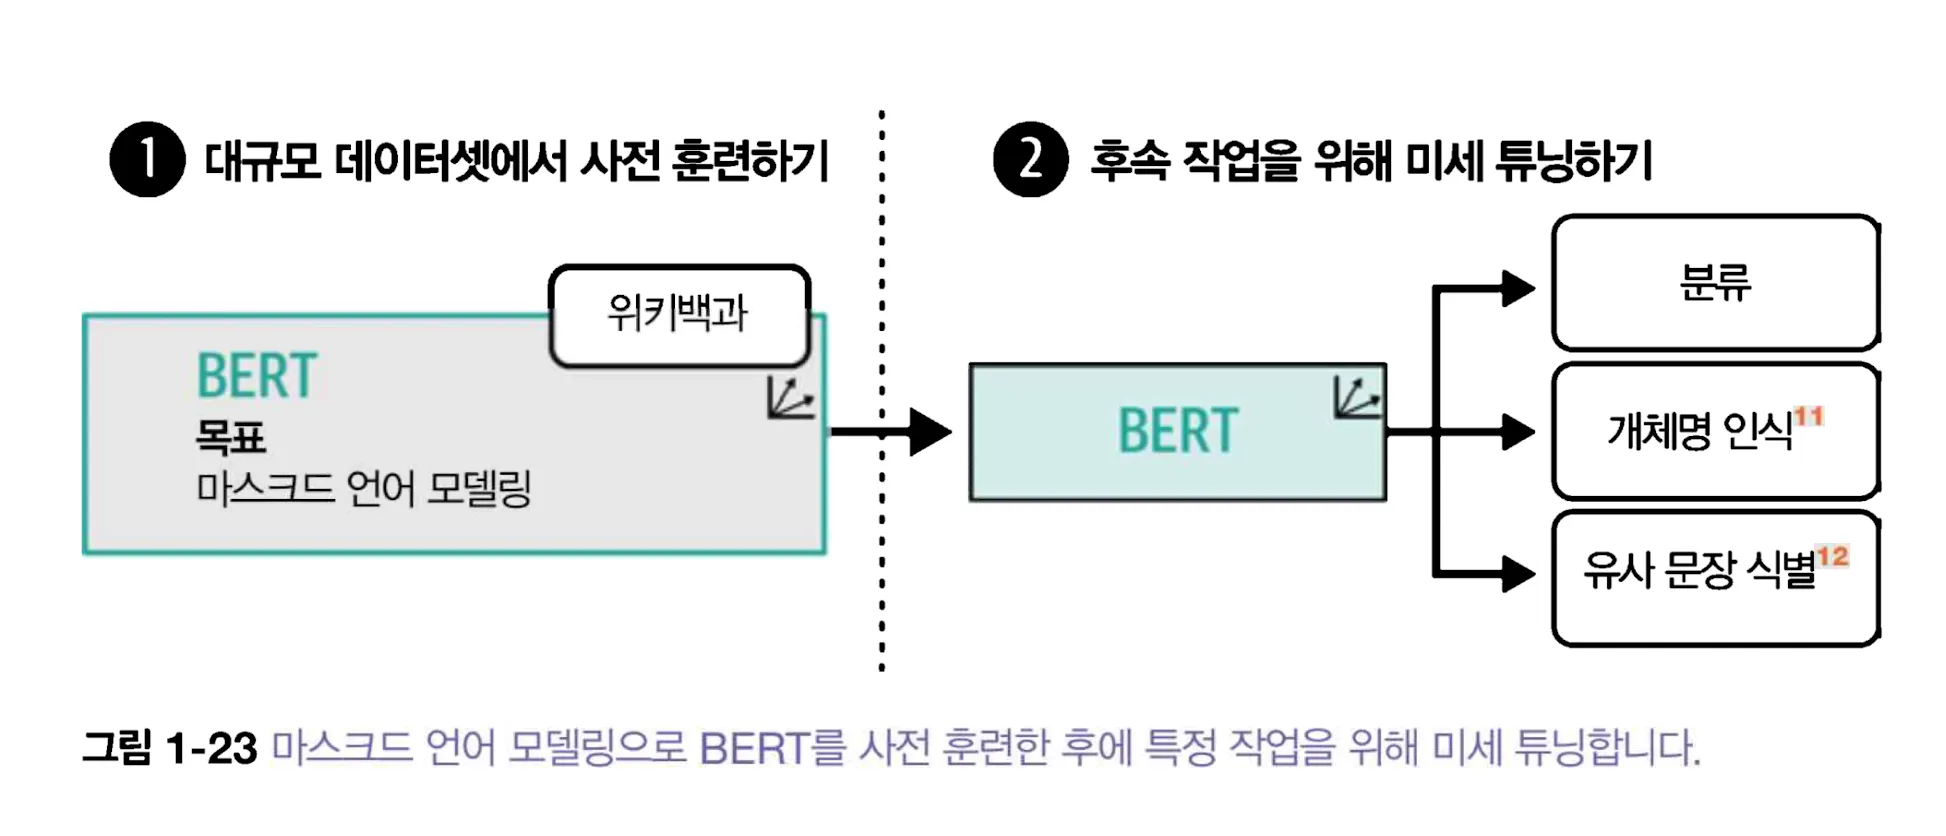
2018년 발표된 BERT는 Bidirectional Encoder Representations from Transformers의 약자다. 한 위치의 표현을 만들 때 왼쪽과 오른쪽 문맥을 함께 사용한다.
BERT는 언어를 표현하는데 초점을 맞춘 인코더 기반 구조이다.
인코더 기반 구조 : 인코더만 사용하고 디코더는 사용하지 않는다는 의미
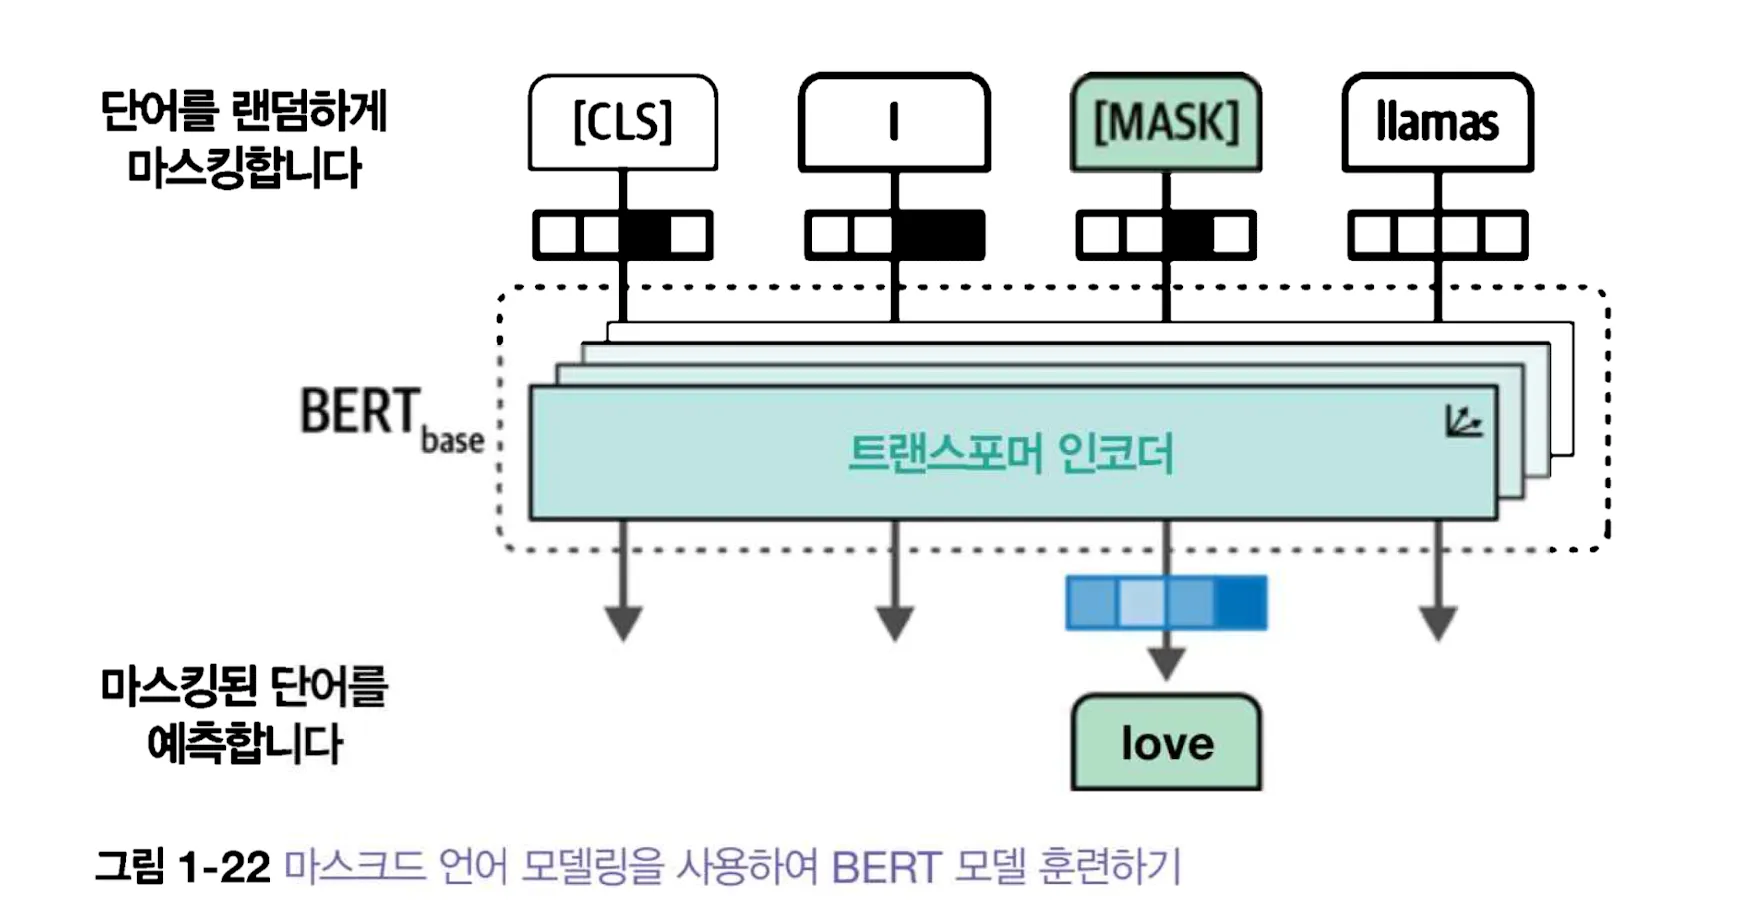
BERT는 마스크드 언어 모델링(Masked Language Modeling)이라는 기법을 적용
-
모델이 예측할 입력의 일부분을 마스킹
-
일반적으로 전이 학습(transfer learning)에 사용
- 언어 모델링을 위해 모델을 사전 훈련(Pretraining) 후 구체적인 작업을 위해 미세튜닝을 진행
예를 들어 “고양이가 [MASK]에서 잔다”라는 입력에서 가려진 위치를 예측한다. 앞뒤 단어를 볼 수 있으므로 문맥 표현을 학습하기 좋다. 실제 분류 작업에서는 문장에 해당하는 표현 위에 작은 분류 헤드를 붙여 스팸/정상 같은 레이블의 점수를 계산한다. 마스크를 맞히는 훈련과 스팸을 분류하는 훈련은 목표가 다르다.
사전 훈련 모델의 장점
-
대부분의 훈련이 이미 완료되었다는 것
-
특정 작업을 위한 미세튜닝은 일반적으로 컴퓨팅 자원을 적게 사용
-
BERT 같은 모델의 은닉 벡터를 특성으로 꺼낼 수 있다. 다만 문장 유사도나 분류에 바로 적합한지는 별도 평가해야 한다.
모델의 구조와 작동 방식의 주요 차이점
인코더 기반 모델은 입력 위치별 문맥 표현을 만든다. 여기에 분류 헤드를 붙이면 문서의 레이블을 예측하고, 토큰별 헤드를 붙이면 개체명을 찾을 수 있다. 디코더 기반 모델도 내부에서 토큰 임베딩과 은닉 표현을 만들지만, 사전 훈련의 목표는 대체로 다음 토큰 예측이다. 검색에 바로 쓸 문장 임베딩의 품질이 자동으로 보장되지는 않는다.
4-2. 생성 모델: 디코더 기반 모델
디코더는 이전에 나온 단어들을 바탕으로 ‘다음에 올 단어를 예측’하며 문장을 생성하는 데 최적화되어 있습니다. 현재 대다수의 생성형 AI(ChatGPT 등)가 이 구조를 따릅니다.
-
특징: 단방향(Unidirectional/Causal) 맥락을 따릅니다. 미래의 단어를 미리 볼 수 없도록 마스킹 처리를 하며, 왼쪽에서 오른쪽으로 순차적으로 텍스트를 생성합니다.
-
학습 방식: 다음 단어를 예측하는 ‘인과적 언어 모델링(CLM)‘을 사용합니다.
-
대표 모델: 공개된 구조로 확인할 수 있는 GPT-1, Llama 계열 등. 비공개 서비스 모델의 내부 구조는 공개된 범위 안에서만 판단할 수 있다.
-
주요 용도:
- 자유로운 텍스트 생성 (에세이 작성, 코드 생성)
- 대화형 챗봇
- 창의적 글쓰기
GPT-1 구조
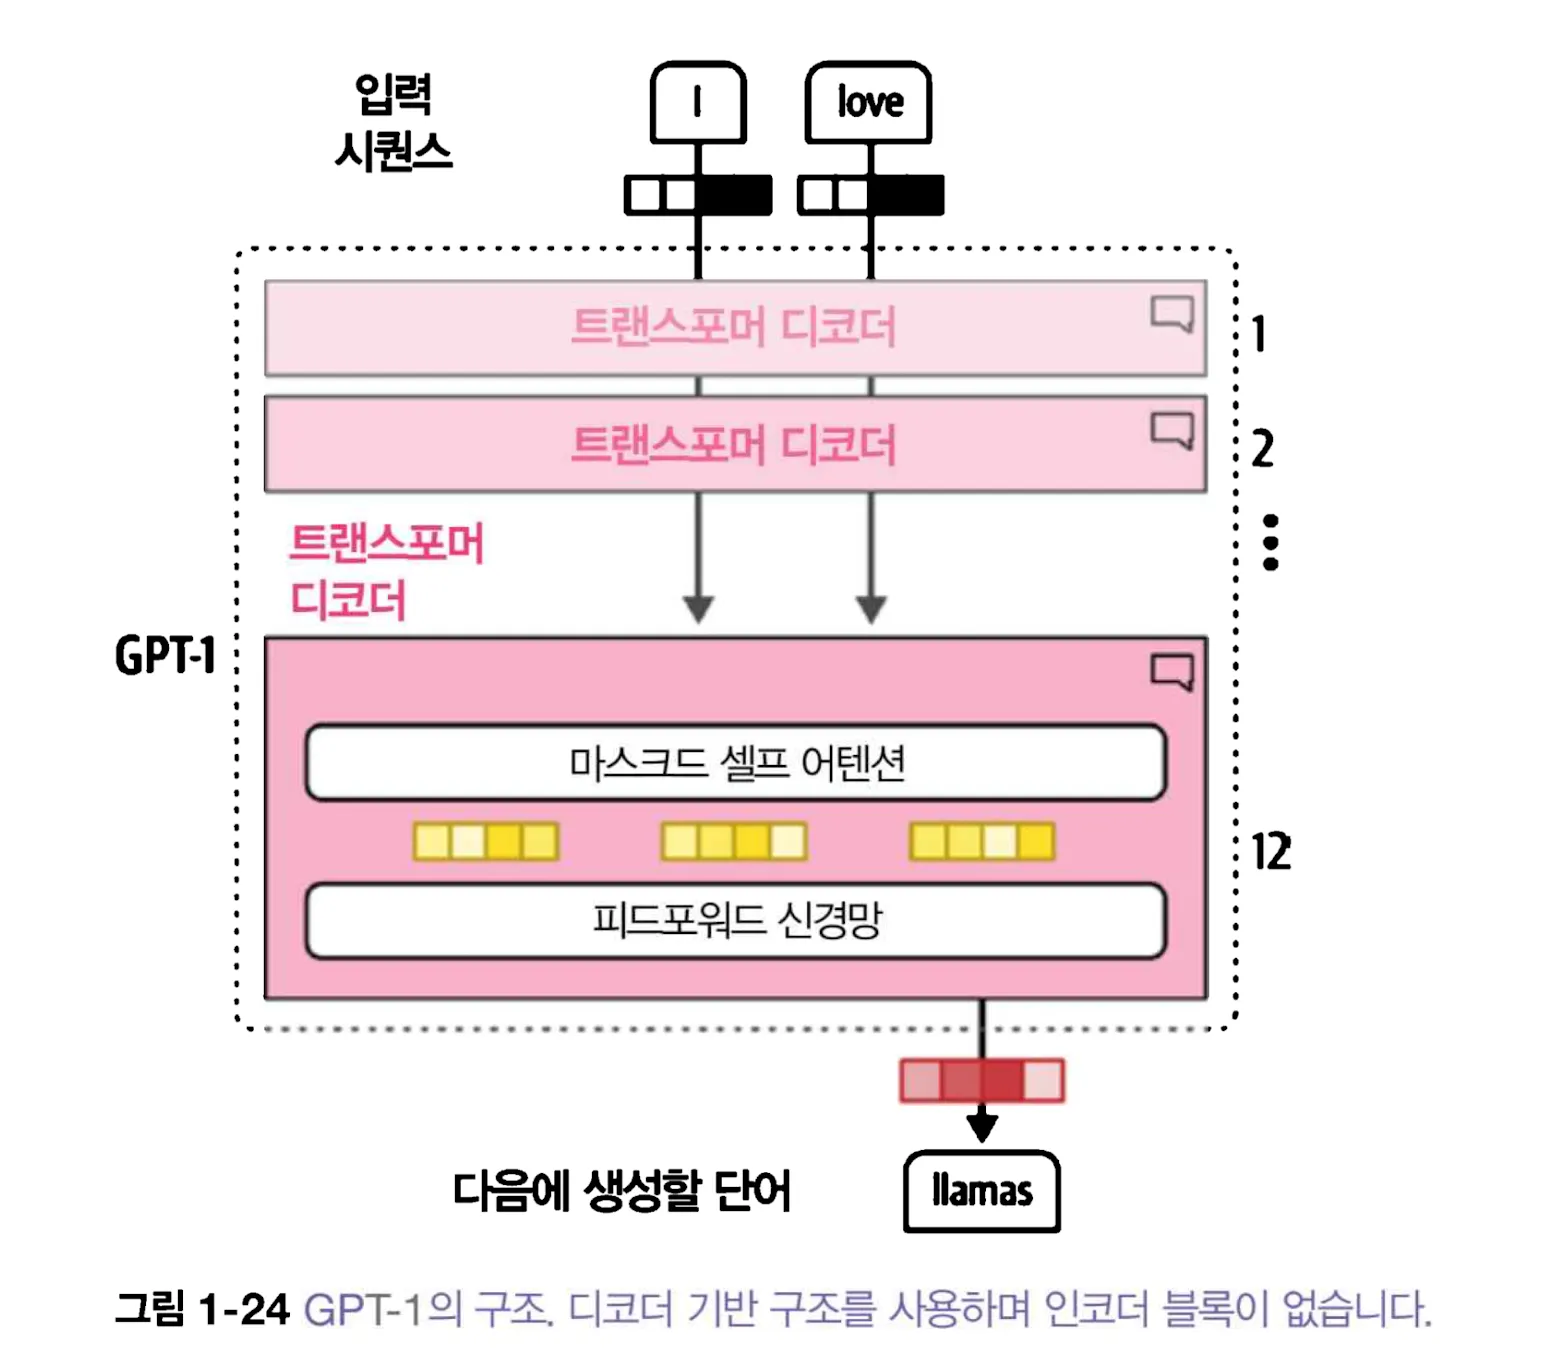
규모가 큰 디코더 기반 생성 모델을 흔히 대규모 언어 모델(LLM)이라고 부른다. 다만 LLM이라는 말이 모든 경우에 디코더만 뜻하는 것은 아니다. 규모가 큰 인코더-디코더 모델에도 사용할 수 있으므로 문맥에서 구조를 확인해야 한다.
생성 모델은 입력 토큰 뒤에 토큰을 이어 붙인다. 채팅처럼 보이는 경우에도 대화 기록을 모델이 기대하는 형식으로 직렬화하고, 그 뒤에 이어질 응답을 생성한다.
-
이 모델의 진정한 힘은 챗봇으로 훈련되었을 때 빛을 발한다.
-
이런 모델을 미세튜닝하여 지시를 따르는 인스트럭트 모델(Instruct Model) 또는 채팅 모델(Chat Model)을 만들 수 있다.
이렇게 만든 모델은 사용자 쿼리(Query:[프롬프트:Prompt])를 입력 받고, 이 프롬프트를 따르는 응답을 출력 할 수 있다. 따라서 종종 생성모델을 완성 모델이라고 한다.
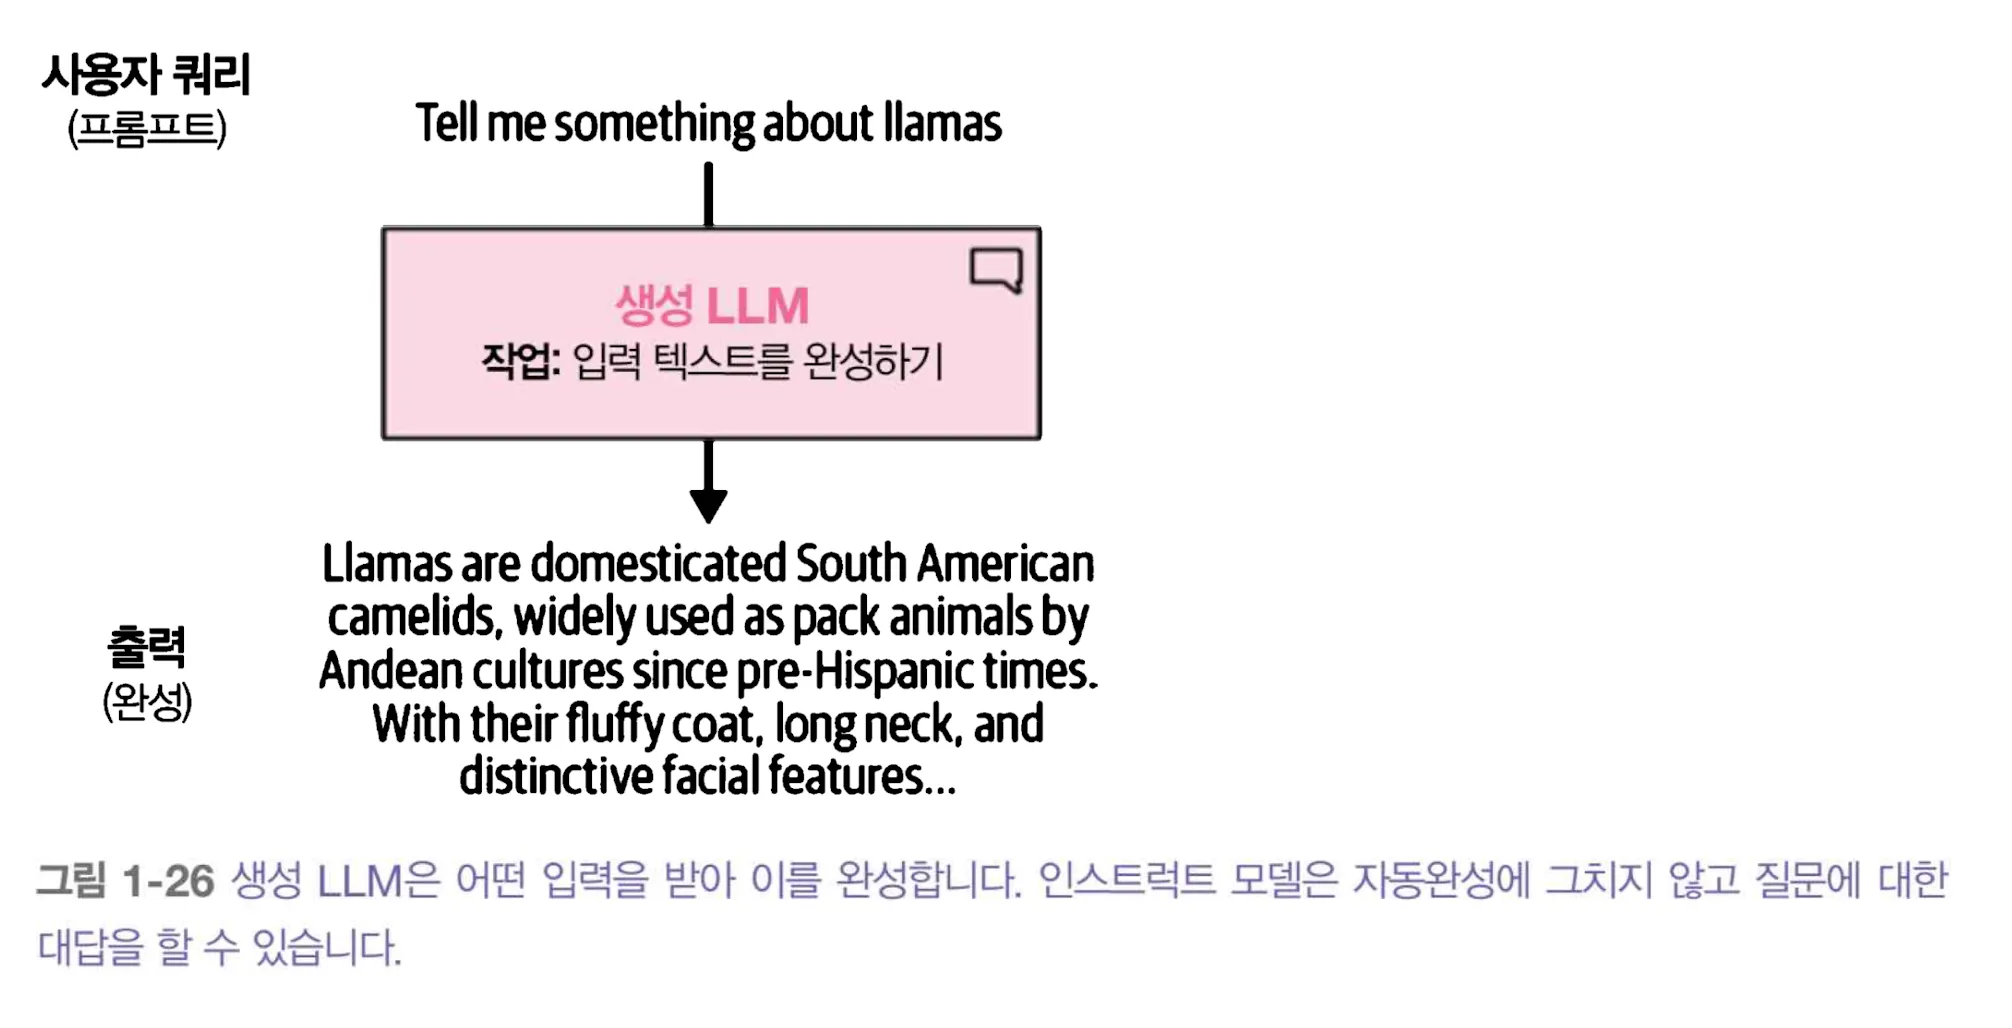
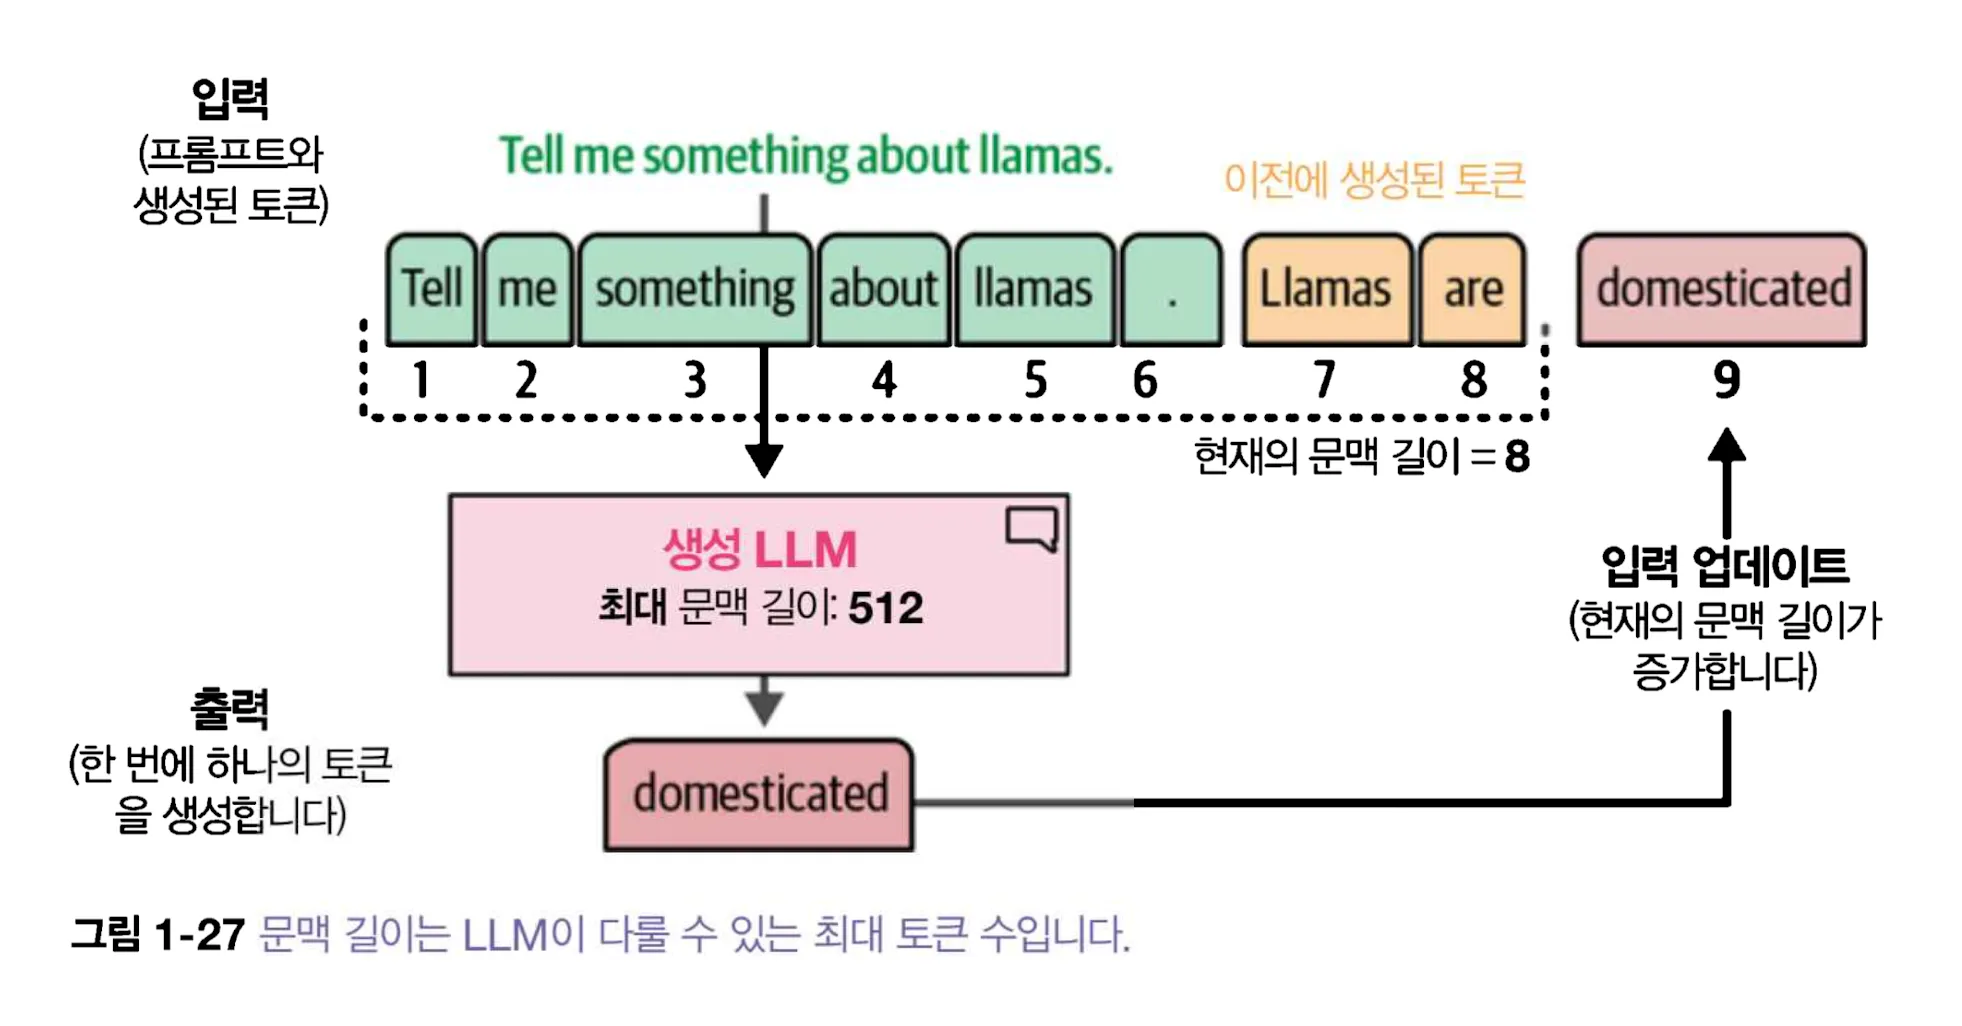
생성모델(완성모델)에서 중요한 부분은 문맥 길이(Context Length) 또는 문맥 윈도(Context Window) 이다.
문맥 길이는 한 번의 계산에서 모델이 참조하도록 설계·설정된 토큰 범위다. 입력 문서가 길면 지시문, 검색 결과, 이전 대화, 앞으로 생성할 답변의 토큰까지 예산에 넣어야 한다. 문서가 창 안에 들어간다는 사실만으로 모든 세부 사항을 안정적으로 활용한다는 뜻은 아니다. 긴 문서에서는 필요한 부분을 골라 넣거나 분할·검색하는 설계가 필요하다.
요약 및 비교
| 구분 | 인코더 기반 (Encoder-only) | 디코더 기반 (Decoder-only) | 인코더-디코더 |
|---|---|---|---|
| 핵심 목적 | 문맥 이해 (NLU) | 텍스트 생성 (NLG) | 입력-출력 변환 (Translation) |
| 방향성 | 양방향 (문장 전체 참조) | 단방향 (이전 단어만 참조) | 입력은 양방향, 출력은 단방향 |
| 대표 모델 | BERT | GPT, Llama | T5, BART |
| 비유 | 독해 능력이 뛰어난 학생 | 소설을 써 내려가는 작가 | 외국어를 통역하는 통역사 |
이 표는 주로 쓰이는 방식을 비교한 것이다. 인코더 모델도 헤드를 바꿔 여러 작업에 쓸 수 있고, 생성 모델도 분류 프롬프트를 받을 수 있다. 새 작업에서 모델을 고를 때는 “출력으로 문장 자체가 필요한가, 레이블이나 벡터가 필요한가”부터 정하면 후보를 좁히기 쉽다.
대규모 언어 모델의 정의
대규모 언어 모델(LLM, Large Language Model)에는 엄격한 파라미터 수 기준이 없다. 일상적으로는 대규모 텍스트로 사전 훈련한 생성 모델을 가리키는 경우가 많다. 그러나 “대규모”보다 실무에서 더 중요한 질문은 어떤 입력을 받아 어떤 출력을 내도록 훈련되었는가이다.
대규모 언어 모델의 훈련 패러다임
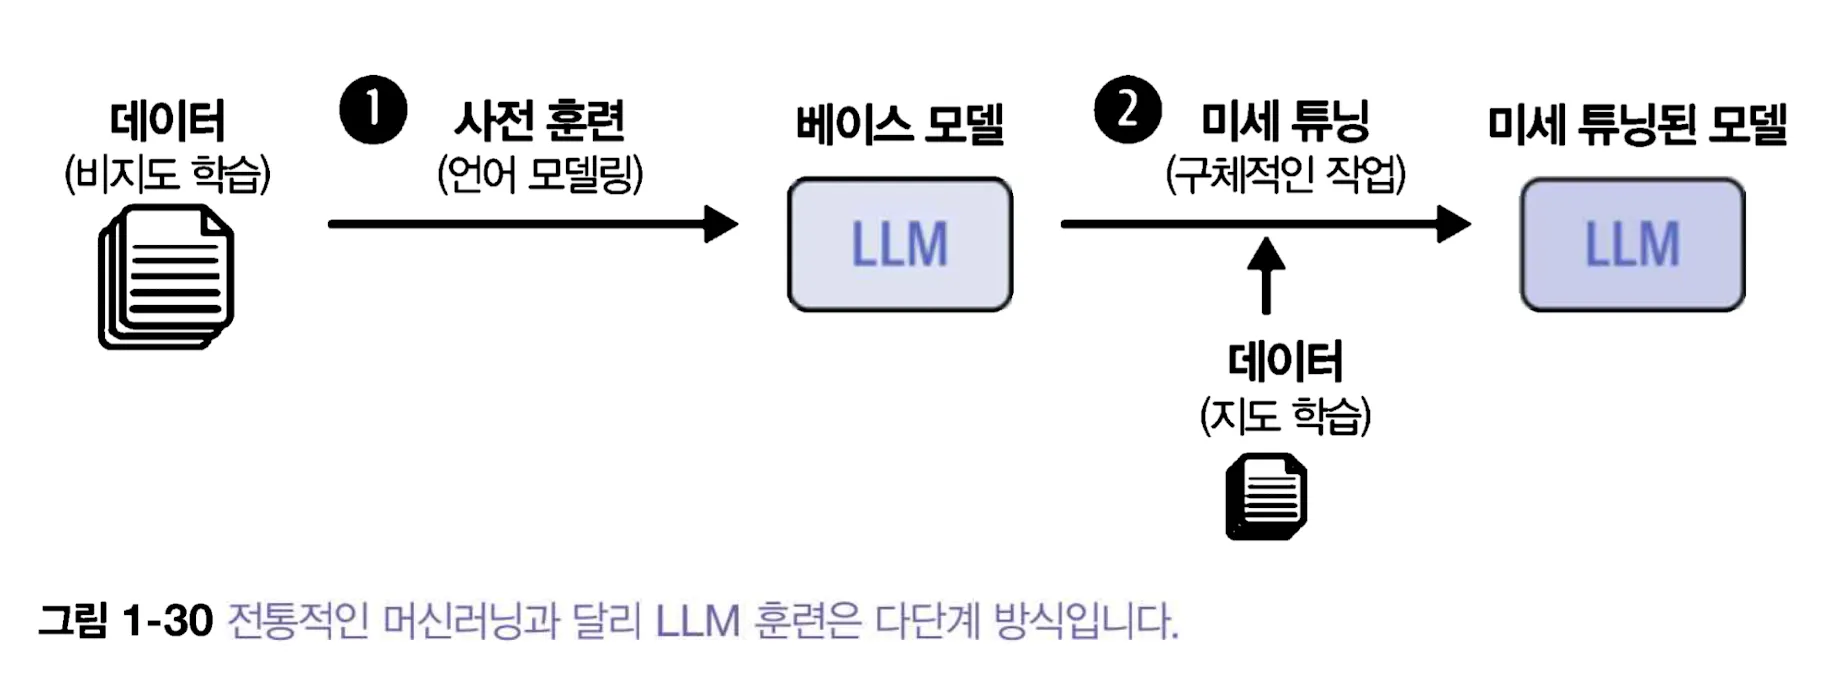
전통적인 분류 작업은 준비된 레이블 데이터로 해당 작업의 모델을 직접 훈련하는 경우가 많았다. 아래 그림의 단일 단계와 비교해, 언어 모델은 범용 텍스트에서 먼저 패턴을 학습한 뒤 목적에 맞게 조정할 수 있다.
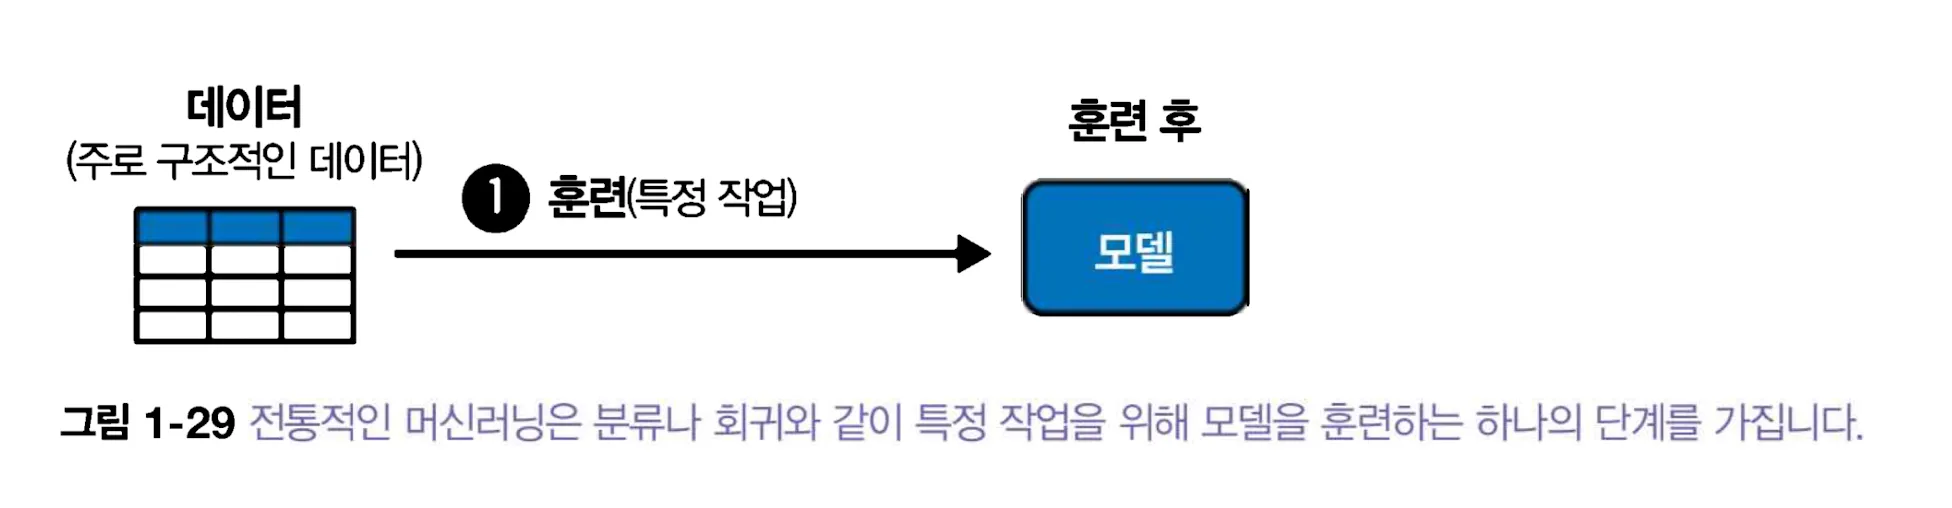
- 사전 훈련(pretraining): 대량의 텍스트로 언어 패턴을 학습한다. 디코더 기반 모델에서는 앞 토큰으로 다음 토큰을 예측하는 손실을 줄인다. 예를 들어
오늘은 비가다음에 올 후보들의 점수를 만들고 실제 다음 토큰에 더 높은 확률을 주도록 가중치를 갱신한다. 이 단계의 결과를 흔히 베이스 모델이라고 한다. - 후속 학습(post-training): 작업과 기대 행동을 보여 주는 데이터로 베이스 모델을 추가 훈련할 수 있다. 지시-응답 예제로 학습하면 요청 형식에 맞춰 답하기 쉬워지고, 분류 레이블로 학습하면 특정 분류기에 가까워진다. 사후 학습에는 지도 미세 튜닝 외의 선호도 기반 방법도 쓰인다.
사전 훈련된 모델을 그대로 사용하는 경우도 있다. 예를 들어 개별 단어의 임베딩을 꺼내거나 제로샷 프롬프트를 시험할 수 있다. 다만 학습 데이터에서 본 패턴을 잘 이어 쓴다는 것과 사실을 검증하거나 최신 정보를 안다는 것은 다른 능력이다. 업무에 적용할 때는 결과 평가, 근거 자료 제공, 입력 길이 관리가 추가로 필요하다.
다음 글에서는 토큰 ID가 어떻게 임베딩과 모델 입력으로 바뀌는지 살펴본다.
참고 자료
- Jay Alammar · Maarten Grootendorst, 《핸즈온 LLM》: 이 연재의 학습 흐름에 참고했다.
- Distributed Representations of Words and Phrases and their Compositionality: Skip-gram과 단어 표현.
- Attention Is All You Need: 원본 트랜스포머.
- BERT: Pre-training of Deep Bidirectional Transformers for Language Understanding: 인코더 기반 사전 훈련.
같은 카테고리의 글
이어서 읽을 글
7. 고급 텍스트 생성 기술과 도구
모델 호출, 프롬프트 체인, 대화 기록, 도구 호출을 데이터 흐름과 실패 사례로 이해하기
3. 대규모 언어 모델 자세히 살펴보기
프롬프트 입력부터 다음 토큰 선택, KV 캐시, 어텐션과 피드포워드 층까지 생성 모델의 계산 흐름을 따라간다.
13. LLM 운영하기
LLM 서비스의 모델·색인 버전 관리, 품질 평가, 추적 지표와 안전한 배포 절차를 정리합니다.
9. LLM 애플리케이션 개발하기
검색 증강 생성으로 근거를 연결하고 권한, 출력 검증, 프롬프트 인젝션과 평가를 다루는 애플리케이션 구성법을 정리한다.