목차
1. JPA
들어가기 전..
자바에서 데이터베이스에 접근하려면 JDBC API를 통해 SQL을 실행한다. MyBatis를 사용하면 SQL을 XML이나 어노테이션에 작성하고 결과를 자바 객체에 매핑할 수 있다. SQL을 직접 제어하기 좋은 방식이지만, 요구사항이 바뀌면 조회문과 매핑 코드를 함께 손봐야 하는 경우가 많다.
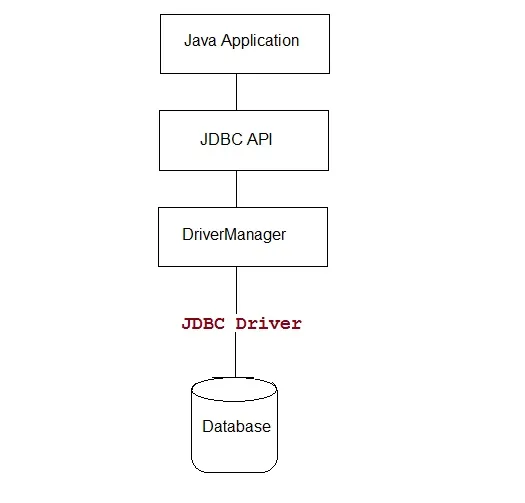
[JDBC API를 이용한 데이터베이스 접근]
그럼 JPA는 무엇일까?
JPA는 Java Persistence API의 약자로 알려진 자바의 ORM 표준이다. 현재 사양과 패키지 이름은 Jakarta Persistence이며 예전 javax.persistence 대신 jakarta.persistence를 사용한다. Hibernate 같은 구현체가 이 표준 인터페이스를 구현한다. MyBatis는 SQL 매퍼이고, JPA는 객체의 상태와 테이블 행을 연결하는 ORM 방식이라는 차이가 있다.
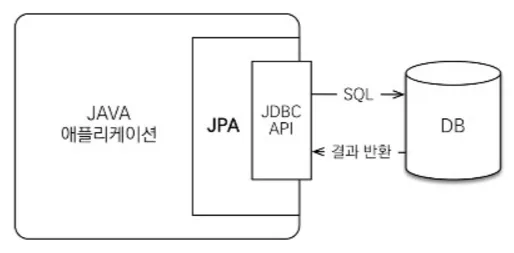
ORM(Object-Relational Mapping)은 객체와 관계형 테이블 사이의 대응 관계를 선언하고, 구현체가 필요한 SQL을 생성·실행하도록 돕는다. 개발자가 SQL을 전혀 몰라도 된다는 뜻은 아니다. 실제 실행 쿼리와 인덱스를 확인해야 성능 문제를 찾을 수 있다.
flowchart LR
    A[자바 엔티티] --> B[EntityManager / 영속성 컨텍스트]
    B --> C[JPA 구현체가 SQL 생성]
    C --> D[데이터베이스 테이블]
    D --> C --> B --> A
엔티티와 영속성 컨텍스트
다음은 회원 객체를 테이블에 매핑하는 가장 작은 형태다. 실행하려면 데이터베이스 연결과 persistence unit 설정이 별도로 필요하다.
import jakarta.persistence.Entity;
import jakarta.persistence.Id;

@Entity
public class Member {
    @Id
    private Long id;
    private String name;

    protected Member() { } // JPA가 사용할 기본 생성자

    public Member(Long id, String name) {
        this.id = id;
        this.name = name;
    }

    public void rename(String name) {
        this.name = name;
    }
}EntityManager는 엔티티를 관리하는 영속성 컨텍스트와 연결된다. persist()로 새 엔티티를 관리 상태로 만들고, find()로 기본 키에 해당하는 엔티티를 조회한다. 관리 중인 객체의 필드를 바꾸면 구현체가 변경 사항을 감지하며, 실제 데이터베이스 반영 시점은 flush와 트랜잭션 경계에 따라 달라진다. Jakarta Persistence EntityManager 문서에 상태와 동작이 설명돼 있다.
JDBC/MyBatis와 비교할 때
| 관점 | SQL을 직접 작성하는 방식 | JPA |
|---|---|---|
| 조회·변경문 | 개발자가 SQL을 작성 | 객체 작업을 바탕으로 구현체가 SQL 생성 |
| 결과 매핑 | 직접 또는 매퍼 설정 | 엔티티 매핑 정의 |
| 쿼리 제어 | SQL을 직접 다루기 쉬움 | 생성된 SQL과 fetch 전략을 살펴봐야 함 |
JPA를 도입해도 복잡한 조회는 JPQL이나 네이티브 SQL이 필요할 수 있다. 관계를 잘못 설정하면 불필요한 쿼리가 반복되는 N+1 문제도 생긴다. 데이터베이스를 바꿀 때 모든 쿼리가 자동으로 호환된다고 가정하지 말고, 사용하는 함수·자료형·생성 스키마를 다시 확인해야 한다. 먼저 엔티티의 생명주기와 트랜잭션을 이해한 뒤 실제 SQL 로그로 동작을 확인하는 것이 좋다.
같은 회원을 두 번 읽으면 무엇이 달라질까?
영속성 컨텍스트는 단순한 SQL 생성기가 아니다. 한 EntityManager 안에서 기본 키가 같은 엔티티를 식별하고, 관리 중인 객체의 변경을 추적한다. 다음 코드는 동일한 트랜잭션과 EntityManager를 사용한다는 전제에서 이해한다.
EntityTransaction tx = em.getTransaction();
tx.begin();
try {
    Member first = em.find(Member.class, 1L);
    Member second = em.find(Member.class, 1L);

    if (first != null) {
        System.out.println(first == second); // 같은 영속성 컨텍스트의 객체
        first.rename("Lee");
    }
    tx.commit();
} catch (RuntimeException ex) {
    if (tx.isActive()) tx.rollback();
    throw ex;
}
위 rename은 엔티티에 의도를 드러내는 변경 메서드를 추가했다고 가정한 것이다. find의 첫 호출이 실제 조회를 할지, 이미 관리 중인 객체를 돌려줄지는 상태에 따라 달라진다. 같은 ID를 다시 조회하면 우선 영속성 컨텍스트의 관리 객체를 이용한다. rename 뒤 update()를 호출하지 않아도 변경 감지(dirty checking)가 flush 시 UPDATE를 준비할 수 있다. 커밋 전 SQL이 실행되더라도 트랜잭션이 롤백되면 변경을 저장 성공으로 볼 수 없다.
stateDiagram-v2
  [*] --> 비영속: new Member()
  비영속 --> 관리: persist()
  관리 --> 분리: detach() 또는 close()
  관리 --> 삭제: remove()
  분리 --> 관리: merge() 결과 객체
  삭제 --> [*]: flush / commit
상태를 구분해야 하는 이유는 EntityManager가 닫힌 뒤 분리 상태 객체를 수정해도 변경 감지가 일어나지 않기 때문이다. merge()는 전달한 객체 자체를 다시 관리 상태로 바꾸는 것이 아니라 관리 객체를 반환한다. 반환값을 무시하면 이후 변경이 어디에 적용되는지 혼동하기 쉽다. 이 개념은 웹 요청 안에서 읽은 엔티티를 요청 밖 비동기 작업으로 넘길 때 특히 중요하다.
ORM을 선택할 때 확인할 경계
JPA는 동일한 구조의 저장·변경 코드를 줄이고 객체 관계를 표현하기 좋다. 그러나 보고서용 대형 집계, DB 고유 기능을 많이 쓰는 조회, 정교한 배치 작업에는 SQL을 직접 작성하는 방식이 더 읽기 쉽거나 빠를 수 있다. 한 애플리케이션에서 JPA와 SQL 조회를 병행할 수도 있다. 이때는 트랜잭션, 캐시, 읽기 시점이 일치하는지 확인해야 한다.
첫 실습의 성공 기준은 “persist가 예외 없이 끝났다”가 아니다. 커밋 후 새 EntityManager로 다시 조회했을 때 행이 보이는지, 변경 뒤 실행 SQL이 무엇인지, 예외 뒤 롤백이 되는지를 함께 확인한다. SQL 로그는 개발 환경에서 유용하지만 바인딩 값에 개인정보가 섞일 수 있으므로 운영 로그 정책을 별도로 둔다.
참고: Jakarta Persistence 개요, EntityManager API, Hibernate 영속성 컨텍스트.
같은 카테고리의 글
이어서 읽을 글
2. JPA 시작
Jakarta Persistence 설정부터 엔티티 저장·재조회까지 따라가며 트랜잭션과 영속성 컨텍스트의 실행 경계를 확인한다.
5. 연관관계 매핑
주문과 고객의 다대일 관계로 외래 키 소유자와 지연 로딩을 설명하고, 목록 조회의 N+1 문제를 점검한다.
4. Entity Mapping(엔티티 매핑)
엔티티·컬럼·기본 키를 테이블에 매핑하고, 날짜·열거형·스키마 설정이 저장 결과에 미치는 영향을 살펴본다.
Spring AI
Spring AI의 ChatModel·ChatClient·Prompt·Advisor가 요청을 처리하는 흐름과 Kotlin API, 스트리밍, 운영 시 검증 기준을 살펴본다.