목차
토큰과 임베딩
텍스트는 어떻게 모델 입력이 될까?
“오늘 배송이 늦었다”라는 리뷰를 생성 모델이나 분류 모델에 넣어 보자. 모델은 문자열을 곧바로 계산하지 않는다. 먼저 토크나이저가 문자열을 조각으로 나누고 각 조각을 토큰 ID라는 정수에 대응시킨다. 모델의 임베딩 표는 이 정수에 대응하는 벡터를 찾고, 트랜스포머가 주변 문맥을 반영해 벡터를 갱신한다. 마지막으로 생성 모델은 다음 토큰의 점수를, 분류 모델은 레이블의 점수를 낸다.
flowchart LR
  A["원문"] --> B["토크나이저"] --> C["토큰 ID"] --> D["임베딩 표"] --> E["문맥을 반영한 벡터"] --> F["생성 또는 분류 헤드"]
토큰 ID는 사전에서의 번호이지 의미를 담은 실수 벡터가 아니다. 또한 입력 임베딩과 트랜스포머를 통과한 마지막 은닉 상태를 구별해야 아래 코드의 출력을 해석할 수 있다.
토큰
LLM은 텍스트를 직접 계산하지 못하므로 텍스트 → 토큰 → ID 변환이 필요하다. 토큰은 항상 완전한 단어가 아니다. 띄어쓰기, 부분 단어, 문장 부호가 별도 토큰이 될 수 있다. 따라서 같은 문장의 토큰 수가 모델마다 다르고, 단어 수로 문맥 길이나 비용을 계산하면 어긋난다.
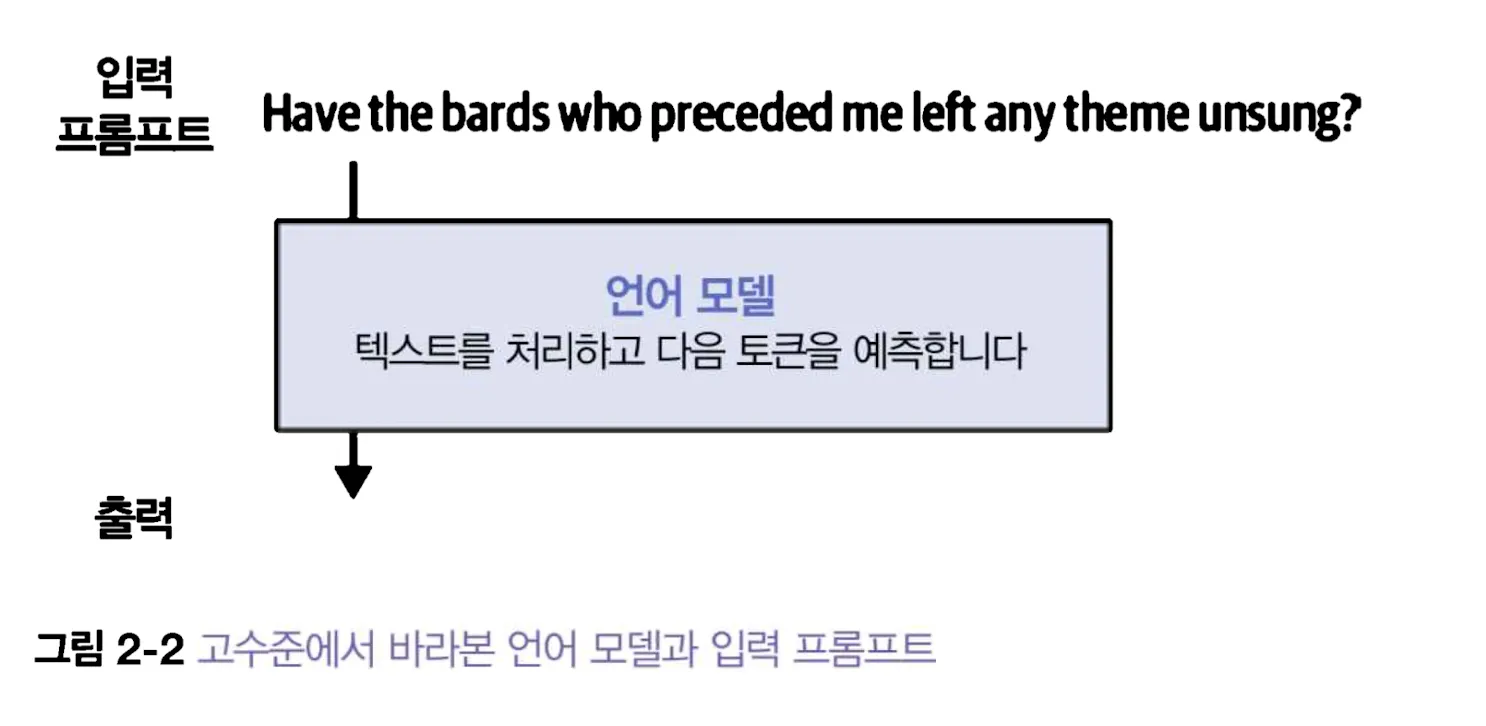
아래 그림은 토크나이저가 텍스트를 조각과 ID로 바꾸는 흐름을 보여 준다. 실제 분할은 해당 모델의 어휘와 규칙에 달려 있다.
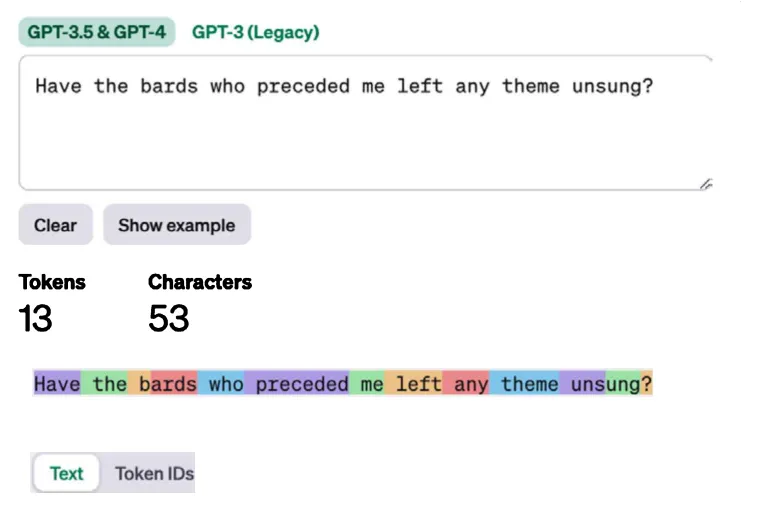
모델 가중치를 받기 전에 토큰화만 확인할 수도 있다. 다음 코드는 한국어 문장과 영어 문장을 각각 ID로 변환한다. 출력 숫자를 미리 정해 적지 않고, 현재 설치된 토크나이저의 결과를 그대로 보도록 했다.
from transformers import AutoTokenizer

tokenizer = AutoTokenizer.from_pretrained("microsoft/Phi-3-mini-4k-instruct")
for sentence in ("오늘 배송이 늦었다.", "The delivery was late."):
    ids = tokenizer(sentence, add_special_tokens=False)["input_ids"]
    print(sentence, "→", len(ids), "tokens")
print(tokenizer.convert_ids_to_tokens(ids))add_special_tokens=False는 문장 본문 자체가 어떻게 나뉘는지 보기 위한 선택이다. 실제 모델 입력에서는 시작·종료·역할 같은 특수 토큰이 추가될 수 있다. 예를 들어 채팅 모델의 user/assistant 역할 표시는 일반 글자처럼 임의로 붙이기보다 해당 토크나이저의 채팅 템플릿을 쓰는 것이 맞다. 토큰 수를 예산으로 사용할 때는 실제 보낼 전체 메시지를 템플릿 적용 후 다시 세어야 한다.
토큰 수가 많아지는 입력에서는 자르기(truncation)가 필요할 수 있다. 하지만 끝부분만 자르면 분류에 필요한 반전 표현, 예를 들어 “처음에는 좋았지만 마지막은 실망했다”의 결론이 사라질 수 있다. 긴 입력의 어느 부분을 유지할지 작업별로 정해야 한다.
예제에는 transformers와 torch가 필요하다. Phi-3 생성 예제는 모델 파일 다운로드와 상당한 메모리가 필요하므로, 토큰 분할만 보고 싶다면 먼저 AutoTokenizer 부분까지만 실행해도 된다.
pip install transformers torch다음 코드는 Hugging Face transformers로 Phi-3의 토크나이저와 생성 모델을 불러온다. 생성 결과보다 먼저 input_ids와 각 ID의 토큰 문자열을 확인해 보자.
# 1. 필수 라이브러리 임포트
# transformers: 사전학습된 LLM과 토크나이저를 쉽게 불러오는 라이브러리
from transformers import AutoModelForCausalLM, AutoTokenizer

# 2. 사용할 사전학습 LLM 모델 이름
# Microsoft에서 공개한 Phi-3 mini (4k context) instruct 모델
model_name = "microsoft/Phi-3-mini-4k-instruct"

# 3. LLM 모델 로드
model = AutoModelForCausalLM.from_pretrained(
    model_name,
    device_map="auto",   # 사용 가능한 장치에 자동 배치
    dtype="auto"         # 모델/장치에 맞는 자료형 선택
)

# 4. 토크나이저 로드
# 모델 학습 시 사용된 토큰화 규칙을 통해 고정된 토큰 사전을 통해 토큰화
tokenizer = AutoTokenizer.from_pretrained(model_name)

# 5. 프롬프트(사람이 입력한 텍스트)
prompt = "hi, im ian"

# 6. 프롬프트 → 토큰 ID 변환
# tokenizer:
#   텍스트 → 토큰 → 토큰 ID
# return_tensors="pt":
#   결과를 PyTorch Tensor로 반환
# 입력 텐서는 모델이 놓인 장치로 이동
input_ids = tokenizer(prompt, return_tensors="pt").input_ids.to(model.device)

# 7. LLM 추론(텍스트 생성)
generation_output = model.generate(
    input_ids=input_ids,
    max_new_tokens=200  # 입력 이후 최대 200 토큰까지 생성
)

# generation_output:
# - PyTorch Tensor
# - 입력 토큰 + 새로 생성된 토큰이 모두 포함됨

# 8. 생성된 토큰 → 사람이 읽는 텍스트로 디코딩
generated_ids = generation_output[0, input_ids.shape[-1]:]
print(tokenizer.decode(generated_ids, skip_special_tokens=True))
print("==============================")

# 9. 토큰화된 입력 ID 확인
print(input_ids)
print("==============================")

# 10. 특정 토큰 ID를 직접 디코딩
# 특수 토큰 번호를 하드코딩하지 않고 모델 설정에서 확인
print(tokenizer.bos_token_id, tokenizer.bos_token)
print("==============================")

# 11. 입력 문장을 토큰 단위로 분해해서 확인
for token_id in input_ids[0].tolist():
    print(token_id, tokenizer.convert_ids_to_tokens(token_id))

# 정리
# 1. 모델마다 고유한 토큰화 사전(tokenizer)이 이미 존재한다.
# 2. 사람이 쓴 프롬프트를 토큰화 사전을 기반으로 토큰 ID로 변환한다. (이때 LLM 모델마다 토큰화 방식은 다르다)
# 3. 토큰 ID는 PyTorch Tensor가 되어 모델과 같은 장치에 놓인다.
# 4. PyTorch 기반 LLM 모델이 토큰을 임베딩 → Transformer 연산 → 다음 토큰 예측
이 코드에서 특히 세 가지를 확인할 수 있다.
AutoTokenizer.from_pretrained가 모델과 짝인 토큰화 규칙과 어휘를 불러온다. 토크나이저는 확률을 예측하지 않는다. 어휘의 각 후보에 점수를 내는 부분은 모델의 언어 모델링 헤드다.input_ids는 정수 텐서다.convert_ids_to_tokens는 어휘 안의 표기를 보여 주고decode는 토큰들을 읽을 만한 문자열로 합친다. 부분 단어 마커나 공백 표기가 보일 수 있으므로 둘의 출력을 같은 것으로 기대하면 안 된다.generate의 반환값에는 입력 ID와 새로 생성된 ID가 함께 들어간다. 새 출력만 보려면input_ids.shape[-1]이후를 잘라서 디코딩한다. ID와 토큰 문자열은 모델 버전과 입력 문장에 따라 달라지므로 긴 정수 목록을 정답처럼 외울 이유는 없다.
Mac의 MPS 장치에서 생성하기
Apple Silicon에서 같은 모델을 실행하는 예다. 장치 지원과 가용 메모리는 환경마다 다르다. 아래 프롬프트는 Phi-3의 채팅 형식을 토크나이저에 맡겨서 만든다. 역할 토큰을 문자열 끝에 임의로 붙이는 방식보다 채팅 모델의 입력 규칙을 명확하게 따른다.
from transformers import AutoModelForCausalLM, AutoTokenizer

# 모델과 토크나이저 로드
model_name = "microsoft/Phi-3-mini-4k-instruct"

model = AutoModelForCausalLM.from_pretrained(
    model_name,
    device_map="mps",
    dtype="auto",
)

tokenizer = AutoTokenizer.from_pretrained(model_name)
messages = [{"role": "user", "content": "Write an email apologizing to Sarah for the gardening mishap. Explain what happened."}]

# 텍스트를 텐서로 변환하고 MPS 장치로 이동
inputs = tokenizer.apply_chat_template(
    messages, add_generation_prompt=True, return_tensors="pt", return_dict=True
).to("mps")

# 모델 생성 실행
generation_output = model.generate(
    **inputs,
    max_new_tokens = 20,
    do_sample = True,
    temperature = 0.7
)

# 프롬프트를 제외한 생성 결과 디코딩
print("--- Generation Result ---")
new_ids = generation_output[0, inputs["input_ids"].shape[-1]:]
print(tokenizer.decode(new_ids, skip_special_tokens=True))

print("\n--- Input IDs Structure ---")
print(inputs["input_ids"])

# 토크나이저 디코딩
print("\n--- Individual Token Decoding ---")
for token_id in inputs["input_ids"][0].tolist():
    print(token_id, tokenizer.convert_ids_to_tokens(token_id))
임베딩
모델의 입력 임베딩 표에는 토큰 ID별 행이 있다. 학습된 모델에 다른 토크나이저를 아무 준비 없이 연결하면 ID와 행의 대응이 깨진다. 어휘를 추가할 때는 임베딩 크기를 조정하고 새 행을 학습하는 등의 절차가 필요하다. 단순히 토크나이저 객체만 교체하는 것은 안전하지 않다.
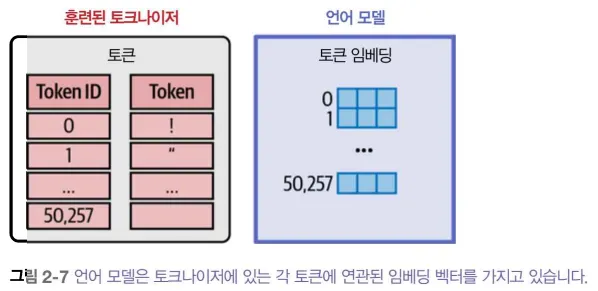
입력 임베딩 표에서 같은 ID를 꺼내면 출발 벡터는 같다. 반면 트랜스포머의 층을 지나 나온 문맥 벡터는 주변 토큰에 따라 달라진다. 아래 DeBERTa 예제에서는 last_hidden_state를 보므로 후자를 관찰한다. 실행 환경에 따라 protobuf, sentencepiece가 추가로 필요할 수 있다.
from transformers import AutoModel, AutoTokenizer

model_name = "microsoft/deberta-v3-xsmall"

# 토크나이저 로드
tokenizer = AutoTokenizer.from_pretrained(model_name)

# 기본 브랜치에는 safetensors 가중치가 없으므로 변환본 리비전을 지정
model = AutoModel.from_pretrained(
    model_name, revision="refs/pr/4", use_safetensors=True
)
model.eval()

prompt = "hello world"
tokens = tokenizer(prompt, return_tensors="pt")

# 추론에는 기울기 계산이 필요 없다
import torch
with torch.no_grad():
    output = model(**tokens)

print(f"임베딩: {output.last_hidden_state.shape}")
print("=====================================")

for token in tokens["input_ids"][0]:
    print(f"토큰화: {tokenizer.convert_ids_to_tokens(int(token))}")
출력 예시(토크나이저 버전에 따라 토큰 표기는 달라질 수 있다)
임베딩: torch.Size([1, 4, 384])
=====================================
토큰화: [CLS]
토큰화: hello
토큰화: world
토큰화: [SEP]
[1, 4, 384]는 문장 1개, 토큰 4개, 토큰당 384차원이라는 뜻이다. 예시에서 시작과 끝에 특수 토큰이 더해져 네 위치가 되었다. 길이 384는 DeBERTa V3 xsmall 모델 설정의 hidden_size다. 기본 브랜치는 PyTorch .bin 가중치만 제공하므로 위 코드는 safetensors 변환본 리비전을 지정했다. 문장이나 토크나이저 설정이 달라지면 가운데 길이 4는 달라지지만, 같은 모델의 은닉 차원은 그대로다.
output.last_hidden_state[0, 1]은 첫 문장의 두 번째 토큰이 마지막 층을 통과한 뒤 가진 벡터다. "hello world"의 hello와 "hello there"의 hello는 입력 임베딩 표에서는 같은 ID를 찾아도 최종 은닉 벡터는 주변 단어 때문에 달라질 수 있다. 토큰 하나의 벡터를 바로 문장 유사도에 쓰면 안 된다. 문장 전체를 비교하려면 풀링 방법 또는 문장 유사도 목적에 맞춰 훈련한 모델을 선택해야 한다.
output 전체를 출력하면 다음처럼 메타데이터와 큰 텐서가 함께 보인다. 아래 숫자는 과거 실행 예시이며 실행 환경에 따른 동일한 수치를 기대하지 않는다.
```python
임베딩: BaseModelOutput(last_hidden_state=tensor([[[-3.3296, -0.0132, -0.1874,  ..., -0.1674, -0.2151,  0.8809],
         [ 1.2704,  0.4024,  0.6584,  ..., -0.5792,  0.9496,  0.5758],
         [ 0.6423,  0.2354,  0.2941,  ...,  0.3958, -0.2798,  1.8824],
         [-3.1477, -0.0229, -0.0343,  ..., -0.1395, -0.1901,  0.7430]]],
       grad_fn=<NativeLayerNormBackward0>), hidden_states=None, attentions=None
```
정적 단어 벡터와 비교
이번에는 문장 문맥을 읽지 않는 GloVe 단어 벡터를 본다. GloVe와 word2vec은 서로 다른 학습 방법이지만, 둘 다 단어별 고정 벡터를 조회하는 예로 사용할 수 있다. gensim을 설치하고 처음 실행할 때는 모델 파일을 내려받는다.
import gensim.downloader as api

# 사전 훈련된 word embedding 로드
# 예시 1: GloVe (Wikipedia 기반, 300차원)
model = api.load("glove-wiki-gigaword-300")

# 예시 2: Google News Word2Vec (300차원)
# model = api.load("word2vec-google-news-300")

# 특정 단어 벡터 확인
vector = model["king"]
print(vector.shape)   # (300,)

# 가장 유사한 단어들
print(model.most_similar("king", topn=10))king은 어떤 문장에 있든 같은 300차원 벡터를 돌려준다. most_similar는 이 벡터와 코사인 유사도가 큰 다른 단어를 찾는다. 값이 1에 가까울수록 방향이 비슷하다. 아래의 이웃과 점수는 예시 출력이며, 가까운 단어가 항상 같은 뜻이라는 보장은 없다. king과 kingdom처럼 주제가 관련될 수도, 자주 함께 등장하는 단어일 수도 있다.
```python
[
	('queen', 0.6336469054222107),
	('prince', 0.6196622848510742),
	('monarch', 0.5899620652198792),
	('kingdom', 0.5791266560554504),
	('throne', 0.5606487989425659),
	('ii', 0.5562329292297363),
	('iii', 0.5503199100494385),
	('crown', 0.5224862694740295),
	('reign', 0.5217353701591492),
	('kings', 0.5066401958465576)
]
```
음악 추천 시스템
단어 대신 곡 ID를 토큰으로 생각하면 같은 원리를 추천에 적용할 수 있다. 한 플레이리스트의 곡 목록을 한 문장으로 보고 Word2Vec을 훈련한다. 주변 곡을 잘 예측하도록 학습된 벡터에서 가까운 곡을 추천 후보로 꺼낸다. 이 예제는 가사나 소리를 분석하지 않는다. 따라서 비슷한 플레이리스트에 함께 등장했다는 관계를 학습한다.
아래 공개 데이터 URL은 외부 파일에 의존한다. 네트워크 연결과 파일 제공 상태를 확인한 후 실행해야 한다.
import pandas as pd
from urllib import request
from gensim.models import Word2Vec

data = request.urlopen("https://storage.googleapis.com/maps-premium/dataset/yes_complete/train.txt")

lines = data.read().decode("utf-8").split("\n")[2:]

playlists = [s.rstrip().split() for s in lines if len(s.split()) > 1]

songs_file = request.urlopen("https://storage.googleapis.com/maps-premium/dataset/yes_complete/song_hash.txt")
songs_file = songs_file.read().decode("utf-8").split('\n')
songs = [parts for line in songs_file if len(parts := line.rstrip().split('\t')) == 3]
songs_df = pd.DataFrame(data=songs, columns= ['id', 'title', 'artist'])
songs_df = songs_df.set_index('id')

model = Word2Vec(playlists, vector_size=32, window=20, negative=50, min_count=1, workers=4)

song_id = 2172
model.wv.most_similar(positive=str(song_id))

print(songs_df.loc[str(song_id)])

def print_recommendations(_song_id):
    similar_ids = [song for song, _score in model.wv.most_similar(str(_song_id), topn=5)]
    return songs_df.reindex(similar_ids)

print(print_recommendations(song_id))vector_size=32는 곡 벡터의 길이, window=20은 주변 곡으로 취급할 범위, negative=50은 훈련 시 사용하는 음성 샘플 수다. most_similar가 돌려주는 첫 값은 곡 ID 문자열이므로 songs_df.iloc의 행 번호가 아닌 .reindex의 레이블로 조회한다. 추천 목록에 제목이 비어 있다면 메타데이터에 해당 ID가 없거나 파싱 규칙이 맞지 않은 것이다.
이 방식은 플레이리스트에 거의 등장하지 않는 곡의 벡터가 불안정하고, 인기 곡이 여러 종류의 목록에 섞여 나타나는 편향도 있다. 실제 추천이라면 일부 곡을 숨긴 뒤 나머지로 숨긴 곡을 얼마나 잘 찾아내는지 평가하고, 인기곡만 추천하는 기준선과 비교해야 한다.
참고 자료
- Hugging Face 토크나이저 문서: 특수 토큰, ID 변환, 채팅 템플릿.
- Hugging Face 모델 출력 문서:
last_hidden_state의 차원. - Gensim Word2Vec 문서: 단어 벡터와 유사도 조회.
같은 카테고리의 글
이어서 읽을 글
10. 텍스트 임베딩 모델 만들기
질문과 문서를 벡터로 표현하고 대조 학습과 검색 지표로 임베딩 모델을 개선하는 방법
11. 자신의 데이터에 맞춘 임베딩 모델 만들기 : RAG 개선하기
질문·문서 쌍으로 임베딩 모델을 미세 튜닝하고 RAG 검색과 답변 품질을 평가하는 방법을 정리합니다.
10. 임베딩 모델로 데이터 의미 압축하기
문장 임베딩과 코사인 유사도로 의미 검색을 구현하고, 청크 설계와 검색 평가 기준을 정리합니다.
12. 생성 모델 미세 튜닝하기
지도 미세 튜닝 데이터와 LoRA 학습, 근거에 충실한 생성 답변의 평가 방법