목차
연결 리스트(Linked List): 포인터를 바꾸어 삽입하기
배열은 인덱스로 원소를 바로 찾지만 중간에 끼워 넣으려면 뒤 원소를 옮겨야 한다. 연결 리스트는 각 노드가 데이터와 다음 노드의 참조를 저장한다. 노드의 메모리 주소가 연속될 필요는 없다. 이미 삽입할 위치의 이전 노드를 알고 있다면 참조 두 개를 바꾸어 O(1)에 삽입할 수 있다. 그러나 그 위치를 처음부터 찾는 데에는 O(n)이 걸린다. 이 차이를 구분하지 않으면 연결 리스트가 언제나 빠르다고 오해하기 쉽다.
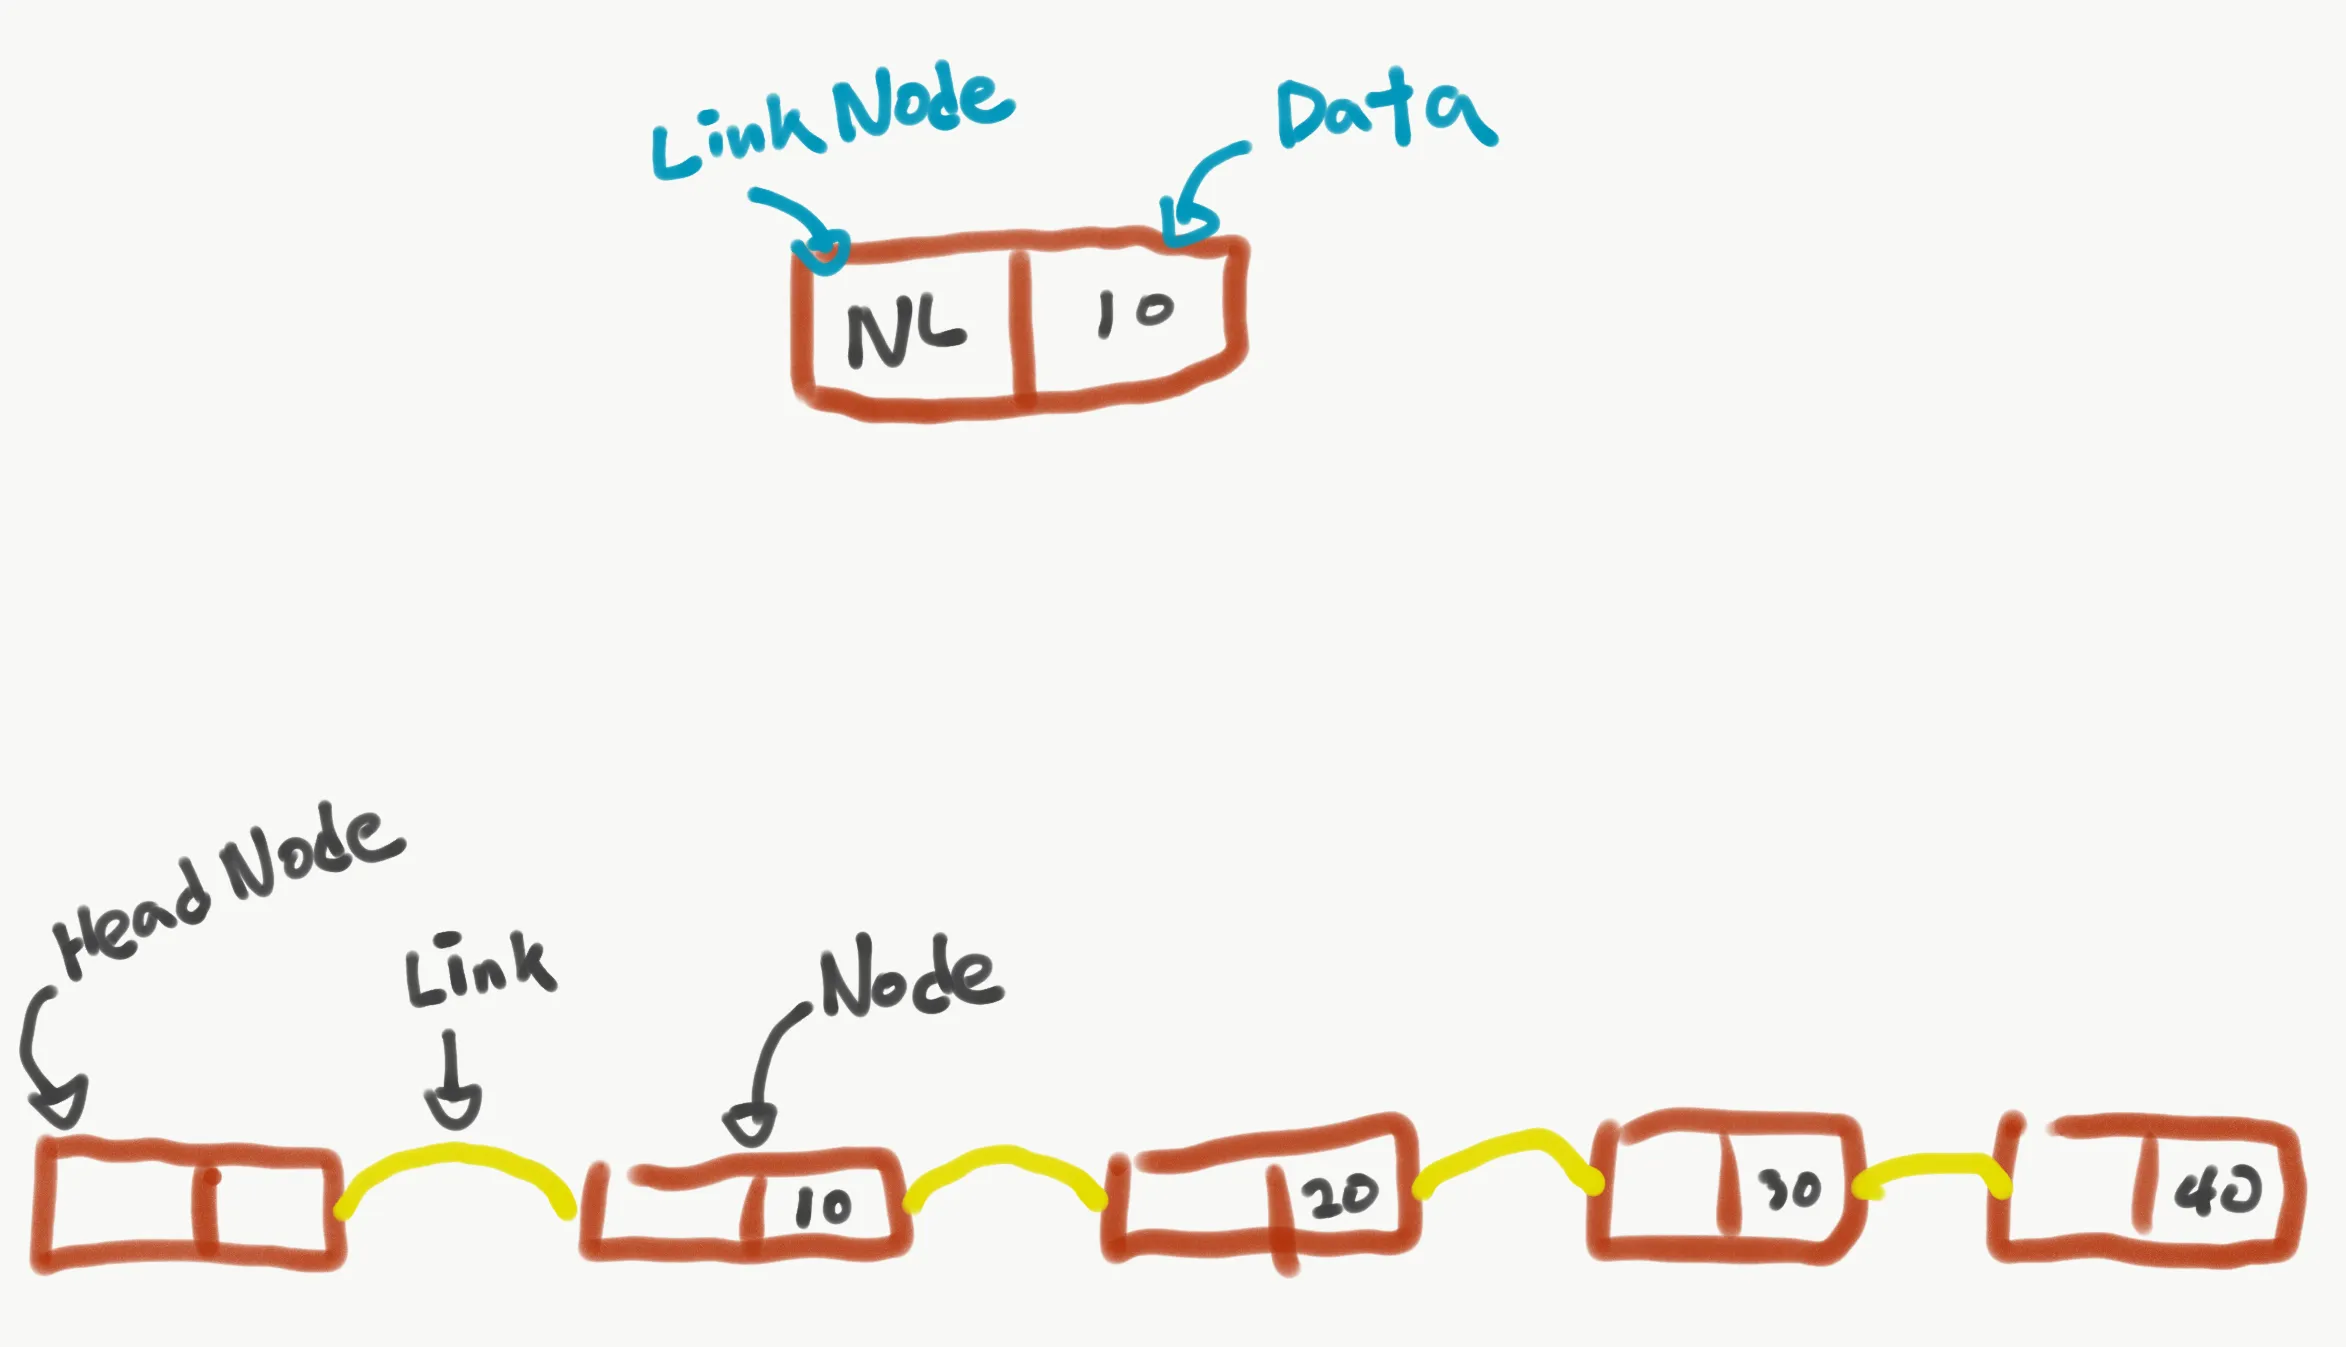
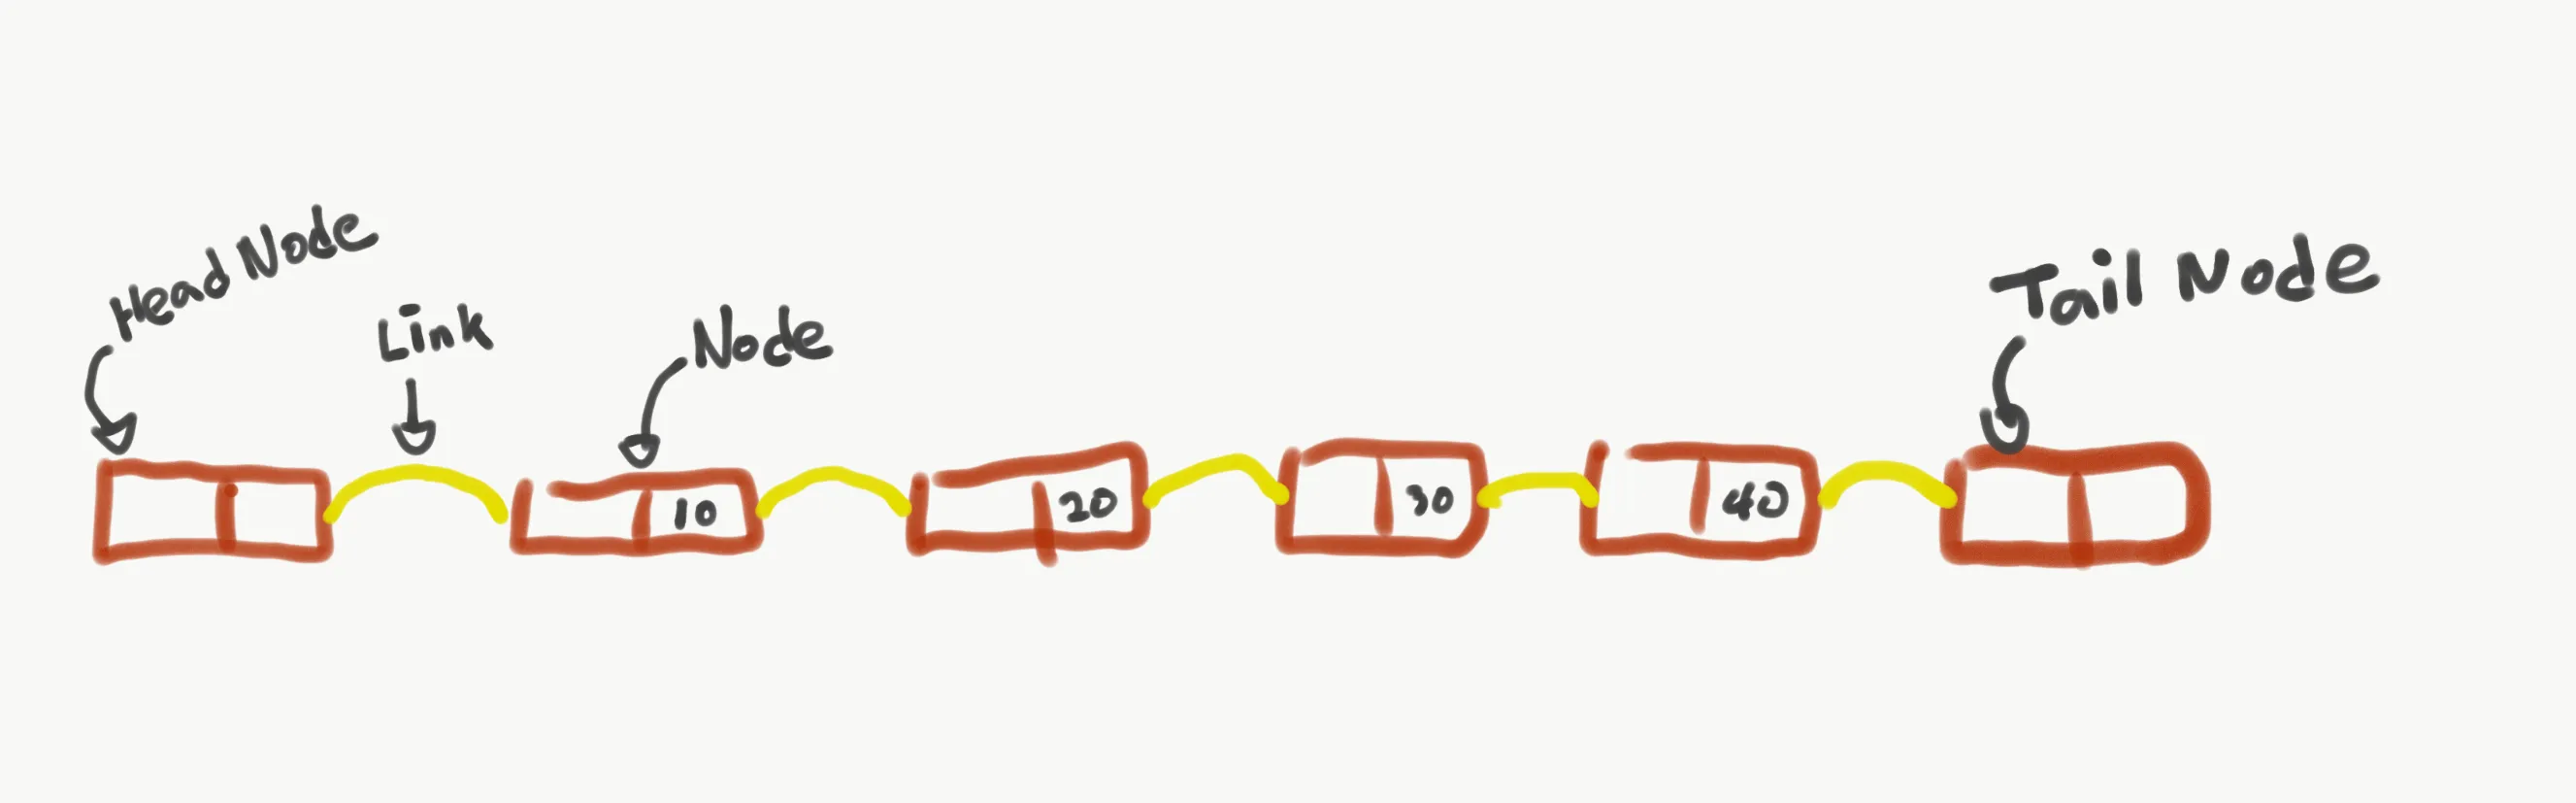
그림의 화살표는 각 노드가 저장한 다음 노드의 주소다. 끝 노드의 다음 참조는 단순 연결 리스트에서 null이다. 구현에 따라 헤드는 첫 데이터 노드 자체일 수도 있고, 데이터를 담지 않는 감시 노드(sentinel)를 뜻할 수도 있다. 테일 또한 마지막 데이터 노드를 가리키거나 별도의 감시 노드일 수 있다. 이 글의 Java 코드는 빈 리스트에서 head와 tail이 모두 null이며, 두 포인터 모두 실제 데이터 노드를 가리킨다.
배열과 비교해 선택하기
| 연산 | 동적 배열 | 단순 연결 리스트 |
|---|---|---|
| 인덱스 i 읽기 | O(1) | O(n) |
| 맨 앞 삽입·삭제 | O(n) 이동 | O(1) |
| 맨 뒤 삽입 | 평균 O(1), 확장 시 O(n) | tail 유지 시 O(1) |
| 위치를 찾은 뒤 삽입 | O(n) 이동 | 이전 노드가 있으면 O(1) |
| 순차 순회 | O(n), 연속 메모리로 캐시 친화적 | O(n), 노드마다 참조 추적 |
연결 리스트에는 노드마다 참조 저장 공간과 객체 할당 비용이 든다. 참조 크기를 언제나 4바이트라고 가정할 수 없다. 프로세스·런타임·압축 참조 설정에 따라 달라진다. 데이터가 많고 인덱스 접근이 잦다면 배열이 더 자연스럽다. 리스트가 유리한 곳은 현재 노드를 이미 알고 있고, 그 주변을 자주 연결·분리하는 작업이다.
B와 D 사이에 C를 끼워 넣는 순서
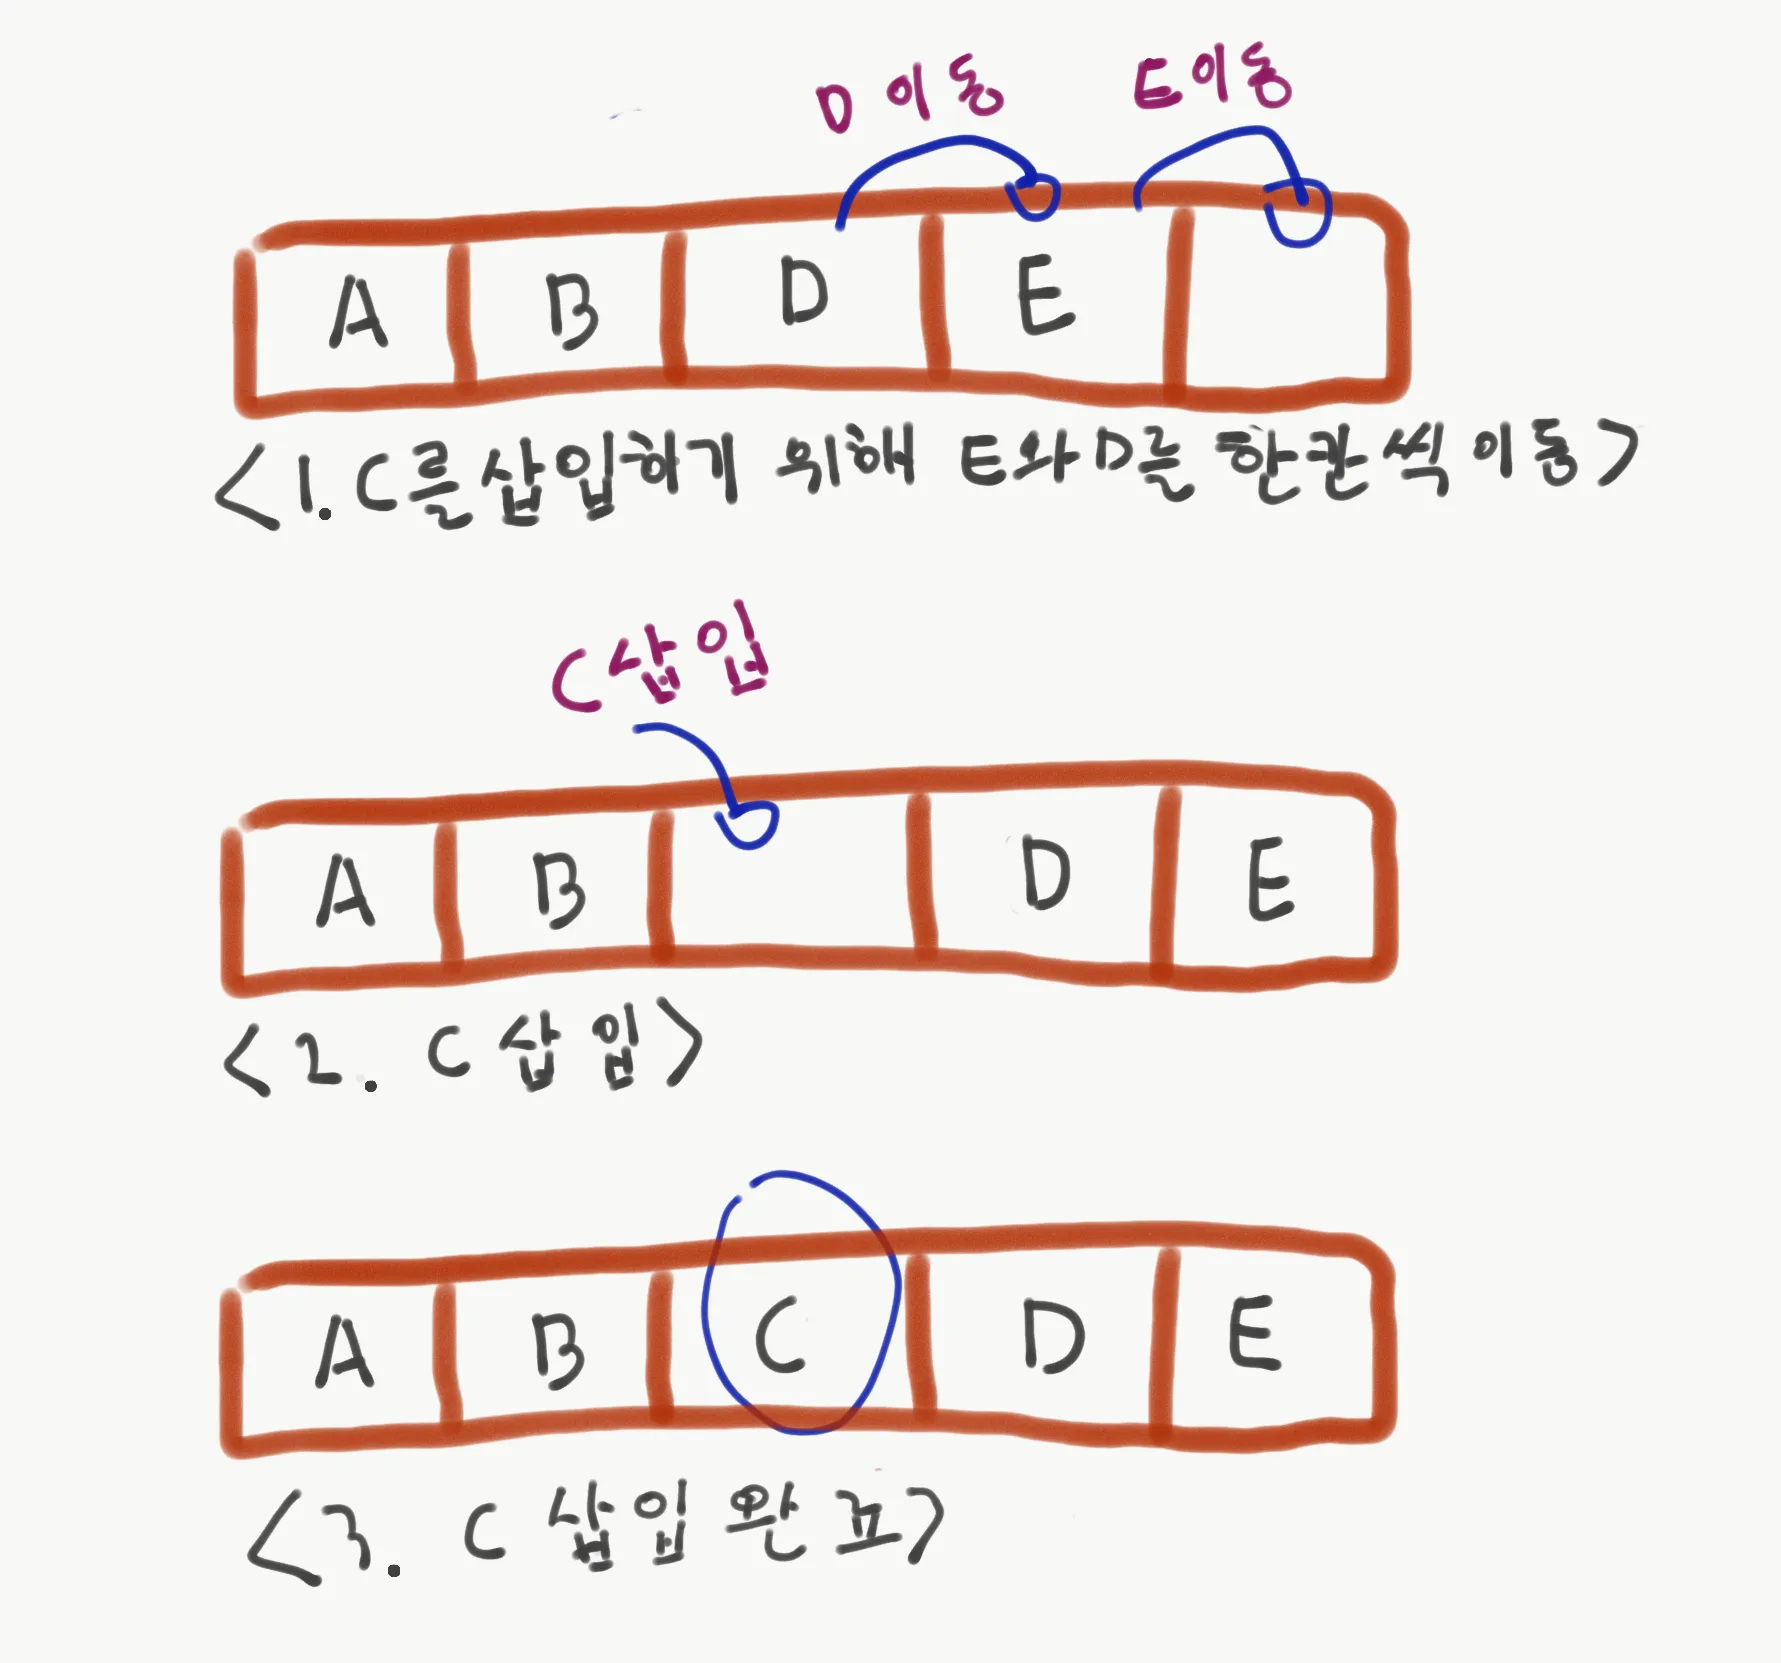
현재 B.next가 D를 가리킨다고 하자. 먼저 C.next에 D를 저장하고, 그다음 B.next를 C로 바꾼다. 순서를 거꾸로 하여 B.next를 먼저 C로 바꾸면 원래 D를 가리키던 유일한 연결을 잃을 수 있다. 삭제는 반대다. B.next가 C일 때 B.next를 C.next로 바꾸고 C의 연결을 끊는다. Java에서는 다른 참조가 없다면 C는 가비지 컬렉터의 대상이 된다. C에서는 직접 free로 메모리를 해제해야 한다.
import java.util.NoSuchElementException;

public class SimpleList<T> {
    private static class Node<T> {
        T value;
        Node<T> next;
        Node(T value) { this.value = value; }
    }

    private Node<T> head;
    private Node<T> tail;
    private int size;

    public void addFirst(T value) {
        Node<T> node = new Node<>(value);
        node.next = head;             // 기존 첫 노드 보존
        head = node;
        if (tail == null) tail = node; // 빈 리스트였을 때만
        size++;
    }

    public void addLast(T value) {
        Node<T> node = new Node<>(value);
        if (tail == null) head = node;
        else tail.next = node;
        tail = node;
        size++;
    }

    public T removeFirst() {
        if (head == null) throw new NoSuchElementException();
        T value = head.value;
        head = head.next;
        if (head == null) tail = null;
        size--;
        return value;
    }

    public boolean removeFirstMatch(T target) {
        Node<T> previous = null;
        Node<T> current = head;
        while (current != null) {
            if (java.util.Objects.equals(current.value, target)) {
                if (previous == null) head = current.next;
                else previous.next = current.next;
                if (tail == current) tail = previous;
                current.next = null;
                size--;
                return true;
            }
            previous = current;
            current = current.next;
        }
        return false;
    }

    public int size() { return size; }
}
불변식은 세 가지다. 빈 리스트라면 head와 tail 모두 null이다. 비어 있지 않다면 tail.next는 null이다. size는 head에서 따라갈 수 있는 데이터 노드 수와 같다. addFirst는 이전 head를 새 노드에 연결하고, 빈 리스트에서만 tail도 설정한다. removeFirst는 마지막 노드를 꺼낸 뒤 tail까지 null로 만들어 불변식을 복구한다. removeFirstMatch는 이전 노드를 기억하므로 중간 연결을 건너뛸 수 있다. head나 tail이 삭제 대상인 두 경계 경우를 별도로 처리한다.
예를 들어 빈 리스트에 addLast(A), addLast(B), addLast(D)를 적용하면 A→B→D가 된다. B 노드 자체를 이미 가지고 있다면 C를 삽입하는 두 참조 변경은 O(1)이지만, 이 공개 API처럼 값으로 B를 검색한다면 검색은 O(n)이다. A를 지울 때는 head를 B로, D를 지울 때는 tail을 B로 바꿔야 한다. 삭제 대상이 없을 때는 false를 반환하고 구조를 건드리지 않는다.
typedef struct Node {
    char value;
    struct Node *next;
} Node;

void insertAfter(Node *previous, Node *fresh) {
    if (previous == NULL || fresh == NULL) return;
    fresh->next = previous->next;
    previous->next = fresh;
}

Node *detachAfter(Node *previous) {
    if (previous == NULL || previous->next == NULL) return NULL;
    Node *removed = previous->next;
    previous->next = removed->next;
    removed->next = NULL;
    return removed; // 호출자가 데이터를 사용한 뒤 free(removed)
}
C 예제는 이전 노드가 실제 리스트에 속하고 fresh가 다른 리스트에 연결되어 있지 않다는 전제가 있다. detachAfter는 소유권을 호출자에게 넘기며 스스로 해제하지 않는다. 이런 계약을 명시하지 않으면 이중 해제나 메모리 누수가 발생하기 쉽다. 또한 이 두 함수만으로는 리스트의 head와 tail을 갱신할 수 없으므로 맨 앞·맨 뒤 처리는 리스트 객체가 맡아야 한다.
원형 연결 리스트(Circular Linked List)
원형 연결 리스트는 마지막 노드의 next가 첫 노드를 가리킨다. 빈 리스트에서는 tail이 null, 원소가 있다면 tail.next가 head라는 불변식이 편리하다. 이 구조를 이용하면 라운드 로빈 스케줄처럼 끝에 도달한 후 처음으로 되돌아가는 순회를 만들 수 있다.
import java.util.NoSuchElementException;

public class CircularList<T> {
    private static class Node<T> {
        T value;
        Node<T> next;
        Node(T value) { this.value = value; }
    }
    private Node<T> tail;
    private int size;

    public void addLast(T value) {
        Node<T> node = new Node<>(value);
        if (tail == null) {
            node.next = node;
        } else {
            node.next = tail.next; // 기존 첫 노드
            tail.next = node;
        }
        tail = node;
        size++;
    }

    public T removeFirst() {
        if (tail == null) throw new NoSuchElementException();
        Node<T> first = tail.next;
        if (first == tail) tail = null; // 원소 하나
        else tail.next = first.next;
        first.next = null;
        size--;
        return first.value;
    }

    public int size() { return size; }
}
A, B, C를 차례로 넣으면 tail은 C이고 tail.next는 A다. A를 꺼내면 C.next를 B로 바꾼다. 원소가 하나일 때는 자기 자신을 가리키던 연결을 끊고 tail을 null로 만든다. 원형 리스트의 순회에는 null 종료 조건이 없으므로 시작 노드로 다시 돌아왔는지 비교하거나 size개만 방문해야 한다. 이 예제의 삽입·첫 노드 제거는 모두 O(1)이다.
이중 연결 리스트(Doubly Linked List)
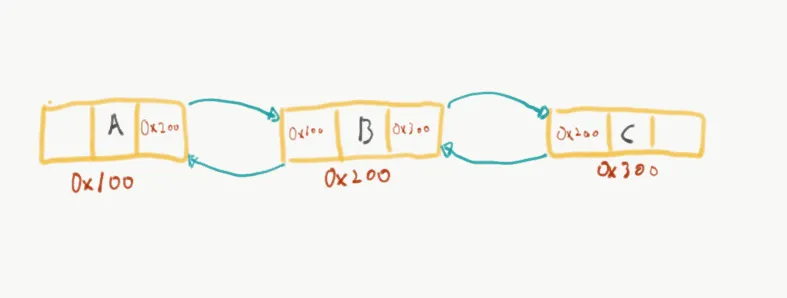
이중 연결 리스트는 각 노드가 prev와 next를 모두 저장한다. 주어진 노드 바로 앞뒤로 이동할 수 있고, 삭제할 노드 자체를 알고 있다면 이전 노드를 처음부터 찾지 않고 O(1)에 제거할 수 있다. 대신 노드마다 참조가 하나 더 필요하며, 연결을 수정할 때 양쪽 포인터를 함께 맞춰야 한다.
import java.util.NoSuchElementException;

public class DoubleList<T> {
    private static class Node<T> {
        T value;
        Node<T> prev, next;
        Node(T value) { this.value = value; }
    }
    private Node<T> head, tail;
    private int size;

    public void addLast(T value) {
        Node<T> node = new Node<>(value);
        node.prev = tail;
        if (tail == null) head = node;
        else tail.next = node;
        tail = node;
        size++;
    }

    public T removeLast() {
        if (tail == null) throw new NoSuchElementException();
        Node<T> removed = tail;
        tail = removed.prev;
        if (tail == null) head = null;
        else tail.next = null;
        removed.prev = null;
        size--;
        return removed.value;
    }

    public int size() { return size; }
}
A→B→C에서 C를 제거할 때 C.prev인 B를 새 tail로 삼고 B.next를 null로 만든다. 원소가 하나라면 head까지 null로 바꾼다. head.prev와 tail.next는 항상 null이어야 한다. 앞쪽·뒤쪽 삭제가 모두 잦다면 이중 연결 리스트가 단순 연결 리스트보다 구현이 쉽다. 반면 인덱스 접근이 중심이라면 배열을 선택하는 편이 낫다.
구현을 고를 때
단순 연결 리스트는 참조 하나로 가볍고 앞쪽 작업에 적합하다. 원형 리스트는 반복 순회를 간단히 만들지만 종료 조건을 주의해야 한다. 이중 연결 리스트는 주어진 노드를 O(1)에 떼어낼 수 있지만 양방향 연결을 일관되게 유지해야 한다. 어떤 형태든 전체 탐색은 O(n)이며, 메모리 할당 실패(C), 빈 리스트, 첫·마지막 노드, 중복 값의 처리 방침을 먼저 정해야 한다.
같은 카테고리의 글
이어서 읽을 글
단순 연결리스트(Simple Linked List)
더미 노드와 tail을 둔 Java 단순 연결 리스트를 직접 구현하며 삽입·삭제 때 참조와 크기 불변식이 어떻게 바뀌는지 추적한다.
8. 해싱(Hashing)
키를 버킷 주소로 바꾸는 해시 함수, 충돌 해결, 적재율과 Java HashMap의 선택 기준을 작은 예제로 설명한다.
7. PriorityQueue(우선순위 큐)
우선순위 큐를 최소 힙으로 구현하면서 삽입 시 위로 올리기, 삭제 시 아래로 내리기와 배열 인덱스 계산을 예제로 설명한다.
6. hash(해시)
해시 함수가 키를 배열 인덱스로 바꾸는 과정, 충돌 해결, 적재율과 재해싱을 실제 코드로 살펴봅니다.