목차
LLM은 무상태(stateless)로 상호작용.
- 프롬프트나 응답 내용을 전혀 저장하지 않는다는 의미
LLM이 이런 정보를 제공하려면 이전 대화와 컨텍스트를 추적할 견고한 메모리 시스템이 필요
- 최종 프롬프트는 기록된 정보를 LLM으로 전달하며 이를 통해 일종의 기억(메모리)이 부여
기본적인 메모리 기능을 탑재한 RAG 프로젝트 구성
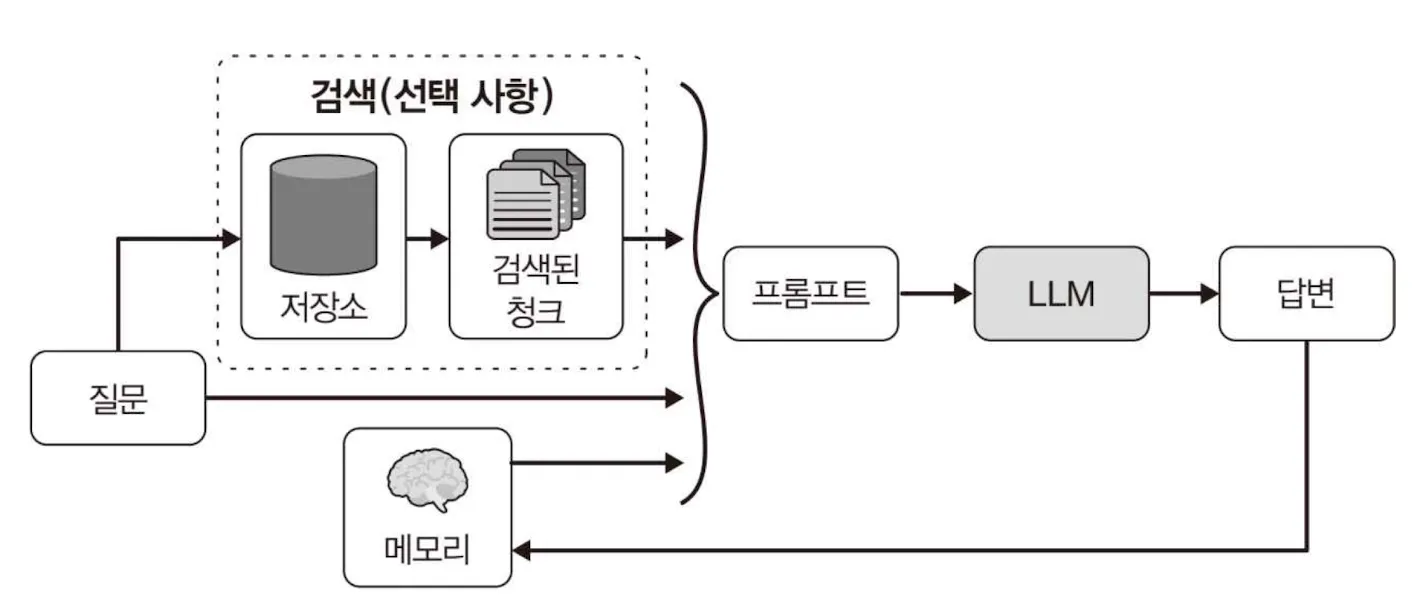
챗봇 메모리 시스템 구축
메모리 시스템 근간을 이루는 두 가지 핵심 설계 결정
- 상태 저장 방식
- 상태 쿼리 방식
간단한 챗봇 메모리 시스템 구축방법은 사용자와 채팅 모델의 모든 대화 기록을 저장해 재활용
- 메시지 목록 형태로 저장
- 턴마다 최근 메시지를 추가해 업데이트
- 메시지를 프롬프트에 추가
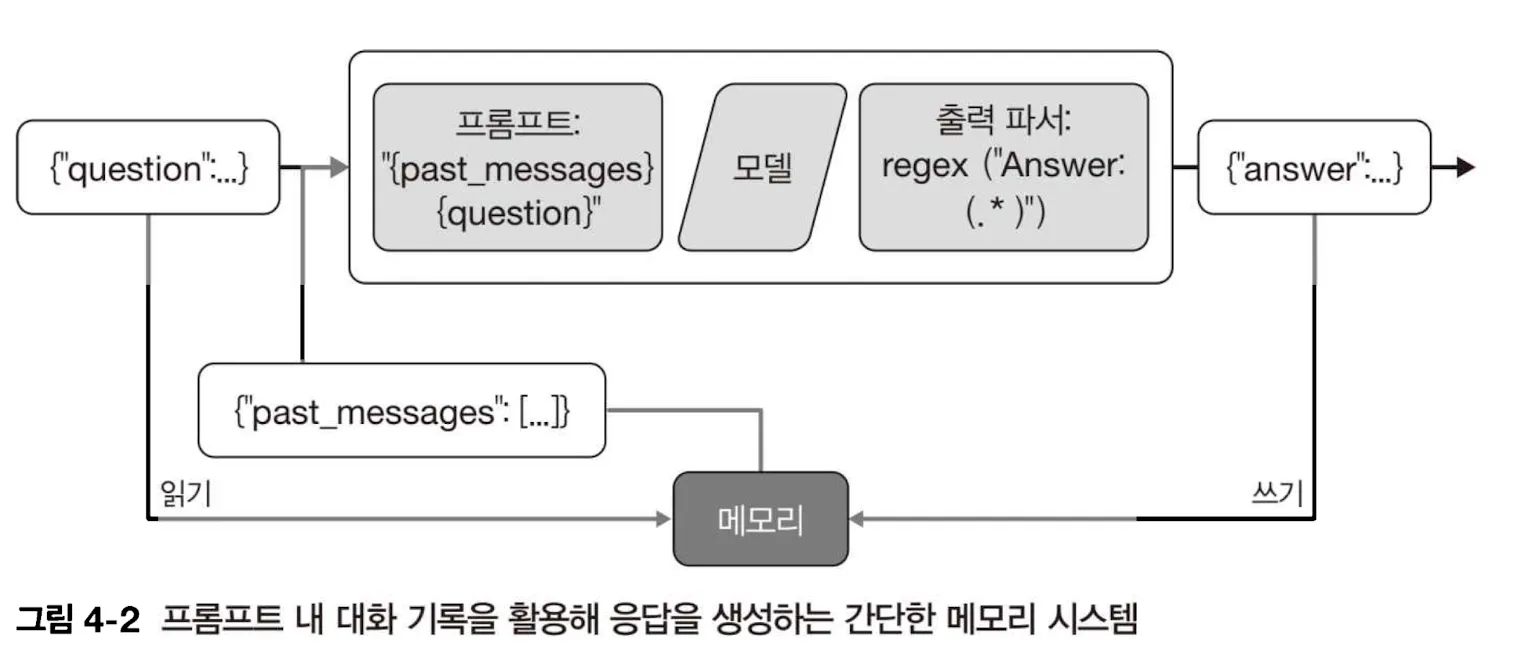
from langchain_core.prompts import ChatPromptTemplate
from langchain_ollama import ChatOllama

from config.load_sys import gemma_model

prompt = ChatPromptTemplate.from_messages([
    ('system','당신은 친절한 어시스턴트 입니다. 모든 질문에 최선을 다해 답하세요.'),
    ('placeholder', '{message}')
])

model = ChatOllama(model=gemma_model)

chain = prompt | model

response = chain.invoke({
    'message': [
        ('human','다음 한국어 문장을 프랑스어로 번역하세요. : 나는 프로그래밍을 좋아해요.'),
        ('ai', 'J\'adore programmer.'),
        ('human', '뭐라고 말했지?')
    ]
})

print(response.content)
"J'adore programmer." 라고 말했습니다.
이 문장은 "나는 프로그래밍을 좋아해요." 라는 한국어 문장을 프랑스어로 번역한 것입니다.
* **J'adore:** ~을 정말 좋아해요
* **programmer:** 프로그래밍하다 (동사)
혹시 다른 질문 있으신가요?체인은 이전 대화 내용을 반영해 후속 질문에 컨텍스트롤 고려하여 적절한 응답을 출력
[대규모 메모리 관리에서 문제점]
- 모든 상호작용 후 메모리를 하나씩 업데이트해야 한다(오류가 발생할 수 있으니 질문만 저장하거나 답변만 저장하는 일은 피한다)
- 메모리 자료를 관계형 데이터베이스 등 내구성이 뛰어난 저장소에 보관한다.
- 이후 활용할 메시지의 종류와 개수를 선택해 저장하고, 이 중 새로운 상호작용에 사용할 메시지의 수를 조절
- LLM 호출 이외의 영역에서 상태(현재 단순한 메시지 목록)을 점검하고 수정하는 것이 좋다.
랭그래프(LangGraph)
랭체인에서 제작한 오픈소스 라이브러리로 개발자가 그래프라는 다중 액터(multiactor), 다단계(multistep), 상태저장 인지 아키텍처 구조를 쉽게 표현할 수 있게 지원.
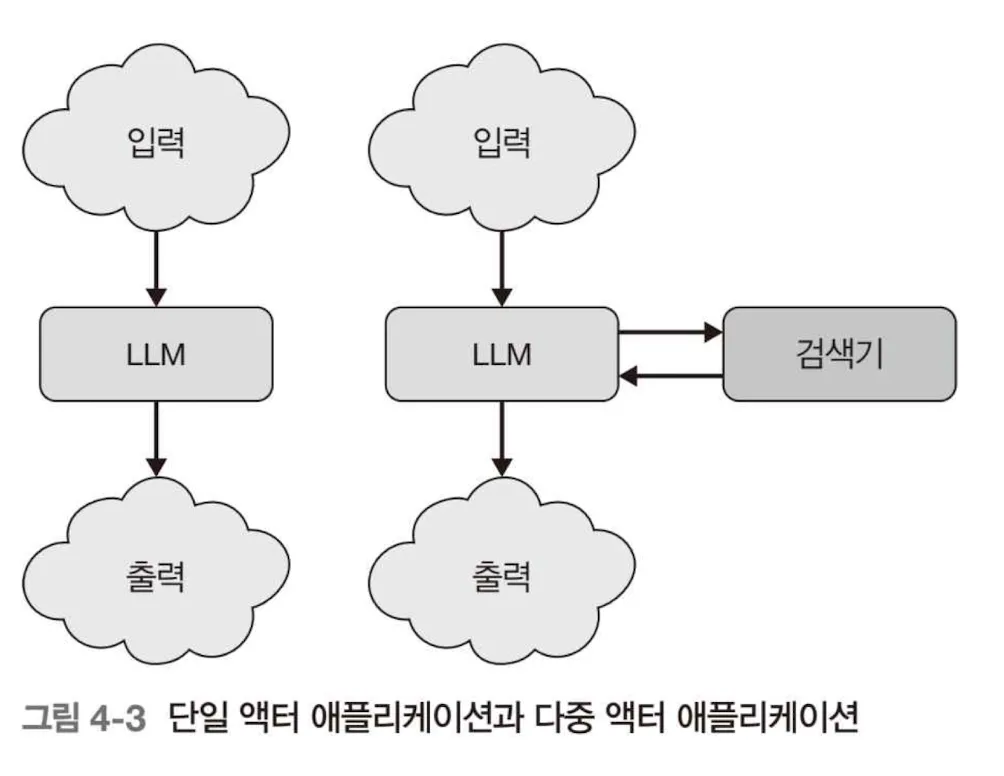
답변 생성, 작업 계획 수립 등 다방면에서 우수한 성능을 보이는 LLM 프롬프트는 최신 정보를 신속하게 파악할 검색 엔진이나 다른 LLM 프롬프트와 결합하면 효율이 증대된다.
[협력하기 위한 체계적인 조정 계층]
- 그래프에서 액터를 노드로 정의한 후, 액터 간에 업무가 전달되는 방식을 엣지로 나타냄
- 각 액터의 실행을 적절한 시점에 배치(필요시 병렬 처리)하고, 일정한 결과가 나오도록 한다.
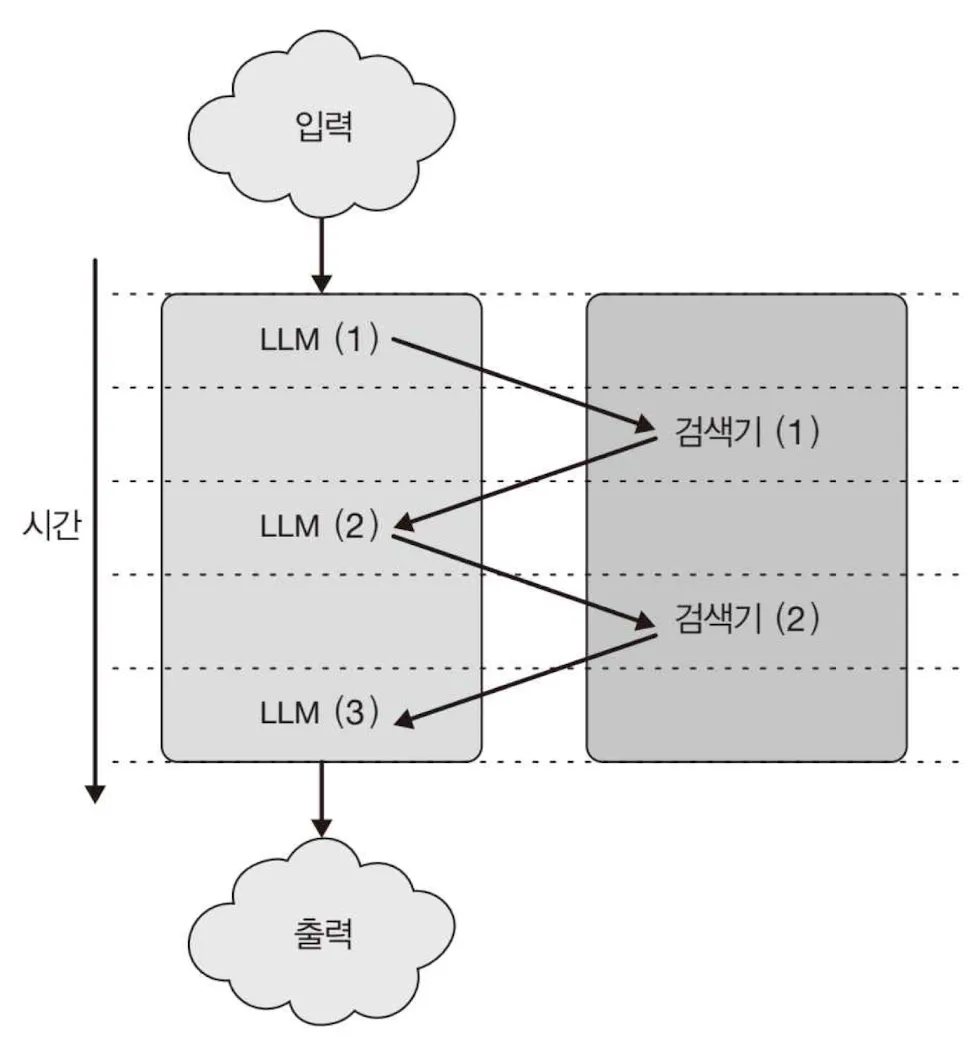
LLM 프롬프트가 검색 툴을 통해 특정 쿼리 결과를 요청하는 경우와 같이 각 액터가 작업을 다른 액터에게 전달할 때 액터끼리 주고받는 작업을 명확히 파악.
- 발생 순서와 각 액터의 호출 횟수 등 구체적인 정보가 필요
- 액터 간 상호작용을 여러 개의 독립된 시간 단계로 구분해 모델링
- 한 액터가 다른 액터에게 업무를 전달하면 다음 단계가 시작되며, 이러한 업무 인계가 연속적으로 이루어져 더 이상 인계할 대상이 없다면 최종 결과에 도달.
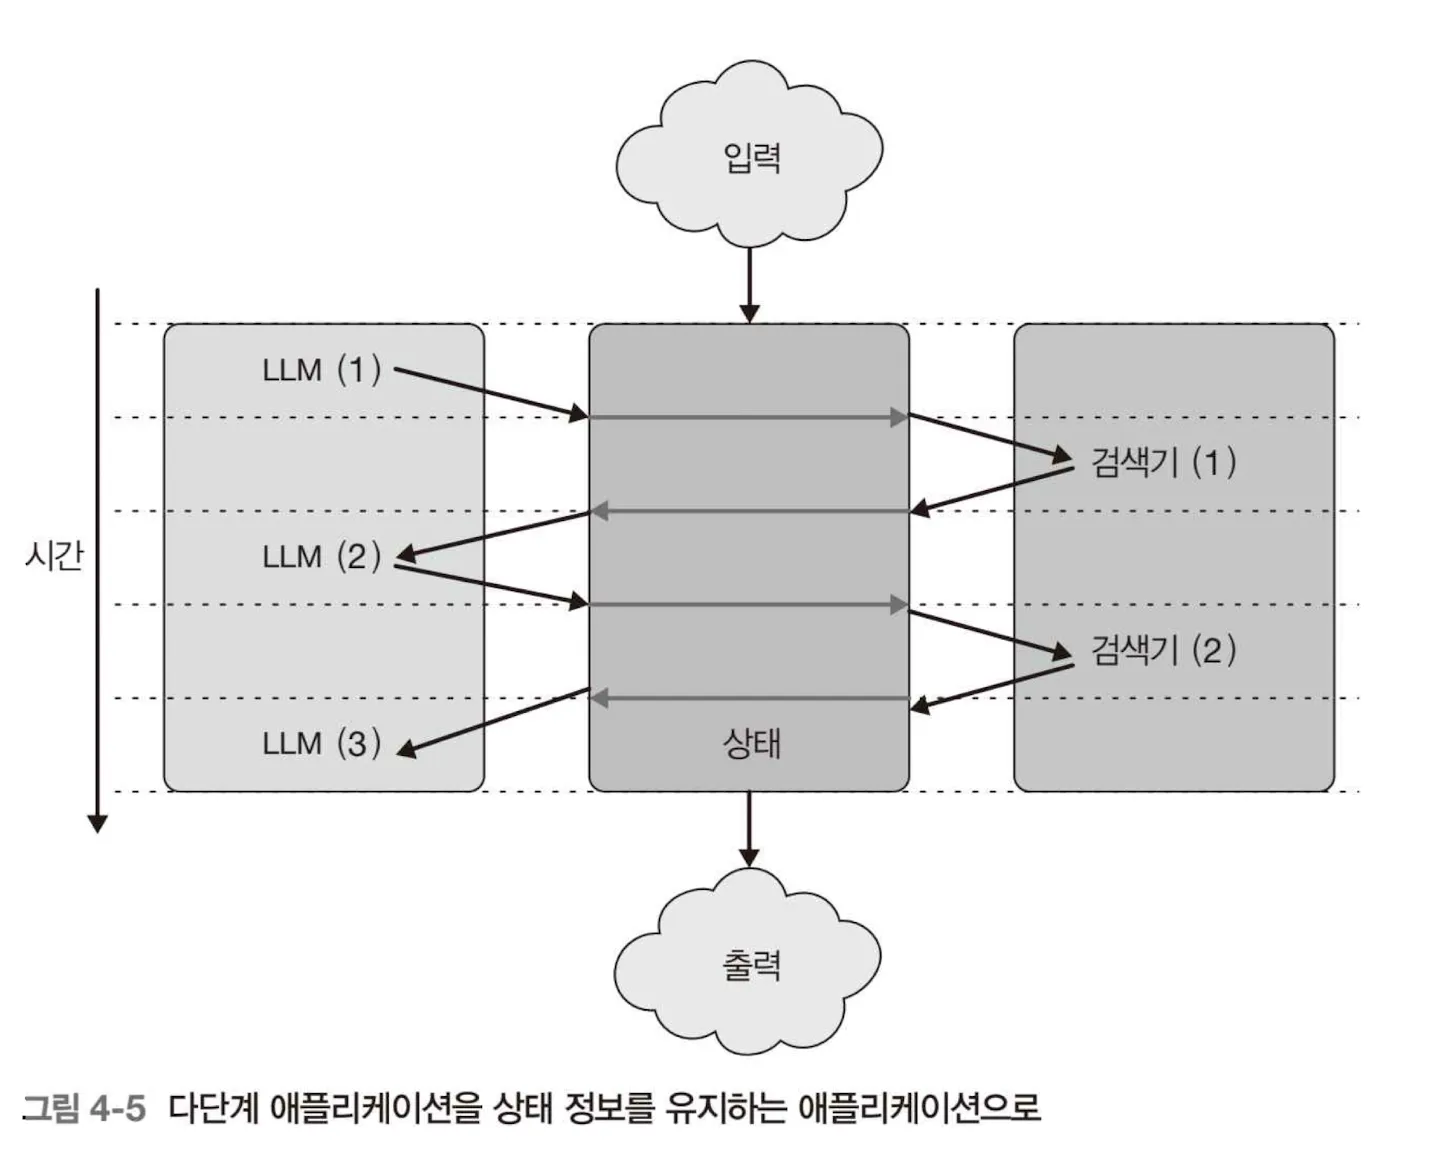
단계 간 통신에선 반드시 상태를 추적. 상태 관리가 미흡하면 LLM 액터를 재호출 해도 첫 번째 실행과 같은 결과가 발생. 이 때 여러 액터가 각자 상태를 분리해 하나의 중앙 상태를 공유하고 갱신하는 방식이 유용.
[중앙 상태 기능 도잆하면 다음과 같은 기능 구현]
- 각 계산 과정 중 또는 계산 완료 후에 중심 상태를 스냅샷해 저장
- 오류 발생 시 손쉽게 복구할 수 있도록 실행을 일시 정지하고 재개
- 사용자 개입 제어 체계를 구현
그래프는 상태, 노드, 엣지로 구성
- 상태 : 외부에서 받은 데이터, 애플리케이션이 실행되는 동안 변경되고 생성
- 노드 : 진행할 단계. 노드는 주로 파이썬이나 JS 함수. 현재 상태를 입력받아 업데이트(데이터를 추가하거나 수정하고 삭제 할 수 있다).
- 엣지 : 노드 사이 연결 관계. 엣지는 첫 번째 노드에서 마지막 노드까지 이어지는 경로를 나타냄. 엣지는 고정 엣지와 조건부 엣지가 있다.
[랭그래프 설치 명령]
[pip]
pip install langgraph
or
[uv]
uv add langgraph
[랭체인과 랭그래프 비교]
| 특성 | LangChain (Chains) | LangGraph |
|---|---|---|
| 구조 | DAG (비순환, 일방통행) | Graph (순환 가능, 루프) |
| 흐름 제어 | 미리 정의된 순서대로 실행 | 조건에 따라 동적으로 경로 변경 및 반복 |
| 적합한 작업 | 단순 QA, 요약, 데이터 추출 | 복잡한 문제 해결, 코딩, 자율 에이전트 |
| 상태 공유 | 단계 간 데이터 전달이 제한적 | 전역 State를 통해 모든 노드가 데이터 공유 |
StateGraph 생성
[상태 그래프 생성]
from typing import TypedDict, Annotated

from langgraph.graph import StateGraph, add_messages

from config.load_sys import gemma_model

# 1. 상태 그래프 생성

class State(TypedDict):
    messages: Annotated[list, add_messages]

builder = StateGraph(State)
이제 그래프는 두 가지 일을 한다.
- 정의된 모든 node는 현재 State를 입력받아 해당 상태를 갱신하는 값을 반환
- messages는 직접 덮어쓴느 대신, 현재 목록에 새 메시지를 추가.
- 파이썬 Annotated 구문에 지정한 add_messages 함수는 리듀서 함수가 이 역할을 맏는다.
[노드추가]
# 2. 노드 추가
from langchain_ollama import ChatOllama

model = ChatOllama(model=gemma_model)

def chatbot(state: State):
    answer = model.invoke(state['messages'])
    return {'messages': [answer]}

## 챗봇노드 추가
## 첫 번째 인자는 고유한 노드 이름
## 두 번재 인자는 실행할 함수 or Runnable
builder.add_node('chatbot', chatbot)
[엣지 추가]
# 3. 엣지 추가
builder.add_edge(START, 'chatbot')
builder.add_edge('chatbot', END)

graph = builder.compile()
엣지의 역할
- 실행할 때마다 그래프의 시작 작업 위치를 지정
- 그래프 종료 지점을 지정하는 역할을 한다. (선택사항으로 노드가 더 이상 실행되지 않으면 랭그래프가 자동으로 종료)
- 그래프를 컴파일해 invoke 및 stream 메서드를 제공하는 Runnable 객체로 전환
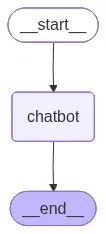
[그래프 시각화 저장]
# 4. 그래프 시각화 저장
graph.get_graph().draw_mermaid_png(output_file_path='graph.png')
[간단한 챗봇]
stream() 메서드를 활용한 실행
# 5. 그래프 실행
input = {'messages' : [HumanMessage('안녕하세요!')]}
for chunk in graph.stream(input):
    print(chunk)
[전체코드]
from typing import TypedDict, Annotated

from langchain_core.messages import HumanMessage
from langgraph.constants import START, END
from langgraph.graph import StateGraph, add_messages

from config.load_sys import gemma_model

# 1. 상태 그래프 생성

class State(TypedDict):
    messages: Annotated[list, add_messages]

builder = StateGraph(State)

###################################
# 2. 노드 추가
from langchain_ollama import ChatOllama

model = ChatOllama(model=gemma_model)

def chatbot(state: State):
    answer = model.invoke(state['messages'])
    return {'messages': [answer]}

## 챗봇노드 추가
## 첫 번째 인자는 고유한 노드 이름
## 두 번재 인자는 실행할 함수 or Runnable
builder.add_node('chatbot', chatbot)

####################################
# 3. 엣지 추가
builder.add_edge(START, 'chatbot')
builder.add_edge('chatbot', END)

graph = builder.compile()

####################################
# 4. 그래프 시각화 저장
graph.get_graph().draw_mermaid_png(output_file_path='graph.png')

####################################
# 5. 그래프 실행
input = {'messages' : [HumanMessage('안녕하세요!')]}
for chunk in graph.stream(input):
    print(chunk)
{'chatbot': {'messages': [AIMessage(content='안녕하세요! 무엇을 도와드릴까요? 😊 궁금한 점이나 필요한 정보가 있으시면 편하게 말씀해주세요.\n', additional_kwargs={}, response_metadata={'model': 'gemma3:12b', 'created_at': '2026-01-21T01:06:29.715331Z', 'done': True, 'done_reason': 'stop', 'total_duration': 1750779834, 'load_duration': 134398917, 'prompt_eval_count': 11, 'prompt_eval_duration': 590470292, 'eval_count': 25, 'eval_duration': 1006180166, 'logprobs': None, 'model_name': 'gemma3:12b', 'model_provider': 'ollama'}, id='lc_run--019bde16-b1fb-7a81-8a2d-ae1925b806cf-0', tool_calls=[], invalid_tool_calls=[], usage_metadata={'input_tokens': 11, 'output_tokens': 25, 'total_tokens': 36})]}}
Disconnected from serverStateGraph에 메모리 기능 추가
랭그래프는 단순한 그래프에서 복잡한 그래프까지 동일하게 활용할 수 있는 영속성(persistence)을 내장
랭그래프 전용 스토리지 어댑터인 체크포인터(checkpointer)를 활용하여 사용자가 선호하는 데이터베이스 맞는 어댑터를 만들 수 있다.
[그래프에 체크포인터 추가]
from langgraph.checkpoint.memory import MemorySaver

graph = builder.compile(checkpointer=MemorySaver())
각 단계가 종료될 때마다 상태가 기록되므로, 최초 실행 이후의 모든 호출은 백지 상태로 시작하지 않는다.
- 그래프 호출 시 체크포인터를 활용해 저장된 최신 상태를 불러온 후 새 입력값과 결합
[메모리 기능 확인]
# 스레드 설정
thread1 = {'configurable': {'thread_id':'1'}}

# 영속성 추가 후 그래프 실행
result_1 = graph.invoke({
    'messages': [HumanMessage('안녕하세요, 저는 조슈아 입니다.!')]
},thread1)

result_2 = graph.invoke({
    'messages': [HumanMessage('제 이름이 뭐죠?')]
},thread1)
[출력결과]
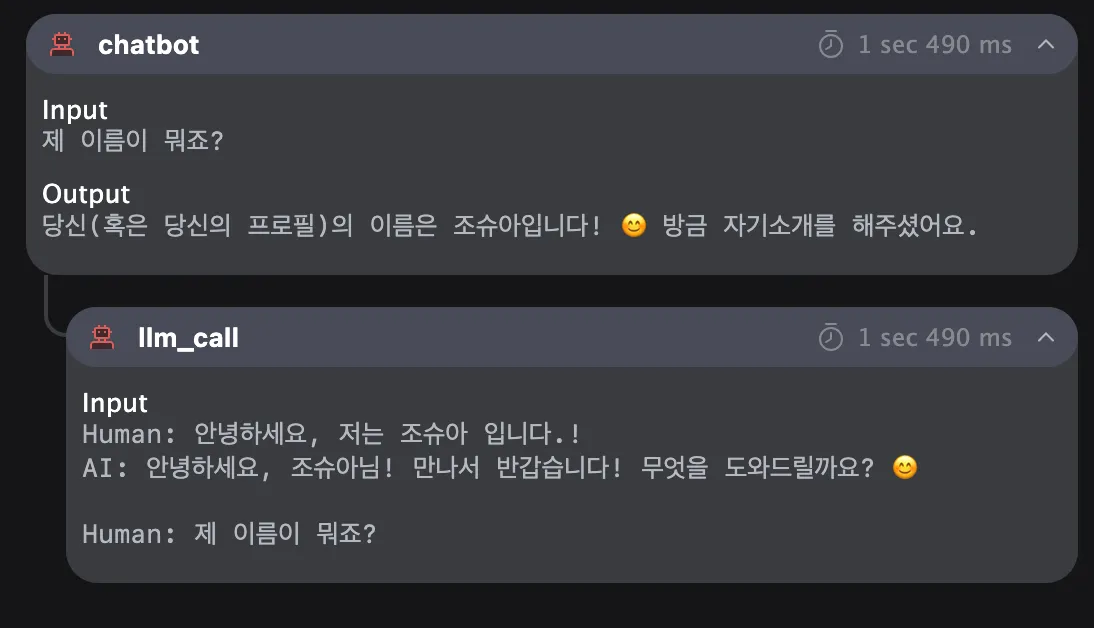
thread1 이라는 객체는 현재 상호작용이 특정 상호작용 기론인 thread1에 기록되는데 이 기록을 랭그래프에선 스레드(thread) 라고 한다.
- 스레드는 처음 사용할 때 자동으로 생성
- 보통 범용 고유 식별자(UUID)가 사용되지만 모든 문자열을 사용 가능
## 상태확인
graph.get_state(thread1)

## 상태 업데이트
graph.update_state(thread1,{'messages': [HumanMessage('LLM은 복잡하넹')]})

## 다시 메시지 출력
result_3 = graph.invoke({
    'messages': [HumanMessage('너는 무슨 모델이니')]
},thread1)
스레드의 상태를 확인하고, 업데이트를 시키면 상태가 저장하고 있는 메시지 목록에 새 메시지가 추가되며, 동일 스레드에서 그래프를 호출할 때 추가된 메시지가 활용된다.
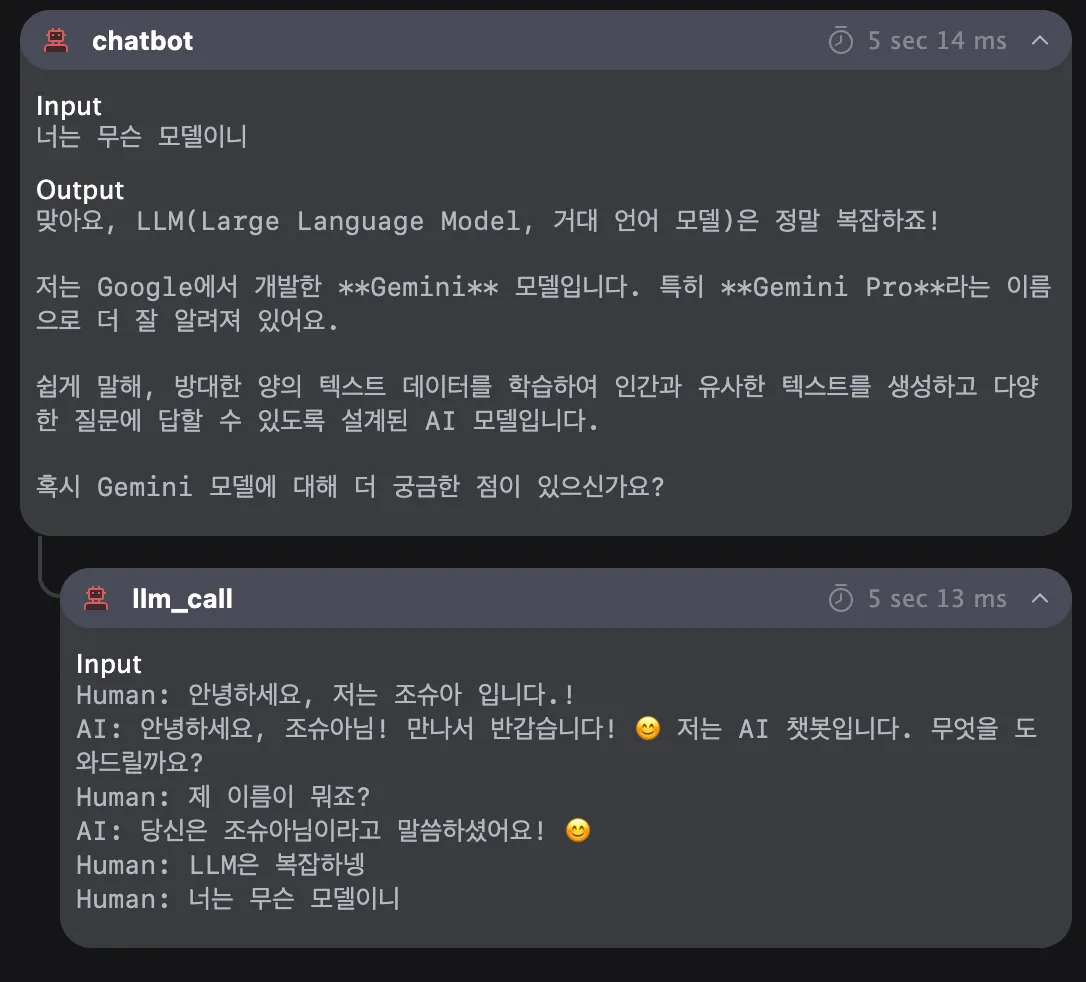
채팅 기록 수정
채팅기록 수정 방법
- 메시지 축약(trimming)
- 내용 필터링(filtering)
- 메시지 병합(merging)
메시지 축약(trimming)
[축약을 안하면 문제점]
- LLM은 컨텍스트 윈도를 제한(토큰 수 제한)하므로 모드별로 정해진 한도를 넘지 않아야함
- 긴 프롬프트는 거부하거나 일부가 생략될 수 있다.
- 프롬프트에 정보가 과도하면 집중력을 분산시켜 환각을 일으킴
채팅 기록에서 가져올 메시지 수를 제한하여 일부 메시지만 프롬프트에 추가하는 방식을 사용하여 문제를 해결
랭체인의 내장 헬퍼 함수인 trim_messages를 제공하는데 이 헬퍼를 사용하면 채팅 기록에서 보존하거나 삭제할 토큰 수를 지정할 수 있다.
- trim_messages : 이전 대화 내용을 적절히 잘라서 LLM이 처리할 수 있도록 조정하는 역할
메시지 목록에서 뒤에서부터 max_tokens 개의 토큰을 받으려면, 매개변수 strategy를 ‘last’로 설정
[메시지 축약]
# 메시지 축약
from langchain_core.messages import (
    SystemMessage,
    HumanMessage,
    AIMessage,
    trim_messages
)
from langchain_ollama import ChatOllama
from config.load_sys import gemma_model

#샘플 메시지 설정
messages = [
    SystemMessage(content='당신은 친절한 어시스턴트 입니다.'),
    HumanMessage(content='안녕하세요. 나는 조슈아 입니다.'),
    AIMessage(content='안녕하세요?'),
    HumanMessage(content='치킨을 좋아합니다.'),
    AIMessage(content='좋구만요?'),
    HumanMessage(content='2 + 2는 얼마죠?'),
    AIMessage(content='4 입니다.'),
    HumanMessage(content='고마워요'),
    AIMessage(content='천만에요'),
    HumanMessage(content='즐거운가요?'),
    AIMessage(content='네')
]

# 축약 설정
trimmer = trim_messages(
    max_tokens=65,
    strategy='last',
    token_counter=ChatOllama(model=gemma_model),
    include_system=True,
    allow_partial=False,
    start_on='human'
)

## 축약 적용
trimmer = trimmer.invoke(messages)
print(trimmer)[SystemMessage(content='당신은 친절한 어시스턴트 입니다.', additional_kwargs={}, response_metadata={}), HumanMessage(content='즐거운가요?', additional_kwargs={}, response_metadata={}), AIMessage(content='네', additional_kwargs={}, response_metadata={}, tool_calls=[], invalid_tool_calls=[])]trim_messages 의 주요설정
- strategy : 메시지 목록의 시작 지점을 설정
- last : 마지막 메시지를 시작지점으로 설정
- first : 가장 처음부터 주어진 토큰 수 만큼 메시지를 유지
- token_counter: 모델의 토큰 숫자를 기반으로 메시지 길이를 제한(최적화된 토크나이저를 활용해 토큰을 산출)
- include_system : True일 경우 트리머가 시스템미시지를 유지하도록 설정
- allow_partial : 제한범위 내 마지막 메시지의 내용을 포함시키기 위해 메시지 일부를 생략할지 결정(메시지 내용이 길어지면 메시지 일부 자를 수 있다는 뜻)
- start_on : ‘human’은 응답인 AIMessage를 제거하면 그 응답을 불러오는 질문인 HumanMessage도 삭제하도록 설정
2. 메시지 필터링(filtering)
메시지를 추적할 때 특정 메시지들만 선별하는 방법으로 filter_messages를 사용하면 유형, ID, 이름별로 쉽게 구분 가능.
[사용자 메시지 필터링]
# 메시지 축약
from langchain_core.messages import (
    SystemMessage,
    HumanMessage,
    AIMessage,
    filter_messages
)

#샘플 메시지 설정
messages = [
    SystemMessage(content='당신은 친절한 어시스턴트 입니다.', id='1'),
    HumanMessage(content='안녕하세요. 나는 조슈아 입니다.', id='2', name='user'),
    AIMessage(content='예시 입력', id='3', name='assistant'),
    HumanMessage(content='실제 입력', id='4', name='bob'),
    AIMessage(content='실제 출력', id='5', name='alice'),
]

## 사용자 메시지만 필터링
human_messages = filter_messages(messages, include_types='human')

print("include_types\n", human_messages)

# 특정 이름 메시지 제외
exclude_messages = filter_messages(messages, exclude_names=['bob', 'assistant'])
print("exclude_names\n", exclude_messages)

# 유형과 ID로 필터링
filtered_messages = filter_messages(messages, include_types=['human','ai'], exclude_ids=['3'])
print("filtered_messages\n", filtered_messages)
include_types
[HumanMessage(content='안녕하세요. 나는 조슈아 입니다.', additional_kwargs={}, response_metadata={}, name='user', id='2'), HumanMessage(content='실제 입력', additional_kwargs={}, response_metadata={}, name='bob', id='4')]
exclude_names
[SystemMessage(content='당신은 친절한 어시스턴트 입니다.', additional_kwargs={}, response_metadata={}, id='1'), HumanMessage(content='안녕하세요. 나는 조슈아 입니다.', additional_kwargs={}, response_metadata={}, name='user', id='2'), AIMessage(content='실제 출력', additional_kwargs={}, response_metadata={}, name='alice', id='5', tool_calls=[], invalid_tool_calls=[])]
filtered_messages
[HumanMessage(content='안녕하세요. 나는 조슈아 입니다.', additional_kwargs={}, response_metadata={}, name='user', id='2'), AIMessage(content='예시 입력', additional_kwargs={}, response_metadata={}, name='assistant', id='3', tool_calls=[], invalid_tool_calls=[]), HumanMessage(content='실제 입력', additional_kwargs={}, response_metadata={}, name='bob', id='4'), AIMessage(content='실제 출력', additional_kwargs={}, response_metadata={}, name='alice', id='5', tool_calls=[], invalid_tool_calls=[])]연속된 메시지 병합(merging)
일부 모델은 동일한 유형의 메시지를 연속으로 입력할 수 없다.
merge_message_run을 활용하면 동일 유형의 연속된 메시지를 손쉽게 병합할 수 있다.
# 메시지 축약
from langchain_core.messages import (
    SystemMessage,
    HumanMessage,
    AIMessage,
    filter_messages, merge_message_runs
)

#샘플 메시지 설정
messages = [
    SystemMessage(content='당신은 친절한 어시스턴트 입니다.'),
    SystemMessage(content='항상 농담으로 대답하세요.'),
    HumanMessage(
        content=[{'type': 'text', 'text': '어떤 피자가 제일 맛있어요?'}]
    ),
    HumanMessage(
        content='어떤 햄버거가 가장 맛있나요?'
    ),
    AIMessage(
        content='나는 항상 너만 "고르곤졸라"'
    ),
    AIMessage(
        content='너가 "버거" 싶어'
    )
]

# 연속된 메시지 병합
merged = merge_message_runs(messages)

print("merged\n", merged)
merged
[SystemMessage(content='당신은 친절한 어시스턴트 입니다.\n항상 농담으로 대답하세요.', additional_kwargs={}, response_metadata={}), HumanMessage(content=[{'type': 'text', 'text': '어떤 피자가 제일 맛있어요?'}, '어떤 햄버거가 가장 맛있나요?'], additional_kwargs={}, response_metadata={}), AIMessage(content='나는 항상 너만 "고르곤졸라"\n너가 "버거" 싶어', additional_kwargs={}, response_metadata={}, tool_calls=[], invalid_tool_calls=[])]체크포인트와 모델 입력은 다른 층
앞의 trim_messages·filter_messages·merge_message_runs는 모델에 보낼 메시지 목록을 가공한다. 이를 호출했다고 저장된 대화 기록이 자동 삭제되는 것은 아니다. 체크포인터는 그래프 상태를 스레드별로 저장한다. 긴 대화에서 모델 입력을 줄이는 정책과 오래된 체크포인트를 지우는 보존 정책은 따로 설계한다(LangGraph persistence).
flowchart LR
    U[사용자 메시지] --> T[인증된 thread_id]
    T --> P[(체크포인트: 전체 상태)]
    P --> W[모델 입력 문맥 선택]
    W --> M[모델 호출]
    M --> N[새 상태 저장]
    N --> P
같은 thread_id로 호출하면 이전 상태를 이어받고, 다른 ID면 별도 스레드로 분리된다. 그러나 ID 자체가 사용자를 인증하지는 않는다. API는 인증된 사용자와 스레드 소유권을 연결해야 한다. 사용자 입력으로 받은 ID를 검증 없이 그래프 설정에 넣으면 다른 대화가 노출될 수 있다.
from langgraph.checkpoint.memory import InMemorySaver

# 앞에서 만든 챗봇 builder를 새 실습 그래프로 컴파일한다고 가정한다.
memory_graph = builder.compile(checkpointer=InMemorySaver())
alice = {"configurable": {"thread_id": "demo-alice"}}
bob = {"configurable": {"thread_id": "demo-bob"}}

memory_graph.invoke(
    {"messages": [{"role": "user", "content": "저는 앨리스입니다."}]},
    config=alice,
)
memory_graph.invoke(
    {"messages": [{"role": "user", "content": "제 이름을 기억하나요?"}]},
    config=alice,
)
memory_graph.invoke(
    {"messages": [{"role": "user", "content": "제 이름을 기억하나요?"}]},
    config=bob,
)
이 코드는 스레드 분리 동작을 살피기 위한 예시다. 모델이 특정 문장을 답한다는 결과를 보장하지 않는다. memory_graph.get_state(alice)와 memory_graph.get_state(bob)의 메시지 상태가 분리되는지 확인한다. InMemorySaver는 프로세스가 끝나면 사라지므로 실서비스의 재시작 복구에는 영속 체크포인터가 필요하다.
| 방법 | 장점 | 놓치기 쉬운 것 |
|---|---|---|
| 최근 메시지만 남기기 | 단순하고 비용 예측이 쉬움 | 앞부분의 이름·제약·승인 정보 |
| 요약 만들기 | 오래된 내용을 짧게 보존 | 요약 오류가 다음 턴에 반복 |
| 관련 문서 재검색 | 현재 근거를 다시 확인 | 검색 지연과 권한 필터 |
| Store에 선호도 기록 | 스레드 밖에서 재사용 | 삭제 요청·보존 기간·사용자 혼합 |
예를 들어 사용자가 처음에는 “2024년 규정”을 묻고 다음에는 “올해도 같아?”라고 묻는다면, 이전 답을 그대로 근거로 쓰면 안 된다. 현재 적용되는 문서를 다시 검색하고 버전을 비교한다. trim_messages로 앞 메시지를 제외했다면 “그 규정”이 무엇인지 모를 수 있으므로 질문 재작성 또는 추가 질문이 필요하다.
운영에서는 저장할 정보의 목적, 보존 기간, 삭제 방법을 먼저 정한다. 모델 요청과 트레이스에 개인정보가 들어갈 수 있으므로 체크포인트·로그·장기 Store의 권한을 각각 관리한다. 공식 checkpointer 설명은 스레드 상태와 스레드 밖 데이터를 구분한다.
같은 카테고리의 글
이어서 읽을 글
5. 랭그래프로 구현하는 인지 아키텍처
LangGraph의 LLM 호출·체인·라우터를 상태와 실행 경로로 구성하고, 분기 결과와 실패 경계를 확인하는 방법을 다룬다.
11. LLM 애플리케이션 개발
문서 기반 질문 응답 서비스를 예로 들어 문제 정의, RAG 그래프 구현, 인용 검증, 평가와 배포까지 연결하는 개발 절차.
10. 테스트: 평가, 모니터링, 개선
LLM 애플리케이션의 회귀 테스트, 오프라인 평가 데이터, 운영 추적과 실패 사례를 개선으로 연결하는 방법.
9. AI 애플리케이션 배포
LangGraph 애플리케이션을 서버로 실행할 때 필요한 구성, 상태 저장, 보안, 스트리밍, 배포 검증과 운영 절차.