목차
비동기 처리
비동기 처리는 어던 작업을 실행하는 동안 해당 처리가 끝나기를 기다리지 않고 다른 작업을 수행할 수 있는 것을 말한다.
RxJava는 비동기 처리를 수행하는데 필요한 API를 제공하고 기존에 구축한 비지니스 로직에 영향을 주지 않고 생산자 또는 소비자의 작업을 비동기로 처리하도록 교체할 수 있다. 또한, 용도별로 적절하게 스레드를 관리하는 클래스를 제공하여 직접 스레드를 관리하는 번거로움이 줄었다.
RxJava 비동기 처리
RxJava에서 개발자가 직접 비동기 처리를 하도록 설정하거나 연산자 내에서 시간을 다루는 작업을 하지 않는 한, 생산자의 처리 작업을 실행하는 스레드에서 각 연산자의 처리 작업과 소비자의 처리 작업이 실행된다. 개발자가 직접 비동기 처리를 하도록 설정하면 생산자와 연산자, 소비자가 처리 작업을 실행할 스레드를 분리할 수 있다.
interval은 시간에 따라 통지하지만 아래처럼 구독자의 onNext가 같은 스케줄러에서 2초 동안 잠들면 그 스케줄러의 후속 작업도 지연된다. 별도 스레드에 소비를 옮기면 두 작업을 분리할 수 있지만, 그러면 생산과 소비 사이 대기열의 크기와 배압 정책을 정해야 한다. 속도 차이를 스레드 추가만으로 해결할 수는 없다.
import io.reactivex.Flowable;

import java.util.concurrent.TimeUnit;

public class SyncSlower {
    public static void main(String[] args) throws Exception {
        Flowable.interval(1000L, TimeUnit.MICROSECONDS)
                .doOnNext(data-> System.out.println("Emit : "+ System.currentTimeMillis() + " ms : "+ data)) //통지할때 데이터 시간 출력
                .subscribe(data -> Thread.sleep(2000L)); //구독, 무거운 처리 작업수행을 가정

        Thread.sleep(5000L);
    }
}
스케줄
스케줄러는 스레드를 관리하는 클래스로 RxJava에서 표준 API를 사용하지 않고 비동기 처리를 할 수 있다. Schedulers클래스의 메서드를 호출 하여 사용한다.
| 메서드 | 내용 |
|---|---|
| computation | 연산 처리를 할 때 사용하는 스케줄러로, 논리프로세서 수와 같은 수만큼 스레드를 캐시한다. I/O 처리 작업에서는 사용할 수 없다. |
| io | I/O처리 작업을 할 때 사용하는 스케줄러로 스레드 풀에서 스레드를 가져오고, 필요에 따라 새로운 스레드를 생성한다 |
| single | 싱글 스레드에서 처리 작업을 할 때 사용하는 스케줄러다 |
| newThread | 매번 새로운 스레드를 생성하는 스케줄러다 |
| from(Executor executor) | 지정한 Executor가 생성한 스레드에서 처리 작업을 수행하는 스케줄러다 |
| trampoline | 현재 Thread Queue에 처리작업을 넣는 스케줄러로, 이미 다른 처리 작업이 Queue에 들어가 있다면 Queue에 들어 있는 작업의 처리가 끝난 후 새로 등록한 처리 작업을 수행한다. |
computation과 io 메서드로 얻은 스케줄러는 비슷한 역할을 하고, 호출할 때 Thread Pool에서 서로다른 Thread를 가져온다.
io
-
스레드 풀에 더 이상가져올 스래드가 없을 때 스레드를 생성하고 I/O 처리 작업 중 대기시간이 발생할 가능성이 있어 논리 프로세서 수를 초과해도 스레드를 생성해 동시 처리작업을 한다.
-
서로 다른 스레드가 동시에 접근하는 공유 I/O처리 작업에 적절하지 않다. 그래서 Thread Safe를 보장하게 구현하거나 single 메서드로 가져온 스케줄러가 제공하는 공통 스레드에서만 처리 작업을 해야한다.
computation - 논리 프로세서 수가 넘지 않는 범위 내에서 스레드를 주고 받는다. - 연산 처리 작업에 대기하는 일이 없기에 논리 프로세서 수를 초과하는 스레드로 처리작업을 하게 되면 실행 스레드를 전환하는 일이 발생하게 되어 스레드 전환 비용에 의해 성능이 저하될 수 있다.
RxJava내에서 스케줄러를 별도로 설정하지 않고, 연산자, 시간을 다루는 처리작업을 하지 않는 이상 생산자는 기본 스레드에서 모든 처리 작업을 수행한다.
subscribeOn 메서드
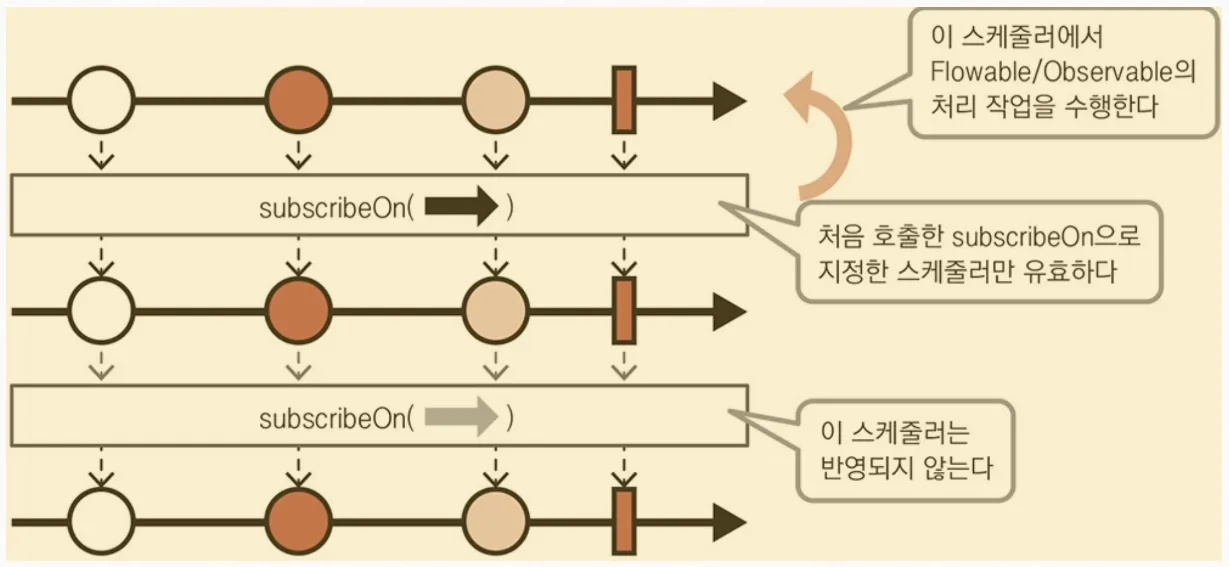
subscribeOn 메서드는 생산자의 처리 작업을 어떤 스케줄러에서 실행할지 설정하는 메서드이다. (생산자는 Flowable/Observable이다)
[subscribeOn]
subscribeOn을 여러 번 연결할 수는 있지만, 실제 소스의 실행 스케줄러는 소스에 가장 가까운 subscribeOn이 정한다. 뒤에 붙인 subscribeOn은 그 앞 단계에 대한 구독을 시작하는 위치에 영향을 줄 뿐 소스의 스케줄러를 덮어쓰지 않는다. 예제의 스레드 이름은 스케줄러의 작업 배치에 따라 달라질 수 있다.
import io.reactivex.Flowable;
import io.reactivex.schedulers.Schedulers;

public class SubscribeOnMain {
    public static void main(String[] args) throws Exception {
        Flowable.just(1,2,3,4,5)
                .subscribeOn(Schedulers.computation())
                .subscribeOn(Schedulers.io())
                .subscribeOn(Schedulers.single())
                .subscribe(data-> {
                    System.out.println(Thread.currentThread().getName() + " : "+ data);
                });
        Thread.sleep(500);
    }
}
[결과]
RxComputationThreadPool-1 : 1
RxComputationThreadPool-1 : 2
RxComputationThreadPool-1 : 3
RxComputationThreadPool-1 : 4
RxComputationThreadPool-1 : 5
스케줄러는 한 번만 설정할 수 있으므로 interval 메서드로 생성한 생산자가 스케줄러를 자동으로 지정할 때 SubscriveOn 메서드로 다른 스케줄러를 지정해도 반영되지 않는다.
observeOn 메서드
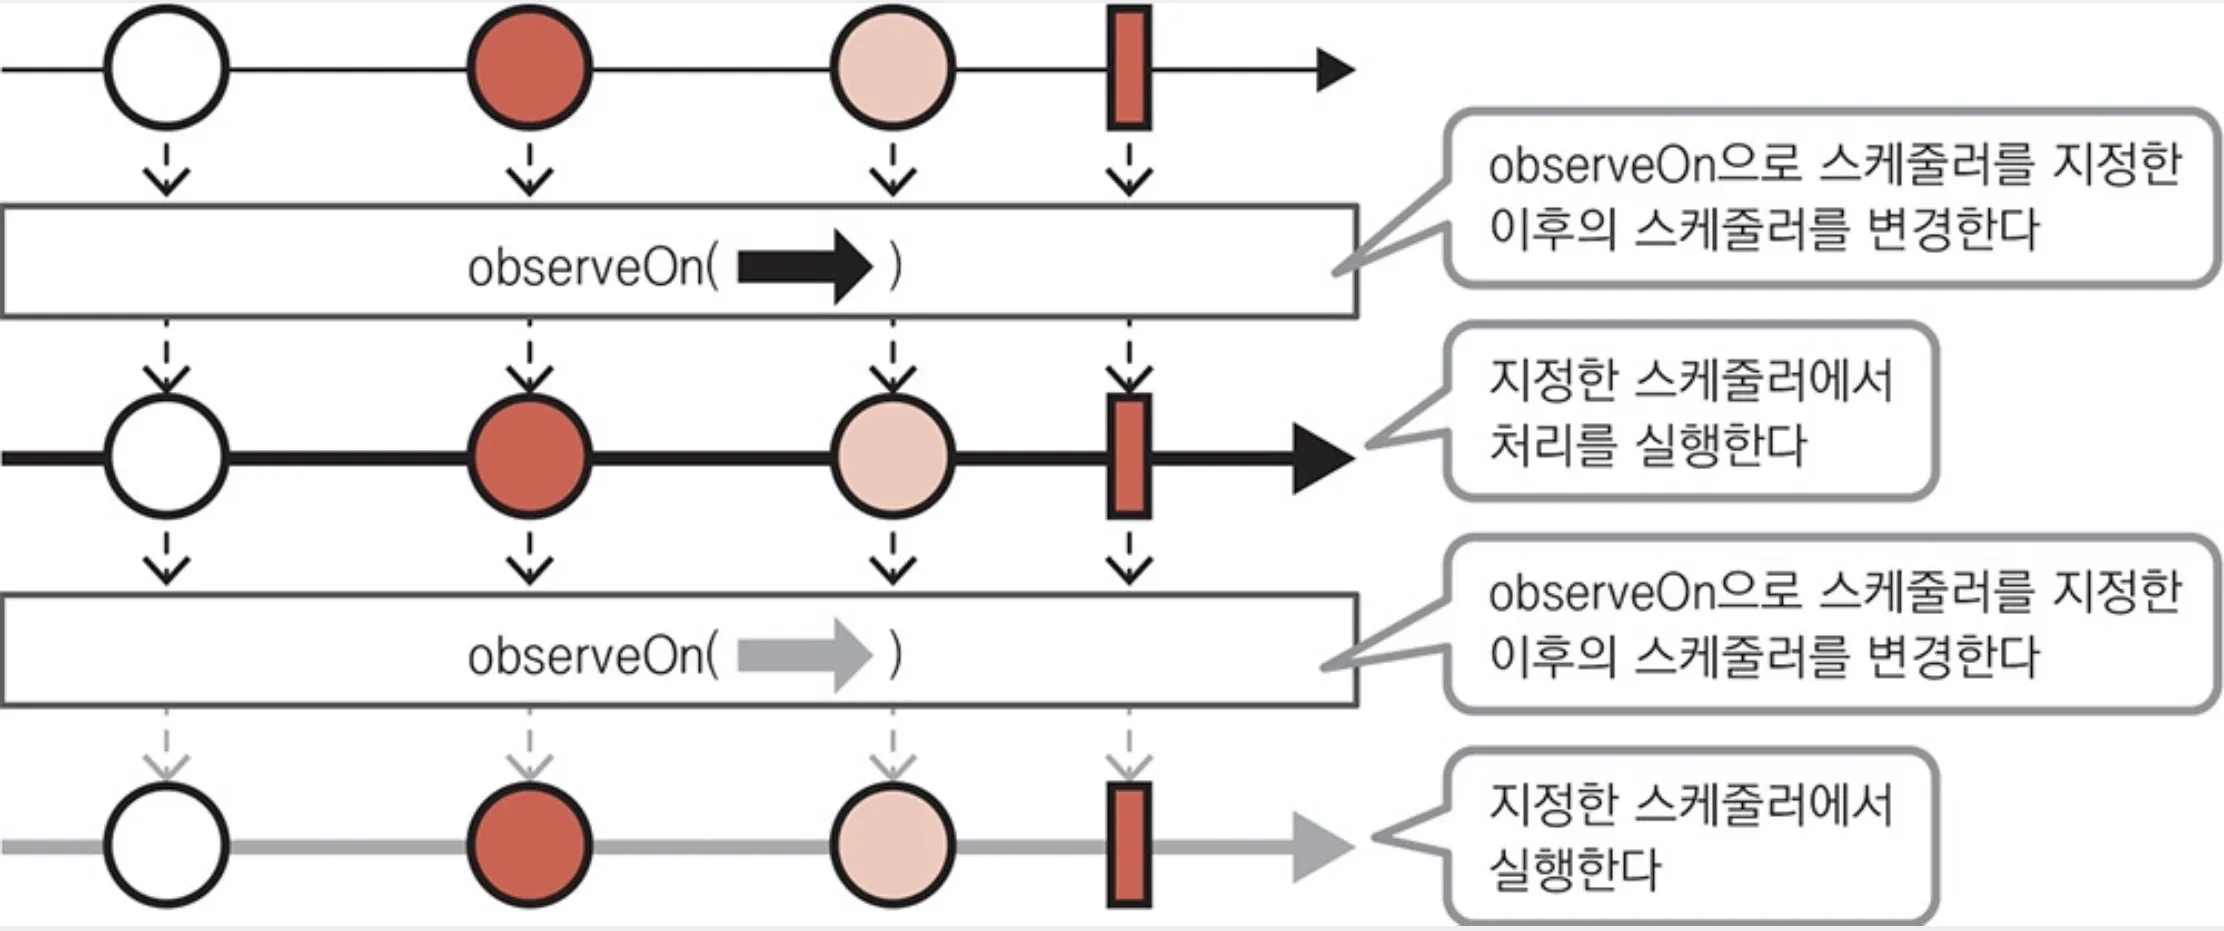
observeOn 메서드는 데이터를 받는 측의 처리 작업을 어떤 스케줄러에서 실행할지 설정하는 메서드로, observeOn 메서드는 데이터를 받은 측의 스케줄러를 지정함으로 연산자마다 서로 다른 스케줄러를 지정할 수 있다.
[observeOn ]
[observeOn 메서드 argument]
observeOn(Scheduler scheduler)
observeOn(Scheduler scheduler, Boolean delayError)
observeOn(Scheduler scheduler, Boolean delayError, int bufferSize)| type | 설명 |
|---|---|
| Scheduler | 스레드를 관리하는 스케줄러 클래스 |
| Boolean | true 일 때 에러가 발생해도 즉시 통지하지 않고, 버퍼에 담긴 데이터를 모두 통지한 후에 에러를 통지, false일 때 에러가 밸상하면 바로통지한다. (default : false) |
| int | 통지를 기다리는 데이터를 버퍼에 담는 크기로 기본값은 128이다. |
[observeOn 메서드 사용 예]
import io.reactivex.Flowable;
import io.reactivex.schedulers.Schedulers;
import io.reactivex.subscribers.ResourceSubscriber;

import java.util.concurrent.TimeUnit;

public class ObserveOnMain {
    public static void main(String[] args) throws Exception {
        Flowable<Long> flowable = Flowable
                .interval(300L, TimeUnit.MILLISECONDS) //0.3초마다 0부터 시작하는 데이터를 통지하는 lowable 생성
                .onBackpressureDrop();

        flowable.observeOn(Schedulers.computation(), false , 1) //비동기로 받게 하고, 버퍼 크기를 1로 설정
                .subscribe(new ResourceSubscriber<Long>() { //구독
                    @Override
                    public void onNext(Long data) {
                        try {
                            Thread.sleep(1000L);
                        } catch (InterruptedException e) {
                            e.printStackTrace();
                            System.exit(1);
                        }

                        System.out.println(Thread.currentThread().getName() + " : " + data);
                    }

                    @Override
                    public void onError(Throwable t) {
                    }
                    @Override
                    public void onComplete() {
                    }
                });

        Thread.sleep(7000L);
    }
}
[결과]
RxComputationThreadPool-1 : 0
RxComputationThreadPool-1 : 4
RxComputationThreadPool-1 : 8
RxComputationThreadPool-1 : 12
RxComputationThreadPool-1 : 16
연산자 내에서 생성되는 비동기 Flowable/Observable
flatMap 메서드
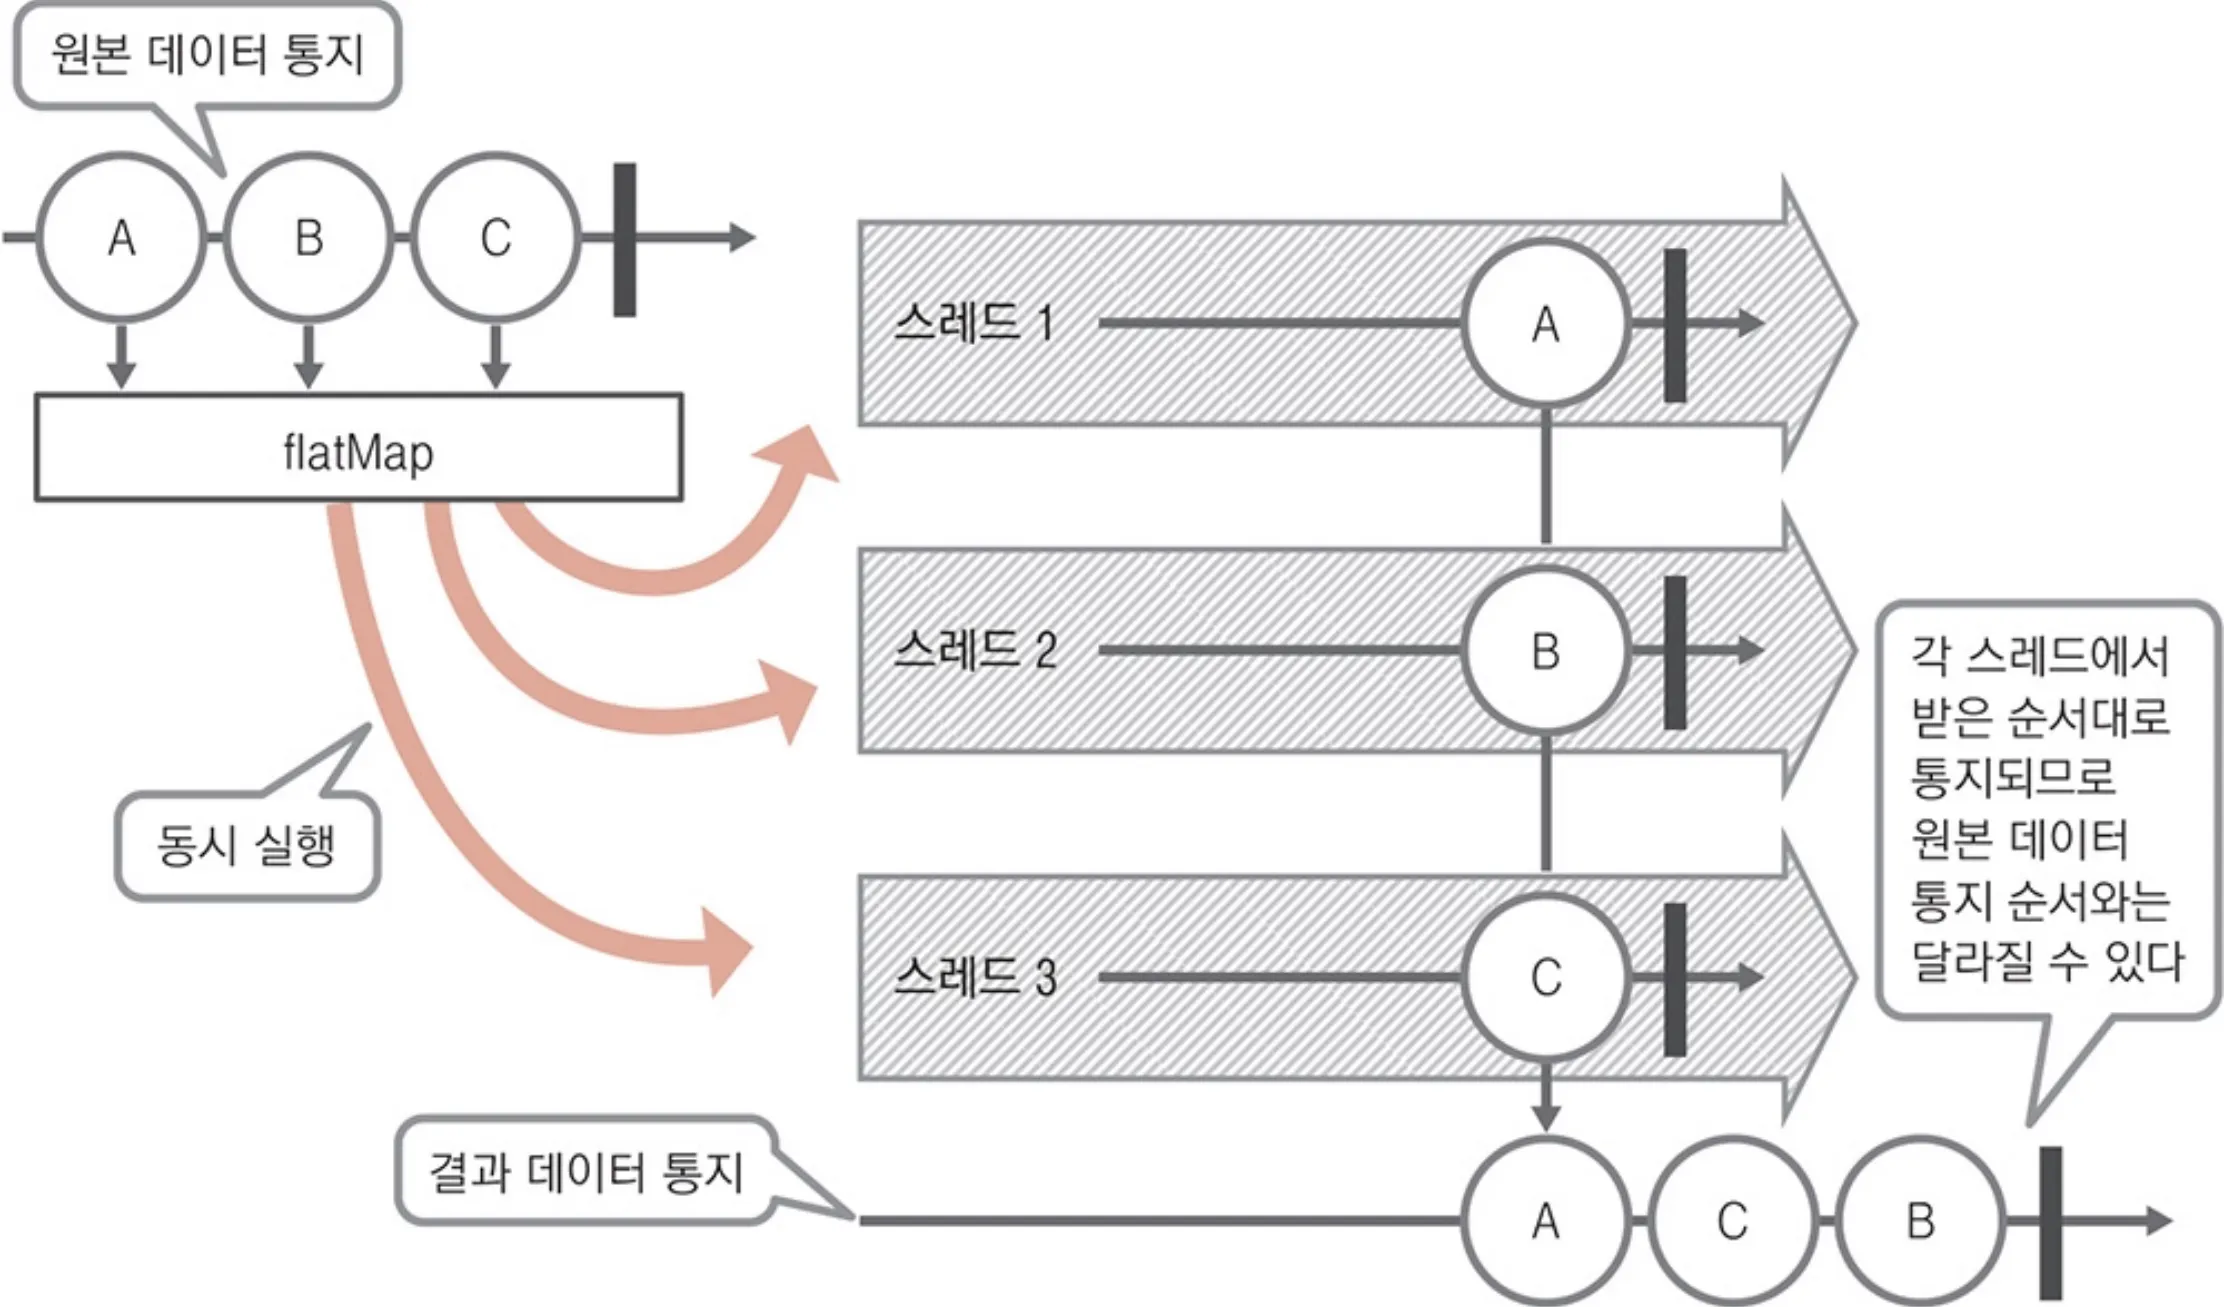
flatMap 메서드는 데이터를 받으면 새로운 Flowable/Observable을 생성하고 이를 실행하면 통지되는 데이터를 메서드의 결과물로 통지하는 연산자다.
[flatMap 메서드]
flatMap 메서드는 처리 성능이 중요할 때 사용한다.
[flatMap 사용 예]
import io.reactivex.Flowable;
import java.util.concurrent.TimeUnit;

public class FlowMap {
    public static void main(String[] args) throws Exception {
        Flowable<String> flowable = Flowable.just("A", "B", "C")
                .flatMap(data -> {
                    return Flowable.just(data).delay(1000L, TimeUnit.MILLISECONDS);
                });

        flowable.subscribe(data -> {
            System.out.println(Thread.currentThread().getName() + " : " + data);
        });

        Thread.sleep(2000L);
    }
}
[결과]
RxComputationThreadPool-3 : C
RxComputationThreadPool-2 : A
RxComputationThreadPool-2 : B
결과를 보면 순서가 다르게 나오는데 각스레드에서 받은 데이터를 순서대로 통지되므로 원본 데이터의 통지 순서는 달라질 수 있다.
concatMap 메서드
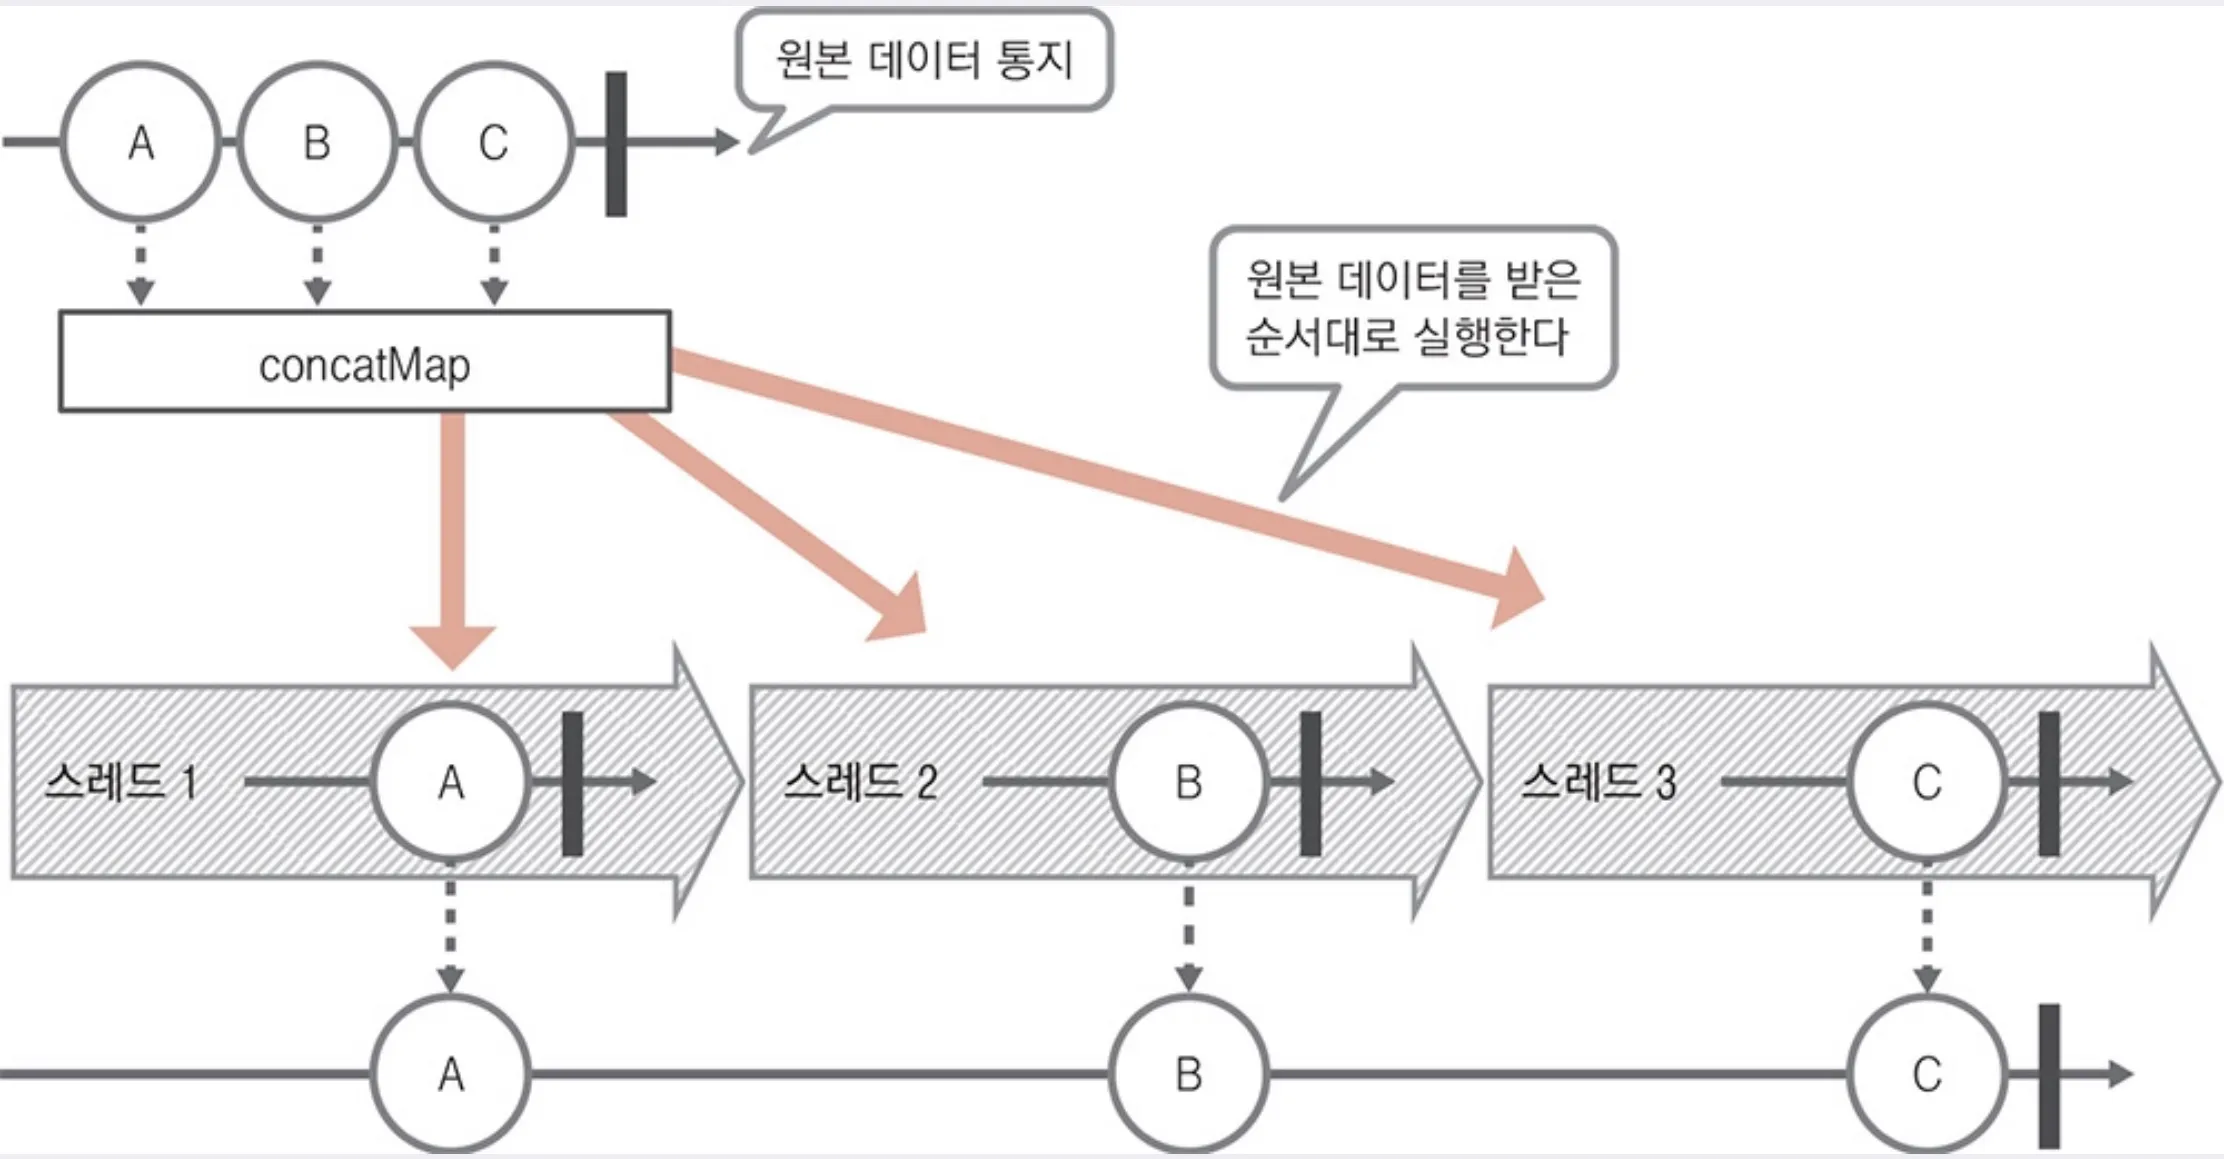
concatMap 메서드는 받은 데이터로 메서드 내부에 Flowable/Observable을 생성하고 이 Flowable/Observable을 하나 씩 순서대로 실행해 통지된 데이터를 그 결과물로 통지하는 연산자이다. 이 과정에서 생성 되는 Flowable/Observable은 다른 스레드에서 처리를 해도 영향을 받지 않고 새로생성한 Flowable/Observable의 처리 데이터를 받은 순서대로 통지한다.
[concatMap 메서드]
성능에 관계없이 데이터 순서가 중요할 때는 concatMap을 사용한다.
[concatMap 메서드 코드]
import io.reactivex.Flowable;
import java.time.LocalTime;
import java.time.format.DateTimeFormatter;
import java.util.concurrent.TimeUnit;

public class ConcatMap {
    public static void main(String[] args) throws Exception {
        Flowable<String> flowable = Flowable.just("A", "B", "C")
                .concatMap(data -> {
                    return Flowable.just(data).delay(1000L, TimeUnit.MILLISECONDS);
                });

        flowable.subscribe(data -> {
            String threadName = Thread.currentThread().getName();
            String tiem = LocalTime.now().format(DateTimeFormatter.ofPattern("ss.SSS"));
            System.out.println(threadName + " : data=" + data + ", time=" + tiem);
        });
        Thread.sleep(4000L);
    }
}
[결과]
RxComputationThreadPool-1 : data=A, time=32.439
RxComputationThreadPool-2 : data=B, time=33.448
RxComputationThreadPool-3 : data=C, time=34.450
concatMapEager 메서드
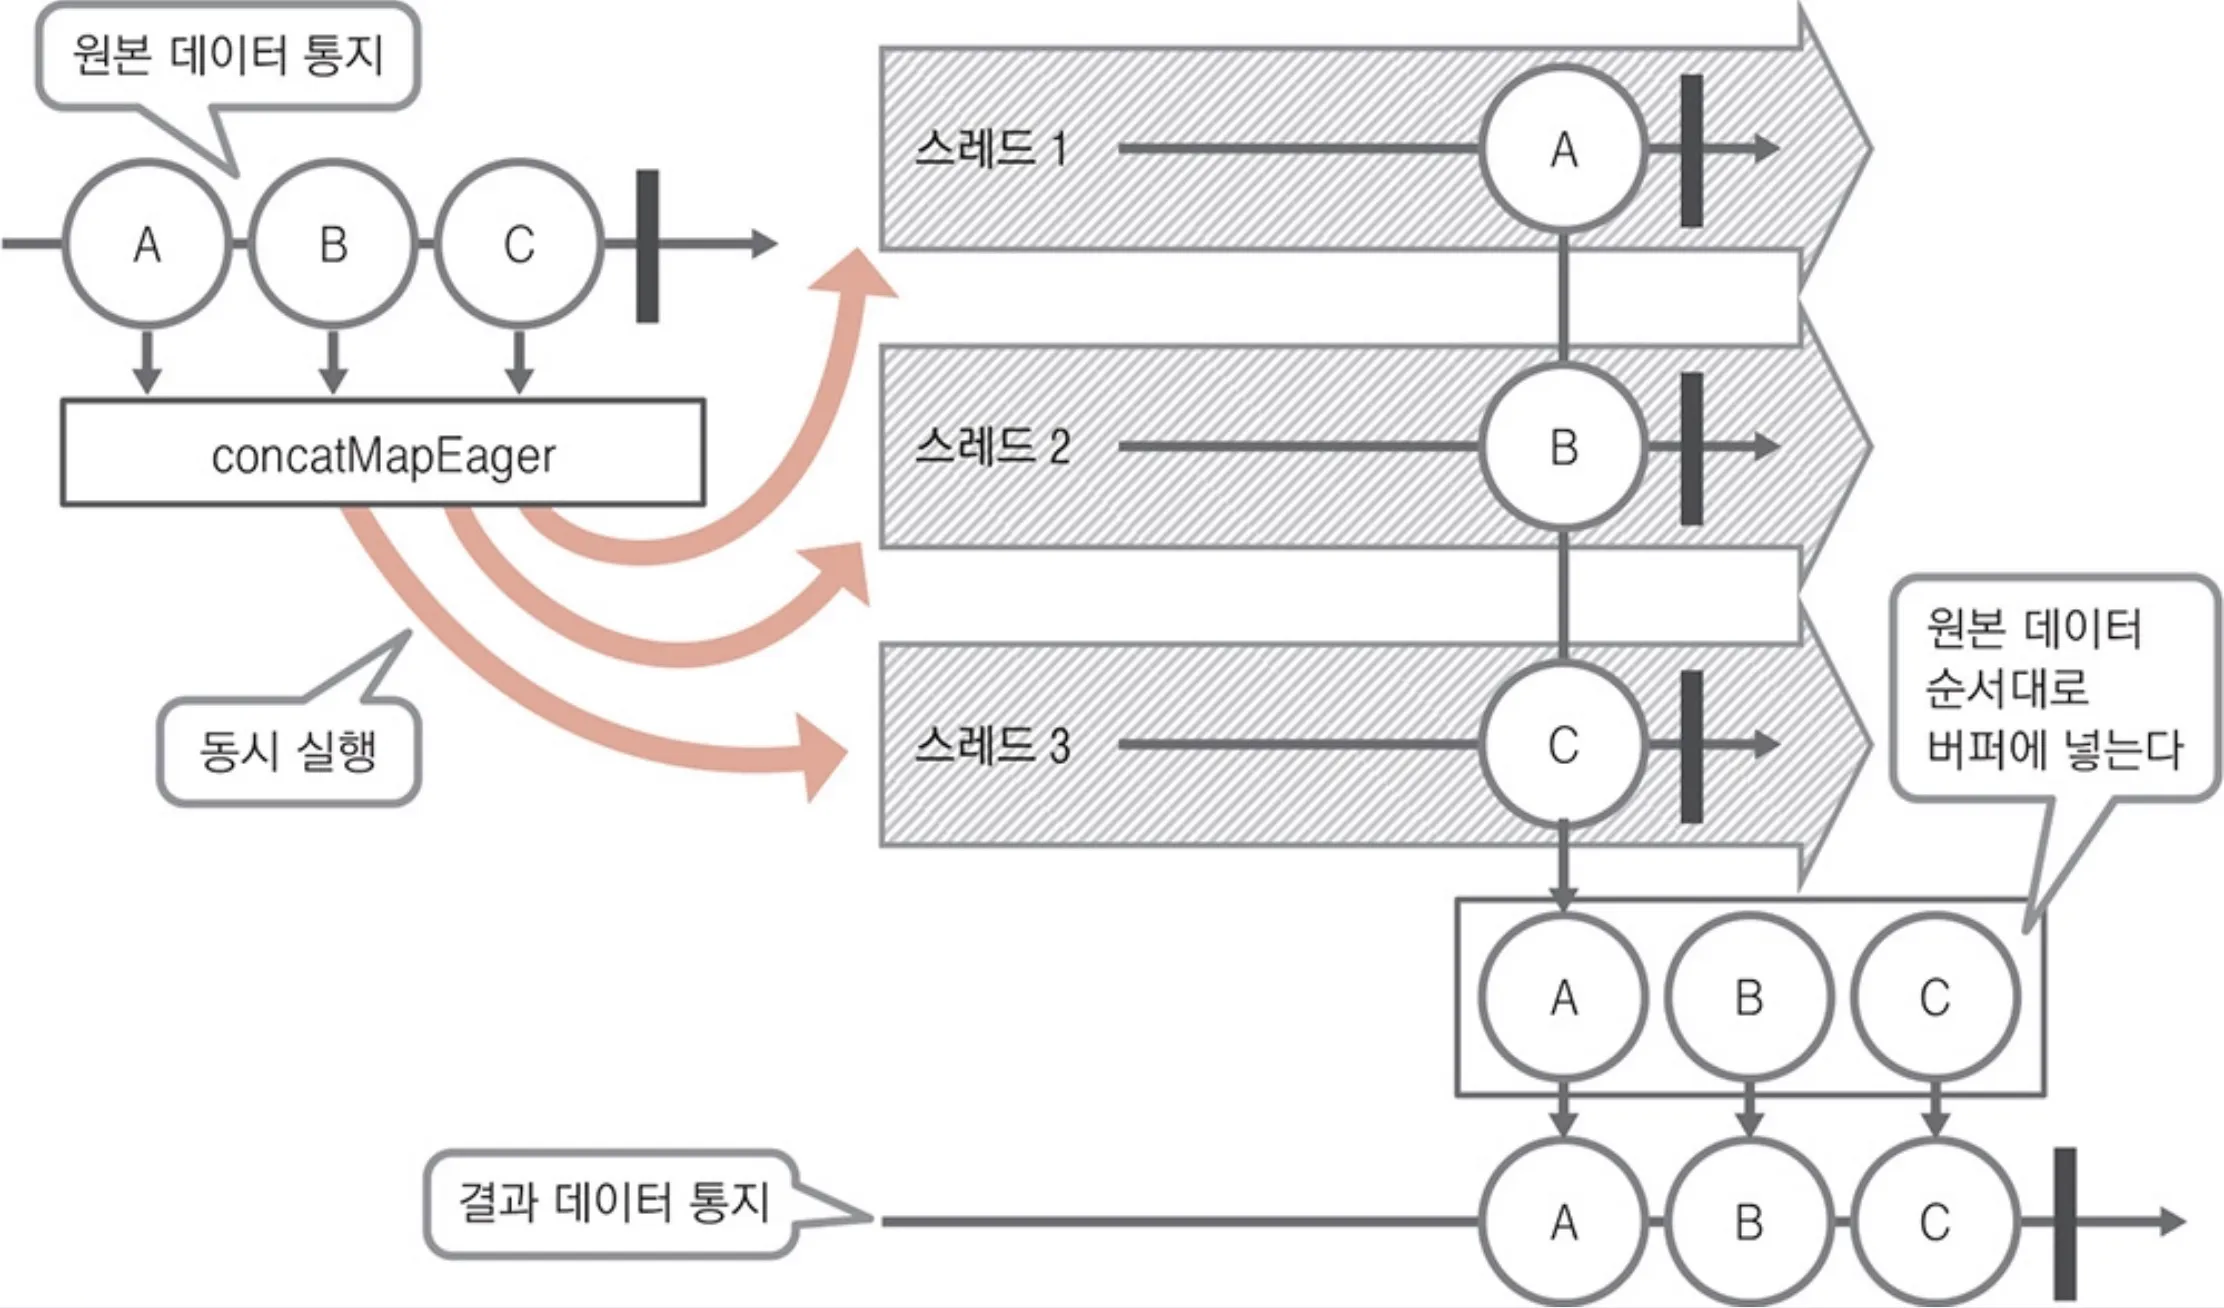
concatMapEager 메서드는 데이터를 받으면 새로운 Flowable/Observable을 생성하고 이를 즉시 실행하고 그 결과를 받은 데이터를 원본 데이터 순서대로 통지하는 연산자이다. 실행은 flatMap 처럼 동시에 실행하여 결과를 통지할 때는 concatMap 과같이 통지한다.
[concatMapEager 메서드]
데이터의 순서와 성능 모두가 중요하다면 concatMapEager 메서드를 사용하는 것이 적합하다. 하지만 통지 전 까지 데이터를 버퍼에 쌓아둬야 하므로 대량의 데이터를 전송할 때 메모리가 부족해질 위험이 있다.
[concatMapEager 코드]
import io.reactivex.Flowable;

import java.time.LocalTime;
import java.time.format.DateTimeFormatter;
import java.util.concurrent.TimeUnit;

public class ConcatMapEager {
    public static void main(String[] args) throws Exception {
        Flowable<String> flowable = Flowable.just("A", "B", "C")
                .concatMapEager(data -> {
                    return Flowable.just(data).delay(1000L, TimeUnit.MILLISECONDS);
                });

        flowable.subscribe(data -> {
                String threadName = Thread.currentThread().getName();
        String tiem = LocalTime.now().format(DateTimeFormatter.ofPattern("ss.SSS"));
        System.out.println(threadName + " : data=" + data + ", time=" + tiem);
        });

        Thread.sleep(2000L);

    }
}
[결과]
RxComputationThreadPool-1 : data=A, time=13.345
RxComputationThreadPool-1 : data=B, time=13.352
RxComputationThreadPool-1 : data=C, time=13.352
merge와 공유 상태는 다른 문제
merge는 두 소스를 동시에 구독하고 도착한 값을 하나의 스트림으로 병합한다. 원본 간 순서는 보장하지 않지만 한 하위 구독자에게 보내는 신호는 직렬화한다. 따라서 하위 onNext 하나에서만 상태를 갱신한다면 두 원본이 같은 시각에 값을 보내더라도 그 하위 콜백이 동시에 실행되어서는 안 된다. 그렇다고 merge가 소스 내부나 다른 스레드에서 공유하는 객체까지 잠그는 것은 아니다.
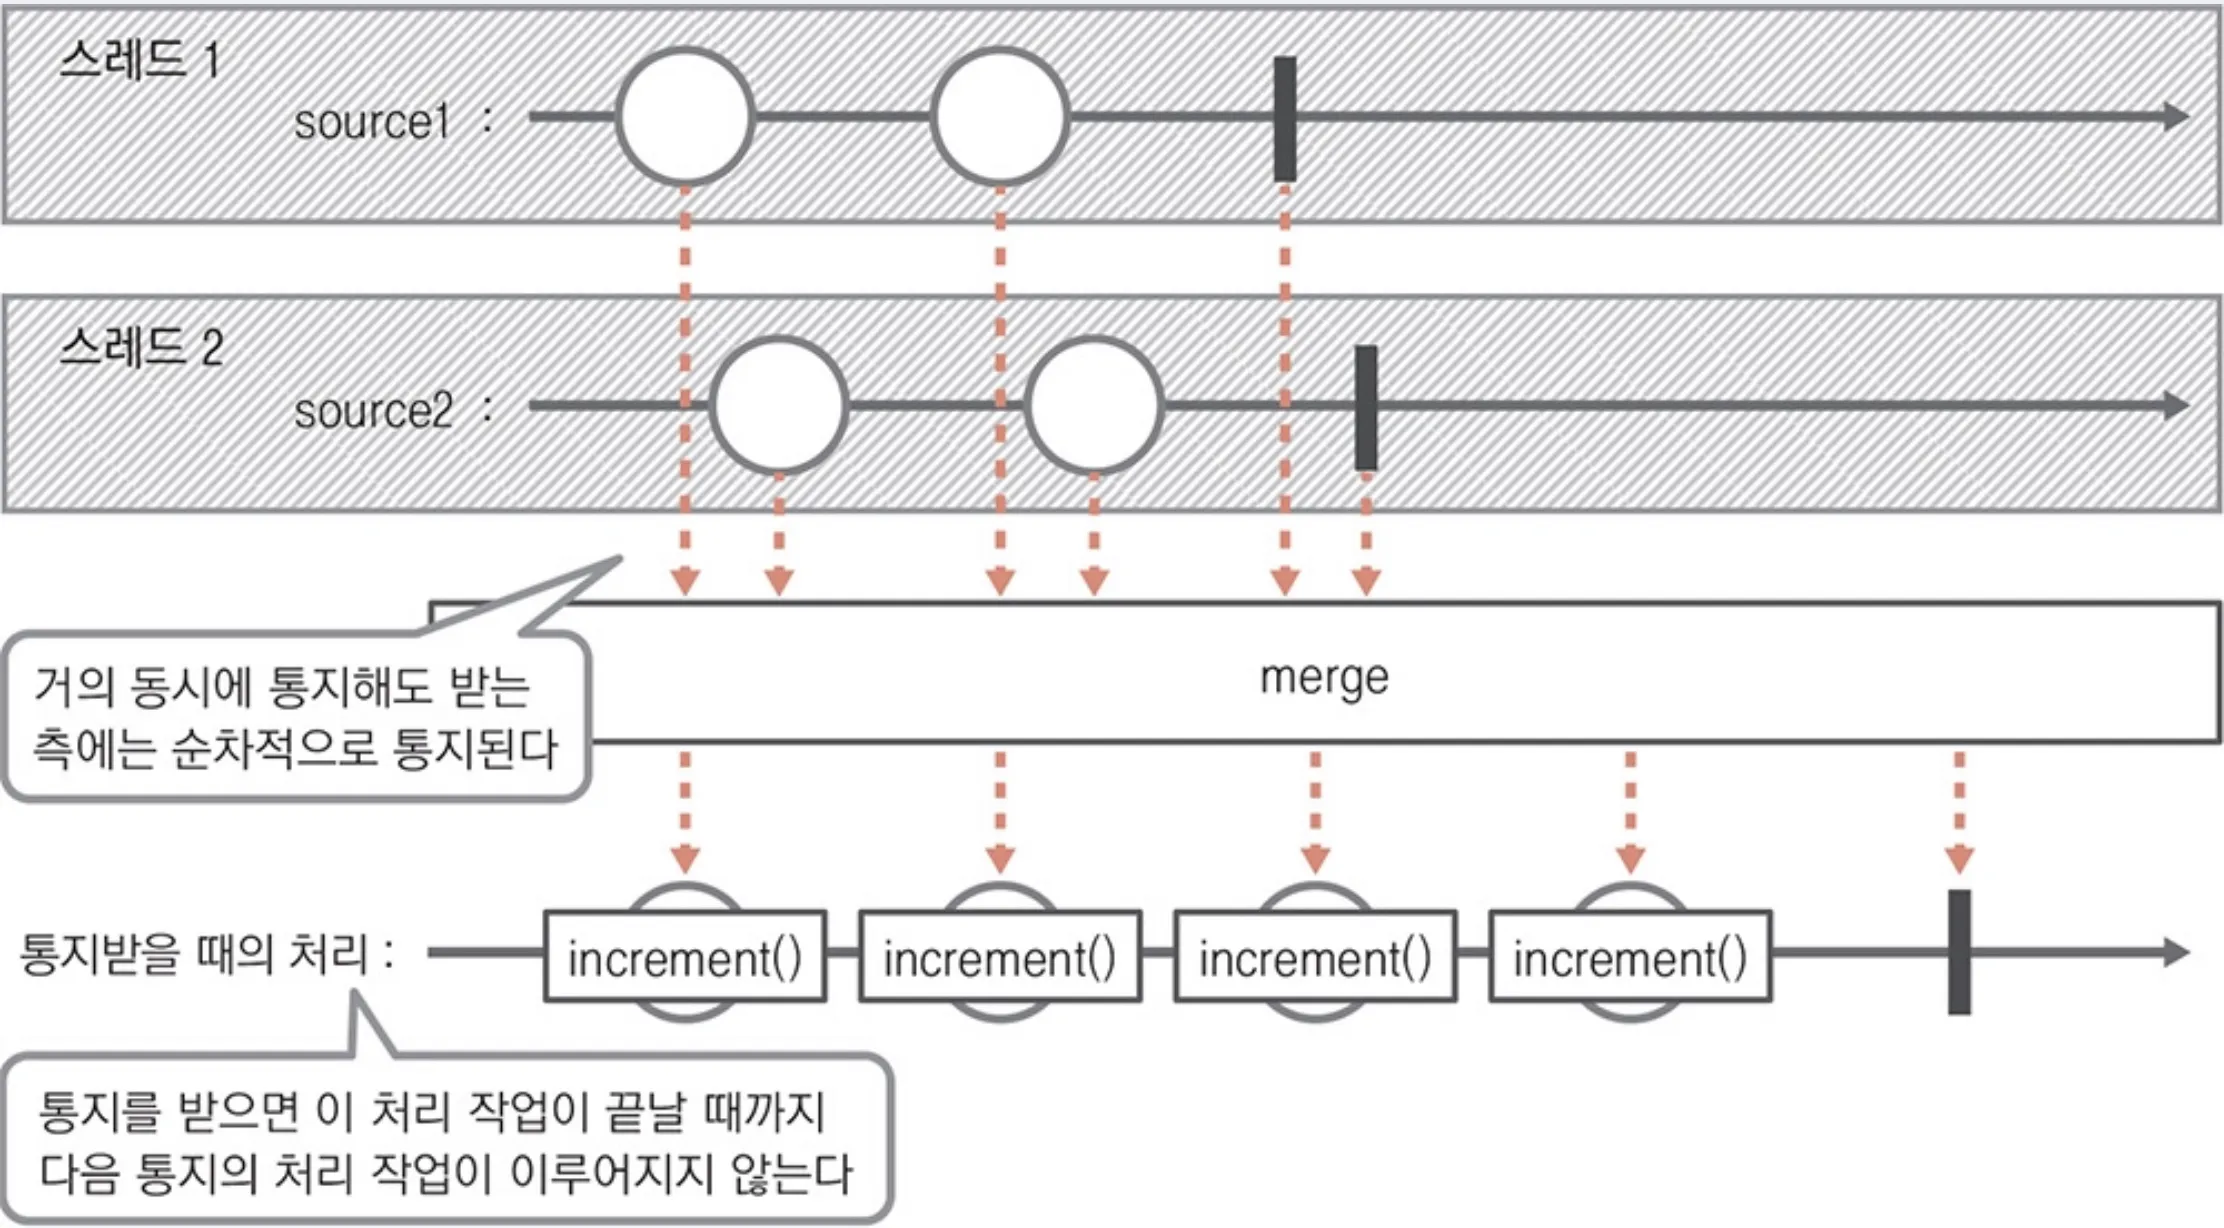
그림의 두 입력 줄은 서로 독립적으로 진행하고 결과 줄에 값이 도착하는 대로 합쳐진다. 따라서 어느 소스의 값이 먼저 나올지는 실행 타이밍에 달려 있다. 원래 이 글의 두 ‘merge 사용 전/후’ 코드는 모두 Flowable.merge(source1, source2)를 사용했는데도 count++ 결과가 각각 20,000보다 작거나 정확하다고 단정했다. 동일한 코드에서 나온 특정 수치를 연산자의 안전성 증거로 볼 수 없다.
import io.reactivex.Flowable;
import io.reactivex.schedulers.Schedulers;

public class MergeCount {
    public static void main(String[] args) {
        Flowable<Integer> first = Flowable.range(1, 10_000)
                .subscribeOn(Schedulers.computation());
        Flowable<Integer> second = Flowable.range(1, 10_000)
                .subscribeOn(Schedulers.computation());

        long count = Flowable.merge(first, second)
                .count()
                .blockingGet();
        System.out.println(count); // 20000
    }
}count()는 병합된 값마다 내부적으로 개수를 세고 두 소스가 모두 완료한 뒤 결과를 하나 보낸다. blockingGet()은 콘솔 예제에서 완료를 기다린다. Thread.sleep(1000)을 기다림의 근거로 쓰면 머신 부하에 따라 아직 완료하지 않은 시점에 프로그램이 끝날 수 있다.
병합 이전 단계에서 여러 소스가 공통 int를 count++로 갱신한다면 여전히 경쟁 조건이 생긴다. volatile은 그 복합 연산을 원자적으로 만들지 않는다. 공유 상태가 꼭 필요하다면 AtomicInteger.incrementAndGet()처럼 원자적 연산을 사용하거나, 위 코드처럼 값을 스트림에 태워 병합 후 한 단계에서 집계한다. 주문이나 로그의 전역 순서까지 필요한 경우에는 merge의 도착 순서에 의존하지 말고 원본에 시퀀스 번호를 붙이거나 순서가 정의된 처리 경계를 선택한다.
참조
같은 카테고리의 글
이어서 읽을 글
9. RxJava 통지 데이터 변환 연산자
map, flatMap, concatMap, buffer를 출력 개수·순서·오류 처리 기준으로 비교한다.
8. RxJava Flowable과 Observable 생성 연산자
RxJava just·fromCallable·defer·interval 등 생성 연산자를 값 준비 시점, 구독 시점, 완료 신호와 배압 기준으로 비교한다.
4. RxJava Buffer 연산자
buffer의 개수·시간 기준 묶음, 완료 시 잔여 항목, 메모리와 배압 문제를 예제로 설명한다.

3. RxJava concatMap과 DelayError 연산자
concatMap의 순차 구독과 concatMapDelayError의 오류 지연을 실행 흐름과 출력 순서로 비교한다.