목차
해시 테이블: 키에서 버킷까지
학생 학번으로 학생 정보를 찾는다고 하자. 배열을 학번 전체 범위만큼 예약하면 인덱스 접근은 빠르지만 쓰지 않는 칸이 많다. 연결 리스트에서 학번을 하나씩 비교하면 공간은 아끼지만 검색에 O(n)이 걸린다. 해시 테이블은 키를 해시 함수에 넣어 적당한 크기의 배열 인덱스를 계산하고, 그 인덱스에 속한 항목만 비교한다.
키 1001 ── 해시 함수 ──> 버킷 1 ──> (1001, 학생 A)
키 1011 ── 해시 함수 ──> 버킷 1 ──> (1011, 학생 B)
배열 크기가 10이고 h(k)=k % 10이면 1001과 1011은 모두 버킷 1이다. 키가 다른데 주소가 같은 충돌이며, 배열 크기를 키 개수보다 작게 쓰는 이상 충돌 가능성을 없앨 수 없다. 삽입·검색·삭제는 해시 주소를 찾은 뒤 키를 다시 비교해야 한다. 주소가 같다는 사실만으로 키가 같다고 판단해서는 안 된다.
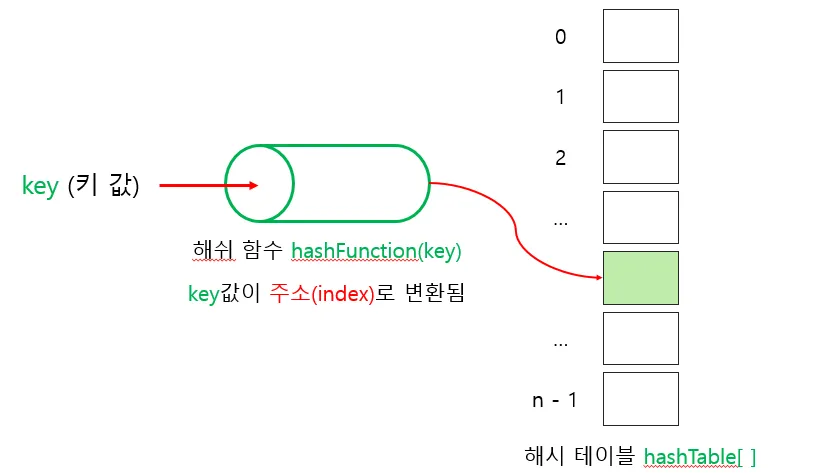
그림에서 해시 함수는 배열의 후보 위치를 계산한다. 같은 위치에 다른 키가 있다면 충돌 해결 절차가 이어진다. 버킷은 해시 주소에 대응하는 저장 구역이고, 슬롯은 그 안의 개별 항목을 놓는 칸을 가리킨다. 구현마다 버킷이 연결 리스트의 머리일 수도, 배열의 한 칸일 수도 있다.
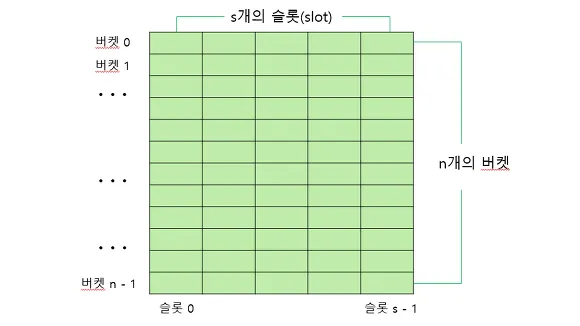
해시 함수와 충돌
정수 키에서는 나머지 연산 h(k)=k % M이 가장 단순하다. M은 0보다 커야 하고, 음수 키를 그대로 C의 % 연산에 넣으면 음수 인덱스가 나올 수 있으므로 정규화해야 한다. 키가 M의 배수로만 들어오면 모든 키가 한 버킷에 몰린다. M을 바꾸거나 키를 충분히 섞는 함수가 필요하다. 문자열의 문자 코드를 단순 합산하면 순서가 달라도 같은 값이 나오므로 분포가 나쁠 수 있다. 문자마다 이전 값을 곱하고 새 문자를 더하는 방식은 순서 차이를 반영한다. 하지만 어떤 일반 해시 함수도 모든 입력에 대해 충돌을 피할 수는 없다.
암호학적 해시와 자료구조용 해시는 목적이 다르다. 전자는 입력 변조 탐지 등의 보안 속성을 목표로 하고, 후자는 빠른 분산과 검색을 목표로 한다. 보안이 필요한 비밀번호 저장에 언어의 기본 해시 테이블용 해시 함수를 쓰면 안 된다. 반대로 해시 테이블 인덱스마다 SHA를 계산하면 보통 불필요한 계산 비용을 낸다.
충돌을 처리하는 두 방법
| 방식 | 충돌 시 행동 | 삭제 시 주의 | 메모리 |
|---|---|---|---|
| 분리 연결(chaining) | 그 버킷의 리스트나 다른 컨테이너에 저장 | 버킷 안에서 같은 키를 찾아 연결 변경 | 노드 할당·참조 필요 |
| 개방 주소(open addressing) | 배열의 다른 빈 칸을 규칙에 따라 탐색 | 단순히 빈 칸으로 바꾸면 검색 사슬이 끊김 | 배열 안에서 해결 |
개방 주소의 선형 조사는 h(k), h(k)+1, h(k)+2 … 순서로 빈 칸을 찾는다(끝에서 처음으로 순환). 예를 들어 크기 5에서 키 1과 6이 모두 1번 버킷이면 6은 2번 칸에 놓일 수 있다. 이후 6을 검색할 때도 1번 칸부터 같은 순서로 조사한다. 1을 삭제하며 1번 칸을 그냥 비우면 6에 도달하지 못할 수 있다. 삭제 표시(tombstone)를 쓰거나 뒤 항목을 적절히 재배치해야 한다. 선형 조사에서는 한 구역에 항목이 몰리는 1차 군집화도 발생한다. 제곱 탐사와 이중 해싱은 조사 순서를 바꾸지만, 모든 버킷을 방문하는지와 삭제 규칙을 별도로 설계해야 한다.
분리 연결은 충돌한 키를 한 버킷 안에 모은다. 아래 C 예제는 정수 키, 정수 값, 고정 크기 5의 버킷을 사용한다. 같은 키를 다시 넣으면 새 노드를 만들지 않고 값을 바꾼다. 실제 서비스에서는 적재율에 따라 버킷 배열을 늘리는 재해싱도 필요하다.
#include <stdbool.h>
#include <stddef.h>
#include <stdio.h>
#include <stdlib.h>
#define BUCKETS 5
typedef struct Entry {
int key, value;
struct Entry *next;
} Entry;
typedef struct Table {
Entry *bucket[BUCKETS];
size_t size;
} Table;
static size_t indexOf(int key) {
int remainder = key % BUCKETS;
if (remainder < 0) remainder += BUCKETS;
return (size_t)remainder;
}
bool put(Table *table, int key, int value) {
if (table == NULL) return false;
size_t index = indexOf(key);
for (Entry *entry = table->bucket[index]; entry != NULL; entry = entry->next) {
if (entry->key == key) {
entry->value = value;
return true;
}
}
Entry *entry = malloc(sizeof *entry);
if (entry == NULL) return false;
entry->key = key;
entry->value = value;
entry->next = table->bucket[index];
table->bucket[index] = entry;
table->size++;
return true;
}
bool get(const Table *table, int key, int *out) {
if (table == NULL || out == NULL) return false;
for (const Entry *entry = table->bucket[indexOf(key)];
entry != NULL; entry = entry->next) {
if (entry->key == key) {
*out = entry->value;
return true;
}
}
return false;
}
bool erase(Table *table, int key) {
if (table == NULL) return false;
Entry **link = &table->bucket[indexOf(key)];
while (*link != NULL) {
Entry *current = *link;
if (current->key == key) {
*link = current->next;
free(current);
table->size--;
return true;
}
link = ¤t->next;
}
return false;
}
void clear(Table *table) {
if (table == NULL) return;
for (size_t i = 0; i < BUCKETS; i++) {
Entry *entry = table->bucket[i];
while (entry != NULL) {
Entry *next = entry->next;
free(entry);
entry = next;
}
table->bucket[i] = NULL;
}
table->size = 0;
}
int main(void) {
Table table = {0};
int value;
if (!put(&table, 1, 100) || !put(&table, 6, 600)) {
clear(&table);
return 1;
}
if (get(&table, 6, &value)) printf("%d\n", value); // 600
erase(&table, 1);
clear(&table);
return 0;
}put(1,100)은 버킷 1의 첫 노드가 된다. put(6,600)도 같은 버킷으로 가며 리스트의 앞에 붙는다. get(6)은 6과 실제 키를 비교해 600을 얻는다. erase는 이중 포인터 link가 현재 노드를 가리키는 참조 자체를 가리키게 한다. 그래서 맨 앞 노드와 중간 노드를 같은 코드로 제거할 수 있다. clear는 각 노드의 next를 해제 전에 저장해 메모리를 안전하게 반환한다. put이 false를 반환하면 할당이 실패했거나 테이블 포인터가 잘못된 것이므로 호출자가 처리해야 한다.
적재율, 재해싱, 복잡도
적재율은 항목 수 n을 버킷 수 M으로 나눈 n/M이다. 분리 연결은 1을 넘어도 저장할 수 있지만 한 버킷의 연결이 길어지면 비교 횟수가 늘어난다. 해시 값이 잘 분산되고 적재율을 관리한다는 가정에서 삽입·검색·삭제의 기대 비용은 O(1)이다. 모든 키가 한 버킷으로 몰리면 각 연산은 O(n)이다. 위 코드는 버킷 수가 5로 고정되어 있으므로 n이 늘어날수록 평균 연결 길이도 늘어난다.
실용적인 재해싱은 새 버킷 배열을 더 크게 만들고, 기존 모든 키를 새 크기에 맞춰 다시 배치한다. 이전 인덱스를 그대로 복사하면 h(k) % 새 크기와 맞지 않는다. 재해싱 한 번은 O(n)이지만, 크기를 충분한 비율로 늘리면 여러 번의 삽입에 나누어 평균 비용을 낮출 수 있다. 재해싱 도중 메모리 할당이 실패할 경우 기존 테이블을 유지할지, 부분 변경을 되돌릴지도 구현 계약에 포함해야 한다.
Java에서는 대부분 직접 구현보다 표준 HashMap을 쓴다. 키의 equals와 hashCode 계약을 지켜야 하며, 키로 쓰는 객체의 비교 대상 필드를 저장 후 변경하면 검색에 실패할 수 있다. 해시 테이블이 저장 순서를 보장한다고 가정하지 말고 순서가 필요하면 별도 자료구조를 선택해야 한다. Oracle HashMap API가 구현의 동작과 복잡도 전제를 설명한다.
같은 카테고리의 글
이어서 읽을 글
8. 해싱(Hashing)
키를 버킷 주소로 바꾸는 해시 함수, 충돌 해결, 적재율과 Java HashMap의 선택 기준을 작은 예제로 설명한다.
7. PriorityQueue(우선순위 큐)
우선순위 큐를 최소 힙으로 구현하면서 삽입 시 위로 올리기, 삭제 시 아래로 내리기와 배열 인덱스 계산을 예제로 설명한다.
7. 그래프(Graph)
인접 행렬과 인접 리스트의 공간·탐색 비용을 비교하고, 방문 배열을 이용한 DFS·BFS의 순서와 적용 조건을 코드로 확인한다.
6. 트리(Tree)
부모·자식 관계와 깊이·높이를 정의하고 일반 트리·수식 트리·이진 트리의 표현과 전위·중위·후위 순회를 코드로 따라간다.