목차
에이전트 AI(AI Agent)
단순히 사용자의 질문에 답하는 수준을 넘어 주어진 목표(Goal)를 달성하기 위해 스스로 계획을 세우고, 필요한 도구를 사용하며, 실행 결과에 따라 다음 행동을 결정하는 능동적인 AI를 의미.
챗봇과 에이전트의 가장 큰 차이는 ‘자율성(Autonomy)‘과 ‘도구 사용(Tool Use)‘에 있다.
| 구분 | 일반적인 챗봇 (Chatbot) | 에이전트 AI (Agent) |
|---|---|---|
| 작동 방식 | 입력에 대해 즉각적인 텍스트 생성 | 목표 달성을 위한 일련의 행동(Action) 수행 |
| 사고 방식 | 알고 있는 지식 내에서 답변 | 모르는 것은 도구를 써서 찾아내고 실행함 |
| 자율성 | 사용자가 시키는 것만 수행 | 목표를 주면 세부 단계를 스스로 설계 |
| 비유 | 질문에 답해주는 ‘백과사전’ | 내 업무를 대신 해주는 ‘유능한 비서’ |
슈튜어드 러셀과 피터 노빅은 에이전트 를 ‘행동의 존재’로 규정했는데 행동(Act) 의 의미를 이렇게 담고 있다.
- 행동하려면 행동을 취할지 결정할 판단력이 필요
- 어떤 행동을 취할지 결정한다는 말은 여러 실행가능한 대안이 존재한다는 의미를 내포. 선택의 여지가 없는 결정은 진정한 결정이라 할 수 없다.
- 에이전트는 의사결정을 위해 내부에 국한되지 않고, 외부 환경에 관한 정보에 접근해야한다.
1. 에이전트 AI의 4대 구성 요소
릴리안 웽(Lilian Weng)의 정의에 따르면, 에이전트는 다음과 같은 구조를 가진다.
① 뇌 (Brain / LLM)
에이전트의 핵심 지능이다. 상황을 판단하고, 어떤 행동을 할지 결정하며, 논리적으로 추론한다. (Tool 또는 CoT가 사용)
- CoT(Chain-of-Thought) : 정답에 도달하기 까지 중간 추론과정을 차근차근 논리적으로 서술하게 만드는 프롬프트 기법 (복잡한 문제를 구체적인 단계로 세분화 → 프롬프트를 순차적으루 진행 → 더 나은 결과 도출)
- 기존 방식 (Standard Prompting): 질문 → 답변 (중간 과정 생략)
- CoT 방식 (Chain-of-Thought): 질문 → 추론 단계 1 → 추론 단계 2 → 추론 단계 3 → 최종 답변
- [CoT의 두 가지 주요 전략]
- ① Zero-shot CoT (지시어 기반)
- 특별한 예시를 주지 않고, 모델에게 논리적으로 생각하라는 ‘마법의 문장’ 하나를 추가하는 방식.
- 핵심 문구: “단계별로 차근차근 생각해보자 (Let’s think step by step)”
- 효과: 작업을 단계로 나누는 데 도움을 줄 수 있지만 정확성을 보장하지 않는다. 계산과 사실은 별도로 검증한다.
- ② Few-shot CoT (예시 기반)
- 모델에게 질문과 답만 주는 것이 아니라, ‘질문 - 풀이 과정 - 답’으로 구성된 예시를 2~3개 제공하는 방식입니다.
- 효과: 모델은 제공된 예시의 ‘사고 방식’을 학습하여, 새로운 문제에 대해서도 유사한 논리 구조로 답변을 생성합니다.
- ① Zero-shot CoT (지시어 기반)
② 계획 (Planning)
거대한 목표를 작은 단위의 태스크로 쪼갠다.
- Reflection(성찰): 과거의 행동을 돌아보고 오류를 수정.
- Subgoal Decomposition: 문제를 하위 목표로 분해하여 차례대로 해결.
③ 기억 (Memory)
- 단기 기억 (Short-term): 현재 대화의 맥락 (Context Window).
- 장기 기억 (Long-term): 외부 데이터베이스나 벡터 DB에 저장된 정보 (RAG 활용).
④ 도구 사용 (Tool Use / Action)
AI가 텍스트 생성을 넘어 물리적/디지털 세계에 영향을 미치는 수단.
- 예: 웹 검색, 파이썬 코드 실행, API 호출(날씨 확인, 이메일 발송, DB 조회 등).
2. 에이전트의 핵심 작동 원리: ReAct (Reason + Act)
에이전트는 보통 “생각하고(Reason) -> 행동하고(Act) -> 관찰한다(Observe)“는 루프를 반복.
- Thought (생각): “사용자가 내일 서울 날씨를 물었네. 현재 나는 날씨를 모르니 검색 도구를 써야겠다.”
- Action (행동):
Google Search("2026년 1월 23일 서울 날씨")실행. - Observation (관찰): “검색 결과: 영하 5도, 맑음.”
- Final Response: “내일 서울은 영하 5도로 맑을 예정입니다. 따뜻하게 입으세요.”
랭그래프 에이전트 구축
[랭그래프 에이전트]
import re
from decimal import Decimal
from typing import TypedDict, Annotated

from langchain_community.tools import DuckDuckGoSearchRun
from langchain_core.messages import HumanMessage
from langchain_core.tools import tool
from langchain_ollama import ChatOllama
from langgraph.constants import START
from langgraph.graph import add_messages, StateGraph
from langgraph.prebuilt import ToolNode, tools_condition

from config.load_sys import llama_model
from langchain_teddynote.messages import stream_response

@tool
def calculator(query: str) -> str:
    """두 숫자의 사칙연산만 허용하는 실습용 계산기."""
    match = re.fullmatch(r"\s*(-?\d+(?:\.\d+)?)\s*([+\-*/])\s*(-?\d+(?:\.\d+)?)\s*", query)
    if not match or len(query) > 80:
        raise ValueError("두 숫자의 사칙연산만 입력하세요.")
    left, op, right = Decimal(match[1]), match[2], Decimal(match[3])
    if abs(left) > 1_000_000 or abs(right) > 1_000_000:
        raise ValueError("입력 범위를 넘었습니다.")
    if op == "/" and right == 0:
        raise ValueError("0으로 나눌 수 없습니다.")
    result = {
        "+": lambda: left + right,
        "-": lambda: left - right,
        "*": lambda: left * right,
        "/": lambda: left / right,
    }[op]()
    return str(result)

search = DuckDuckGoSearchRun()
tools = [search, calculator]

model = ChatOllama(model=llama_model, temperature=0.1).bind_tools(tools)

class State(TypedDict):
    messages: Annotated[list, add_messages]

def model_node(state: State) -> State:
    res = model.invoke(state['messages'])
    return { 'messages': [res] }

builder = StateGraph(State)
builder.add_node('model', model_node)
builder.add_node('tools', ToolNode(tools))
builder.add_edge(START, 'model')
builder.add_conditional_edges('model', tools_condition)
builder.add_edge('tools', 'model')

graph = builder.compile()

graph.get_graph().draw_mermaid_png(output_file_path='graph_tools.png')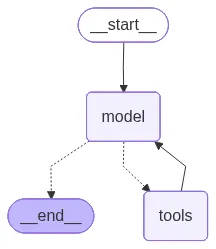
- 검색 툴 (search)과 계산기 툴(calculator) 두 가지를 사용.
- 랭그래프가 제공하는 두가지 함수를 사용
- ToolNode : 상태에 기록된 최신 AI 메시지의 도구 호출을 실행하고 ToolMessage를 반환한다. 도구 예외를 메시지로 바꿀지, 그래프 실패로 처리할지는 사용하는 LangGraph 버전의
handle_tool_errors설정과 서비스 정책을 확인한다. - tools_condition은 상태 내 최신 AI 메시지를 확인한 후, 실행할 툴이 존재하면 tools 노드로 연결하는 조건부 엣지 함수 역할을 한다. 그 외의 경우 그래프를 종료한다.
- 그래프는 model 노드와 tools 노드 사이를 반복한다. 모델이 최종 답을 선택하더라도 서버에는 최대 단계 수·시간 제한·도구 사용량 제한을 둬야 한다. 모델 판단만을 종료 조건으로 두면 반복 호출이 이어질 수 있다.
- ToolNode : 상태에 기록된 최신 AI 메시지의 도구 호출을 실행하고 ToolMessage를 반환한다. 도구 예외를 메시지로 바꿀지, 그래프 실패로 처리할지는 사용하는 LangGraph 버전의
[에이전트 실행]
## 에이전트 실행
input = {
    'messages': [
        HumanMessage(
            '미국의 제 30대 대통령이 사망했을 때 몇 살이었나요?'
        )
    ]
}
response = graph.stream(input)
for chain in response:
    print(chain)
{'model': {'messages': [AIMessage(content='', additional_kwargs={}, response_metadata={'model': 'llama3.1:8b', 'created_at': '2026-01-22T02:16:36.696835Z', 'done': True, 'done_reason': 'stop', 'total_duration': 1432948042, 'load_duration': 85398834, 'prompt_eval_count': 243, 'prompt_eval_duration': 530184166, 'eval_count': 28, 'eval_duration': 674114707, 'logprobs': None, 'model_name': 'llama3.1:8b', 'model_provider': 'ollama'}, id='lc_run--019be37d-40bc-7401-8c90-cc615d8263d6-0', tool_calls=[{'name': 'duckduckgo_search', 'args': {'query': '미국 제 30대 대통령 사망 나이'}, 'id': '854ad83b-f72a-46ba-8d8e-d5fb93ccfbe8', 'type': 'tool_call'}], invalid_tool_calls=[], usage_metadata={'input_tokens': 243, 'output_tokens': 28, 'total_tokens': 271})]}}
{'tools': {'messages': [ToolMessage(content="루스벨트는 3회 이상의 임기를 수행한 유일한 미국의 대통령으로, [7] 그가 사망 한 이후 1951년 미국 수정 헌법 제22조 가 비준되어 한 개인이 두 번을 넘게 대통령으로 선출될 수 없고 타인의 대통령직을 2년 이상 대행한 개인은 1번 넘게 선출될 수 없음을 성문화했다. 프랭클린 D. 루스벨트 는 미국 역사상 유일하게 3선 이상을 재임한 대통령인데, 그는 대공황 과 제 2차 세계대전 의 위기 속에서 지도력을 발휘해 4선 (1932년, 1936년, 1940년, 1944년 대선에 잇따라 당선됨으로써 1932년 3월 4일부터 1945년 4월 12일까지 재임)에 성공했다. 원래는 영국 처럼 의원내각제 와 입헌군주제 를 도입하는 것이 유력했으나, 만약 도입할 경우 군주의 지위가 애매해져서, 그것을 대신할 ' 대통령 '이라는 직함을 새로 만들기로 결정해서 이른바 대통령제 가 탄생했다. Jul 18, 2022 · 한편, 역대 미국 대통령 중 생존- 사망 나이 순위에서는 제39대 대통령 지미 카터가 현재 97세로 여전히 살아있어 1위이고, 제41대 대통령 조지 H.W. 부시가 94세로 사망 해 역대 2위, 제38대 대통령 제럴드 포드가 93세 165일째 사망해 역대 3위, 제40대 대통령이었던 ... Jan 30, 2017 · 존 캘빈 쿨리지 2세 (John Calvin Coolidge, Jr., 1872년 7월 4일 ~ 1933년 1월 5일)는 미국 29대 부통령이며 제 30대 대통령 (1923년 - 1929년)이다. Dec 6, 2024 · 미국 역대 대통령 들의 영문 이름, 재임기간, 주요 업적, 이슈, 평가를 자세히 정리해 보았습니다:1. George Washington (1789-1797)업적: 미국의 초대 대통령으로서 새로운 국가의 기틀을 마련하고, 헌법을 시행했습니다. 프랭클린 D. 루스벨트 는 미국 역사상 유일하게 3선 이상을 재임한 대통령인데, 그는 대공황 과 제 2차 세계대전 의 위기 속에서 지도력을 발휘해 4선 (1932년, 1936년, 1940년, 1944년 대선에 잇따라 당선됨으로써 1932년 3월 4일부터 1945년 4월 12일까지 재임)에 성공했다. Mar 18, 2021 · 캘빈 쿨리지는 제29대 부통령으로, 제 30 대 미국 대통령 워런 G. 하딩이 임기를 시작한 지 2년이 조금 지난 1923년 8월에 사망 하여 제 30 대 대통령으로 당선되었어요. Jul 18, 2022 · 한편, 역대 미국 대통령 중 생존- 사망 나이 순위에서는 제39대 대통령 지미 카터가 현재 97세로 여전히 살아있어 1위이고, 제41대 대통령 조지 H.W. 부시가 94세로 사망 해 역대 2위, 제38대 대통령 제럴드 포드가 93세 165일째 사망해 역대 3위, 제40대 대통령이었던 ... Jan 30, 2017 · 존 캘빈 쿨리지 2세 (John Calvin Coolidge, Jr., 1872년 7월 4일 ~ 1933년 1월 5일)는 미국 29대 부통령이며 제 30대 대통령 (1923년 - 1929년)이다.", name='duckduckgo_search', id='20d6fddb-76d5-4cba-87e9-4c47628568df', tool_call_id='854ad83b-f72a-46ba-8d8e-d5fb93ccfbe8')]}}
{'model': {'messages': [AIMessage(content='미국의 제 30대 대통령인 존 캘빈 쿨리지는 1872년 7월 4일생으로, 1933년 1월 5일 사망했습니다. 따라서 그의 나이는 60세였습니다.', additional_kwargs={}, response_metadata={'model': 'llama3.1:8b', 'created_at': '2026-01-22T02:16:41.891036Z', 'done': True, 'done_reason': 'stop', 'total_duration': 3764854375, 'load_duration': 85187333, 'prompt_eval_count': 1003, 'prompt_eval_duration': 2225978667, 'eval_count': 56, 'eval_duration': 1197558417, 'logprobs': None, 'model_name': 'llama3.1:8b', 'model_provider': 'ollama'}, id='lc_run--019be37d-4bed-7c10-99e0-734eda977731-0', tool_calls=[], invalid_tool_calls=[], usage_metadata={'input_tokens': 1003, 'output_tokens': 56, 'total_tokens': 1059})]}}
Disconnected from server에이전트 아키텍처의 유용한 확장 방향 및 계획 수립과 툴 호출 방법 살펴보기
툴 우선 호출
표준 에이전트 아키텍처에서는 LLM이 항상 다음에 호출할 툴을 결정
[장점]
- 쿼리마다 LLM은 유연하게 애플리케이션의 동작을 조정할 수 있다. 다만, 이와 같은 유연성을 부여하려면 예측 불가능성이라는 대가를 감수해야 한다.
- LLM 호출을 생략함으로써 검색 툴 호출을 위한 요청 생성 과정을 줄여 전체 지연시간을 감소시킨다
- 일부 사용자 쿼리에 관해 LLM이 검색 툴 호출이 불필요하다고 오판하는 상황을 미연하게 방지
# 앞 절에서 정의한 calculator와 import를 재사용한다.
search = DuckDuckGoSearchRun()
tools = [search, calculator]
model = ChatOllama(model=llama_model, temperature=0.1).bind_tools(tools)

class State(TypedDict):
    messages: Annotated[list, add_messages]

def model_node(state: State) -> State:
    res = model.invoke(state['messages'])
    return { 'messages': [res] }

def first_model(state: State) -> State:
    query = state['messages'][-1].content
    search_tool_call = {
        'name': search.name, 'args': {'query': query}, 'id': uuid4().hex
    }
    return {'messages': [AIMessage(content='', tool_calls=[search_tool_call])]}

builder = StateGraph(State)
builder.add_node('first_model', first_model)
builder.add_node('model', model_node)
builder.add_node('tools', ToolNode(tools))
builder.add_edge(START, 'first_model')
builder.add_edge('first_model', 'tools')
builder.add_conditional_edges('model', tools_condition)
builder.add_edge('tools', 'model')

graph = builder.compile()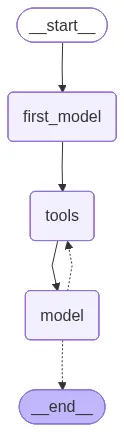
[이전 절차와의 차이점]
- 모든 호출은 first_model을 먼저 호출(LLM은 전혀 호출하지 않는다). 단순히 사용자 메시지를 그대로 쿼리로 활용해 검색 툴 호출을 생성. 기존 아키텍처는 LLM이 툴 호출을 포함한 여러 선택지 중에서 보다 적절하다고 판단한 응답을 생성
- 그 후, 이전 예시와 같은 tools 단계를 진행. 이어서 같은 방식으로 agent 노드로 이동
복수 툴 호출
프롬프트에서 여러 선택지나 과도한 정보가 주어질 경우 어려움을 겪는다.
- 향후 실행할 행동 계획에 영향을 미친다.
- 툴이 많이 제공 될 경우(10개이상), LLM의 계획 성능(적합한 툴을 선택하는 능력)이 저하되는 경향이 있다.
- 결국 LLM이 활용할 툴 수를 제한하게 됨
- 다양한 사용자 쿼리에 활용 할 툴이 많다면?
[대안]
RAG단계를 활용해 현재 쿼리에 가장 적합한 툴을 미리 선별 후, 전체 툴 집합 대신 선별된 툴만 LLM에 전달
- 프롬프트와 출력 길이를 기준으로 요금이 부과되는 LLM 서비스 호출 비용을 줄인다.
반면, RAG 단계는 애플리케이션에 추가 지연을 초래하므로, 추가 툴 도입 후 성능 저하가 관찰될 때만 적용하는 편이 바람직.
[복수 툴 호출 그래프]
from typing import TypedDict, Annotated
from uuid import uuid4

from langchain_community.tools import DuckDuckGoSearchRun
from langchain_core.documents import Document
from langchain_core.messages import HumanMessage, AIMessage
from langchain_core.tools import tool
from langchain_core.vectorstores import InMemoryVectorStore
from langchain_ollama import ChatOllama, OllamaEmbeddings
from langgraph.constants import START
from langgraph.graph import add_messages, StateGraph
from langgraph.prebuilt import ToolNode, tools_condition

from config.load_sys import llama_model

# 첫 번째 그래프에서 정의한 calculator를 재사용한다.
search = DuckDuckGoSearchRun()
tools = [search, calculator]
embeddings = OllamaEmbeddings(model='embeddinggemma')
model = ChatOllama(model=llama_model, temperature=0.1)

tools_retriever = InMemoryVectorStore.from_documents(
    [Document(tool.description, metadata={'name': tool.name}) for tool in tools]
, embeddings
).as_retriever(search_kwargs={'k': 1})

class State(TypedDict):
    messages: Annotated[list, add_messages]
    selected_tools: list[str]

def model_node(state: State) -> State:
    chosen_tools = [item for item in tools if item.name in state['selected_tools']]
    res = model.bind_tools(chosen_tools).invoke(state['messages'])
    return { 'messages': [res] }

def select_tools(state: State) -> State:
    query = state['messages'][-1].content
    tool_docs = tools_retriever.invoke(query)
    return {'selected_tools': [doc.metadata['name'] for doc in tool_docs]}

builder = StateGraph(State)
builder.add_node('selected_tools', select_tools)
builder.add_node('model', model_node)
builder.add_node('tools', ToolNode(tools))

builder.add_edge(START, 'selected_tools')
builder.add_edge('selected_tools', 'model')
builder.add_conditional_edges('model', tools_condition)
builder.add_edge('tools', 'model')

graph = builder.compile()

graph.get_graph().draw_mermaid_png(output_file_path='graph_tools_3.png')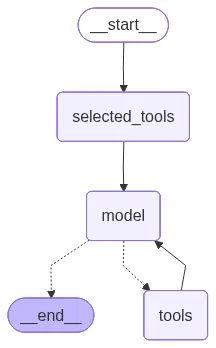
에이전트 반복을 시작하기 전 먼저 select_tools 노드를 거친다. 나머지는 기존 에이전트 아키텍처와 동일하게 동작
실행 경로와 결과 해석
model_node는 현재 메시지를 읽고 일반 답변 또는 도구 호출을 만든다. tools_condition이 호출 유무를 보고 다음 노드를 고른다. 도구 호출이 있으면 ToolNode가 실행 결과를 ToolMessage로 남기고 다시 모델로 돌아간다. 도구 호출이 없으면 그래프가 끝난다.
flowchart LR
    U[사용자 메시지] --> M[모델]
    M -->|도구 호출 없음| F[최종 메시지]
    M -->|도구 호출 있음| T[ToolNode]
    T --> O[ToolMessage: 결과 또는 오류]
    O --> M
위에 기록된 검색 출력에는 서로 다른 대통령과 오래된 웹 문장이 섞여 있다. 최종 답이 그럴듯하더라도 검색 결과의 출처와 날짜가 질문을 뒷받침하는지는 따로 확인해야 한다. 검색 도구가 긴 텍스트를 돌려준다고 해서 사실 검증이 끝나는 것은 아니다. 계산기 역시 처음 코드에서 사용하던 ast.literal_eval은 1 + 2 같은 연산식을 계산하지 못하므로, 위처럼 허용된 두 숫자의 사칙연산만 파싱하도록 바꿨다.
도구를 먼저 호출할 때
first_model은 모델에게 선택을 맡기지 않고 검색 도구 호출 메시지를 만든다. 사용자의 질문에 최신 외부 정보가 반드시 필요하다면 한 번의 모델 판단을 줄일 수 있다. 반면 “안녕” 같은 질문도 검색하게 되므로 지연과 외부 요청이 늘 수 있다. 실행 전에 입력 길이와 검색어를 제한하고, 실제 서비스에서는 사용자별 요청량 상한을 둔다.
도구를 동적으로 선별할 때
마지막 예제는 도구 설명을 임베딩해 질문과 가까운 하나의 도구만 bind_tools로 모델에 전달한다. 앞 코드의 metadata={'name': 'tool.name'}처럼 문자열을 넣으면 모든 문서가 같은 이름을 가지므로 실제 tool.name 값을 저장하도록 수정했다. 또한 selected_tools라는 지역 변수로 전역 tools를 가리면 Python에서 지역 변수를 정의하기 전 참조하는 오류가 나므로 chosen_tools로 분리했다.
도구 검색의 결과는 추천 후보다. 검색 점수가 낮거나 질문이 애매하면 허용 도구를 하나도 주지 않고 추가 질문할 경로가 필요하다. 더 중요한 점은 bind_tools(chosen_tools)가 모델에게 보이는 도구를 줄일 뿐, 도구 실행 서버의 권한을 제한하는 장치가 아니라는 것이다. 여기서는 ToolNode(tools)에 전체 도구 목록을 등록했으므로, 실제 권한 경계가 필요하면 실행 시점에 사용자별 허용 도구와 인자를 별도로 확인해야 한다. 도구 개수가 적다면 검색 단계 없이 고정 목록을 주는 편이 단순하고 지연도 적다.
운영 전 평가 사례
| 질문 | 기대 경로 | 실패로 볼 결과 |
|---|---|---|
| “12 * 7은?” | 계산기 | 웹 검색이나 근거 없는 숫자 |
| “오늘 발표된 공지는?” | 검색 | 내부 지식만으로 현재 공지 단정 |
| “안녕” | 도구 없이 답변 | 불필요한 검색 반복 |
| “메일을 보내줘” | 지원 범위 안내 | 허용하지 않은 쓰기 도구 실행 |
| “1 / 0” | 계산기 입력 오류 | 무한 재시도 또는 서버 예외 노출 |
모델 선택·도구 선택·도구 결과 해석을 각각 기록하면 왜 실패했는지 분리할 수 있다. LangGraph의 도구 사용 패턴과 영속성을 참고해 반복 상한, 상태 저장, 재개 시 중복 호출을 설계한다.
같은 카테고리의 글
이어서 읽을 글
7. 에이전트 아키텍처 II
성찰 루프와 서브그래프·슈퍼바이저 패턴을 상태 전달, 반복 상한, 결과 검증 관점에서 비교한다.
11. LLM 애플리케이션 개발
문서 기반 질문 응답 서비스를 예로 들어 문제 정의, RAG 그래프 구현, 인용 검증, 평가와 배포까지 연결하는 개발 절차.
10. 테스트: 평가, 모니터링, 개선
LLM 애플리케이션의 회귀 테스트, 오프라인 평가 데이터, 운영 추적과 실패 사례를 개선으로 연결하는 방법.
9. AI 애플리케이션 배포
LangGraph 애플리케이션을 서버로 실행할 때 필요한 구성, 상태 저장, 보안, 스트리밍, 배포 검증과 운영 절차.