목차
Priority Queue(우선순위 큐)
-
입력된 순서대로 출력되는 것이 아닌 데이터의 우선순위에 따라 출력순서가 결정되는 것.
-
핵심 = 데이터의 입/출력이 이루어질 때 최소의 비용으로 최소 우선순위의 데이터를 헤드에 위치시키는 것.
-
우선순위 큐는 삽입과 제거의 연산을 지원하는 자료구조
우선순위 큐의 구현방법
-
배열기반으로 구현하는 방법
-
연결리스트로 구현하는 방법
-
힙으로 구현하는 방법
기본원리
(아래 조건은 배열 or 연결리스트로 구현하는 것을 예 로듬)
데이터가 작으면 우선순위가 높은 걸로 가정
우선순위 큐의 삽입 연산
- 20이란 데이터를 집어 넣으려고 하면 queue에 있는 리스트들을 검색하여 19 보단 크고 21보다는 작은 데이터 사이에 추가한다.
우선순위 큐의 제거 연산
- 제일 앞에 있는 데이터를 제거한다. (why? 데이터의 수가 가장 적은 것이 우선순위가 높다고 가정했으므로)
그러나 배열이나 연결리스트로 구현하게되면 삽입할 때마다 데이터를 당기고 밀어야 하고 데이터를 삽입하기 위해 순차 탐색을 해야한다.
그래서 Heap이란 것을 사용한다.
Heap
- Heap은 프로그래밍에서 말하는 Free Store가 아니라 Heap Order Property(힙 순서 속성)을 만족하는 완전 이진트리이다.
위키백과에서 말하는 Heap의 정의
힙(heap)은 최댓값 및 최솟값을 찾아내는 연산을 빠르게 하기 위해 고안된 완전이진트리(Complete binary tree)를 기본으로 한 자료구조(tree-based structure) 로서 다음과 같은 힙 속성(property)을 만족한다.
- A가 B의 부모노드(parent node) 이면, A의 키(key)값과 B의 키값 사이에는 대소관계가 성립한다.
힙에는 두 가지 종류가 있다
-
최대 힙(Max Heap) : 부모노드의 key값이 자식노드의 키값보다 항상 큼
-
최소 힙(Min Heap) : 부모노드의 key값이 자식노드의 키값보다 항상 작은
key값의 대소관계는 오로지 부모노드와 자식노드 간에만 성립하며, 특히 형제 사이에는 대소관계가 정해지지 않는다.
최대 힙과 최소 힙은 부모와 자식 사이의 대소 관계만 다르다. 아래 구현은 각 노드의 자식이 최대 둘인 이진 힙(binary heap)이다.
힙에서는 가장 높은(혹은 가장 낮은) 우선순위를 가지는 노드가 항상 뿌리노드에 오게 되는 특징이 있으며, 이를 응용하면 우선순위 큐와 같은 추상적 자료형을 구현할 수 있다.
Heap에 새 노드 삽입
MAX HEAP
-
마지막 레벨의 왼쪽부터 비어 있는 다음 자리에 새 노드를 추가해 완전 이진 트리를 유지한다.
-
삽입한 노드는 부모노드와 비교하고 부모노드보다 삽입한 노드가 더 크면 부모노드와 위치를 바꾸고, 부모노드가 더 크면 현재 위치를 유지한다.
-
삽입한 노드는 부모노드보다 더 크면 2번을 반복한다.
MIN HEAP
-
마지막 레벨의 왼쪽부터 비어 있는 다음 자리에 새 노드를 추가해 완전 이진 트리를 유지한다.
-
삽입한 노드는 부모노드와 비교하고 부모노드보다 삽입한 노드가 더 작으면 부모노드와 위치를 바꾸고, 부모노드가 더 작으면 현재 위치를 유지한다.
-
삽입한 노드는 부모노드보다 더 작으면 2번을 반복한다.
Heap에 노드 삭제
MAX HEAP
-
Heap에 있는 루트노드를 삭제(왜냐하면 제일 큰 값이기 때문에)
-
완전 이진 트리의 마지막 노드를 루트로 옮겨 빈자리를 메운다.
-
루트노드로 옮긴 노드는 양쪽 자식노드랑 비교하여 큰 값을 갖는지 확인한다.
-
큰 값이라면 현재 위치를 그대로 유지하고 그렇지 않으면 양쪽 자식노드 중 큰 값을 가지고 있는 노드와 위치를 바꾼다.
-
3번, 4번을 반복한다.
MIN HEAP
-
Heap에 있는 루트노드를 삭제(왜냐하면 제일 작은 값이기 때문에)
-
완전 이진 트리의 마지막 노드를 루트로 옮겨 빈자리를 메운다.
-
루트노드로 옮긴 노드는 양쪽 자식노드랑 비교하여 작은 값을 갖는지 확인한다.
-
작은 값이라면 현재 위치를 그대로 유지하고 그렇지 않으면 양쪽 자식노드 중 작은 값을 가지고 있는 노드와 위치를 바꾼다.
-
3번, 4번을 반복한다.
구현
- Heap을 구현할 때 연결 리스트 기반으로 할 경우 힙의 가장 마지막 노드, 즉 최고 깊이의 최 우측 노드를 어떻게 찾을 것인가라는 문제의 효율적인 답을 얻기 어려우므로 배열을 자주 사용한다.
완전 이진트리를 배열로 나타내는 방법
-
깊이 0의 노드를 배열의 0번째 요소에 저장
-
깊이 1의 노드(모두 2개)는 배열의 1~2번 요소에 저장
-
깊이 2의 노드(모두 4개)는 배열의 3~6번 요소에 저장
-
깊이 n의 노드(최대 2^n개)는 배열의 2^n-1부터 2^(n+1)-2까지 저장된다. 마지막 깊이는 일부 칸만 사용될 수 있다.
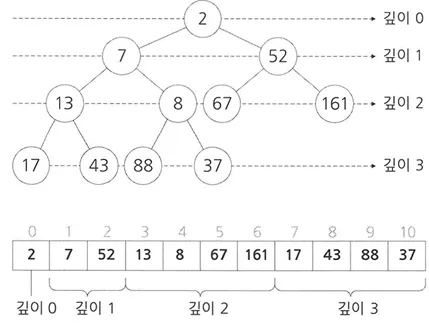
Priority
배열의 장점
-
완전트리인 힙의 각 노드의 위치를 부모/자식 관계등을 배열의 인덱스로만으로 단번에 알 수 있다
-
k번 인덱스에 위치한 노드의 양쪽 자식 노드들이 위치한 인덱스
- 왼쪽 자식 노드 : 2k + 1
- 오른쪽 자식 노드 : 2k + 2
-
k번 인덱스에 위치한 노드의 부모 노드가 위치한 인덱스 : (k-1)/2의 몫
작은 최소 힙을 배열로 구현하기
힙의 불변식은 부모 값이 두 자식 값보다 크지 않다는 것이다. 배열 전체가 정렬되어 있어야 하는 것은 아니다. 예를 들어 [2, 5, 3, 9]는 2가 자식 5와 3보다 작고, 5가 자식 9보다 작으므로 최소 힙이다. 이때 두 번째로 작은 값이 반드시 배열의 두 번째 칸에 있다는 보장은 없다.
import java.util.ArrayList;
import java.util.List;

public final class MinHeap {
    private final List<Integer> values = new ArrayList<>();

    public void add(int value) {
        values.add(value);
        int child = values.size() - 1;
        while (child > 0) {
            int parent = (child - 1) / 2;
            if (values.get(parent) <= values.get(child)) break;
            swap(parent, child);
            child = parent;
        }
    }

    public int peek() {
        if (values.isEmpty()) throw new IllegalStateException("힙이 비었습니다");
        return values.get(0);
    }

    public int poll() {
        if (values.isEmpty()) throw new IllegalStateException("힙이 비었습니다");
        int result = values.get(0);
        int last = values.remove(values.size() - 1);
        if (!values.isEmpty()) {
            values.set(0, last);
            int parent = 0;
            while (true) {
                int left = parent * 2 + 1;
                if (left >= values.size()) break;
                int right = left + 1;
                int smaller = right < values.size()
                        && values.get(right) < values.get(left) ? right : left;
                if (values.get(parent) <= values.get(smaller)) break;
                swap(parent, smaller);
                parent = smaller;
            }
        }
        return result;
    }

    private void swap(int a, int b) {
        int value = values.get(a);
        values.set(a, values.get(b));
        values.set(b, value);
    }
}
삽입할 때는 마지막 칸에 놓아 완전 이진 트리의 모양을 유지하고, 부모와 비교하면서 위로 올린다. [2, 5, 3, 9]에 1을 넣으면 [2, 5, 3, 9, 1]에서 부모 5와 교환하고 다시 부모 2와 교환해 [1, 2, 3, 9, 5]가 된다. 마지막 원소만 붙이고 이동하므로 각 단계에서 힙의 다른 가지는 영향을 받지 않는다.
삭제할 때는 루트 값을 보관하고 마지막 값을 루트로 옮긴다. 루트가 자식보다 크다면 두 자식 중 더 작은 쪽과 바꾸며 아래로 내린다. 자식이 하나뿐이면 그 자식만 비교한다. 위 코드는 빈 힙에서 예외를 던지고, 크기가 1인 경우 루트 삭제 후 곧바로 반환한다.
완전 이진 트리의 높이는 이므로 삽입과 삭제는 각각 , 최소값 확인은 이다. 내부 배열이 커질 때 재할당이 일어나면 한 번의 삽입 비용은 더 클 수 있다. 같은 우선순위의 항목은 FIFO 순서를 보장하지 않는다. 순서까지 필요하면 단조 증가하는 번호를 함께 비교 기준에 넣는다.
실제 Java 코드에서는 표준 구현을 사용할 수 있다.
import java.util.PriorityQueue;

PriorityQueue<Integer> queue = new PriorityQueue<>();
queue.offer(5);
queue.offer(2);
queue.offer(3);
System.out.println(queue.peek()); // 2
System.out.println(queue.poll()); // 2
System.out.println(queue.poll()); // 3
Java의 PriorityQueue는 기본적으로 작은 값이 먼저 나오며, Comparator로 순서를 바꿀 수 있다. Iterator 순서는 우선순위 순서가 아니고, null은 넣을 수 없다. 빈 큐에서 poll은 null을 반환한다. Oracle PriorityQueue API는 offer·poll이 , peek이 이라고 명시한다. 요청을 도착 순서대로 처리해야 한다면 일반 큐, 우선순위가 가장 높은 작업을 반복해서 꺼내야 한다면 우선순위 큐를 고른다.
같은 카테고리의 글
이어서 읽을 글
8. 해싱(Hashing)
키를 버킷 주소로 바꾸는 해시 함수, 충돌 해결, 적재율과 Java HashMap의 선택 기준을 작은 예제로 설명한다.
6. hash(해시)
해시 함수가 키를 배열 인덱스로 바꾸는 과정, 충돌 해결, 적재율과 재해싱을 실제 코드로 살펴봅니다.
7. 그래프(Graph)
인접 행렬과 인접 리스트의 공간·탐색 비용을 비교하고, 방문 배열을 이용한 DFS·BFS의 순서와 적용 조건을 코드로 확인한다.
6. 트리(Tree)
부모·자식 관계와 깊이·높이를 정의하고 일반 트리·수식 트리·이진 트리의 표현과 전위·중위·후위 순회를 코드로 따라간다.