목차
1. PK 컬럼 순서, 대충하지 말자
여러 개의 컬럼으로 구성된 PK 구성 테이블에서 있는 그대로 테이블을 생성해 버리면 발생하는 문제점
-
인덱스 구성에서 의도하지 않은 순서의 Primary Key Unique Index가 생성된다.
-
그에 따라 SQL 실행 시 성능 저하 현상이 나타날 수 있다.
-
많은 인덱스가 생성되므로 입력/수정/삭제 시 불필요한 내부 작업이 증가해 성능에 악영향을 마친다.
해결방법
- 테이블 생성 전에 SQL Where 절을 분석하여 엔티티 타입의 PK 컬럼 순서를 조정하는 작업을 수행해야 한다.(PK 순서 트랜잭션의 처리 유형에 의해 조정)
1-1. PK 구성과 인덱스 이용
- 스키마를 생성하기 이전에 데이터 모델의 PK 순서를 조절하지 않은 채 테이블을 생성하면 인덱스를 이용하지 못해 테이블 Full Scan 현상이 발생할 경우가 있다.
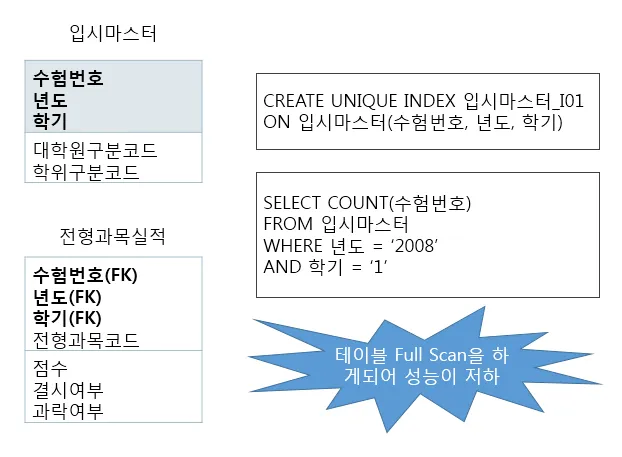
그림 [1-1] 비효율적인 PK 순서 인덱스
- 입시마스터_I01 인덱스가 수험번호+년도+학기 중 수험번호에 대한 값이 Where절에 들어오지 않아 Full Table Scan이 발생한다.
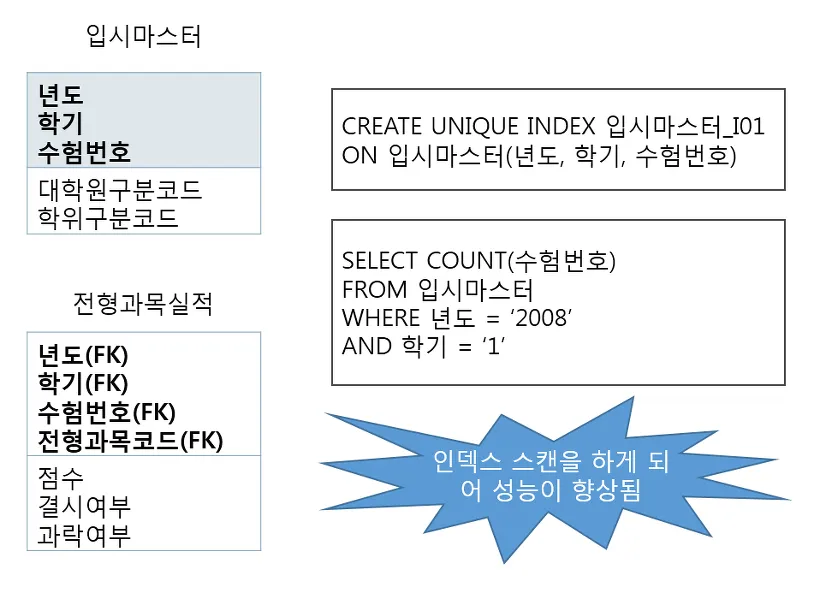
[그림 1-2] 효율적인 PK 순서 인덱스
입시 마스터 테이블에 데이터를 조회할 때 년도와 학기에 대한 내용이 빈번하게 들어가므로 다음과 같이 PK 순서를 변경함으로 인덱스를 이용하도록 만들었다.
1-2. 인덱스의 비효율적 이용
현금출금실적 테이블에 PK는 거래일자+사무소코드+출급기번호+명세표번호로 되어있는데
대부분의 SQL 문장에서 조회를 할 때 사무소코드가 ‘=’로 들어오고 거래일자에 대해서는 ‘BETWEEN’조회를 하고 있다. 이런 유형의 트랜잭션 성능이 좋은 상태로 나타날 수 있을까?
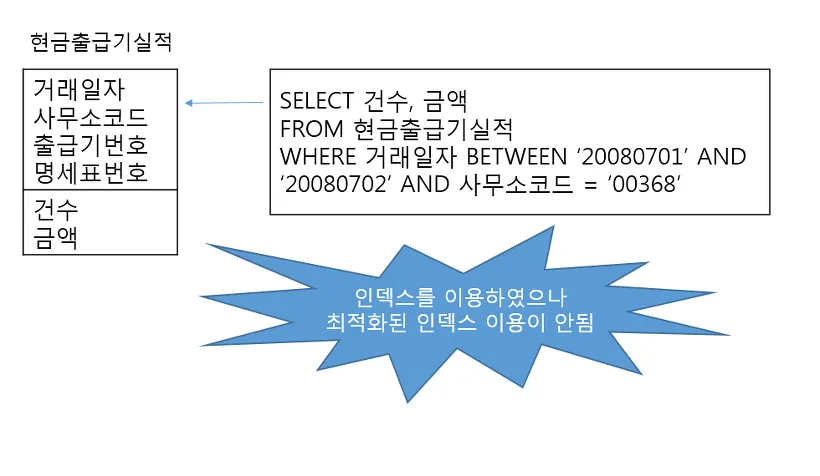
[그림 1-3] WHERE 절과 테이블 PK의 문제
- 인덱스가 정상적으로 이용되었기 때문에 SQL문장은 잘 튜닝된 것으로 착가할 수 있다. 문제는 인덱스를 이용하기는 하는데 넓은 범위 조회로 인해 SQL실행 성능이 심각하게 저하되어 나타나는데 있다.
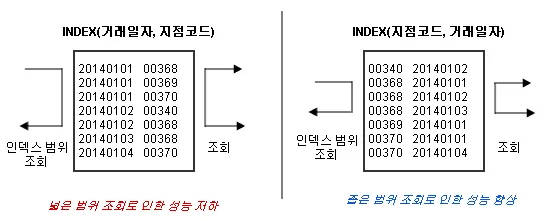
그림 [1-4] PK 순서에 따른 검색 범위
- 거래일자+사무소코드 순서로 인덱스를 구성한 경우와 사무소코드+거래일자 순서로 인덱스를 구성한 경우에 데이터를 처리하는 범위가 어떻게 달라지는지 보여줌.
이와 같이 테이블의 PK 구성을 조정하여 PK 인덱스 조회시 범위를 줄임으로써 성능 향상을 유도할 수 있다.
테이블의 PK 구조를 그대로 둔 상태에서 인덱스만 하나 더 만들어도 성능을 개선할 수 있다. 하지만 이미 만들어진 PK 인덱스가 전혀 사용되지 않는다면 입력, 수정, 삭제 시 불필요한 인덱스로 인해 성능이 더 저하되어 좋지 않다.
최적화된 인덱스 생성을 위해서는 PK순서 변경을 통해 인덱스를 생성하는 것이 바람직
3. PK 컬럼 순서를 효율적으로 만드려면
설계 단계를 마치기 전 데이터 모델링을 수행할 때 PK 컬럼 순서를 반드시 검토하여 조정해야 한다.
PK 순서 잘못으로 SQL 문장의 성능 저하 원인은 크게 두 가지가 있다.
-
인덱스를 이용하지 못하고 Full Table Scan으로 성능이 저하
-
인덱스를 이용하는데 범위가 넓어져 성능이 저하되는 경우
-
인덱스의 정렬(Sort) 구조를 이해한 상태에서 트랜잭션의 특성에 따른 PK 구성을 하여 인덱스 범위를 최소화하는 방향으로 데이터 모델에 반영해야 한다.
-
PK 순서를 결정할 때에는 인덱스 정렬 구조를 이해한 상태에서 인덱스를 효율적으로 이용할 수 있도록 해야한다.
두 인덱스에서 읽는 범위 비교
원문의 출금 예제를 (거래일자, 사무소코드, 출금기번호, 명세표번호) 복합 기본 키로 생각해 보자. 대부분의 조회가 사무소코드 = 'A01'과 거래일자 BETWEEN ...을 함께 사용한다면, (사무소코드, 거래일자, ...) 순서의 B-tree 인덱스는 먼저 한 사무소를 좁히고 그 안에서 날짜 범위를 읽기 쉽다. 반대로 (거래일자, 사무소코드, ...)는 기간 안의 여러 사무소 값을 훑은 다음 코드를 필터링할 수 있다. 어느 쪽이 유리한지는 기간 폭, 사무소 수와 분포, DBMS 옵티마이저에 따라 달라진다.
SELECT 출금기번호, SUM(출금액)
FROM 현금출금실적
WHERE 사무소코드 = 'A01'
  AND 거래일자 >= DATE '2024-01-01'
  AND 거래일자 < DATE '2024-02-01'
GROUP BY 출금기번호;
위 SQL은 열 이름과 날짜 리터럴을 지원하는 DBMS라는 전제의 개념 예시다. 실제 테이블·타입에 맞게 바꿔야 한다. 동등 조건에 쓰는 열을 범위 조건 열 앞에 놓는 것이 이 패턴에서 좋은 출발점일 수 있지만, 무조건적인 공식은 아니다. 정렬 순서, 다른 쿼리, 선택도, 커버링 여부와 실제 실행 계획이 최종 판단 기준이다. 복합 인덱스의 앞쪽 열이 없는 조건에서도 DBMS가 다른 경로를 선택하거나 인덱스 일부를 활용할 수 있으므로 “인덱스를 절대 못 쓴다”도 지나친 단정이다.
flowchart LR
  Q[자주 실행되는 쿼리 목록] --> F[동등·범위·정렬 조건 분리]
  F --> I[후보 인덱스 순서]
  I --> E[실제 데이터로 EXPLAIN·실행 시간 비교]
  E --> W[쓰기 비용과 다른 쿼리 영향 검토]
기본 키 순서 변경의 비용
기본 키는 단순 조회 속도 설정이 아니라 행의 식별 규칙이다. 열의 조합이 정말 유일하고 안정적인지 먼저 정해야 한다. MySQL InnoDB처럼 기본 키가 클러스터링 인덱스를 이루는 엔진에서는 PK 변경이 데이터 저장 구조와 보조 인덱스의 크기·조회 비용까지 영향을 줄 수 있다. 이미 운영 중인 테이블의 PK를 바꾸면 외래 키, 애플리케이션의 키 직렬화 순서, 데이터 마이그레이션과 잠금·다운타임을 검토해야 한다. 따라서 특정 검색 하나 때문에 PK를 즉시 바꾸는 것이 항상 최선은 아니다.
| 선택 | 읽기 장점 | 비용·제약 |
|---|---|---|
| PK 순서 변경 | 주요 조회와 저장 순서를 맞출 수 있음 | 식별·외래 키·마이그레이션 영향 큼 |
| 보조 인덱스 추가 | 기존 PK 계약 유지 | 저장 공간과 INSERT/UPDATE/DELETE 비용 |
| 쿼리 변경 | 필터·범위 개선 가능 | 업무 결과가 같아야 함 |
EXPLAIN 또는 DBMS의 실제 실행 계획에서 읽은 행 수, 인덱스 조건, 잔여 필터를 확인한다. 동일한 데이터 규모에서 변경 전후 대표 쿼리를 측정하고, 쓰기 처리량도 함께 비교한다. 새 인덱스가 기존 PK와 거의 같은 내용을 중복한다면 정리 가능성을 살피되, 삭제 전에 다른 쿼리가 그 인덱스를 사용하는지도 조사한다. 원문의 그림은 설계 아이디어를 전달하는 자료이고 실제 서버의 성능 결과를 대체하지 않는다.
이어서 읽을 글
테이블 복사(Table Copy)
MySQL에서 테이블 구조·데이터·조건에 맞는 행을 복사하는 명령을 구분하고, 복사 후 제약 조건과 결과를 확인한다.
Spring AI
Spring AI의 ChatModel·ChatClient·Prompt·Advisor가 요청을 처리하는 흐름과 Kotlin API, 스트리밍, 운영 시 검증 기준을 살펴본다.
4. Agentic Engineering(에이전틱 엔지니어링) — AI 에이전트를 설계하고 조율하는 기술
에이전트의 목표·상태·도구·종료 조건을 설계하고, 권한과 재시도 경계를 둔 뒤 단일·멀티 에이전트 구조를 평가하는 방법.
하네스 엔지니어링으로 서비스 만들어보기
작은 FAQ 서비스 예제로 요구 문서, 허용 작업 범위, Gradio UI, 테스트와 변경 검토를 연결하는 하네스 작업 순서.