목차
IN, BETWEEN 연산자
WHERE 절에서 여러 값 중 하나를 고르거나 연속된 범위를 고를 때 IN과 BETWEEN을 사용한다. 두 연산자는 조건의 뜻을 간결하게 표현한다. 원래 메모의 “IN은 빠르고 BETWEEN은 느리다”처럼 연산자만 보고 속도를 단정할 수는 없다. 실제 속도는 인덱스, 데이터 분포, DBMS의 실행 계획에 달려 있다.
IN: 목록 중 하나와 일치
SELECT name, job, salary
FROM employee
WHERE name IN ('SMITH', 'ALLEN', 'BLAKE');
name = 'SMITH' OR name = 'ALLEN' OR name = 'BLAKE'를 짧게 쓴 형태다. 앞의 예제 결과 이미지도 이 목록에 포함된 직원만 보여준다.
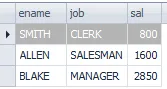
NULL은 값이 없거나 알려지지 않았음을 뜻하므로 IN 목록에 NULL을 더한다고 NULL인 행이 선택되지는 않는다. 그런 행이 필요하면 name IS NULL을 별도로 조건에 넣는다. 특히 NOT IN의 목록에 NULL이 들어가면 예상과 달리 많은 행이 제외될 수 있다. PostgreSQL의 IN·NOT IN 설명이 이 동작을 예제로 설명한다.
BETWEEN: 양쪽 끝을 포함하는 범위
SELECT ename, job, sal
FROM emp
WHERE sal BETWEEN 1000 AND 2000;
sal >= 1000 AND sal <= 2000과 같다. 따라서 급여가 정확히 1000 또는 2000인 행도 포함한다. 앞의 예제 이미지는 이 구간에 들어온 직원의 결과다.
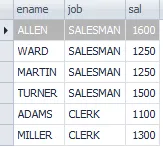
아래쪽 값과 위쪽 값의 순서를 바꾸면 일반적인 BETWEEN에서는 원하는 구간이 나오지 않는다. 경계를 빼고 싶다면 비교 연산자를 직접 쓴다.
-- 1000 초과, 2000 미만
SELECT ename, job, sal
FROM emp
WHERE sal > 1000 AND sal < 2000;
날짜·시간 컬럼에 BETWEEN '2026-01-01' AND '2026-01-31'을 쓰면, 값이 시각까지 포함되는 컬럼에서는 1월 31일의 늦은 시각을 놓칠 수 있다. 한 달 전체를 고를 때에는 created_at >= '2026-01-01' AND created_at < '2026-02-01'처럼 다음 경계 직전까지 표현하는 편이 명확하다. PostgreSQL의 비교 연산자 문서는 BETWEEN이 양쪽 끝을 포함한다고 명시한다.
성능 확인
동일한 조건을 BETWEEN과 >=·<=로 표현했다고 어느 쪽이 항상 빠른 것은 아니다. MySQL의 범위 최적화 문서는 인덱스 조건에 IN과 BETWEEN을 모두 포함한다. 느린 쿼리를 만나면 먼저 EXPLAIN으로 실제 인덱스 사용 여부와 읽는 행 수를 확인한다.
세 값으로 경계를 직접 확인하기
sal이 999, 1000, 2000, 2001인 네 행을 생각하면 BETWEEN 1000 AND 2000에는 1000과 2000을 포함한 두 행이 들어온다. 경계를 포함하지 않는 요구라면 sal > 1000 AND sal < 2000으로 쓴다. IN ('SMITH', 'ALLEN')은 순서가 있는 범위가 아니라 두 값 중 하나와 같은지 확인한다. 이름에 대소문자·공백 차이가 있으면 DBMS의 정렬 규칙에 따라 기대와 다른 결과가 나올 수 있다.
-- 상태 목록과 날짜 반열린 구간을 함께 사용
SELECT order_id, status, created_at
FROM orders
WHERE status IN ('paid', 'shipped')
  AND created_at >= TIMESTAMP '2026-01-01 00:00:00'
  AND created_at <  TIMESTAMP '2026-02-01 00:00:00';
이 SQL의 TIMESTAMP 리터럴 지원과 시간대 해석은 DBMS에 따라 다르다. 저장된 값이 UTC인지 로컬 시각인지 먼저 확인한다. 기간 끝을 다음 달 첫 시각으로 두면 1월 31일의 마지막 소수 초까지 따로 계산할 필요가 없다. NOT IN에 NULL이 섞이면 SQL의 3값 논리 때문에 예상보다 적은 행이 나올 수 있다. 목록이 다른 테이블에서 오고 NULL이 있을 수 있다면 NOT EXISTS와의 차이를 실제 데이터로 검증한다.
성능은 연산자 단독의 속도보다 인덱스와 읽는 행 수에 좌우된다. EXPLAIN으로 필터가 인덱스 탐색에 쓰이는지, 인덱스 뒤에서 남은 조건으로 평가되는지 본다. 아주 긴 IN 목록은 쿼리 유지 관리와 계획 비용을 늘릴 수 있어 임시 테이블이나 조인이 더 나을 수도 있다. 먼저 값의 개수와 실행 계획을 측정한다.
같은 카테고리의 글
이어서 읽을 글
[SQL] Join(조인)
INNER·CROSS·OUTER·SELF JOIN의 차이를 살펴보고, 작은 표로 결과 행 수와 ON·WHERE 조건의 영향을 확인한다.
CDATA 키워드
XML 매퍼에서 CDATA로 비교 기호를 표현하는 방법과 적용 범위를 살펴보고, 엔티티 이스케이프·값 바인딩과 구분한다.
테이블 복사(Table Copy)
MySQL에서 테이블 구조·데이터·조건에 맞는 행을 복사하는 명령을 구분하고, 복사 후 제약 조건과 결과를 확인한다.
Spring AI
Spring AI의 ChatModel·ChatClient·Prompt·Advisor가 요청을 처리하는 흐름과 Kotlin API, 스트리밍, 운영 시 검증 기준을 살펴본다.