목차
Kafka에 Spark 스트리밍 연결
이 글 앞부분의 Receiver/Direct 방식은 과거 DStream API의 비교다. 새 파이프라인에는 Spark의 Structured Streaming API가 일반적인 출발점이다. “정확히 한 번 처리”도 모든 출력 저장소에 자동으로 적용되는 보장이 아니므로, 글 끝의 오프셋·체크포인트·출력 설계를 함께 확인한다.
Spark Streaming
스파크 스트리밍은 빠르고 확장성이 용이하며, 빠른 처리성능과 내결함성을 지원하는 실시간 처리 시스템이다. 데이터 스트리밍은 생산 로그, 클릭 흐름(click stream) 데이터, kafka, AWS Kinesis, flume 등의 다양한 데이터를 제공하는 시스템을 데이터 소스로 활용한다. 또한 데이터를 수신하는 API를 제공하고, 데이터에서 가치있는 값을 얻기 위해 복잡한 알고리즘을 적용한다. 최종적으로 가공된 데이터는 일종의 저장소 시스템으로 향하게 된다.
스파크에는 두 가지 접근 방식이 있다.
- 수신자 기반 접근방식(Receiver-based approach)
- 직접 접근 방식(Direct approach)
1. 수신자 기반 통합 접근방식(Receiver-based approach)
스파크는 수신자를 구현하기 위해 상위 레벨의 컨슈머 API를 사용한다. kafka Topic Partition에서 받은 데이터는 스파크 실행기와 스트리밍 잡(Streaming Job) 프로세스에 저장된다. 하지만 스파크 수신자는 모든 실행기에 걸쳐 메시지를 복제하는데. 이것은 하나의 실행기가 실패할 경우 다른 실행기가 처리할 복제된 데이터를 제공할 수 있어야 하기 때문이다. 스파크는 이런 방식으로 데이터에 대한 내 결함성을 제공한다.
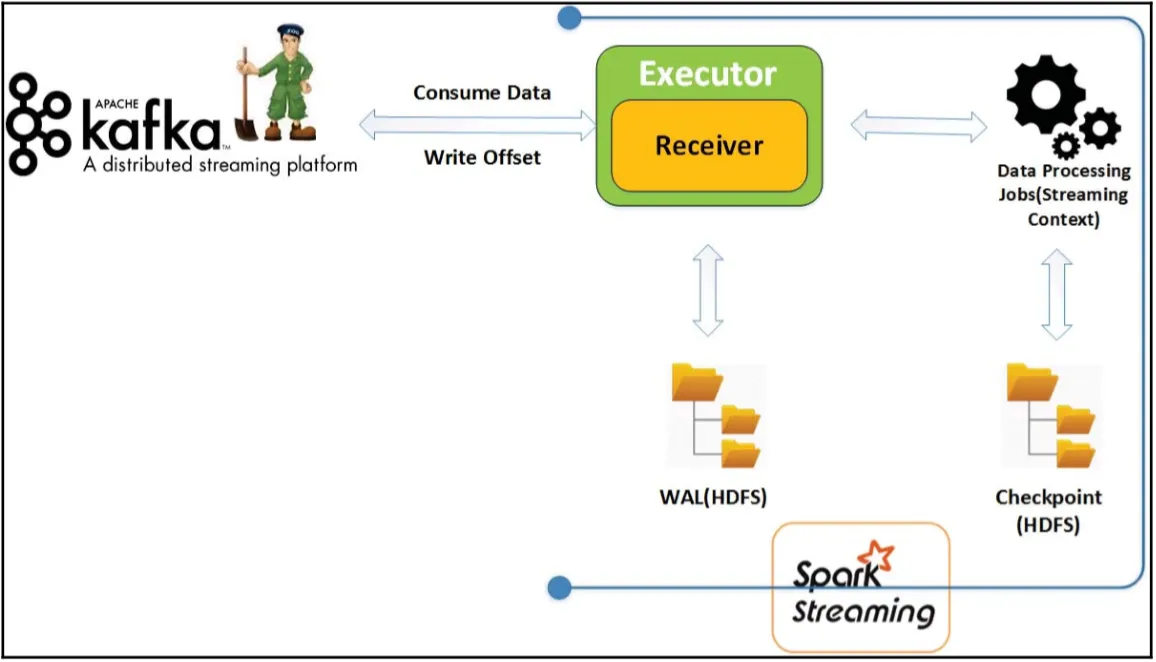
스파크 수신자는 메시지가 성공적으로 실행기에 복제될 때만 브로커에게 통지를 하는데, 그렇지 않으면 주키퍼에 메시지 오프셋이 커밋되지 않고, 메시지는 아직 읽지 않은 상태로 남게 된다.
스파크 드라이버에 장애가 나게 될 경우 모든 실행 프로그램을 종료하므로 실행기에서 사용할 수 있는 데이터가 손실된다. 스파크 수신자가 그러한 메시지에 대해 이미 ACK를 보냈고, 주키퍼로 오프셋을 성공적으로 커밋을 했으면 레코드가 처리됐거나 처리되지 않았는지 알 수 없으므로 레코드를 잃어버리게 된다.
이 문제를 방지하기 위한 방법
- 로그 선행 기입(WAL : Write-Ahead Log)
- 정확한 1회 처리
- 검사점(checkpoint)
수신자 기반 통합 접근 방식의 단점
- 처리성능 : 로그 선행 기입과 검사점 활성화로 인한 처리성능이 저하될 수 있다.
- 저장소 : 스파크 실행기 버퍼에 한 세트의 데이터를 저장하고, 동일 데이터에 대한 하나의 세트를 선행 기입 로그용 HDFS에 저장한다.
- 데이터 손실 : 로그 선행 기입을 활성화하지 않았다면 데이터를 손실할 가능성이 크고, 일부 중요한 어플리케이션에 심각한 영향을 줄 수 도 있다.
2. 직접 접근 방식(Direct Approach)
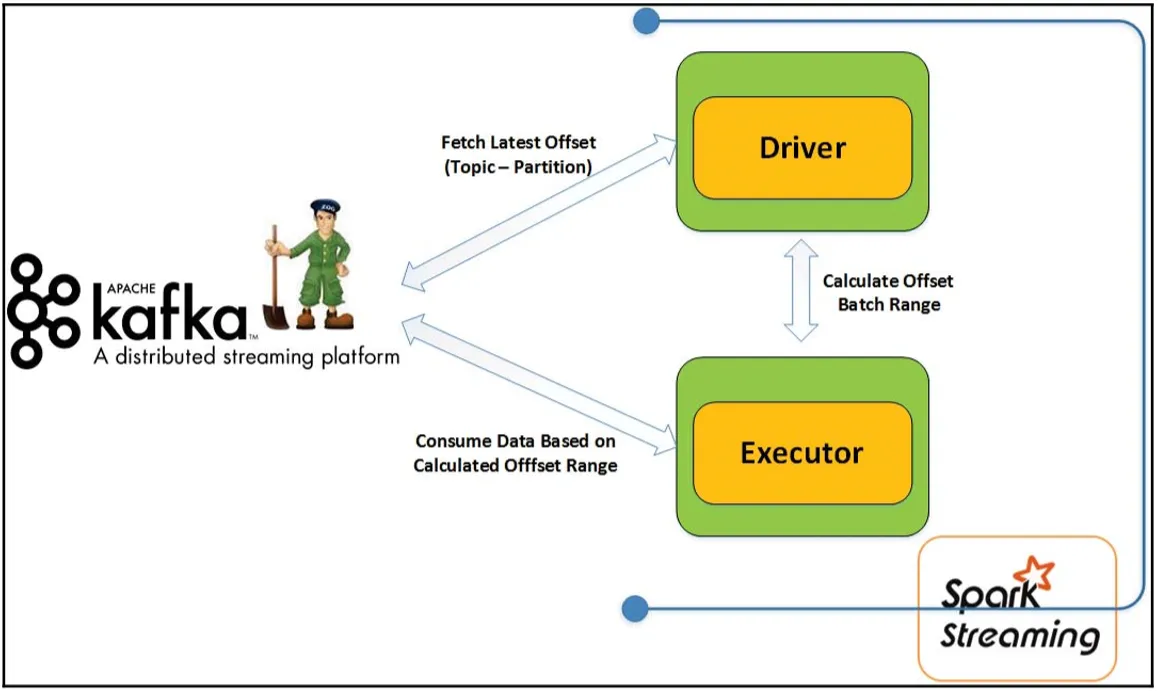
수신자 기방 통합 접근방식의 문제점과 단점을 극복하기 위한 방식으로 배치라고 하는 일정 범위의 오프셋으로 카프카에서 메시지를 주기적으로 질의해온다. 스파크는 하위 레벨 컨슈머 API를 사용하고, 정의된 오프셋 범위로 카프카에서 직접 메시지를 가져온다. 병렬 처리라는 카프카에서 파티션 단위로 정의되며, 스파크의 직접 접근 방식은 파티션 장점으로 활용한다.
기능
- 병렬 처리와 처리 성능 : RDD 안의 파티션 수는 카프카 토픽 하나의 파티션 개수에 의해 정의되고, 카프카 토픽 파티션에서 병렬로 메시지를 읽는다.
- 로그 선행 기입 배제 : 데이터 손실을 막기 위해 로그 선행 기입을 하지 않고, 카프카에서 데이터를 직접 읽고 처리된 메시지를 검사점에서 커밋한다.
- 주키퍼 배제 : 기본값으로 스파크에 의해 사용되는 오프셋을 커밋하기 위해 주키퍼를 사용하지 않는다.
- 정확한 1회 처리 : 정확하게 한 번만 처리할 수 있는 기회를 제공한다.
Structured Streaming으로 연결해 보기
최근 Spark의 Kafka 소스는 스트리밍 DataFrame을 만든다. 토픽의 각 레코드는 key, value, topic, partition, offset, timestamp 같은 컬럼으로 읽힌다. key와 value는 기본적으로 바이너리이므로 텍스트 JSON을 다룬다면 먼저 문자열로 변환하고 스키마에 맞게 파싱한다. 다음은 로컬 검증용 콘솔 출력 예제다.
from pyspark.sql import SparkSession

spark = SparkSession.builder.appName("orders-stream-demo").getOrCreate()
records = (
    spark.readStream.format("kafka")
    .option("kafka.bootstrap.servers", "localhost:9092")
    .option("subscribe", "orders")
    .option("startingOffsets", "earliest")
    .load()
)
view = records.selectExpr(
    "CAST(key AS STRING) AS event_key",
    "CAST(value AS STRING) AS event_value",
    "topic", "partition", "offset"
)
query = (
    view.writeStream.format("console")
    .option("checkpointLocation", "/tmp/orders-stream-demo-checkpoint")
    .start()
)
query.awaitTermination()
Spark와 Kafka를 연결하는 패키지 spark-sql-kafka-0-10은 설치한 Spark·Scala 버전과 맞아야 한다. 예를 들어 Spark 4.2 문서에는 해당 릴리스와 Scala 2.13용 아티팩트가 안내된다. 코드만 복사하고 커넥터를 빠뜨리면 Failed to find data source: kafka가 날 수 있다. localhost는 Spark driver/executor가 브로커와 같은 네트워크에서 해당 주소로 접근할 수 있을 때만 맞는다. 분산 클러스터에서는 broker의 광고 주소까지 모든 executor에서 연결되는지 확인한다.
flowchart LR
  K[Kafka 파티션과 오프셋] --> R[Spark Kafka 소스]
  R --> T[마이크로 배치 또는 연속 처리]
  T --> S[출력 저장소]
  T --> C[체크포인트: 진행 위치·상태]
startingOffsets=earliest는 새 쿼리가 처음 시작할 때 적용된다. 이미 체크포인트가 있는 쿼리를 재시작하면 저장된 진행 위치에서 이어진다. 콘솔 sink는 동작 확인에 적합하지만 운영 데이터의 결과 저장소가 아니다. 운영에는 파일·테이블·Kafka 등 적절한 sink를 선택하고, 체크포인트를 작업자 노드의 임시 폴더가 아니라 재시작 후에도 접근 가능한 저장소에 둔다. 서로 다른 쿼리가 같은 체크포인트 경로를 공유하면 상태가 섞일 수 있다.
장애 뒤 어느 부분을 다시 처리할까
Spark는 Kafka의 오프셋 범위와 처리 진행을 체크포인트에 기록한다. 배치 처리 중 worker가 실패하면 같은 범위를 다시 읽을 수 있다. 따라서 외부 데이터베이스에 단순 INSERT를 실행한 뒤 체크포인트 갱신 전에 죽으면 중복 행이 생길 수 있다. 출력 저장소가 멱등 쓰기나 트랜잭션을 지원하는지, foreachBatch를 쓴다면 배치 ID와 업무 키로 중복을 막을 수 있는지 검토한다. 특히 Kafka sink는 재처리 때 중복 레코드가 발생할 수 있다는 공식 설명이 있으므로 “Spark를 쓰면 끝까지 정확히 한 번”이라고 단정하지 않는다.
| 문제 | 확인 |
|---|---|
| Kafka 소스를 못 찾음 | Spark 버전과 Kafka 커넥터 아티팩트 |
| 처음부터 다시 읽히지 않음 | 기존 체크포인트와 startingOffsets 적용 시점 |
| 데이터가 안 옴 | 브로커 광고 주소, 토픽, 파티션, 현재 오프셋 |
| 결과 중복 | sink의 멱등성, 체크포인트, 재실행 범위 |
원문의 Receiver 방식은 오래된 Spark Streaming 구성에서 왜 로그 선행 쓰기와 재시도 비용을 논의했는지 보여 준다. 현재 설계에서는 Structured Streaming의 소스·체크포인트·sink 보장을 사용 중인 Spark 버전 문서에서 확인한다. Kafka 토픽의 보존 기간보다 재시작 지연이 길면 필요한 오프셋이 이미 삭제됐을 수도 있다.
참고: Spark Structured Streaming Kafka 연동, Structured Streaming 가이드, Spark Streaming 구 Kafka 연동.
같은 카테고리의 글
이어서 읽을 글
kafka에 Storm 연결하기
KafkaSpout에서 Bolt로 메시지가 전달되는 과정을 따라가며, 커넥터 설정과 오프셋·재처리·중복 처리 문제를 살펴본다.
Kafka REST Proxy
Confluent REST Proxy의 HTTP API로 Kafka 메시지를 보내고 구독·조회하며, 컨슈머 정리와 v2·v3의 차이를 살펴본다.
[Kafka] 8. Spring Boot를 이용한 Kafka API 구축
Spring Boot에서 Kafka 메시지를 발행·소비하는 API를 구성하고, HTTP 응답과 비동기 메시지 처리 시점의 차이를 살펴본다.
[Kafka] 7. Apache Flume
Flume의 Source·Channel·Sink를 따라 로그가 이동하는 흐름을 이해하고, Kafka 연동 설정과 결과 확인 방법을 살펴본다.