목차
객체를 네트워크로 보낼 때: 메시지 경계와 ByteBuf
이 글의 처음 실습은 Spring 4.2.5 / Netty 4.1.0.Final 환경에서 Java Serializable 객체를 ObjectEncoder·ObjectDecoder로 보낸 기록이었다. 아래 두 화면은 당시 서버와 클라이언트가 객체 값을 주고받은 결과다. 현재 Netty API는 이 두 클래스를 직렬화 보안 위험 때문에 deprecated로 표시한다. 바이트 배열을 만든 뒤 다시 ObjectInputStream으로 복원하는 방식도 같은 역직렬화 위험을 없애지 못한다. 따라서 그 코드는 새 서비스의 수신 경로에 적용하지 않는다.
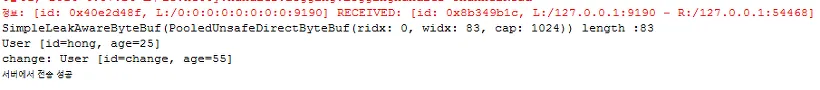
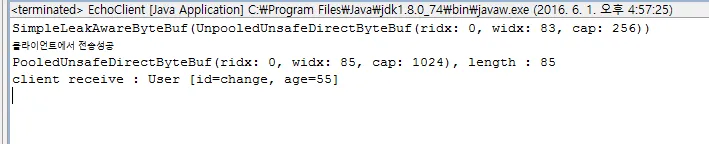
현재 사용할 프로토콜을 새로 정한다. 여기서는 User(id, age)를 예로 들어 프레임 길이 4바이트, ID 길이 2바이트, UTF-8 ID, 나이 4바이트 순서로 보낸다. 네트워크 바이트 순서는 Netty ByteBuf의 기본 빅엔디언을 사용한다. Java 객체의 내부 구현을 그대로 전송하지 않고 필드별 계약을 명시하면 다른 언어의 클라이언트도 같은 형식으로 구현할 수 있다.
+------------------+------------------+----------------+-----------+
| frame length: 4B | id length: 2B    | UTF-8 id: N B | age: 4B   |
+------------------+------------------+----------------+-----------+
길이 필드의 값은 뒤따르는 본문 길이(2 + N + 4)다. 본문이 1020바이트면 헤더까지 전체 프레임이 1024바이트다. TCP는 메시지 경계를 보존하지 않으므로 한 번의 channelRead에 정확히 한 객체가 도착한다고 가정하면 안 된다. 한 프레임이 여러 읽기로 쪼개지거나 두 프레임이 한 읽기로 합쳐질 수 있다.
1. 프레임 경계를 먼저 복원하기
LengthFieldBasedFrameDecoder는 스트림에서 앞 4바이트를 읽어 한 메시지 단위로 나눈다. 최대 프레임 길이를 제한해 지나치게 큰 요청으로 메모리를 고갈시키는 일을 줄인다. LengthFieldPrepender는 응답을 보낼 때 본문 앞에 4바이트 길이를 붙인다.
final class UserProtocol {
    static void install(ChannelPipeline pipeline) {
        pipeline.addLast(new LengthFieldBasedFrameDecoder(
                1024, // 전체 프레임의 최대 길이
                0,    // 길이 필드 시작 위치
                4,    // 길이 필드 크기
                0,    // 길이 필드는 본문 길이만 표현
                4     // 다음 핸들러에는 길이 필드를 제거해 전달
        ));
        pipeline.addLast(new LengthFieldPrepender(4));
        pipeline.addLast(new UserEncoder());
        pipeline.addLast(new UserDecoder());
        pipeline.addLast(new UserEchoHandler());
    }
}
파이프라인의 입력 방향은 LengthFieldBasedFrameDecoder → UserDecoder → UserEchoHandler다. 출력은 역방향으로 UserEncoder → LengthFieldPrepender를 지난다. 따라서 UserEncoder가 본문 바이트를 쓰면 prepender가 길이 필드를 추가한다. 코드의 import는 Netty io.netty.channel.*, io.netty.handler.codec.* 및 아래 User 타입에 맞춰 넣는다.
flowchart LR
  C["클라이언트 User"] --> E["필드 인코딩"]
  E --> L["길이 필드 추가"]
  L --> T["TCP 바이트 스트림"]
  T --> F["길이 기반 프레임 분리"]
  F --> D["필드 길이·범위 검증"]
  D --> H["서버 UserEchoHandler"]
그림의 TCP 바이트 스트림에서는 객체 경계가 사라진다. F가 먼저 한 프레임을 복원하므로 D는 부분 메시지를 객체로 해석하지 않는다. 반대로 D가 필드 값을 검사하지 않으면 완성된 프레임이어도 잘못된 나이나 지나치게 긴 ID를 애플리케이션에 전달할 수 있다.
2. 객체를 필드별로 인코딩·검증하기
다음 User는 Java 17의 record를 쓴 작은 예시다. 네트워크 프로토콜의 필드 의미와 범위는 송신자와 수신자가 함께 지켜야 한다.
public record User(String id, int age) { }final class UserEncoder extends MessageToByteEncoder<User> {
@Override
protected void encode(ChannelHandlerContext ctx, User user, ByteBuf out) {
if (user.id() == null || user.id().isBlank()
|| user.age() < 0 || user.age() > 150) {
throw new IllegalArgumentException("invalid user");
}
byte[] id = user.id().getBytes(StandardCharsets.UTF_8);
if (id.length > 64) {
throw new IllegalArgumentException("id too long");
}
out.writeShort(id.length);
out.writeBytes(id);
out.writeInt(user.age());
}
}64는 문자 수가 아니라 UTF-8 바이트 수다. 한글 ID는 문자 하나가 여러 바이트를 차지하므로 문자 길이만 검사하면 프레임 크기 제한과 어긋난다. 송신 측 검사는 편의를 위한 것이며, 신뢰할 수 없는 클라이언트를 상대하는 서버는 수신 측에서 다시 검사해야 한다.
final class UserDecoder extends MessageToMessageDecoder<ByteBuf> {
    @Override
    protected void decode(ChannelHandlerContext ctx, ByteBuf in,
                          List<Object> out) throws Exception {
        if (in.readableBytes() < 6) {
            throw new CorruptedFrameException("missing fields");
        }
        int idLength = in.readUnsignedShort();
        if (idLength < 1 || idLength > 64
                || in.readableBytes() != idLength + 4) {
            throw new CorruptedFrameException("invalid id length");
        }
        byte[] idBytes = new byte[idLength];
        in.readBytes(idBytes);
        String id = StandardCharsets.UTF_8
                .newDecoder()
                .onMalformedInput(CodingErrorAction.REPORT)
                .decode(ByteBuffer.wrap(idBytes))
                .toString();
        int age = in.readInt();
        if (id.isBlank() || age < 0 || age > 150) {
            throw new CorruptedFrameException("invalid user");
        }
        out.add(new User(id, age));
    }
}MessageToMessageDecoder<ByteBuf>가 입력 ByteBuf를 소비한 뒤 해제하는 기본 동작을 전제로 한다. 이 버퍼를 다른 스레드에 보관하거나 다음 핸들러에 원본으로 넘기는 설계로 바꾸면 참조 카운트 소유권을 다시 따져야 한다. 길이·UTF-8 형식·범위를 검증하고 나서만 User를 생성한다. malformed UTF-8을 조용히 대체 문자로 바꾸지 않도록 decoder의 오류 정책도 명시했다.
3. 서버에서 처리하고 실패를 확인하기
final class UserEchoHandler extends SimpleChannelInboundHandler<User> {
    @Override
    protected void channelRead0(ChannelHandlerContext ctx, User user) {
        ctx.writeAndFlush(user);
    }

    @Override
    public void exceptionCaught(ChannelHandlerContext ctx, Throwable cause) {
        // 실제 서비스에서는 원인별 지표와 요청 ID를 기록한다.
        ctx.close();
    }
}SimpleChannelInboundHandler<User>는 메시지 타입이 맞을 때 메서드를 호출한다. 인코더가 응답 User를 다시 바이트로 바꾼다. 외부에 공개하는 서버라면 인증, TLS, 읽기 타임아웃, 연결 수 제한, 요청 빈도 제한도 프로토콜 앞단에서 설계해야 한다. 위 에코 핸들러는 바이트 계약을 설명하는 실습용이다.
검증할 입력은 정상 User("kim", 30) 하나로 끝나지 않는다. 길이 필드만 보내고 본문을 중단한 경우, idLength가 본문보다 큰 경우, 최대 길이를 넘는 경우, 잘못된 UTF-8, 음수 나이, 두 프레임을 한 번에 보낸 경우를 각각 확인한다. EmbeddedChannel을 사용하면 실제 소켓을 열지 않고 파이프라인의 입력·출력과 버퍼 해제 여부를 테스트할 수 있다. 실패 시 연결을 닫는지, 오래 기다리는 연결이 무한정 리소스를 점유하지 않는지도 확인한다.
Java 객체 그래프를 그대로 주고받는 요구라면 우선 JSON이나 Protobuf처럼 필드 스키마를 명시할 수 있는 형식을 고려한다. 형식만 바꿔도 입력 검증은 필요하다. JSON이라면 본문 길이 제한과 스키마 검증을, Protobuf라면 스키마 버전과 필드 호환성을 관리해야 한다.
참고: Netty 4.x 사용자 가이드, 길이 기반 프레임 디코더, 참조 카운트, ObjectDecoder의 deprecated 및 보안 설명.
같은 카테고리의 글
이어서 읽을 글
[Netty]네티서버에 필요한 요소
EventLoopGroup·Channel·Pipeline·Handler가 요청을 처리하는 순서를 따라가며 Netty 서버의 구성 요소와 책임을 구분한다.
[Netty] @Sharable
Netty 핸들러를 여러 채널이 공유할 때 생기는 상태 경쟁을 살펴보고, 채널별 데이터와 @Sharable 사용 기준을 정리한다.
[Netty] 1. 네티 프레임워크
Netty의 이벤트 루프와 채널 파이프라인을 따라 연결과 메시지가 처리되는 흐름을 살펴보고 ByteBuf 관리의 주의점을 짚는다.
[Netty] 네티 ServerBootstrap 만들기
ServerBootstrap으로 줄바꿈 경계를 가진 NIO 에코 서버를 만들고, bind·종료 절차와 전송 방식 선택을 확인한다.