최신 글
기술과 일상을 함께 기록합니다.
엘라스틱 스택
Elasticsearch·Kibana·Beats·Logstash의 역할을 구분하고, 검색 매핑과 데이터 수집·색인·조회 흐름을 살펴본다.
1.데이터의 이해
데이터 유형과 속성을 구분하고, 주문 데이터 예제로 전처리·탐색적 분석과 데이터 누수를 피하는 방법을 살펴본다.
2. MongoDB Query
MongoDB의 find·findOne과 필드 선택, 비교 조건을 예제로 익히고 누락된 필드와 느린 조회의 원인을 살펴본다.
3. RabbitMQ의 기본 비동기 메시지 전송
Spring AMQP로 RabbitMQ 큐와 송수신 코드를 구성하고, 메시지 전달 경로와 발행 확인·소비 확인 응답의 차이를 살펴본다.
2. 주요 용어와 Exchange의 이해
RabbitMQ의 Producer·Exchange·Queue·Consumer 역할을 연결하고, 라우팅 키와 Exchange 유형별 메시지 전달 방식을 비교한다.
1. RabbitMQ 개요
RabbitMQ를 활용한 비동기 메시징의 용도와 AMQP 라우팅 구조를 살펴보고, Mac 설치와 메시지 큐의 역할을 정리한다.
1. MongoDB -기본
MongoDB의 도큐먼트·컬렉션·BSON 구조를 이해하고, 데이터 생성·조회·수정·삭제의 기본 명령을 살펴본다.
[SQLServer] 프로시저 및 함수 사용법
SQL Server 프로시저와 함수의 생성·실행·변경 방법을 살펴보고, OUTPUT 매개변수·반환 값·반환 코드를 구분한다.
Kafka에 Spark 스트리밍 연결
Kafka 데이터를 Spark Structured Streaming으로 읽는 흐름을 살펴보고, 오프셋·체크포인트·출력 저장소의 복구 역할을 구분한다.
kafka에 Storm 연결하기
KafkaSpout에서 Bolt로 메시지가 전달되는 과정을 따라가며, 커넥터 설정과 오프셋·재처리·중복 처리 문제를 살펴본다.
Kafka REST Proxy
Confluent REST Proxy의 HTTP API로 Kafka 메시지를 보내고 구독·조회하며, 컨슈머 정리와 v2·v3의 차이를 살펴본다.
0. Spark 소개
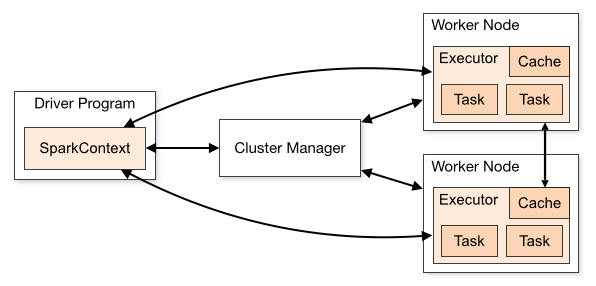
Spark의 Driver·Executor·RDD 구조와 변환·액션의 실행 흐름을 살펴보고, SQL·스트리밍·머신러닝 구성 요소를 정리한다.