목차
Apache Storm
Apache Storm은 이벤트를 토폴로지로 연결한 여러 작업자에서 계속 처리하는 분산 스트림 처리 프레임워크다. 추천 신호나 이상 활동 탐지처럼 지속적으로 들어오는 데이터에 규칙을 적용할 수 있다. 처리량과 지연은 토폴로지, 네트워크, 입력량에 따라 달라지므로 “노드마다 초당 수백만 개”처럼 고정된 성능을 보장할 수는 없다. 과거의 기본 구성에서는 ZooKeeper가 클러스터 조정에 쓰였으며, Storm은 상태 있는 처리와 체크포인트도 지원한다.
클러스터 구조
스톰은 마스터-슬레이브(master-slave)구조로 되어있고 님버스(nimbus)가 마스터이고, 수퍼파이저(supervisor)가 슬레이브가 된다.
-
님버스(nimbus) : 스톰 클러스터 마스터노드로 클러스터 안에서 나머지 모든 노드를 작업자 노드라고 한다. 님버스는 작업자 노드에게 데이터를 분배하고, 작업을 할당한다. 또한 작업자의 장애를 모니터하고, 장애가 발생하면 다른 작업자에게 작업을 다시 할당한다.
-
수퍼바이저(Supervisor) : 수퍼바이저는 님버스가 할당한 작업을 완료하는 역할을 하고, 가용한 자원 정보를 전송한다. 개별 작업자 노드는 정확히 한 개의 수퍼바이저가 있으며, 한 개 이상의 작업자 프로세스를 갖고 있고, 각 수퍼바이저는 다중 작업자 프로세스를 관리한다.
[Strom 구조]

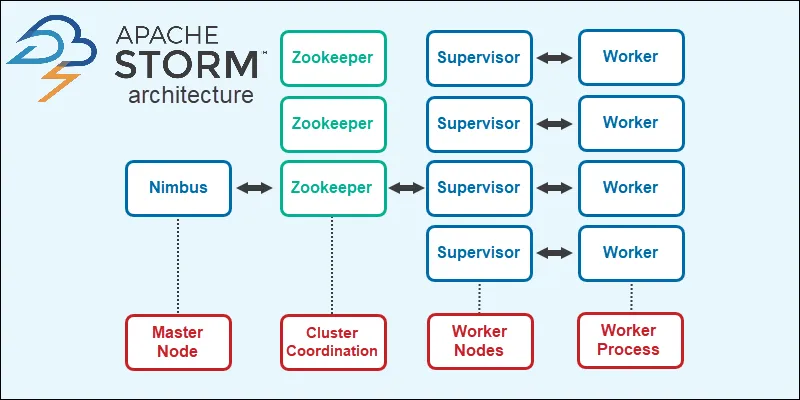
<스톰구조>
스톰 구조
스톰은 상태정보를 저장하지 않으며 님버스와 수퍼바이저가 상태정보를 주키퍼에 저장한다. 님버스가 스톰 어플리케이션의 실행 요청을 받으면 주키퍼로부터 가용한 자원을 요구하고 나서, 사용할 수 있는 수퍼바이저에게 작업 스케줄을 준다. 또한 주키퍼에 진행 상황에 대한 메타데이터를 저장하고, 장애가 발생하여 님버스가 재시작되면 어디서 부터 재시작할 수 있는지 알 수 있다.
Strom의 개념
-
스파우트(SPout) : 외부소스 시스템에서 데이터 스트림(Tuple)을 읽고 나중에 처리하기 위해 토폴로지(Topology)에 전달하는데 사용된다. 스파우트는 신뢰할 수 있거나 아닐 수도 있다.
- 신뢰할 수 있는 스파우트 : 실행 중에 장애가 발생할 경우 데이터의 재연이 가능. 이런 경우 스파우트는 이후 과정의 처리를 위해 내보내는 이벤트마다 ACK를 기다린다. 더 많은 시간이 소요되지만, 단 한 개의 레코드 손실 없이 관리를 원하는 프로그램들에게는 도움이 된다.
- 신뢰할 수 없는 스파우트 : 이벤트의 장애 발생 시 다시 이벤트를 내보내는 데에 신경쓰지 않는다. 100~200개의 레코드가 손실되는 것이 별 다른 의미가 없는 경우에 유용하게 사용할 수 있다.
-
볼트(Bolt) : 토폴로지의 모든 처리 작업이나, 레코드 처리를 Bolt에서 수행하는 것이며, 스파우트가 보낸 스트림 스톰 볼트가 수신하고, 처리가 끝나면 해당 레코드는 볼트를 통해 데이터베이스, 파일 또는 저장소 시스템에 저장될 수 있다.
-
토폴로지(Topology) : 애플리케이션의 전체적인 흐름으로 프로그램 내에 스톰 토폴로지를 생성하고 스톰 클러스터에 등록한다. Batch job과는 달리 지속적인 동작을 한다. 토폴로지에 정의된 각 객체는 하나의 처리 로직을 포함하며 데이터를 읽어올 스트림을 정의할 수 있고 읽어들인 스트림을 처리할 처리 로직을 포함할 수 있다(Hadoop의 MR(Mapreduce)작업에 대응하는 컴포넌트)
-
스트림(Stream) : Storm에서는 일련의 튜플(Tuple)의 흐름을 스트림으로 정의하고 있는데, 이 스트림을 분산 환경에서 신뢰성있게 다른 스트림으로 전환 할 수 있는 기능을 제공한다. 튜플은 기본 데이터 타입(Primitive Data)이나 바이트 배열(Byte Array)을 포함할 수 있고 사용자 타입을 정의할 수도 있다.
[스톰 토폴로지 개념도]
[스톰 토폴로지 개념도] - 한 개의 스파우트가 한 번에 여러 볼트에게 데이터를 보낼 수 있고, 모든 볼트에 대한 ACK를 주적할 수 있다.

참조
https://phoenixnap.com/kb/apache-storm
http://courspick.blogspot.com/2015/06/apache-storm-storm.html
토폴로지가 실제로 움직이는 방식
웹 클릭 이벤트를 예로 들면 Spout가 메시지 브로커에서 이벤트를 읽어 튜플로 내보내고, 첫 Bolt는 형식을 검사하며, 다음 Bolt는 페이지별 클릭 수를 집계한다. Topology는 이 구성 요소와 연결을 선언한 그래프다. Worker는 JVM 프로세스이고 그 안에서 Spout/Bolt의 task들이 실행된다. Nimbus는 작업을 배치하고 Supervisor는 각 노드의 worker 실행을 관리한다. 한 종류의 Bolt를 여러 task로 병렬 실행하더라도 어떤 튜플을 어느 task로 보낼지를 stream grouping으로 정해야 결과가 올바르다.
flowchart LR
  B[메시지 브로커] --> S[Spout: 튜플 생성]
  S --> V[Bolt: 입력 검증]
  V -->|pageId로 묶기| A[Bolt: 페이지별 집계]
  A --> D[결과 저장소]
  V -->|실패 이벤트| E[오류 경로]
shuffleGrouping은 튜플을 여러 task에 분산한다. fieldsGrouping("pageId")는 같은 페이지 ID의 튜플을 같은 집계 task로 보내는 데 사용한다. 이렇게 키 기준으로 묶지 않으면 각 task가 따로 센 값을 다시 합쳐야 한다. allGrouping은 모든 task에 복제하므로 집계에 무심코 쓰면 중복 계산이 된다. 그룹 방식은 속도만이 아니라 결과의 뜻을 결정한다.
ACK와 재처리
신뢰 가능한 Spout는 튜플을 내보낸 뒤 downstream Bolt들이 처리 완료를 알리는지 추적한다. Bolt에서 새 튜플을 만들 때 원본 튜플과 관계를 연결(anchor)하고 처리가 끝나면 ack한다. 처리 중 예외·timeout이 나면 원본 튜플이 다시 재생될 수 있다. 이를 “절대 한 번만 실행”으로 이해하면 안 된다. DB에 count = count + 1을 기록한 직후 ACK 전에 worker가 죽으면 같은 이벤트를 다시 처리할 수 있다. 이벤트 ID에 고유 제약을 두거나 멱등 갱신 방식으로 중복을 제어한다.
| 증상 | 먼저 확인 |
|---|---|
| 결과가 비어 있음 | Spout 입력 연결, Bolt의 구독 grouping, 튜플 형식 |
| 처리 지연 상승 | 입력률 대비 task 병렬 수, 느린 Bolt, 역압력 |
| 중복 결과 | ACK/timeout 뒤 재생과 외부 저장소의 멱등성 |
| 노드 장애 후 상태 손실 | stateful Bolt의 체크포인트와 복구 설정 |
원문의 “Storm은 상태를 저장하지 않는다”는 설명은 일반적인 Bolt가 자동으로 영속 상태를 갖지 않는다는 취지로 좁혀야 한다. 상태 있는 Bolt와 체크포인트 기능은 별도로 존재한다. 또한 Storm 클러스터가 조정 메타데이터를 저장하는 것과 애플리케이션의 집계 상태를 저장하는 것은 다르다. 운영에서는 ZooKeeper나 다른 조정 구성의 버전 지원, 배포 모드, 작업자 수와 저장소 복구 방식까지 확인한다.
참고: Apache Storm Concepts, 상태 관리, 메시지 처리 보장.
이어서 읽을 글
kafka에 Storm 연결하기
KafkaSpout에서 Bolt로 메시지가 전달되는 과정을 따라가며, 커넥터 설정과 오프셋·재처리·중복 처리 문제를 살펴본다.
[Kafka] 6. kafka Stream
Kafka Streams의 스트림 처리 개념을 익히고, Pipe와 WordCount 예제로 토픽 간 전달과 단어 집계의 차이를 확인한다.
Spring AI
Spring AI의 ChatModel·ChatClient·Prompt·Advisor가 요청을 처리하는 흐름과 Kotlin API, 스트리밍, 운영 시 검증 기준을 살펴본다.
4. Agentic Engineering(에이전틱 엔지니어링) — AI 에이전트를 설계하고 조율하는 기술
에이전트의 목표·상태·도구·종료 조건을 설계하고, 권한과 재시도 경계를 둔 뒤 단일·멀티 에이전트 구조를 평가하는 방법.