목차
Kafka Streams
kafka streams는 입출력 데이터가 카프카 클러스터에 kafka에 저장된 데이터를 처리하고 분석하기 위해 개발된 클라이언트 라이브러리다. Kafka Streams는 클라이언트에서 쓰기가 간편하고, 자바와 스칼라 어플리케이션을 표준으로 작성하고 배포하고, Kafka 서버-사이드 클러스터 기술의 이점을 결합하여 응용프로그램의 확장성과, 탄력성, 내결함성, 분산성등을 향상시킨다. 또한 이벤트 시간과 처리 시간을 분리하여 다루며, 다양한 옵션을 지원하여 실시간 분석을 간단하고 효율적으로 지원한다.
kafka streams를 설명하기 전 몇 가지 개념 정리
-
Stream(스트림) : 연속적으로 업데이트되고 무제한으로 진행되는 과정을 의미한다. (무제한은 크기 제한이 없다는 뜻이다.)
-
Stream Processing Application(스트림 처리 어플리케이션) : Kafka stream library를 사용하는 프로그램을 말한다.
-
Processor Topology(프로세서 토폴로지) : 스트림 처리 애플리케이션이 수행할 데이터 처리에 대한 연산 로직을 정의하는 토폴로지다. 토폴로지는 스트림과 연결된 스트림 프로세서의 그래프이다.
- 두 가지 구현방법
- low-level 프로세서 API를 통하는 방법
- kafka Stream DSL을 통하는 방법
- 두 가지 구현방법
-
Stream Processor(스트림 프로세서) : 프로세서 토폴로지에 있는 노드로 토폴로지 안에서 처리 과정을 나타내고, 스트림 데이터를 변환하는데 사용. 표준작업, 필터, 조인, 맵, 데이터 종합 등은 kafka stream에서 활용하는 스트림 프로세서 사례다.
-
Windowing(윈도잉) : 데이터 레코드를 시간단위로 보기 위해 스트림 프로세서가 시간 단위 묶음으로 나눈다. 주로 데이터 취합이나 조인할 때 필요.
-
join(조인) : 새로운 스트림을 생성하는 작업으로, 두 개 이상의 스트림이 데이터 레코드의 키를 기반으로 합쳐지면 새로운 스트림이 생성된다.
-
Aggregation(취합) : 새로운 스트림을 생성하는 작업으로, 새로운 스트림은 하나의 입력 스트림을 통해 여러 개의 입력 레코드를 조합해 단일 출력 레코드로 만들어낸다.
[Kafka Stream Architecture]
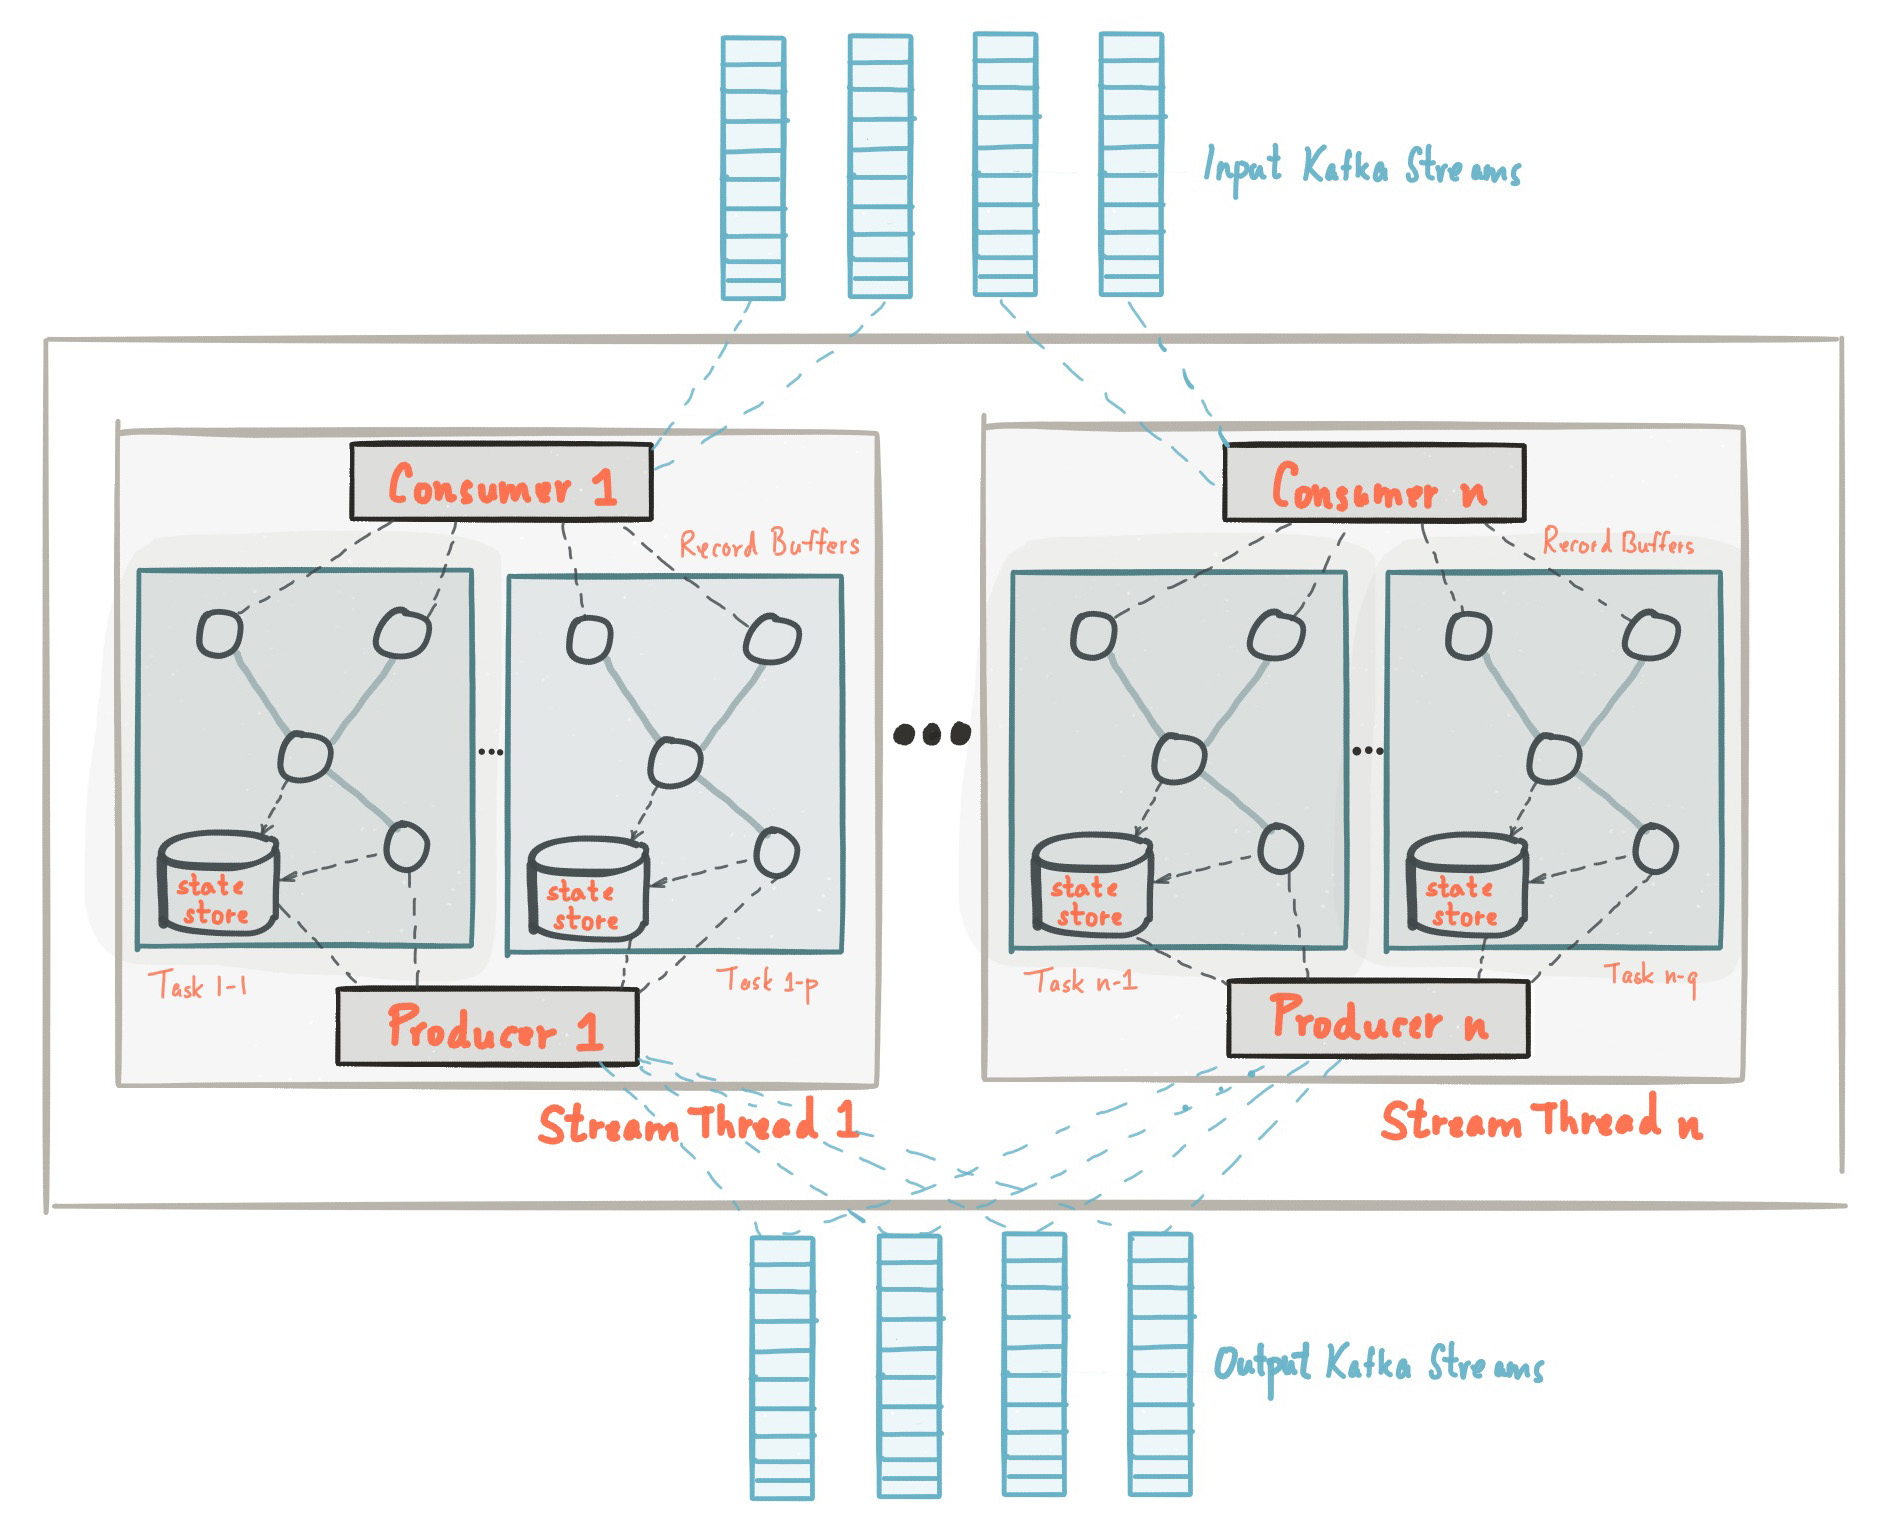
kafka streams Architecture
kafka streams 구현
- Dependency 추가
## Gradle
compile group: 'org.apache.kafka', name: 'kafka-streams', version: '2.2.1'

## Maven

<dependency>
    <groupId>org.apache.kafka</groupId>
    <artifactId>kafka-streams</artifactId>
    <version>2.2.1</version>
</dependency>
Pipe 스트림 어플리케이션
- streams-plaintext-input topic의 데이터를 streams-pipe-output topic으로 전달하는 어플리케이션
- Properties 설정
Properties props = new Properties();
//kafka streams application을 유일할게 구분할 ID
props.put(StreamsConfig.APPLICATION_ID_CONFIG, "streams-pipe");
//kafka application에 접근할 broker 정보
props.put(StreamsConfig.BOOTSTRAP_SERVERS_CONFIG, "localhost:9092");
//데이터를 어떤 형식으로 read/write할지 결정(key-value type)
props.put(StreamsConfig.DEFAULT_KEY_SERDE_CLASS_CONFIG, Serdes.String().getClass());
props.put(StreamsConfig.DEFAULT_VALUE_SERDE_CLASS_CONFIG, Serdes.String().getClass());- Stream 시작
//다른 쓰레드들에서 일련의 작업이 완료 될 때까지 대기하도록 Sync를 맞춰주는 기능
final CountDownLatch latch = new CountDownLatch(1);

//JVM이 shutdown 될때 이벤트를 가로채어 안전하게 종료 해준다.
Runtime.getRuntime().addShutdownHook(new Thread("streams-shutdown-hook") {
    @Override
    public void run() {
        streams.close();
        latch.countDown();
    }
});

try {
    //Kafka Streams 시작
    streams.start();
    System.out.println("Pipe Topology started");
    System.out.println(topology.describe());
    latch.await();
} catch (Exception e) {
    System.exit(1);
}- StreamsBuilder를 통해 topic과 topology 세팅 후 KafkaStreams 생성
//data stream으로 구성된 Topology 를 정의할 builder
final StreamsBuilder builder = new StreamsBuilder();
//input stream topic, output streams topic 설정
builder.stream("streams-plaintext-input").to("streams-pipe-output"); //topic 설정
//topology 생성
final Topology topology = builder.build();
//KafkaStreams 생성
final KafkaStreams streams = new KafkaStreams(topology, props);-
Stream 시작
-
완성코드
[Pipe.java]
import org.apache.kafka.common.serialization.Serdes;
import org.apache.kafka.streams.KafkaStreams;
import org.apache.kafka.streams.StreamsBuilder;
import org.apache.kafka.streams.StreamsConfig;
import org.apache.kafka.streams.Topology;

import java.util.Properties;
import java.util.concurrent.CountDownLatch;

public class Pipe {
    public static void pipeStart() {
        Properties props = new Properties();
        props.put(StreamsConfig.APPLICATION_ID_CONFIG, "streams-pipe"); //kafka streams application을 유일할게 구분할 ID
        props.put(StreamsConfig.BOOTSTRAP_SERVERS_CONFIG, "localhost:9092"); //kafka application에 접근할 broker 정보
        //데이터를 어떤 형식으로 read/write할지 결정(key-value type)
        props.put(StreamsConfig.DEFAULT_KEY_SERDE_CLASS_CONFIG, Serdes.String().getClass());
        props.put(StreamsConfig.DEFAULT_VALUE_SERDE_CLASS_CONFIG, Serdes.String().getClass());


        //data stream으로 구성된 Topology 를 정의할 builder
        final StreamsBuilder builder = new StreamsBuilder();
        //input stream topic, output streams topic 설정
        builder.stream("streams-plaintext-input").to("streams-pipe-output"); //topic 설정

        final Topology topology = builder.build();

        final KafkaStreams streams = new KafkaStreams(topology, props);

        final CountDownLatch latch = new CountDownLatch(1);

        Runtime.getRuntime().addShutdownHook(new Thread("streams-shutdown-hook") {
            @Override
            public void run() {
                streams.close();
                latch.countDown();
            }
        });

        try {
            streams.start();
            System.out.println("Pipe Topology started");
            System.out.println(topology.describe());
            latch.await();
        } catch (Exception e) {
            System.exit(1);
        }
    }
}
[Main.java]
public class Main {
    public static void main(String[] args) {
        Pipe.pipeStart();
    }
}
LineSplit 애플리케이션
- LineSplit은 한 문장의 단어를 쪼개어 streams-linesplit-output topic에 데이터가 쌓이도록 하는 애플리케이션이다.
flatMapValues 는 key-value 형식으로 리스트의 각 요소를 스트링으로 flat하는 메소드다. 그래서 데이터를 나누는작업으로 문장을 단어별로 쪼개어 Array에 담고 stremas-linesplit-output topic에 데이터를 담도록 처리해준다.
KStream<String, String> source = builder.stream("streams-plaintext-input");
 // \W+ 한개 이상의 알파벳 또는 숫자를 분리
source.flatMapValues(value -> Arrays.asList(value.split("\\W+"))).to("streams-linesplit-output");
[LineSplit.java]
import org.apache.kafka.common.serialization.Serdes;
import org.apache.kafka.streams.KafkaStreams;
import org.apache.kafka.streams.StreamsBuilder;
import org.apache.kafka.streams.StreamsConfig;
import org.apache.kafka.streams.Topology;
import org.apache.kafka.streams.kstream.KStream;

import java.util.Arrays;
import java.util.Properties;
import java.util.concurrent.CountDownLatch;

public class LineSplit {
    public static void lineSplitStart() {
        Properties props = new Properties();
        props.put(StreamsConfig.APPLICATION_ID_CONFIG, "streams-linesplit");
        props.put(StreamsConfig.BOOTSTRAP_SERVERS_CONFIG, "localhost:9092"); //kafka application에 접근할 broker 정보
        //데이터를 어떤 형식으로 read/write할지 결정(key-value type)
        props.put(StreamsConfig.DEFAULT_KEY_SERDE_CLASS_CONFIG, Serdes.String().getClass());
        props.put(StreamsConfig.DEFAULT_VALUE_SERDE_CLASS_CONFIG, Serdes.String().getClass());

        final StreamsBuilder builder = new StreamsBuilder();
        KStream<String, String> source = builder.stream("streams-plaintext-input");
        source.flatMapValues(value -> Arrays.asList(value.split("\\W+"))) // \W+ 한개 이상의 알파벳 또는 숫자를 분리
                .to("streams-linesplit-output");

        final Topology topology = builder.build();
        final KafkaStreams streams = new KafkaStreams(topology, props);
        final CountDownLatch latch = new CountDownLatch(1);

        Runtime.getRuntime().addShutdownHook(new Thread("streams-shutdown-hook") {
            @Override
            public void run() {
                streams.close();
                latch.countDown();
            }
        });

        try {
            streams.start();
            System.out.println("LineSplit Topology started");
            System.out.println(topology.describe());
            latch.await();
        } catch (Exception e) {
            System.exit(1);
        }

    }
}
[Main.java]
public class Main {
    public static void main(String[] args) {
        LineSplit.lineSplitStart();
    }
}
WordCount 애플리케이션
-
groupBy() : 그룹핑해서 동일 단어별로 묶어준다.
-
count() : 키값으로 몇개의 요소가 있는지 체크하는 function.으로 데이터를 Store(KeyValueStore<Bytes,byte[]> counts-store)에 담고 변경이 있는 KTable에 대해서만 결과값을 리턴
KStream<String, String> source = builder.stream("streams-plaintext-input");
source.flatMapValues(value -> Arrays.asList(value.toLowerCase(Locale.getDefault()).split("\\W+")))
        .groupBy((key, value) -> value)
        //count() : 키값으로 몇개의 요소가 있는지 체크하는 function.으로
        //데이터를 Store(KeyValueStore<Bytes,byte[]> counts-store)에 담고 변경이 있는 KTable에 대해서만 결과값을 리턴
        .count(Materialized.<String, Long, KeyValueStore<Bytes, byte[]>>as("counts-store"))
        .toStream()
        .to("streams-wordcount-output", Produced.with(Serdes.String(), Serdes.Long()));
[WordCount.java]
import org.apache.kafka.common.serialization.Serdes;
import org.apache.kafka.common.utils.Bytes;
import org.apache.kafka.streams.KafkaStreams;
import org.apache.kafka.streams.StreamsBuilder;
import org.apache.kafka.streams.StreamsConfig;
import org.apache.kafka.streams.Topology;
import org.apache.kafka.streams.kstream.KStream;
import org.apache.kafka.streams.kstream.Materialized;
import org.apache.kafka.streams.kstream.Produced;
import org.apache.kafka.streams.state.KeyValueStore;

import java.util.Arrays;
import java.util.Locale;
import java.util.Properties;
import java.util.concurrent.CountDownLatch;

public class WordCount {
    public static void wordCountStart() {
        Properties props = new Properties();
        props.put(StreamsConfig.APPLICATION_ID_CONFIG, "streams-wordcount");
        props.put(StreamsConfig.BOOTSTRAP_SERVERS_CONFIG, "localhost:9092");
        props.put(StreamsConfig.DEFAULT_KEY_SERDE_CLASS_CONFIG, Serdes.String().getClass());
        props.put(StreamsConfig.DEFAULT_VALUE_SERDE_CLASS_CONFIG, Serdes.String().getClass());

        final StreamsBuilder builder = new StreamsBuilder();

        KStream<String, String> source = builder.stream("streams-plaintext-input");
        source.flatMapValues(value -> Arrays.asList(value.toLowerCase(Locale.getDefault()).split("\\W+")))
                .groupBy((key, value) -> value)
                //count() : 키값으로 몇개의 요소가 있는지 체크하는 function.으로
                //데이터를 Store(KeyValueStore<Bytes,byte[]> counts-store)에 담고 변경이 있는 KTable에 대해서만 결과값을 리턴
                .count(Materialized.<String, Long, KeyValueStore<Bytes, byte[]>>as("counts-store"))
                .toStream()
                .to("streams-wordcount-output", Produced.with(Serdes.String(), Serdes.Long()));

        final Topology topology = builder.build();
        final KafkaStreams streams = new KafkaStreams(topology, props);
        final CountDownLatch latch = new CountDownLatch(1);

        Runtime.getRuntime().addShutdownHook(new Thread("streams-shutdown-hook") {
            @Override
            public void run() {
                streams.close();
                latch.countDown();
            }
        });

        try {
            streams.start();
            System.out.println("WordCount Topology started");
            System.out.println(topology.describe());
            latch.await();
        } catch (Exception e) {
            System.exit(1);
        }
    }
}
[Main.java]
public class Main {
    public static void main(String[] args) {
        WordCount.wordCountStart();
    }
}
실행결과
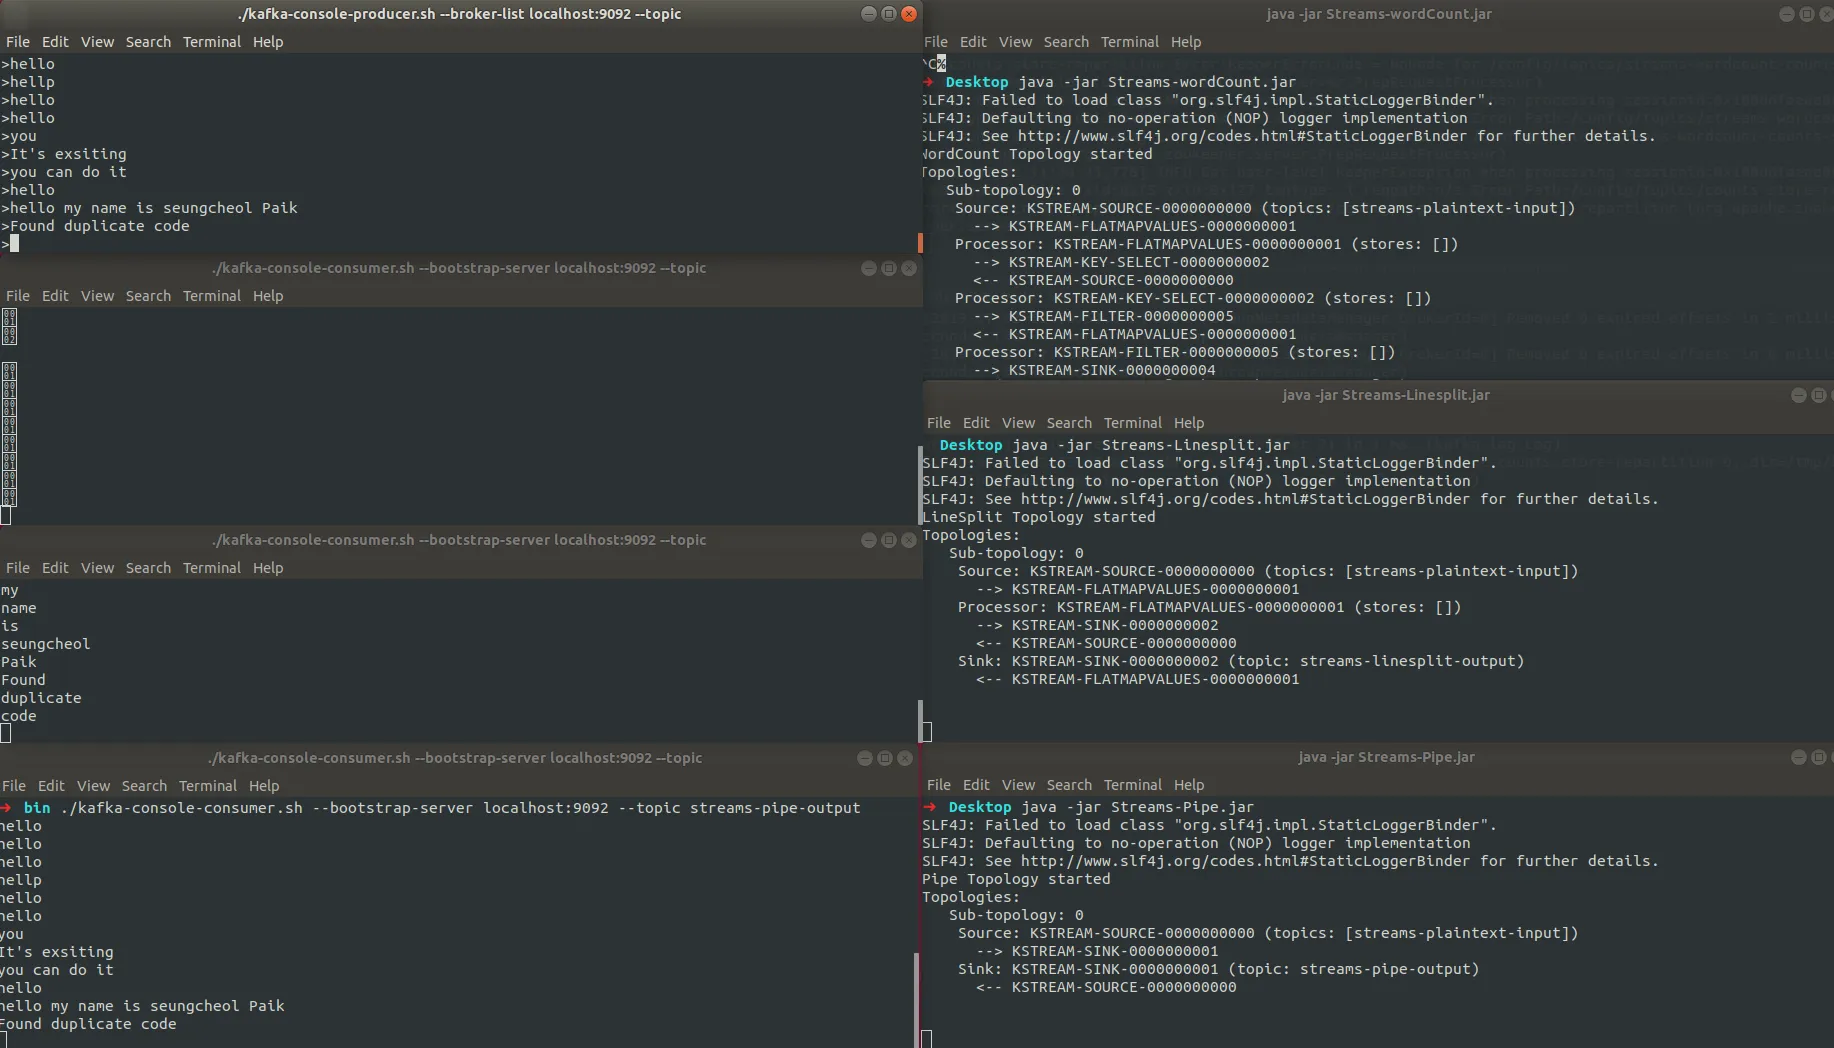
참조 : https://kafka.apache.org/23/documentation/streams/architecture
#Kafka Streams
Pipe와 WordCount의 동작 차이
원문의 Pipe는 입력 레코드를 거의 그대로 출력 토픽에 쓰는 상태 없는 처리다. 반면 WordCount는 단어별 개수를 기억해야 하는 상태 있는 처리다. 입력 "apple banana", 다음 입력 "apple"이 들어오면 단어 분리 뒤 apple의 카운트는 1에서 2로, banana는 1로 갱신된다. 출력 토픽에는 최종 스냅샷 한 건만 나오는 것이 아니라 카운트가 바뀔 때마다 갱신 레코드가 기록될 수 있다. 따라서 출력 소비자는 같은 키의 최신 값을 유지하는 방식으로 해석해야 한다.
flowchart LR
  I[입력 토픽: 문장] --> S[flatMapValues: 단어로 분리]
  S --> G[groupBy: 단어를 키로 재배치]
  G --> C[count: 상태 저장소 갱신]
  C --> O[출력 토픽: 단어별 변경 값]
groupBy((key, value) -> value)는 기존 레코드 키 대신 단어를 새 키로 사용한다. 키가 바뀌므로 Kafka Streams가 데이터 재분배를 위해 내부 repartition 토픽을 사용할 수 있다. count()의 결과는 KTable이며, toStream()은 변경 내용을 다시 스트림 레코드로 내보낸다. Materialized.as("counts-store")는 로컬 상태 저장소 이름을 지정한다. 장애 후에는 Kafka의 변경 로그와 입력을 바탕으로 상태를 복구할 수 있지만, 복구 시간과 디스크 공간이 필요하다.
결과를 재현하며 확인하기
입력 토픽과 출력 토픽을 만든 후 애플리케이션을 시작한다. 다른 터미널에서 콘솔 프로듀서로 apple banana와 apple을 보낸다. 출력 토픽은 Long Serde로 직렬화된 값이므로 단순 문자열 소비자를 쓰면 사람이 읽기 어려운 바이트로 보일 수 있다. 다음처럼 Long 역직렬화기를 지정한다.
bin/kafka-console-consumer.sh --bootstrap-server localhost:9092 \
  --topic streams-wordcount-output --from-beginning \
  --property print.key=true \
  --property value.deserializer=org.apache.kafka.common.serialization.LongDeserializer
처리 결과의 순서는 여러 파티션에서 읽는 순서와 flush 타이밍에 따라 달라질 수 있다. 같은 단어 키의 갱신을 따라가며 최종 개수가 기대한 값인지 확인한다. 애플리케이션을 재시작해도 같은 application.id이면 기존 소비 위치와 상태를 다시 사용한다. 처음부터 실험하려면 기존 실습의 토픽·상태를 의도적으로 초기화하거나 새 application.id를 쓴다. 운영 데이터에 재처리 도구를 실행하면 출력 중복이 생길 수 있으므로 범위를 검토해야 한다.
| 문제 | 확인할 항목 |
|---|---|
| 출력 토픽이 비어 있음 | 입력 토픽 이름, bootstrap.servers, 애플리케이션 로그 |
| 출력이 깨져 보임 | 출력 value의 Long Serde와 소비자 역직렬화기 |
| 재시작 뒤 예전 위치부터 시작 | 동일한 application.id의 그룹·상태 유지 여부 |
| 상태 복구가 오래 걸림 | changelog 크기, 로컬 디스크, 파티션 수 |
원문 2.2.1 API와 Gradle의 compile 선언은 당시 환경을 기록한 것이다. 새 프로젝트에서는 사용하는 Kafka 클라이언트와 빌드 도구 버전에 맞는 의존성 문법을 확인한다. Kafka Streams의 “정확히 한 번”은 설정과 Kafka 토픽 간 처리 범위에 한정된다. 외부 DB·HTTP 호출까지 자동으로 원자화하지 않으므로 외부 부작용은 중복에 견디게 설계해야 한다.
참고: Kafka Streams DSL, Kafka Streams 개요, Apache Kafka Quickstart.
같은 카테고리의 글
이어서 읽을 글
kafka에 Storm 연결하기
KafkaSpout에서 Bolt로 메시지가 전달되는 과정을 따라가며, 커넥터 설정과 오프셋·재처리·중복 처리 문제를 살펴본다.
Kafka에 Spark 스트리밍 연결
Kafka 데이터를 Spark Structured Streaming으로 읽는 흐름을 살펴보고, 오프셋·체크포인트·출력 저장소의 복구 역할을 구분한다.
Kafka REST Proxy
Confluent REST Proxy의 HTTP API로 Kafka 메시지를 보내고 구독·조회하며, 컨슈머 정리와 v2·v3의 차이를 살펴본다.
[Kafka] 8. Spring Boot를 이용한 Kafka API 구축
Spring Boot에서 Kafka 메시지를 발행·소비하는 API를 구성하고, HTTP 응답과 비동기 메시지 처리 시점의 차이를 살펴본다.