목차
트랜스포머 아키텍처
트랜스포머(Transformer)는 순환신경망(RNN)처럼 토큰을 하나씩 처리하지 않고, 한 층 안에서 여러 위치의 표현을 함께 계산한다. 이 때문에 학습 시 시퀀스의 토큰을 병렬로 처리하기 쉽다. 핵심은 현재 토큰이 다른 토큰을 얼마나 참고할지 학습하는 어텐션(Attention)이다. 원 논문은 기계 번역을 위해 인코더와 디코더를 함께 제안했다. 오늘날 LLM에는 인코더만 사용하는 모델, 디코더만 사용하는 모델, 두 부분을 함께 사용하는 모델이 모두 있다.
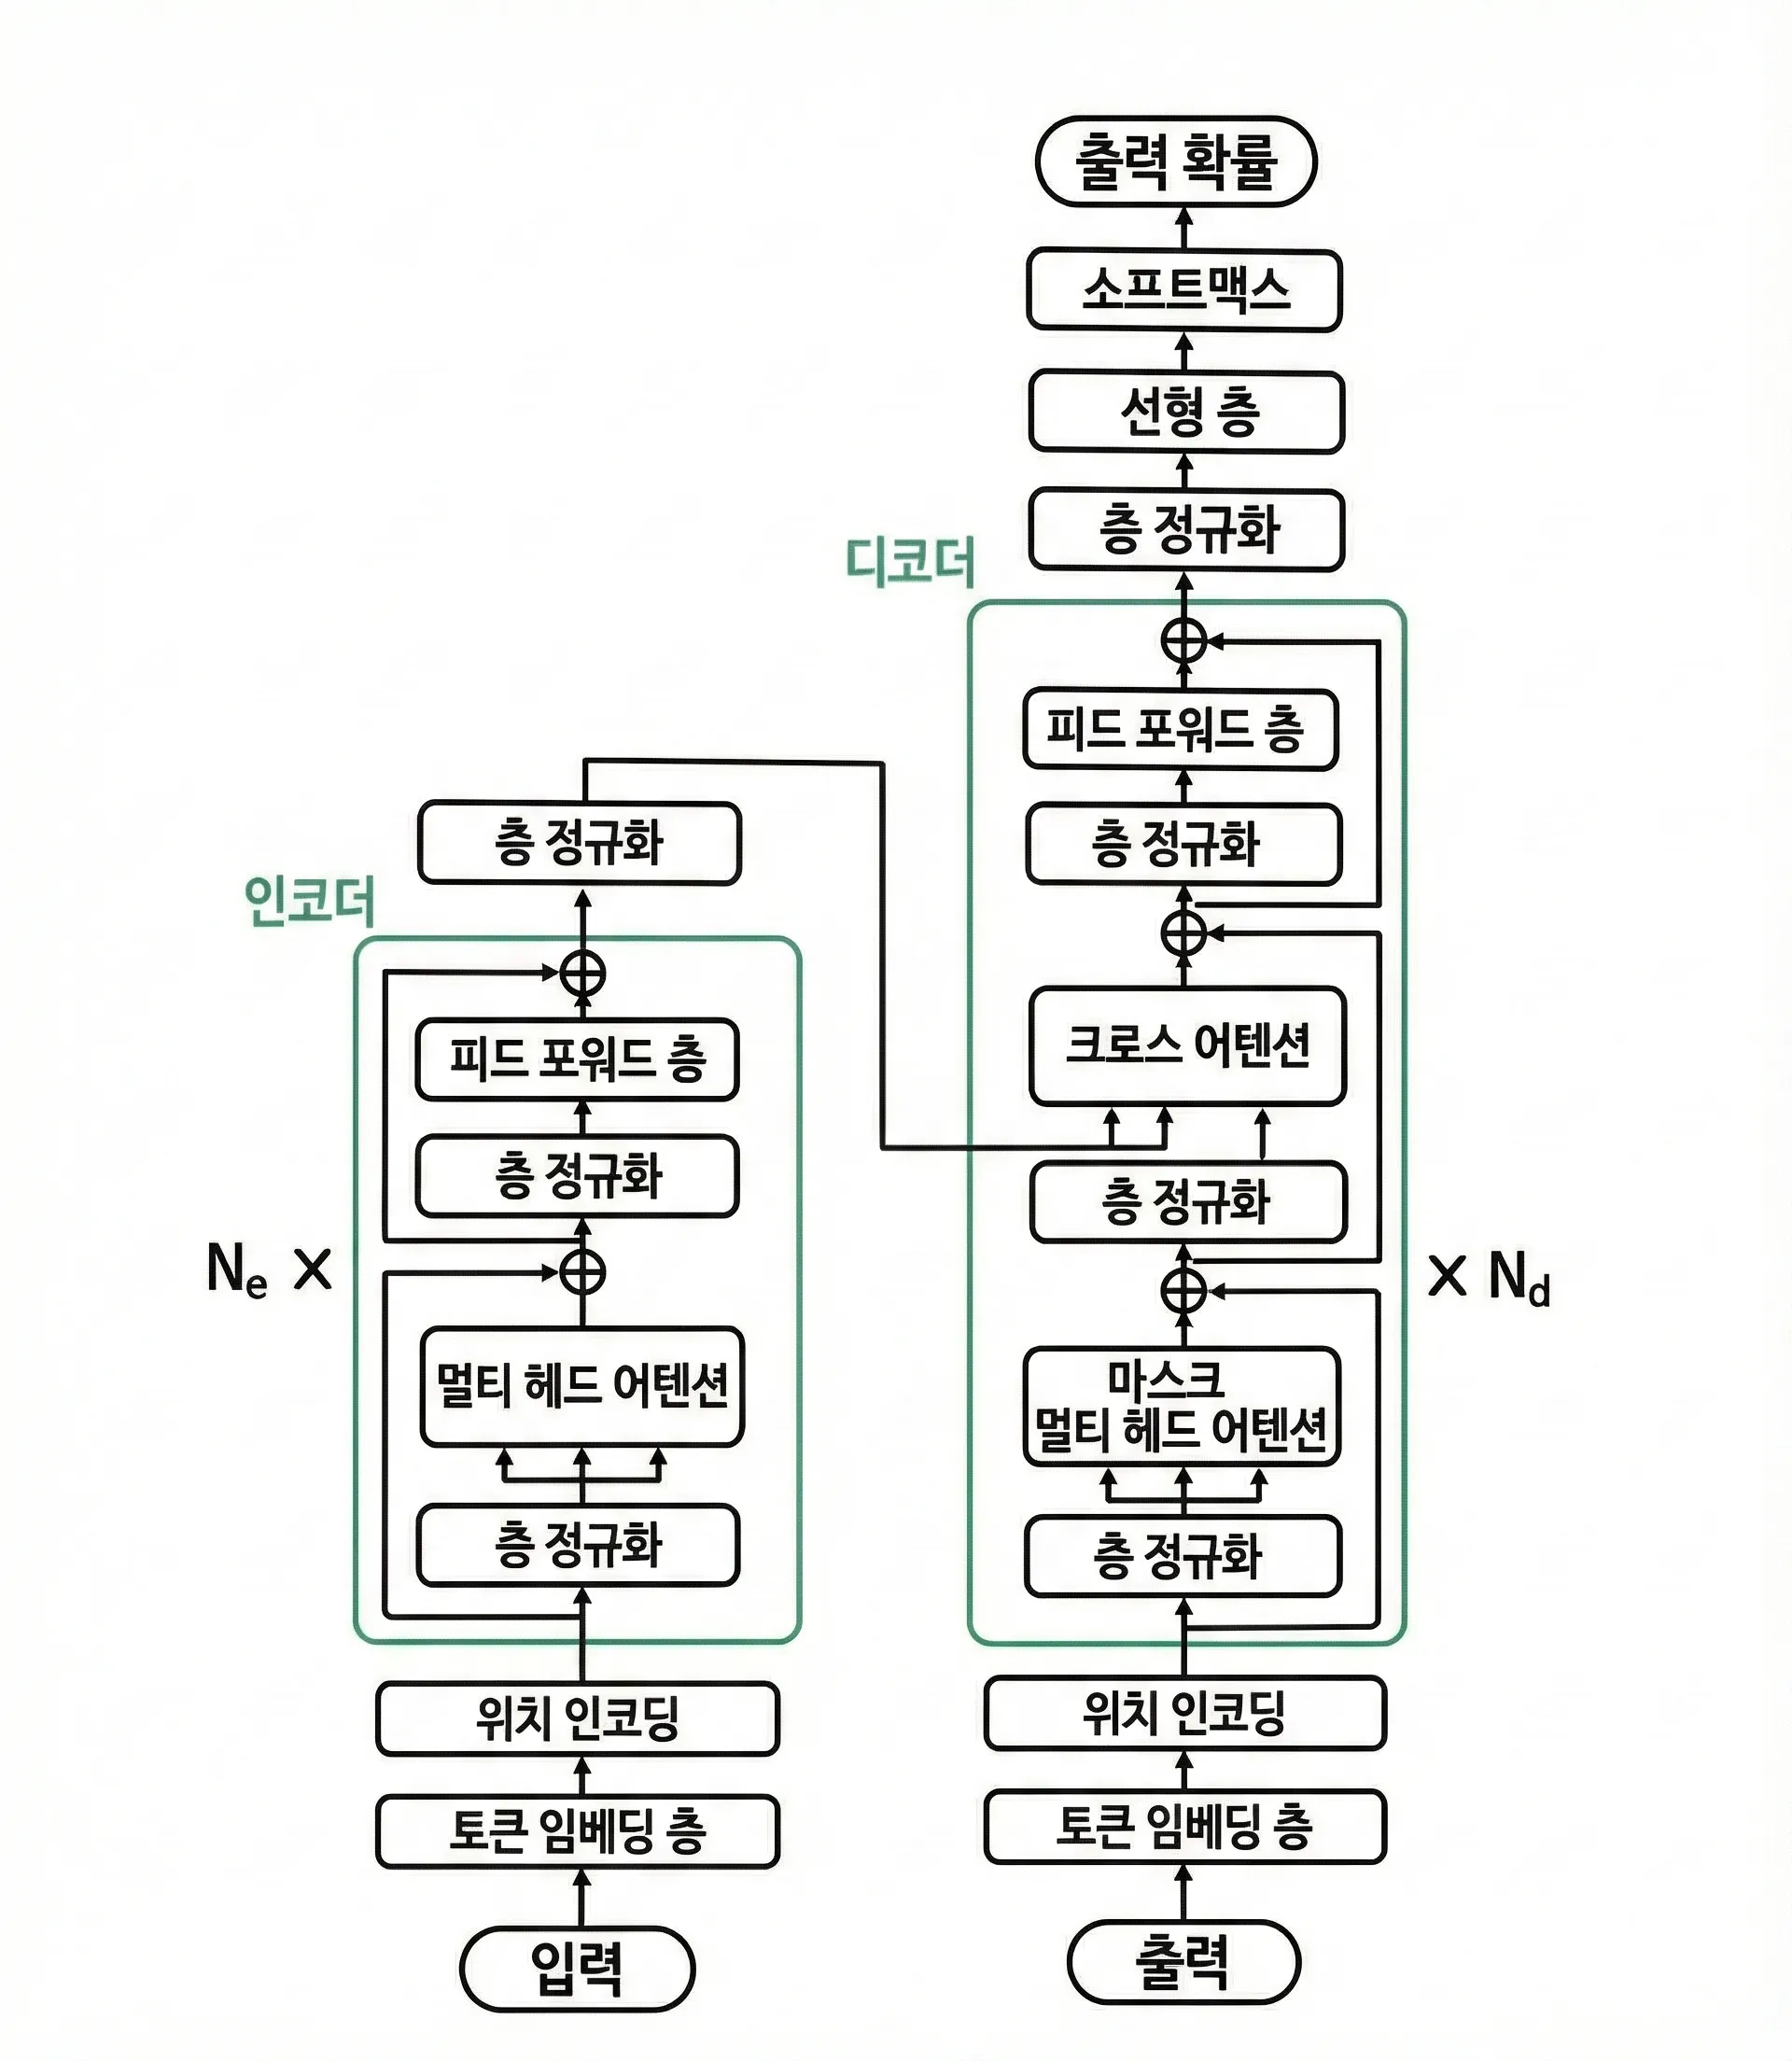
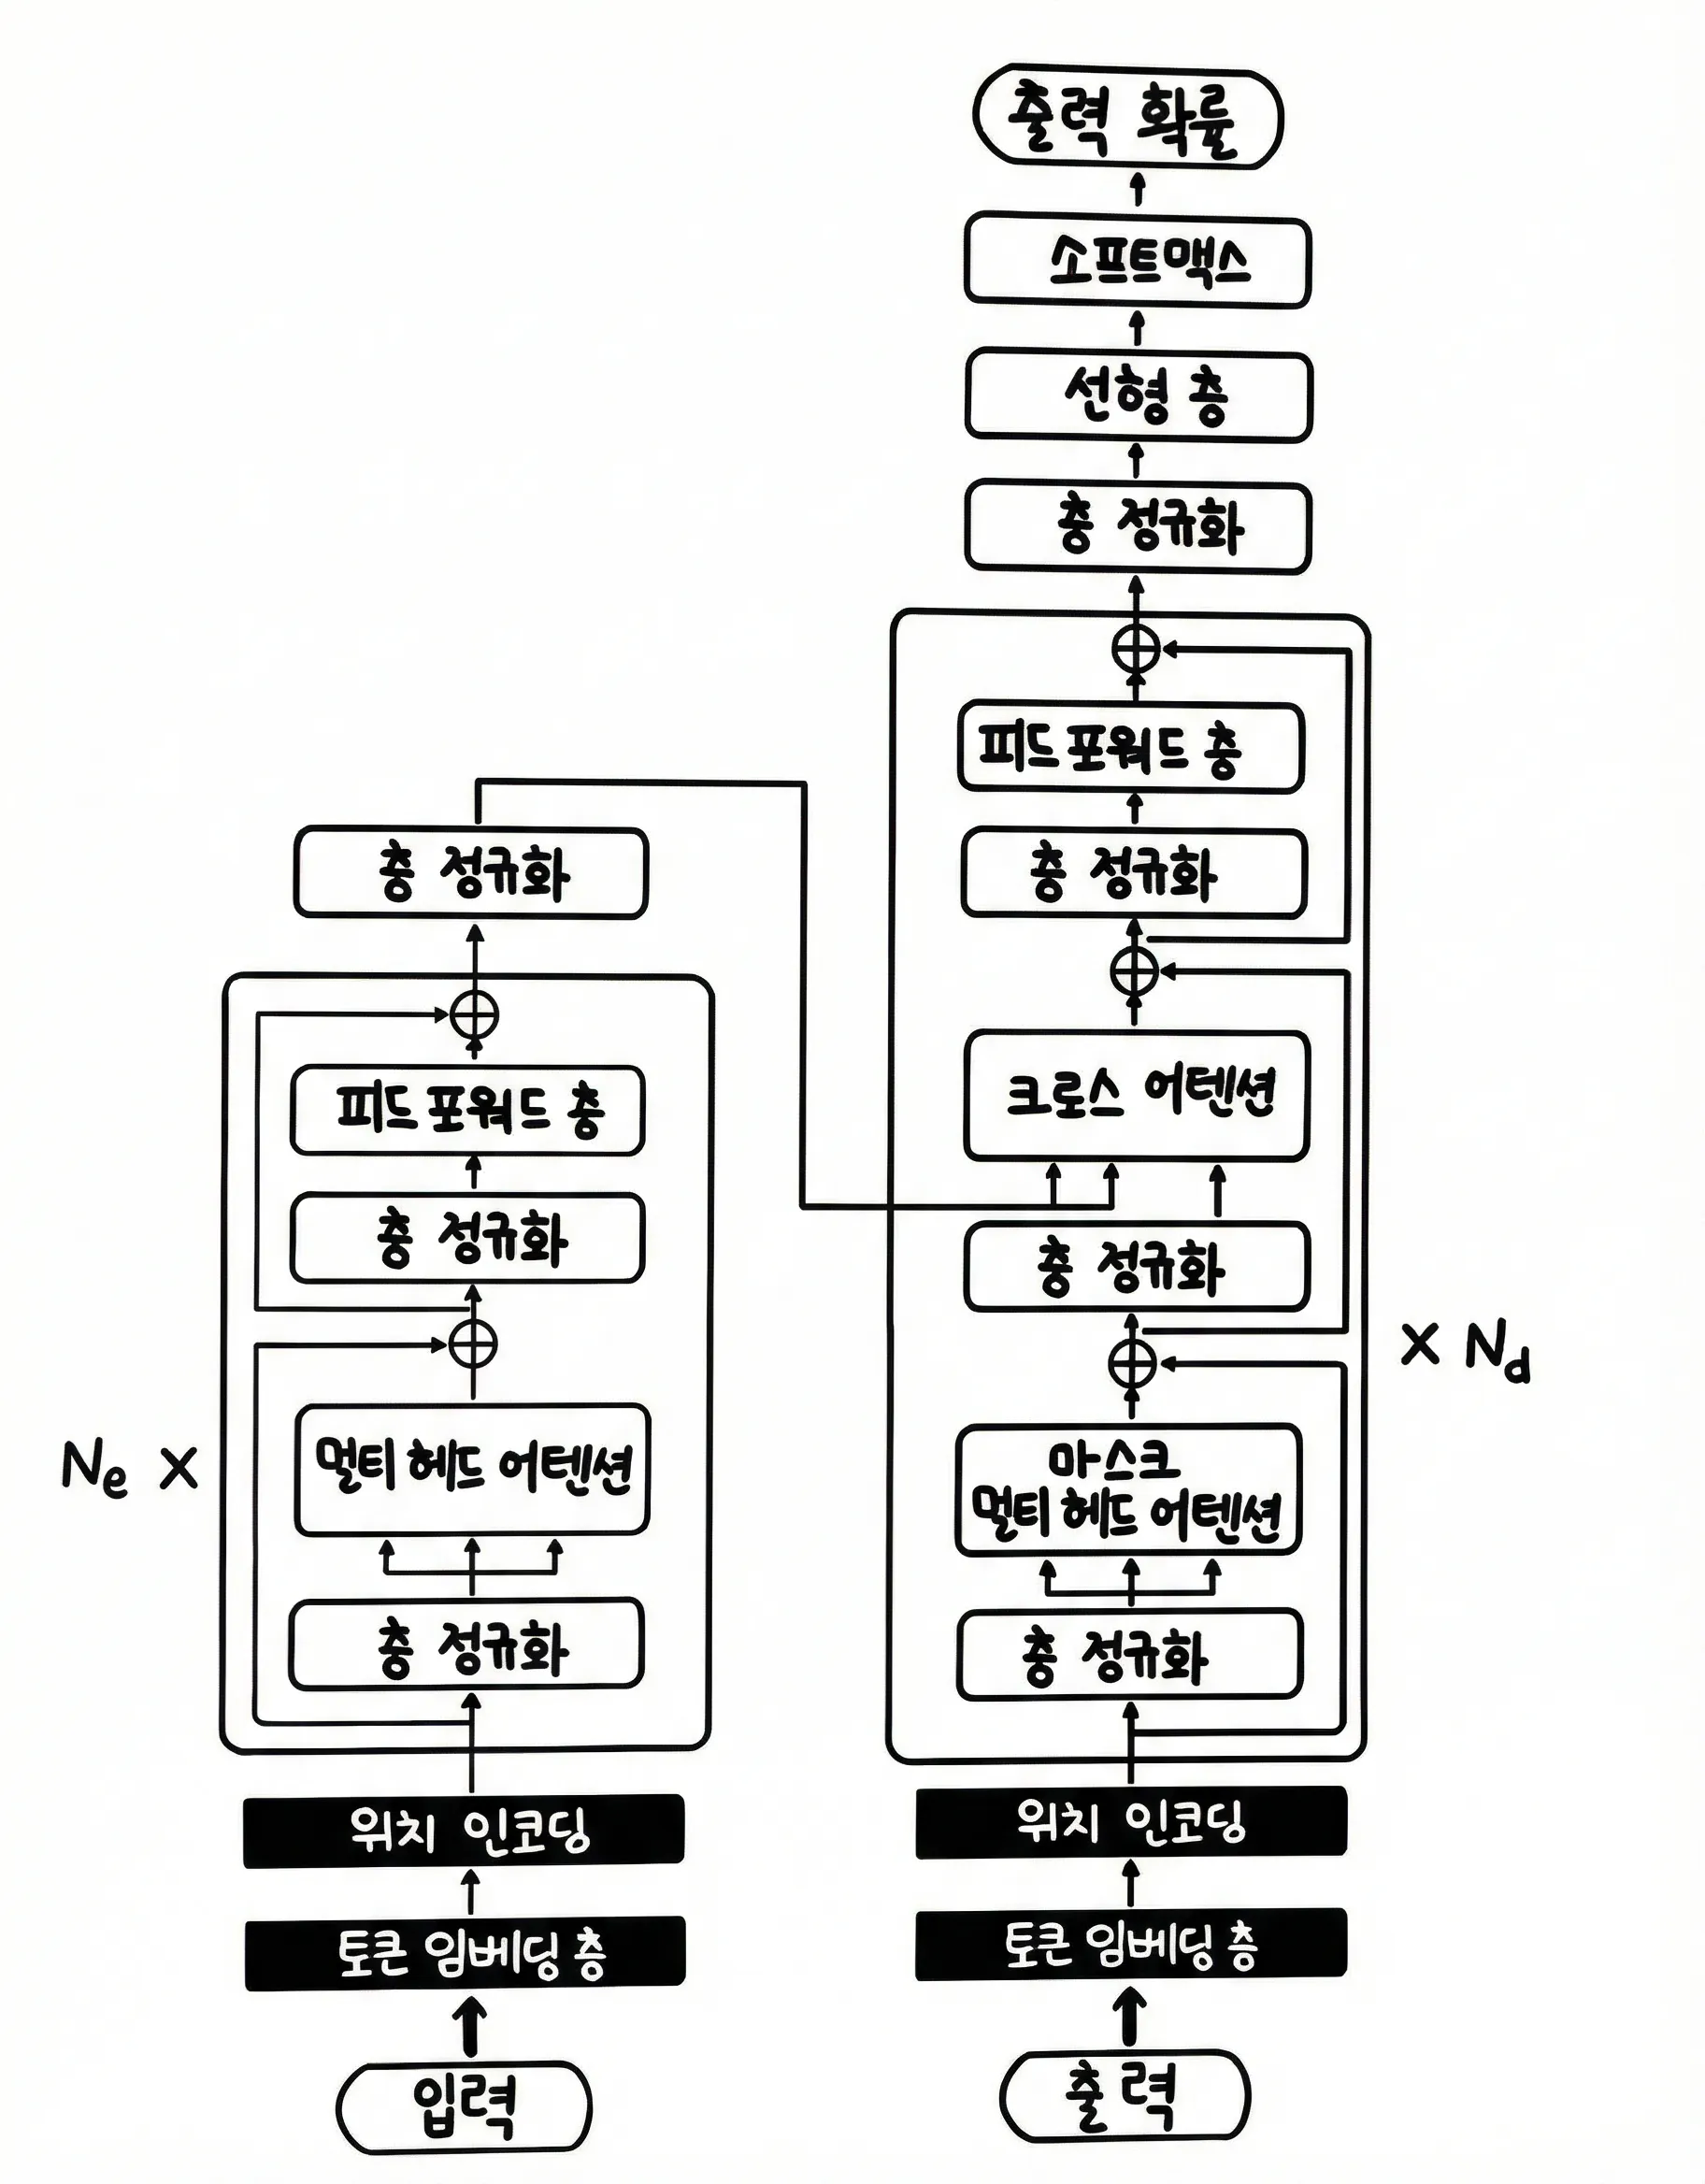
그림의 왼쪽 인코더는 입력을 문맥화한 표현으로 바꾼다. 오른쪽 디코더는 이미 생성한 출력과 인코더의 표현을 이용해 다음 토큰을 예측한다. 요즘의 생성형 LLM이 흔히 쓰는 디코더 전용 구조에는 그림의 인코더와 크로스 어텐션이 없다. 반대로 번역·요약 같은 입력에서 출력을 만드는 인코더·디코더 모델은 두 부분을 모두 쓸 수 있다. 구조를 구분해야 나중에 마스크와 캐시가 왜 필요한지 이해하기 쉽다.
트랜스포머가 긴 문맥을 자동으로 완벽하게 기억하는 것은 아니다. 표준 셀프 어텐션의 점수 행렬은 길이 에 대해 로 커진다. 위치가 멀수록 필요한 정보를 찾기 어려운 과제도 있다. 병렬 학습의 이점과 긴 입력의 메모리·품질 문제를 함께 봐야 한다.
텍스트가 벡터가 되는 과정
컴퓨터는 원문 문자열로 행렬곱을 할 수 없다. 먼저 토크나이저가 텍스트를 토큰으로 나누고 사전(vocabulary)의 정수 ID로 바꾼다. 다음으로 임베딩 표에서 각 ID에 해당하는 벡터를 찾는다. 마지막으로 위치 정보를 더하거나 어텐션 계산에 반영한다.
그림에서 문장의 각 조각은 토큰 ID, 토큰 벡터, 위치 정보 순서로 변한다. 예를 들어 나는 최근에 파리를 공백으로 나누면 4개 조각이지만, 실제 LLM의 서브워드(subword) 토크나이저는 이를 더 잘게 나눌 수 있다. 따라서 아래 공백 분리 예제는 임베딩의 텐서 모양을 보기 위한 축소 모형이다. 실제 모델을 호출할 때는 해당 모델의 토크나이저와 특별 토큰 규칙을 그대로 사용해야 한다.
단어 단위 사전은 드문 단어와 신조어에서 미등록 단어(OOV) 문제가 크다. 서브워드 방식은 자주 나타나는 문자열을 큰 조각으로, 드문 문자열을 작은 조각으로 나타내 사전 크기와 시퀀스 길이 사이를 조절한다. 다만 토큰 수가 증가하면 같은 문장도 어텐션 비용과 모델의 문맥 창을 더 많이 사용한다. 한국어 서비스에서 비용을 추정할 때 글자 수보다 실제 토크나이저의 토큰 수를 재는 이유다.
import torch
from torch import nn

tokens = "나는 최근에 파리 여행을 다녀왔다".split()
vocab = {token: index for index, token in enumerate(tokens)}
ids = torch.tensor([[vocab[token] for token in tokens]])  # [batch=1, length=5]

d_model = 16
token_embedding = nn.Embedding(len(vocab), d_model)
position_embedding = nn.Embedding(32, d_model)
positions = torch.arange(ids.size(1)).unsqueeze(0)
x = token_embedding(ids) + position_embedding(positions)
print(ids.shape, x.shape)
# torch.Size([1, 5]) torch.Size([1, 5, 16])nn.Embedding은 ID로 행을 조회하는 학습 가능한 표다. 위 예제의 벡터는 무작위 초기화 상태이므로 단어의 의미를 담았다고 해석하면 안 된다. 학습 중 손실을 줄이면서 값이 바뀐다. positions는 0~4이고 같은 크기의 위치 벡터가 각 토큰 벡터에 더해진다. 32는 이 예제가 허용하는 최대 위치 수이므로 입력이 길어지면 위치 표의 범위를 늘려야 한다.
위치를 표현하는 다른 방식
원 논문은 사인·코사인 함수로 절대 위치를 표현했다. 위 코드는 이해를 돕기 위해 학습 가능한 절대 위치 임베딩을 썼다. 두 방식 모두 위치 정보를 제공하지만 같은 방식은 아니다. 상대 위치와 회전 위치 임베딩(RoPE)을 쓰는 모델도 있다. 상대 위치 방식은 두 토큰의 거리나 위치 관계를 어텐션 계산에 반영한다. 어떤 방식이든 학습 때 보지 못한 길이까지 품질이 유지된다고 보장하지 않는다.
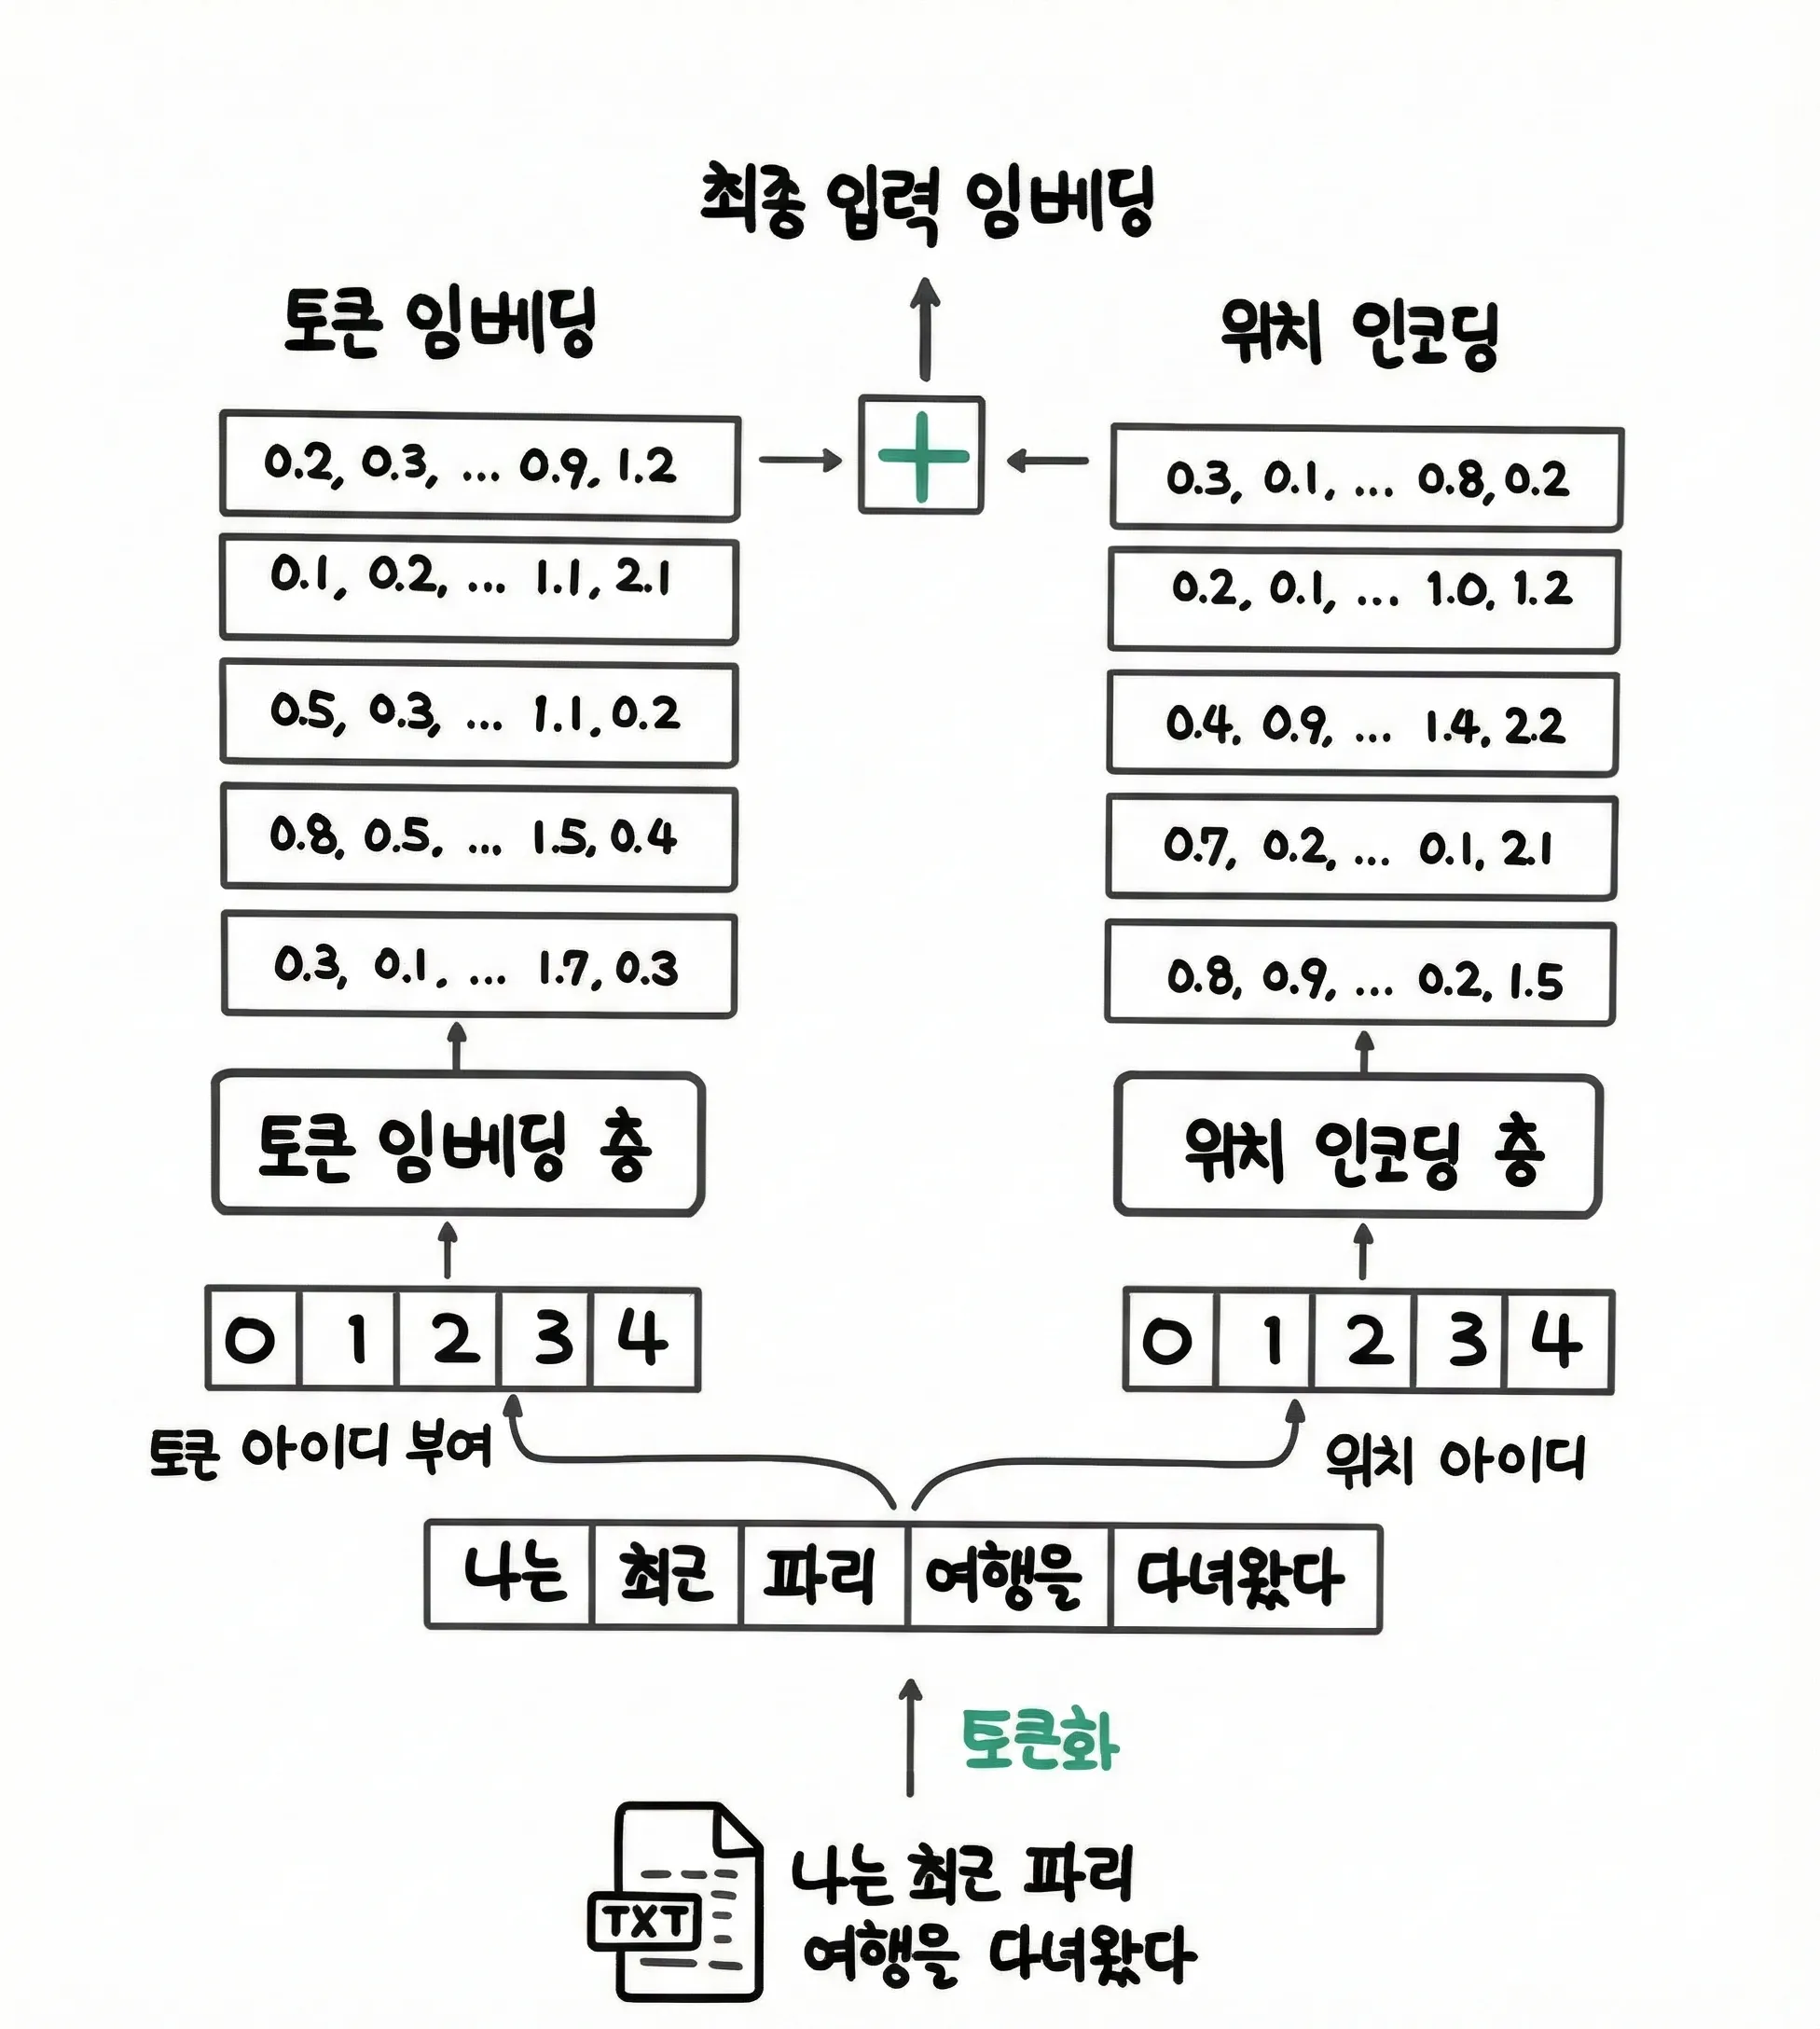
그림처럼 토큰 벡터에 위치 표현을 더하면 같은 토큰이 서로 다른 위치에 있을 때 입력 벡터가 달라진다. 위치가 없다면 토큰 집합을 뒤섞어도 셀프 어텐션만으로는 순서를 구별하기 어렵다.
셀프 어텐션: 어디를 참고할지 계산
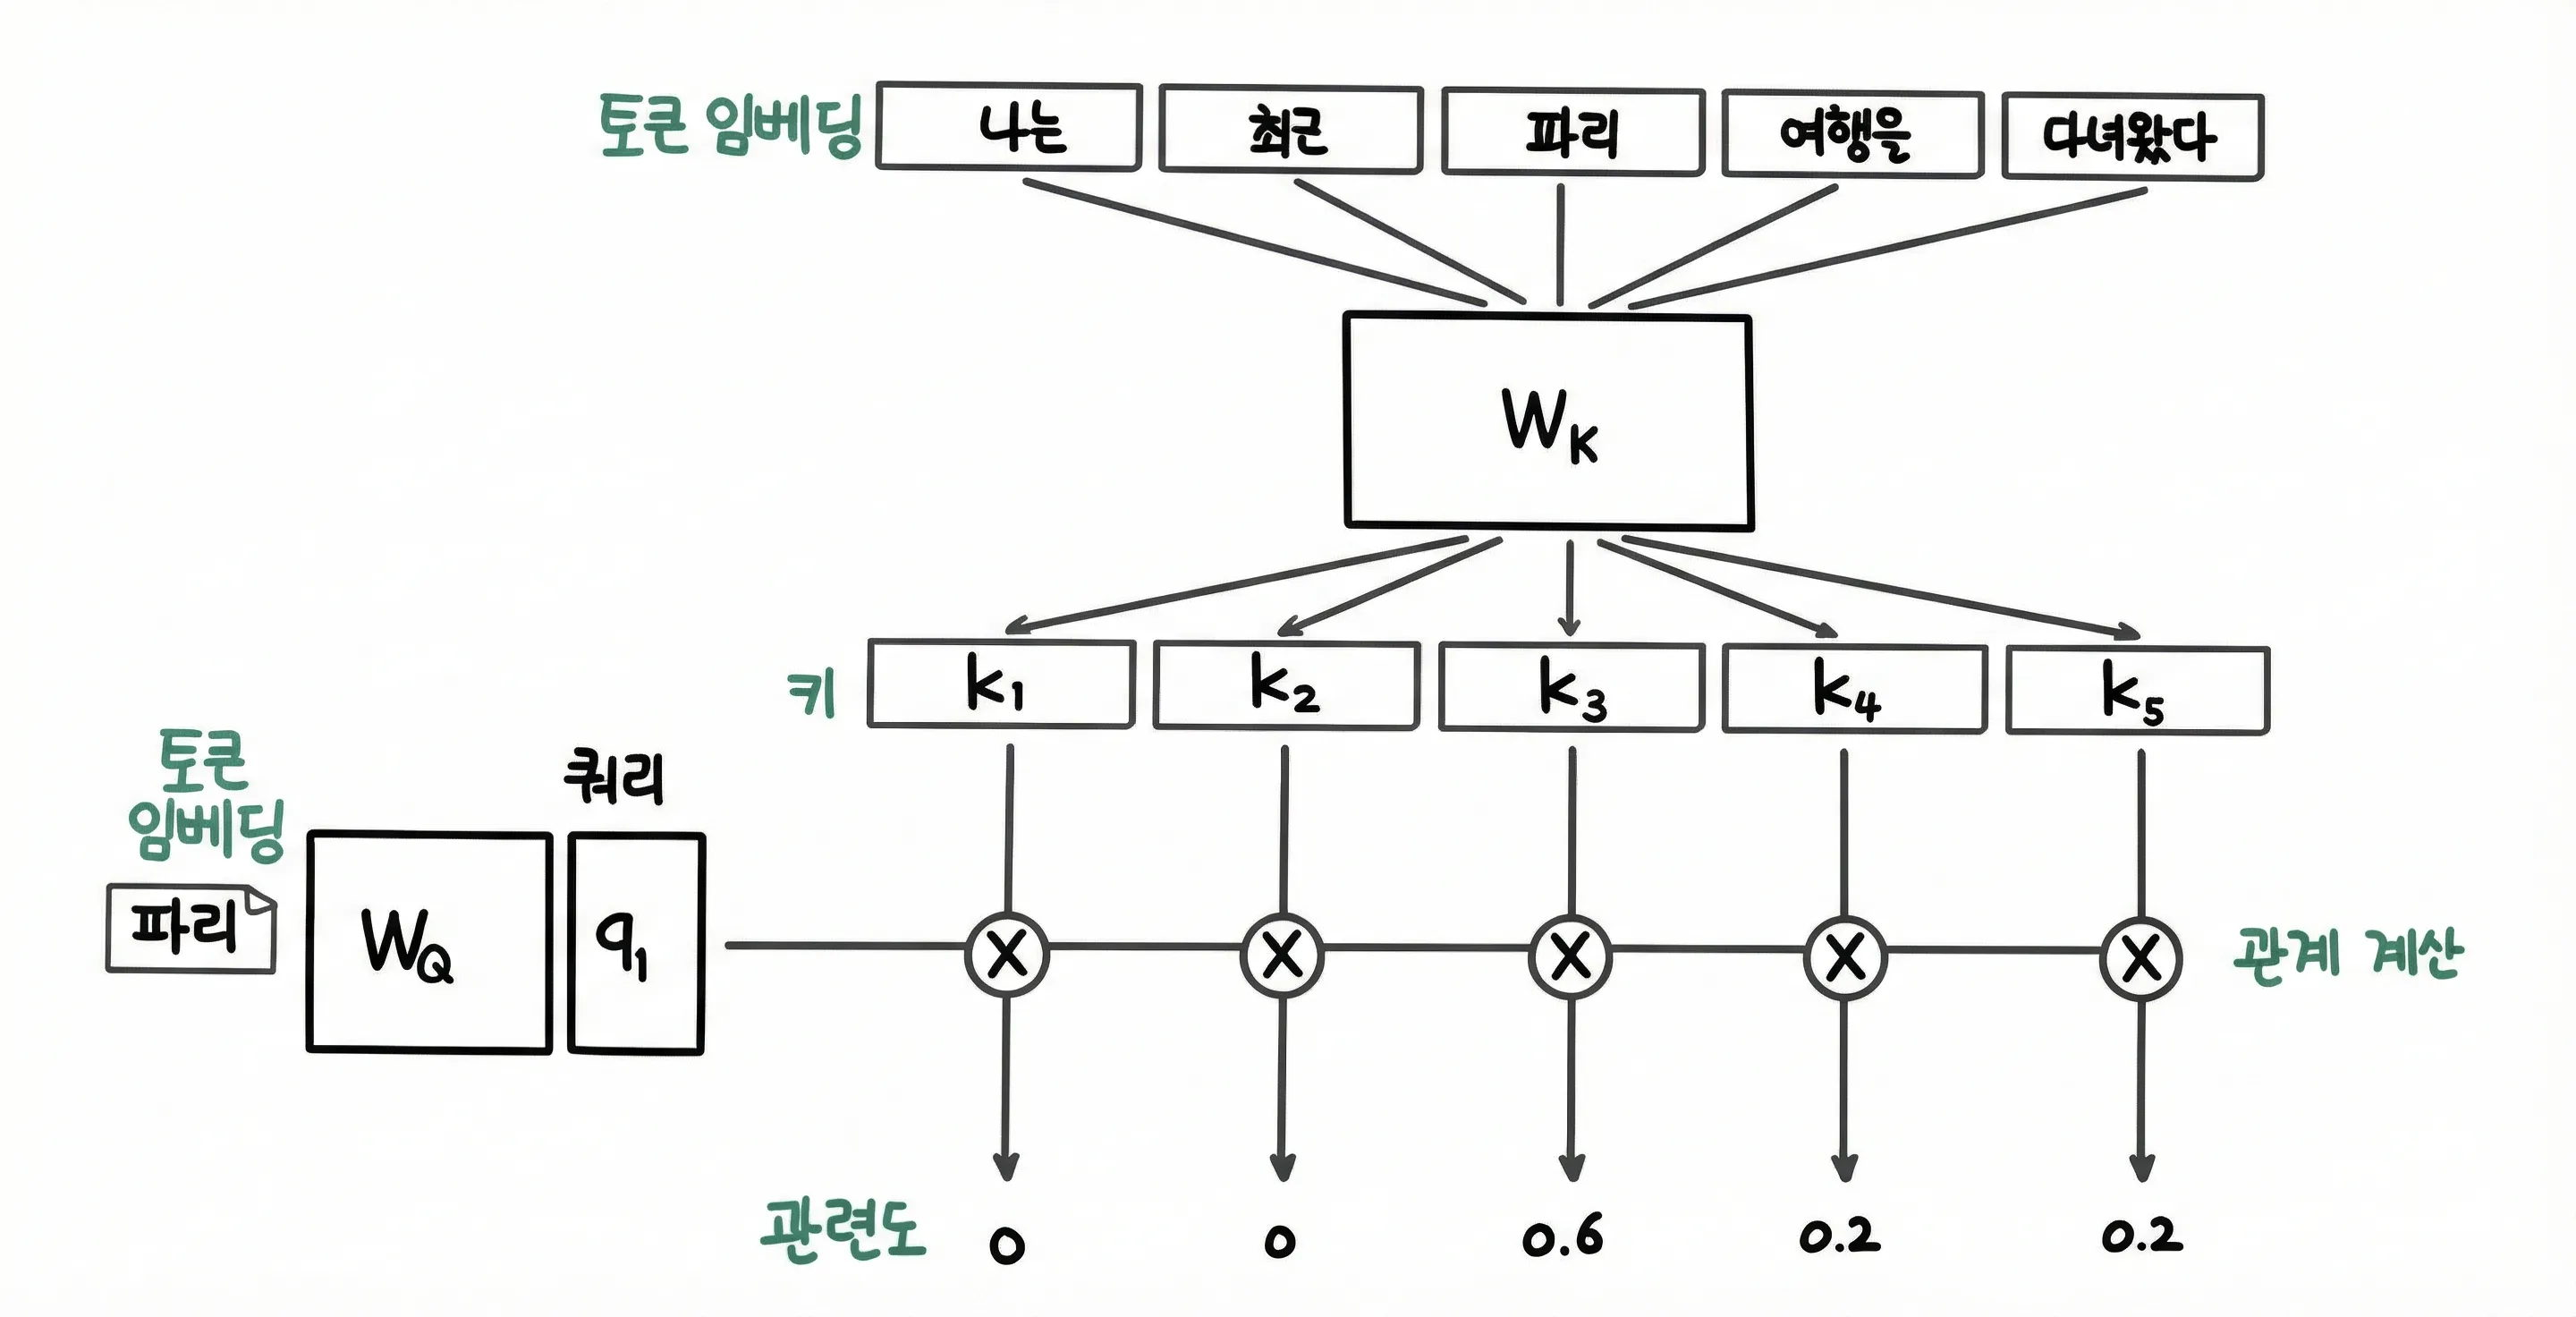
어텐션에서는 각 위치의 입력 벡터를 별도의 학습 가중치 , , 로 변환해 쿼리(Query), 키(Key), 값(Value)을 만든다. 쿼리와 키의 점곱은 관련도 점수가 되고, 소프트맥스(softmax)를 거친 점수로 값을 가중합한다. 값은 검색 결과의 순위가 아니라 다음 층에 전달할 정보 벡터다.
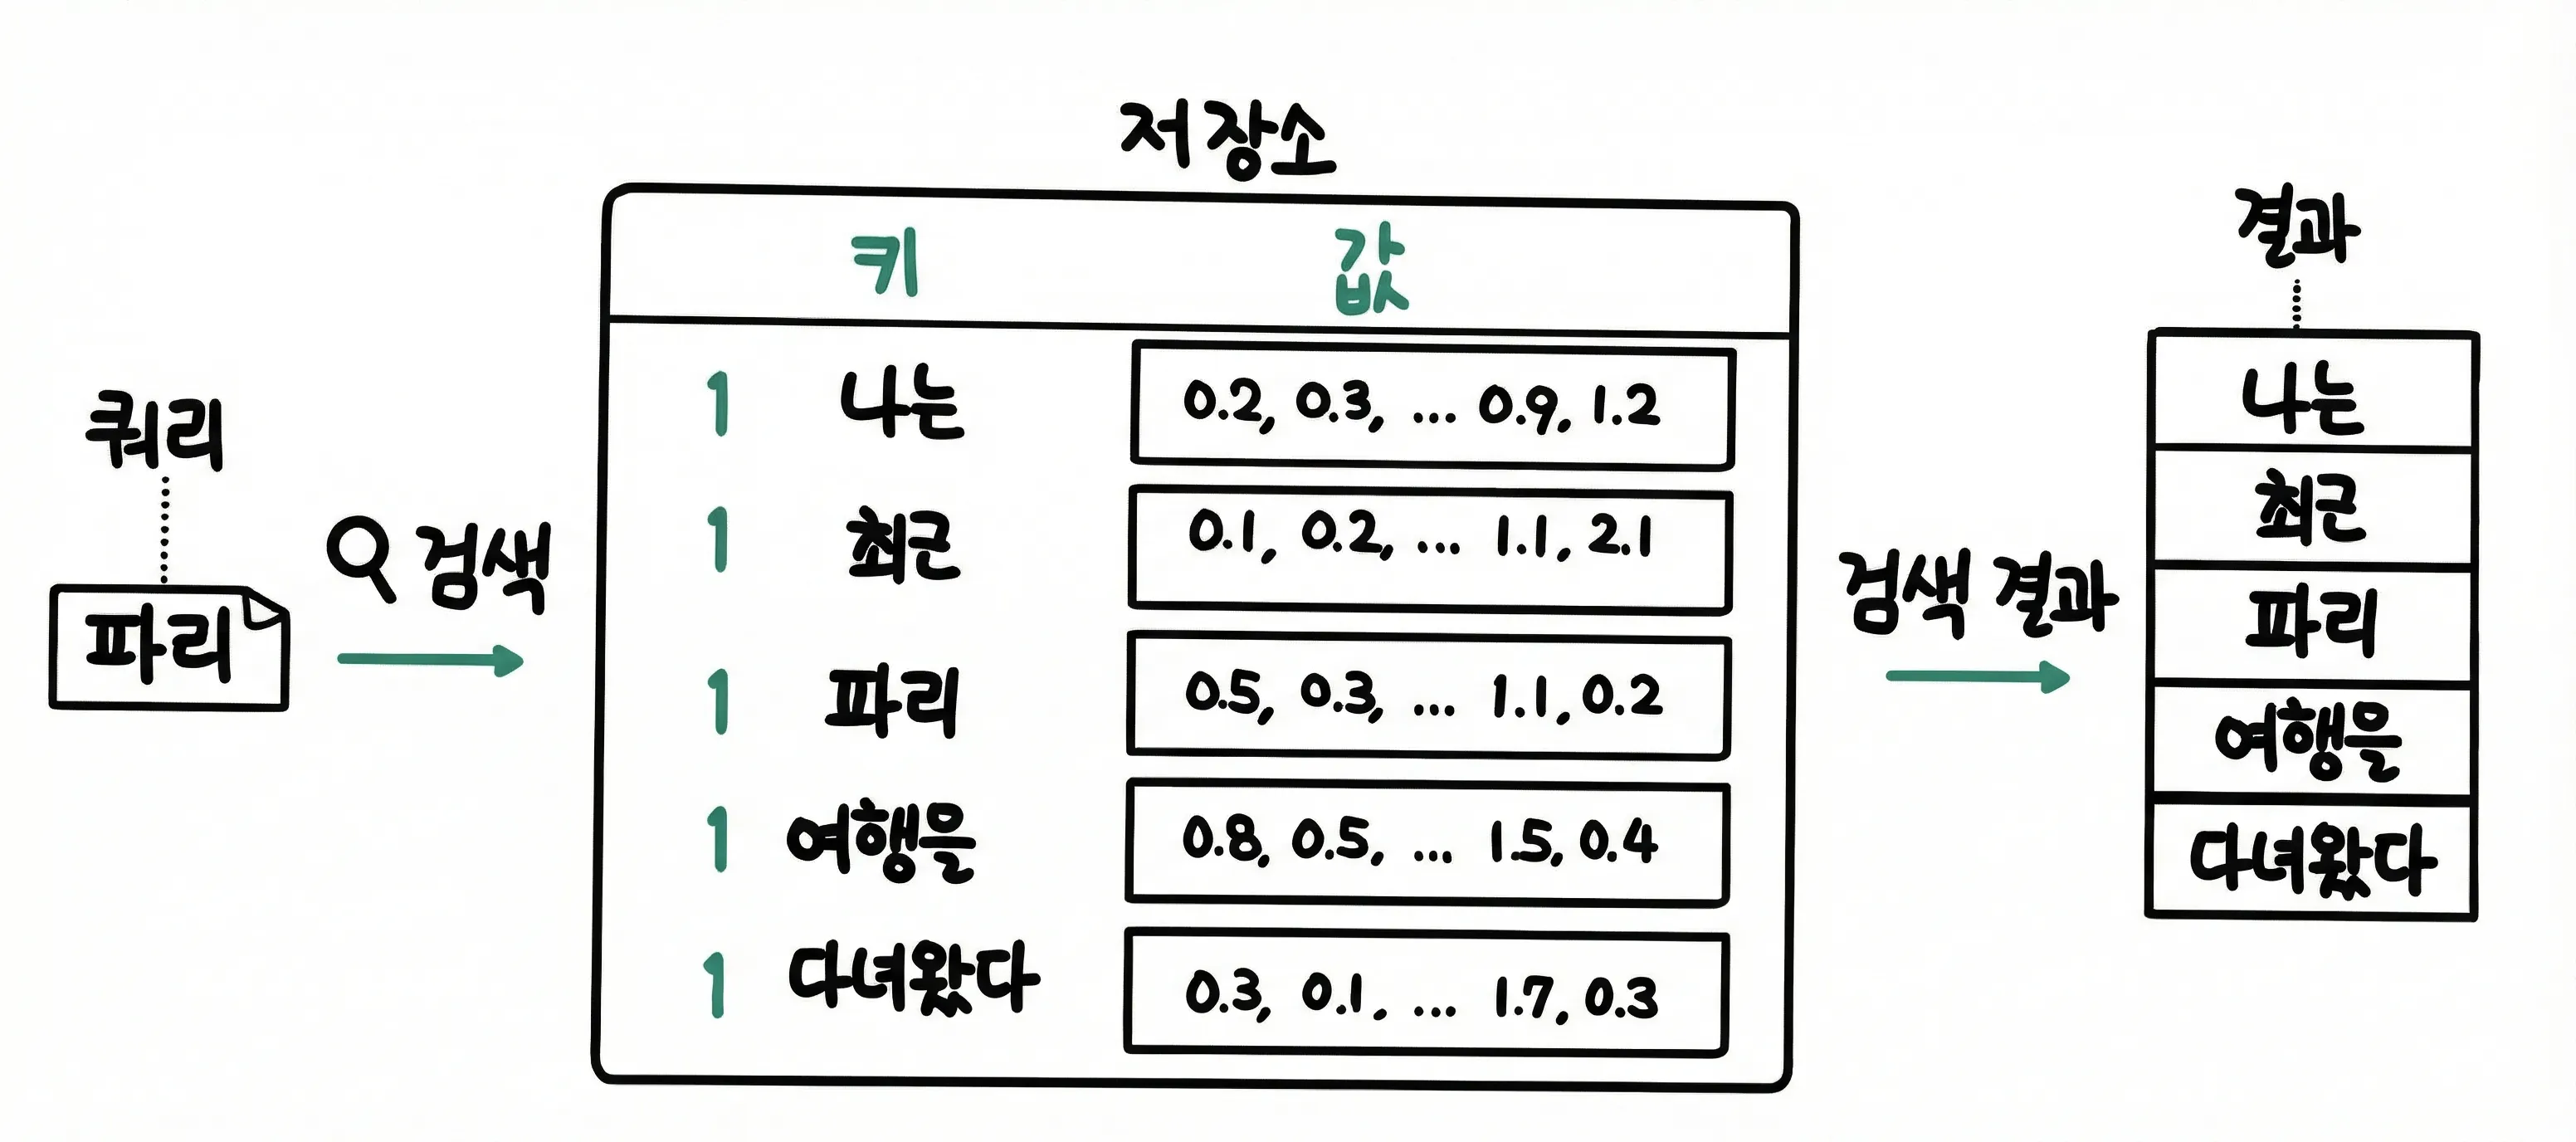
그림의 검색 비유에서 쿼리는 현재 위치가 찾는 정보, 키는 각 위치가 제공하는 단서, 값은 그 위치가 전달할 내용에 대응한다. 세 벡터는 입력을 복사한 것이 아니라 서로 다른 선형 변환의 결과다. 그래서 같은 단어라도 문맥과 학습된 가중치에 따라 참고 대상이 달라질 수 있다.
어텐션 헤드의 계산식은 다음과 같다.
는 [B, T_q, d_k], 는 [B, T_k, d_k], 는 [B, T_k, d_v]다. 점수 행렬은 [B, T_q, T_k], 출력은 [B, T_q, d_v]가 된다. 로 나누는 것은 내적 크기가 차원에 따라 커져 소프트맥스가 지나치게 뾰족해지는 것을 완화한다. 은 허용하지 않는 위치에 큰 음수를 더하는 선택적 마스크다.
import math
import torch
from torch import nn

torch.manual_seed(7)
x = torch.randn(1, 5, 16)             # [배치, 입력 길이, 모델 차원]
q = nn.Linear(16, 8)(x)
k = nn.Linear(16, 8)(x)
v = nn.Linear(16, 8)(x)

scores = q @ k.transpose(-2, -1) / math.sqrt(q.size(-1))
weights = scores.softmax(dim=-1)
context = weights @ v
print(scores.shape, context.shape)
print(weights.sum(dim=-1))
# torch.Size([1, 5, 5]) torch.Size([1, 5, 8])
# 각 행의 합은 1에 가깝다.
첫 번째 길이 5는 어떤 위치가 질문하는지를, 두 번째 길이 5는 참고할 수 있는 위치를 뜻한다. 한 행의 가중치가 1로 합쳐져도 그것을 인간이 읽는 의미의 중요도나 근거로 곧바로 해석하면 안 된다. 헤드와 층마다 정보를 변환하며, 높은 가중치가 반드시 최종 예측의 원인이라고 보장하지 않는다.
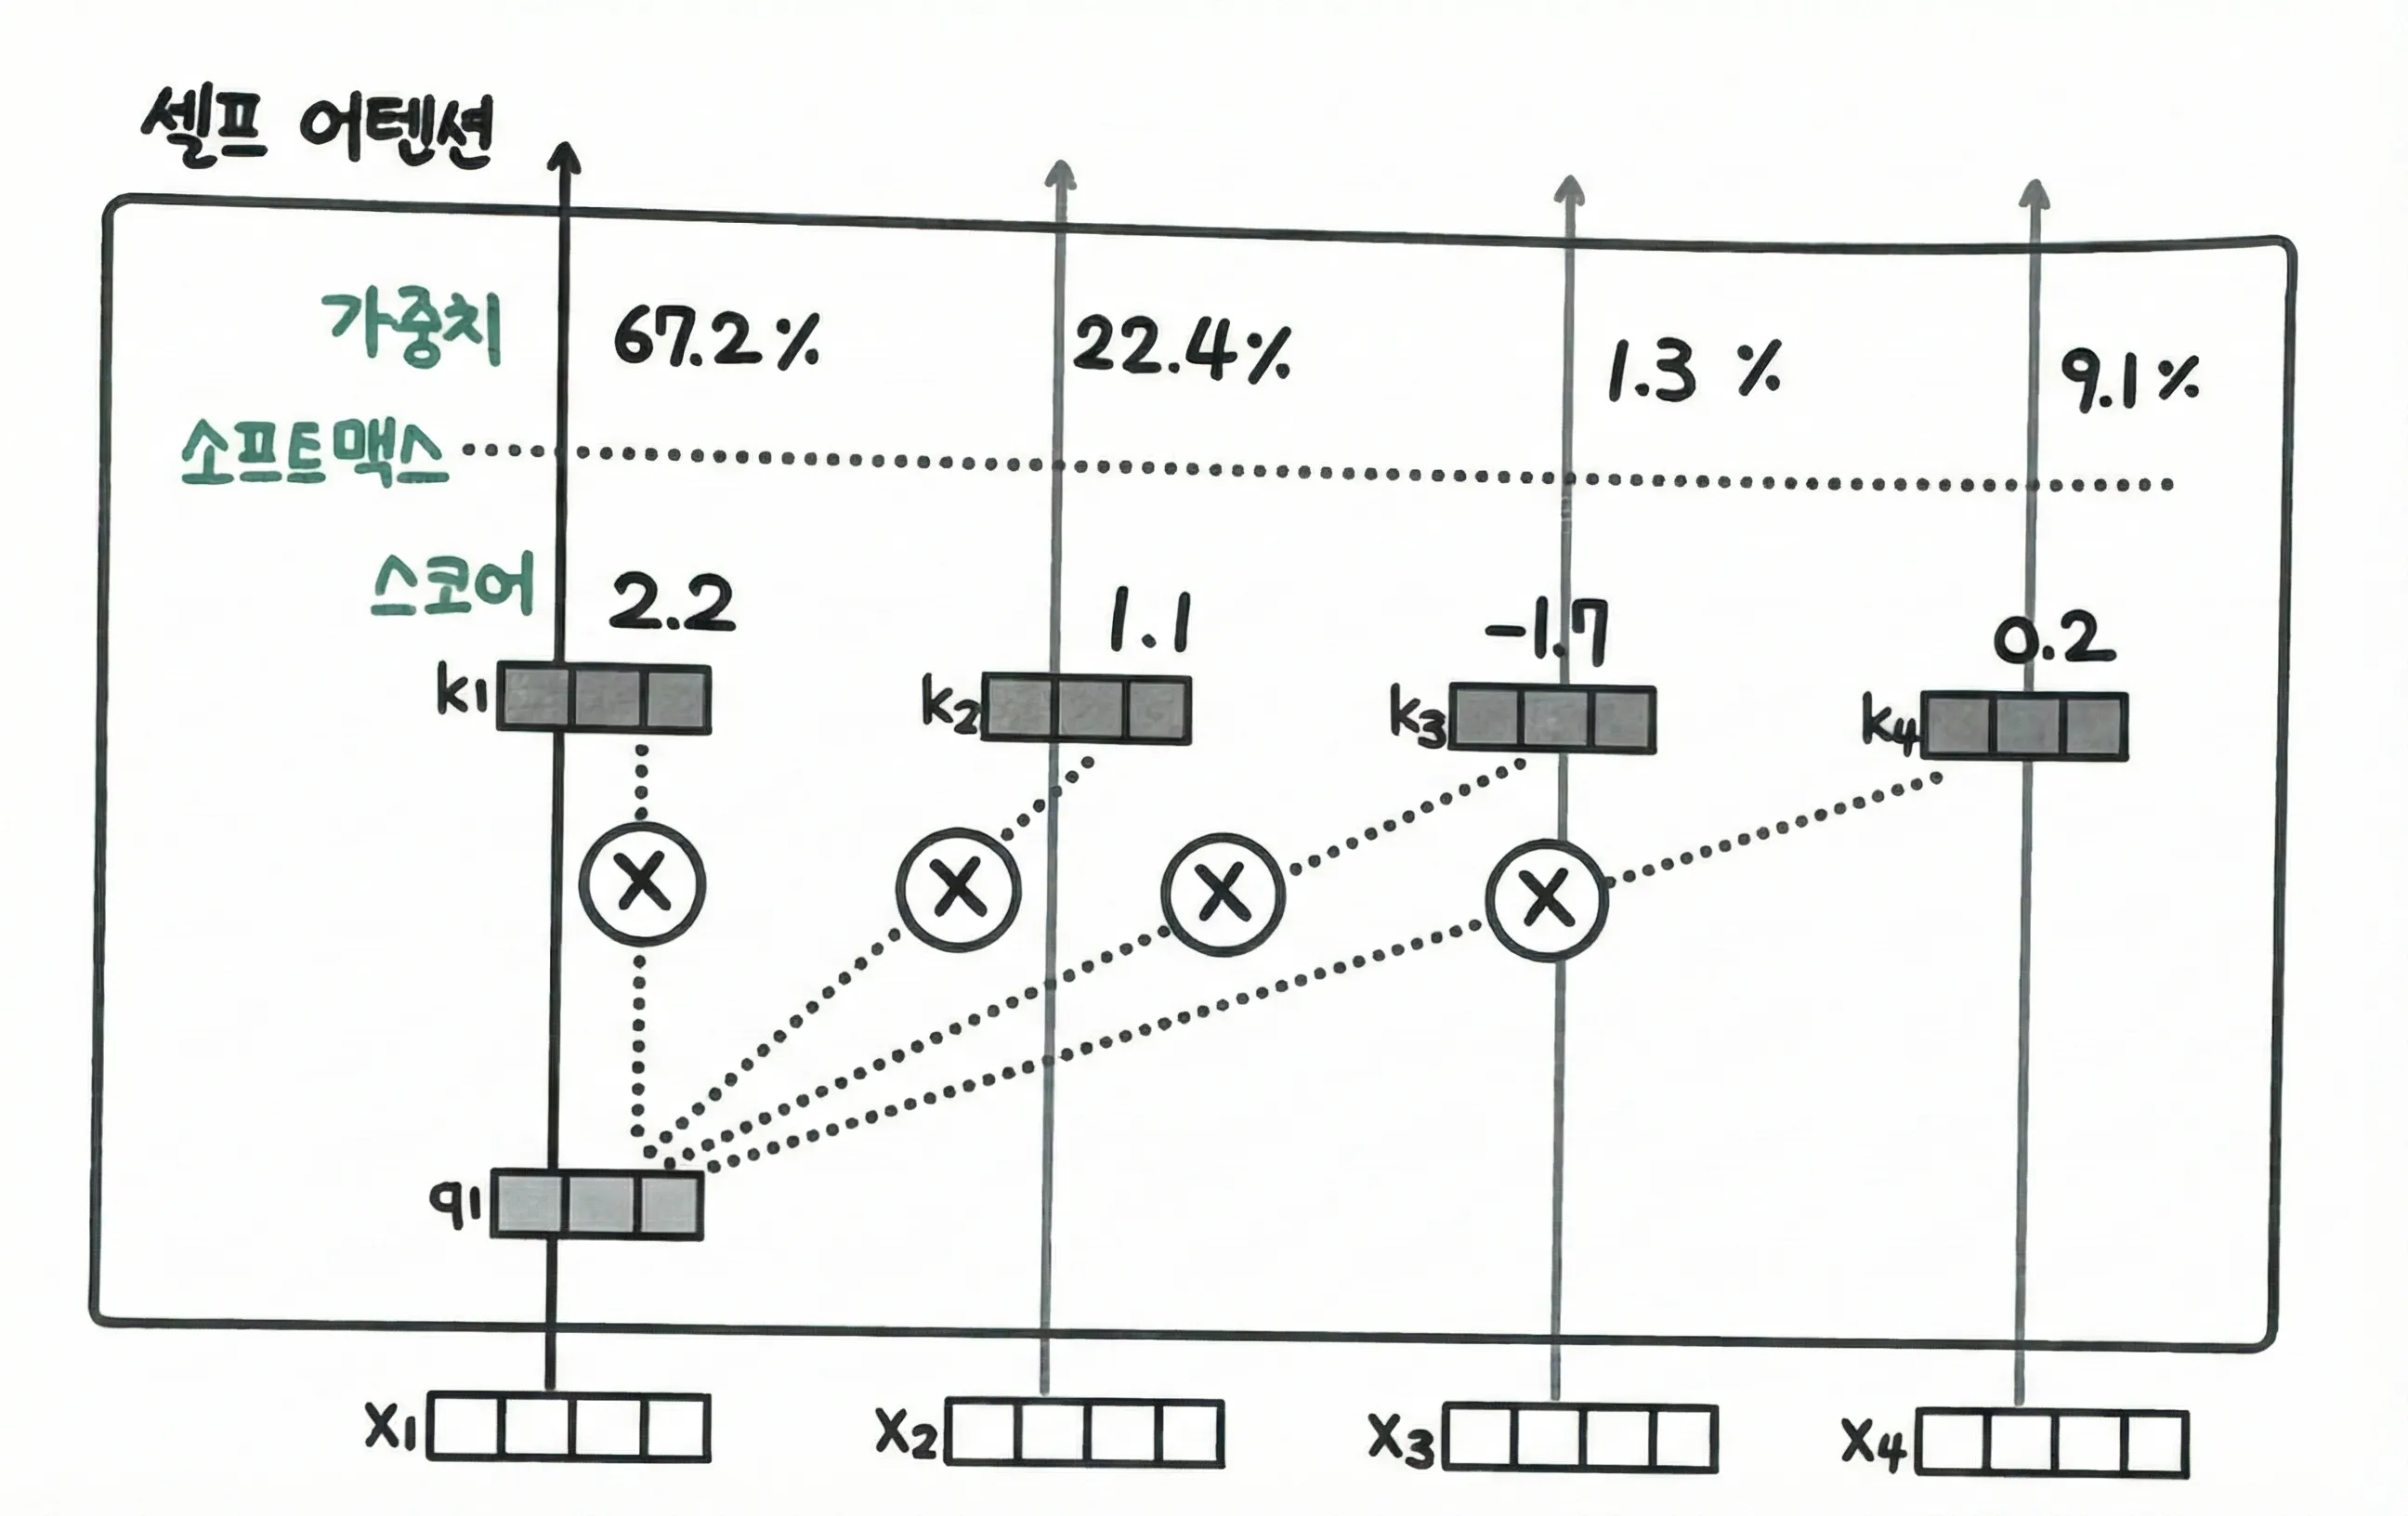
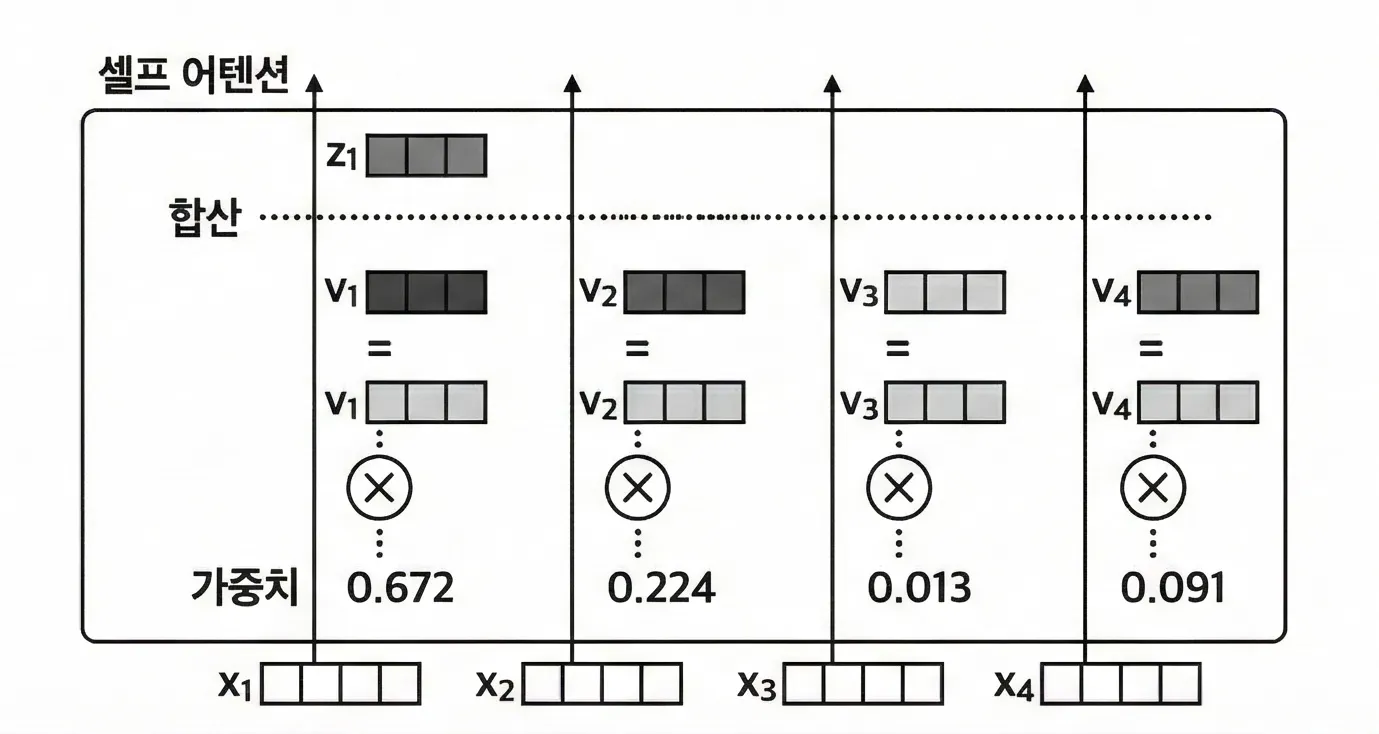
두 그림은 한 쿼리가 여러 값 벡터를 다른 비중으로 섞는 과정을 보여준다. 예를 들어 세 값에 대한 가중치가 0.672, 0.315, 0.013이라면 첫 번째 값의 반영 비율이 가장 크다. 이는 한 헤드의 한 행에 관한 설명이며 전체 모델의 단어 중요도는 아니다.
멀티 헤드 어텐션
한 개의 가중치 집합만 쓰는 대신 개의 헤드가 서로 다른 투영 공간에서 어텐션을 계산한다. 각 헤드의 결과를 이어 붙인 뒤 출력 선형 변환으로 섞는다. , 헤드 수가 4이면 각 헤드 차원은 4다. 헤드를 늘린다고 항상 품질이 좋아지지는 않는다. 모델 차원을 고정하면 헤드별 차원은 작아지고 계산·메모리 구성도 달라진다.
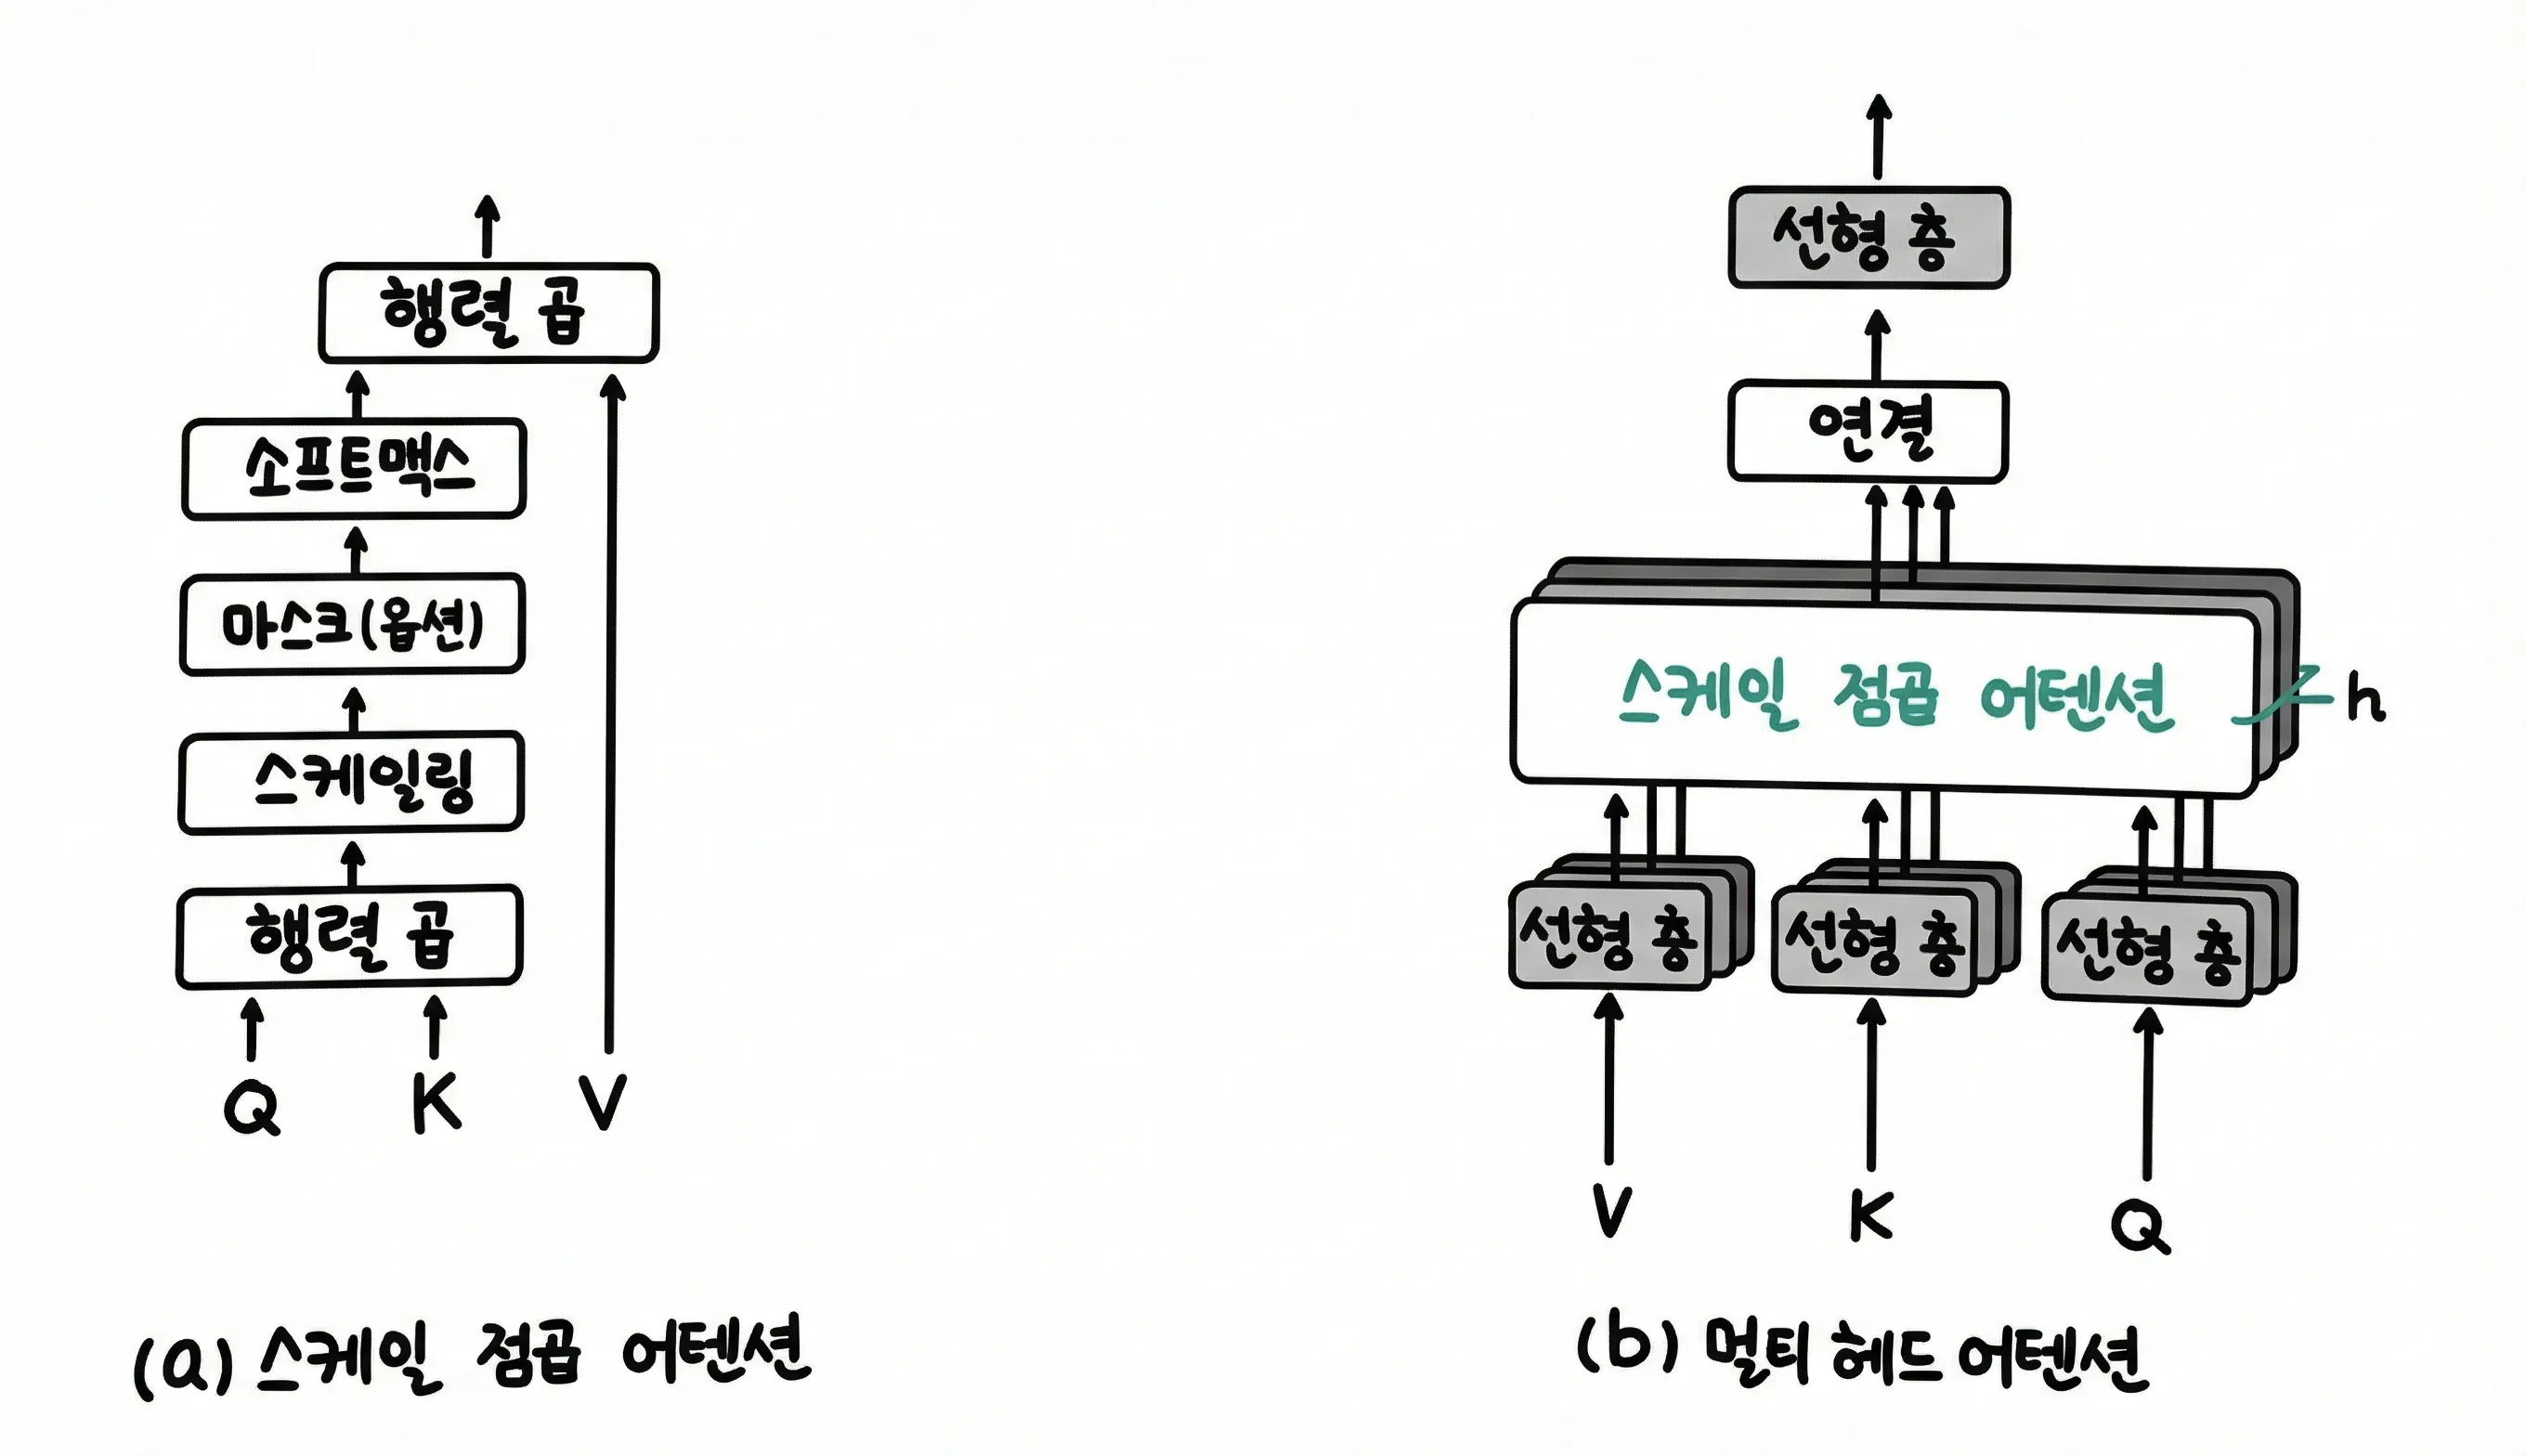
그림에서는 여러 헤드가 같은 입력을 각각 다른 공간으로 투영한 다음 결과를 결합한다. 파이토치의 nn.MultiheadAttention은 이 과정과 출력 투영을 함께 제공한다. 아래의 인코더 호출은 쿼리·키·값이 모두 x라서 셀프 어텐션이다.
import torch
from torch import nn

x = torch.randn(2, 5, 16)
attention = nn.MultiheadAttention(embed_dim=16, num_heads=4, batch_first=True)
output, weights = attention(x, x, x)
print(output.shape, weights.shape)
# torch.Size([2, 5, 16]) torch.Size([2, 5, 5])weights는 기본적으로 헤드 평균이다. 헤드별 값을 보려면 average_attn_weights=False를 지정한다. 학습과 서빙에서 가중치가 필요하지 않다면 need_weights=False로 불필요한 반환을 줄일 수 있다. 입력 차원은 헤드 수로 나누어떨어져야 한다. 서로 다른 길이의 쿼리와 키를 쓰는 크로스 어텐션에서는 출력 길이가 쿼리 길이를 따른다.
층 정규화와 피드포워드
트랜스포머 블록에는 어텐션 외에 잔차 연결(residual connection), 층 정규화(layer normalization), 피드포워드 네트워크(FFN)가 들어간다. 잔차 연결은 입력 x에 하위 층의 출력을 더한다. 층 정규화는 보통 각 토큰의 특징 차원을 기준으로 값을 정규화한다.
- 후정규화(post-norm):
x = LayerNorm(x + Sublayer(x))처럼 잔차 합 뒤에 정규화한다. 원 논문의 구조에 가깝다. - 선정규화(pre-norm):
x = x + Sublayer(LayerNorm(x))처럼 하위 층 전에 정규화한다. 깊은 모델의 학습 안정성을 위해 쓰이는 구성이다.
두 식의 연산 순서는 같지 않다. 아래 완성 예제에서는 파이토치 층의 norm_first=True를 지정해 선정규화를 선택한다. 이를 원 논문의 후정규화 그림과 구분해서 읽어야 한다.
피드포워드는 Linear(d_model, d_ff) → 활성 함수 → Linear(d_ff, d_model) 형태다. 각 토큰 위치에 같은 네트워크를 독립적으로 적용하므로 그 자체가 토큰 사이 정보를 섞지는 않는다. 앞의 어텐션이 문맥을 섞은 결과를 토큰별로 다시 가공한다. 드롭아웃과 잔차 연결을 포함한 블록은 입력과 출력의 마지막 차원을 같게 유지해 여러 층을 쌓을 수 있다.
인코더와 디코더
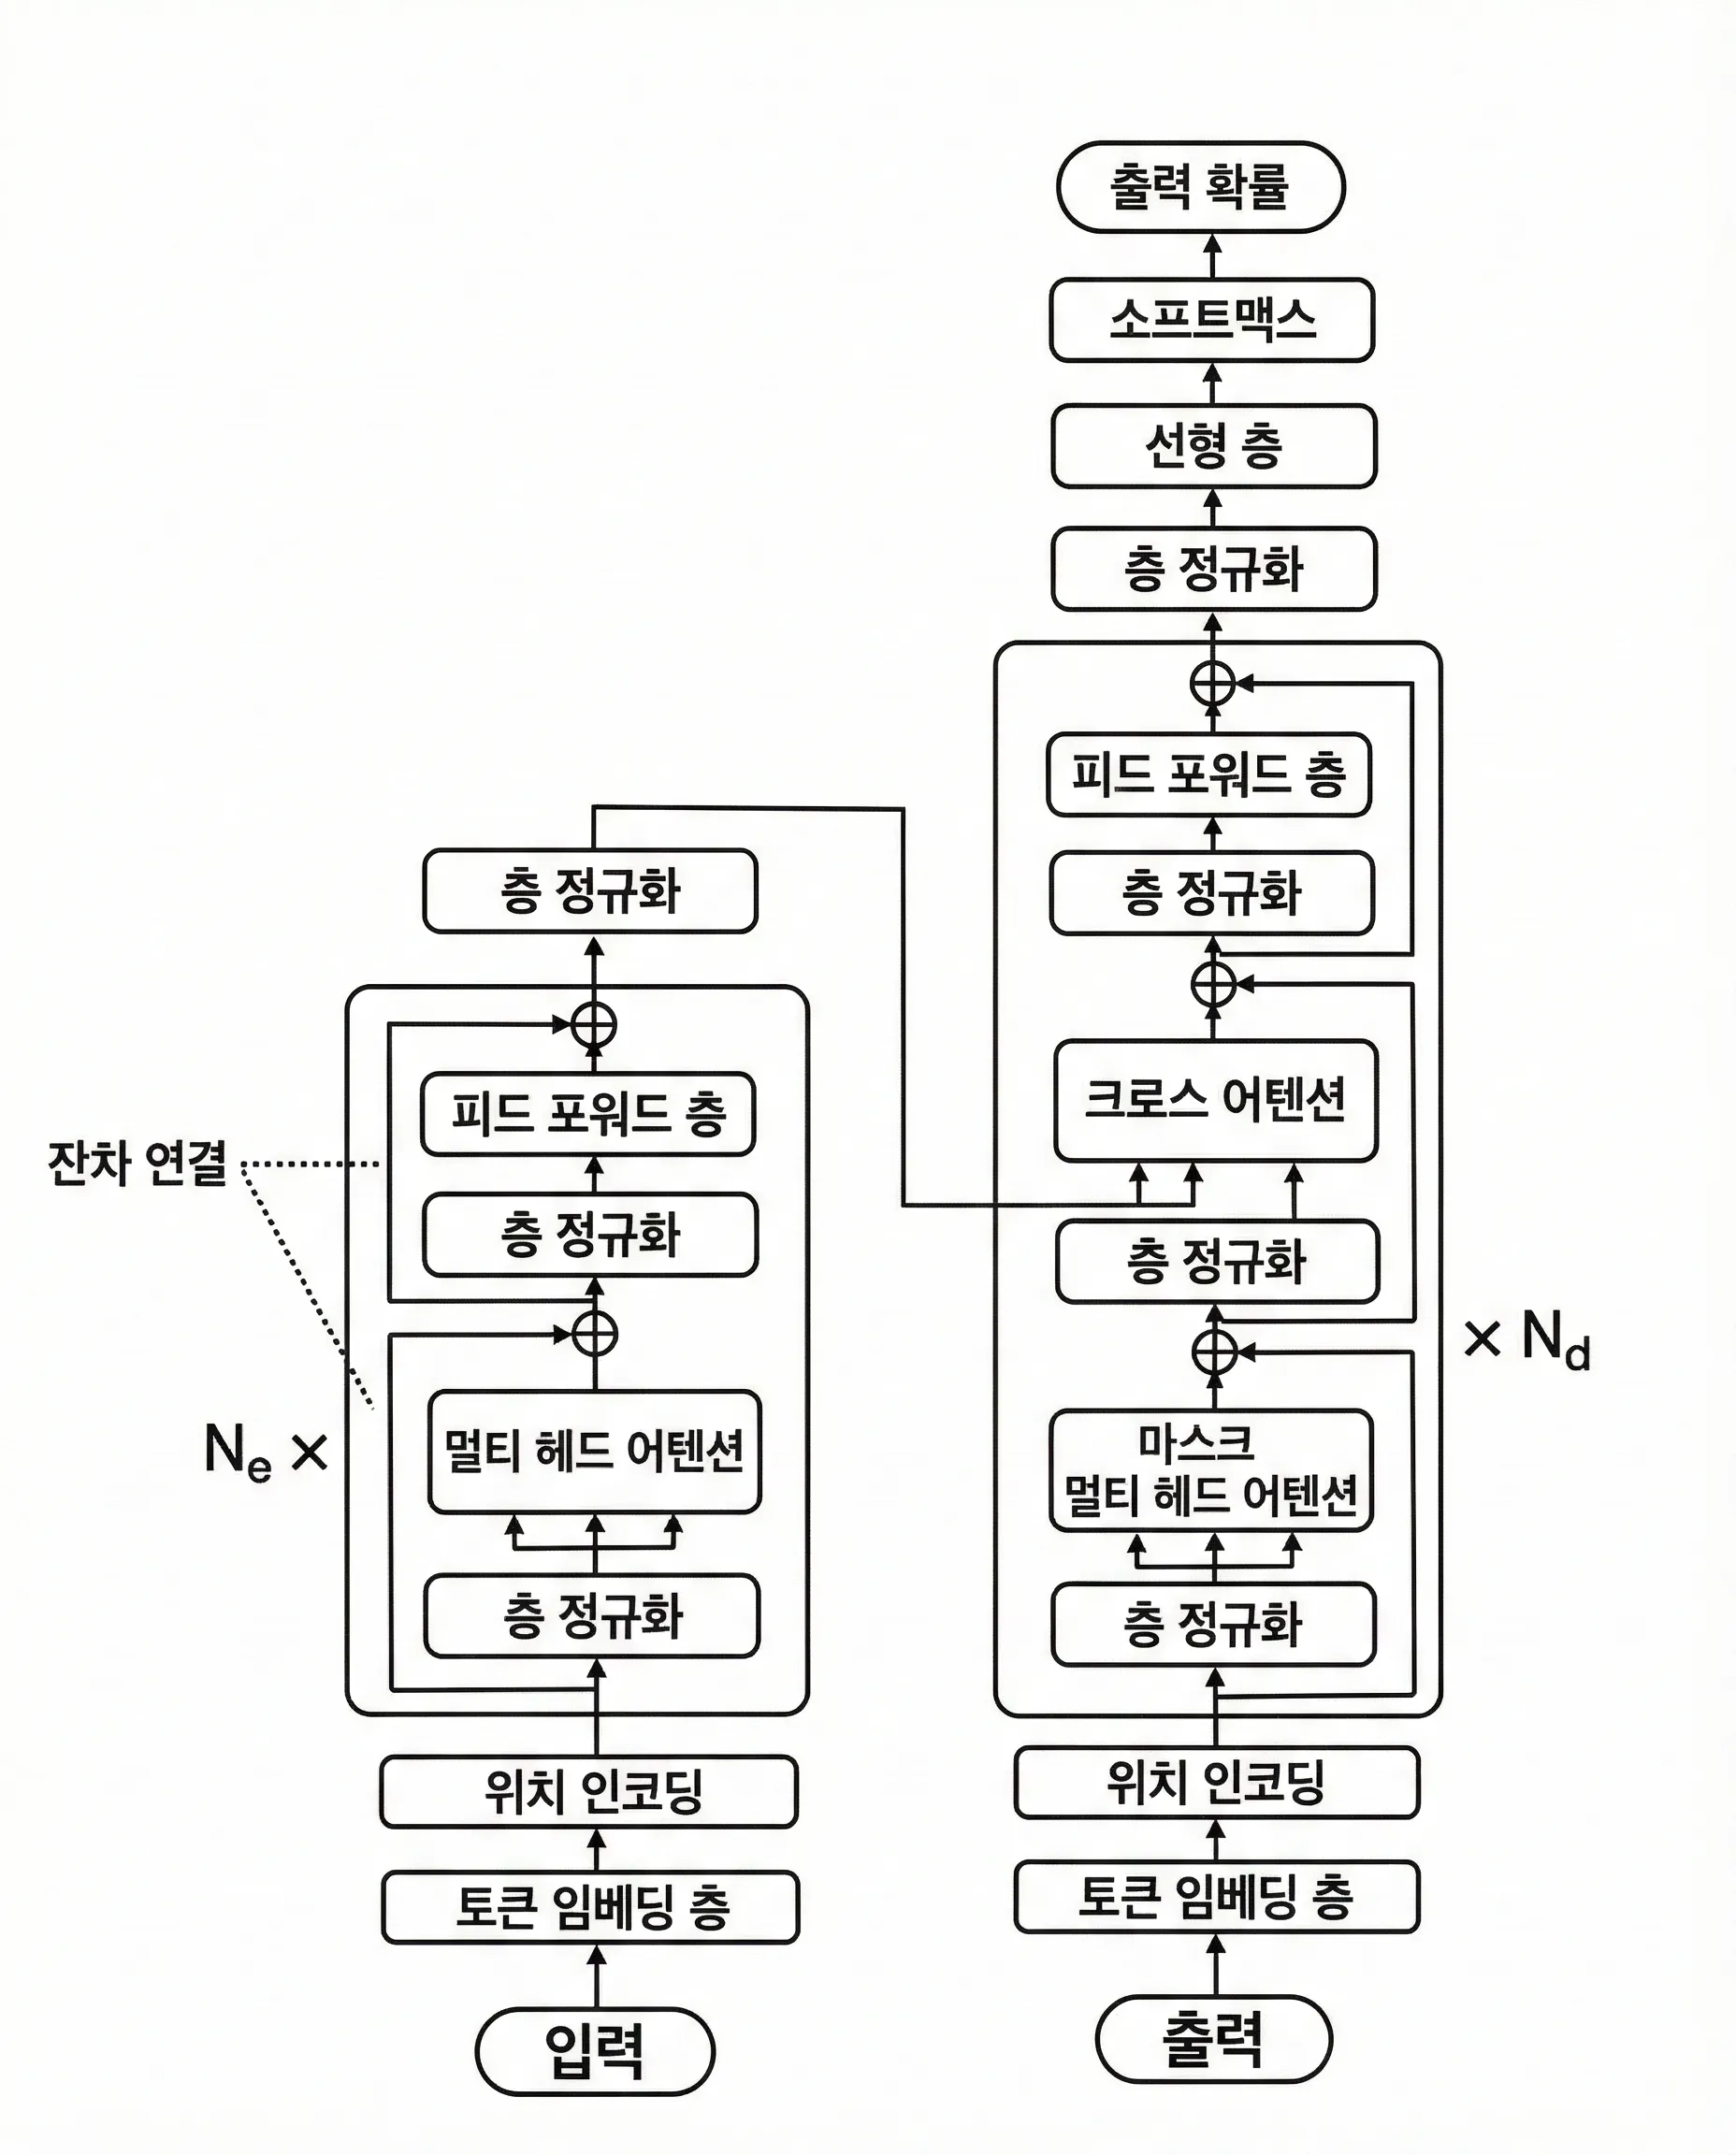
인코더 그림의 블록은 양방향 셀프 어텐션과 FFN을 반복한다. 별도의 패딩 마스크가 없다면 각 토큰이 모든 입력 위치를 볼 수 있다. 화살표가 하위 층을 돌아 다시 더해지는 부분이 잔차 연결이다.
디코더는 출력 토큰을 앞에서부터 생성한다. 학습 중에는 정답 문장을 한 번에 넣어 계산하더라도, 위치 가 미래의 정답 토큰 을 보면 답을 훔쳐보는 셈이 된다. 인과 마스크(causal mask)로 미래 위치의 점수를 차단한다. 학습 입력은 보통 시작 토큰부터 마지막 정답 직전까지, 학습 목표는 그보다 한 칸 오른쪽의 토큰들이다.
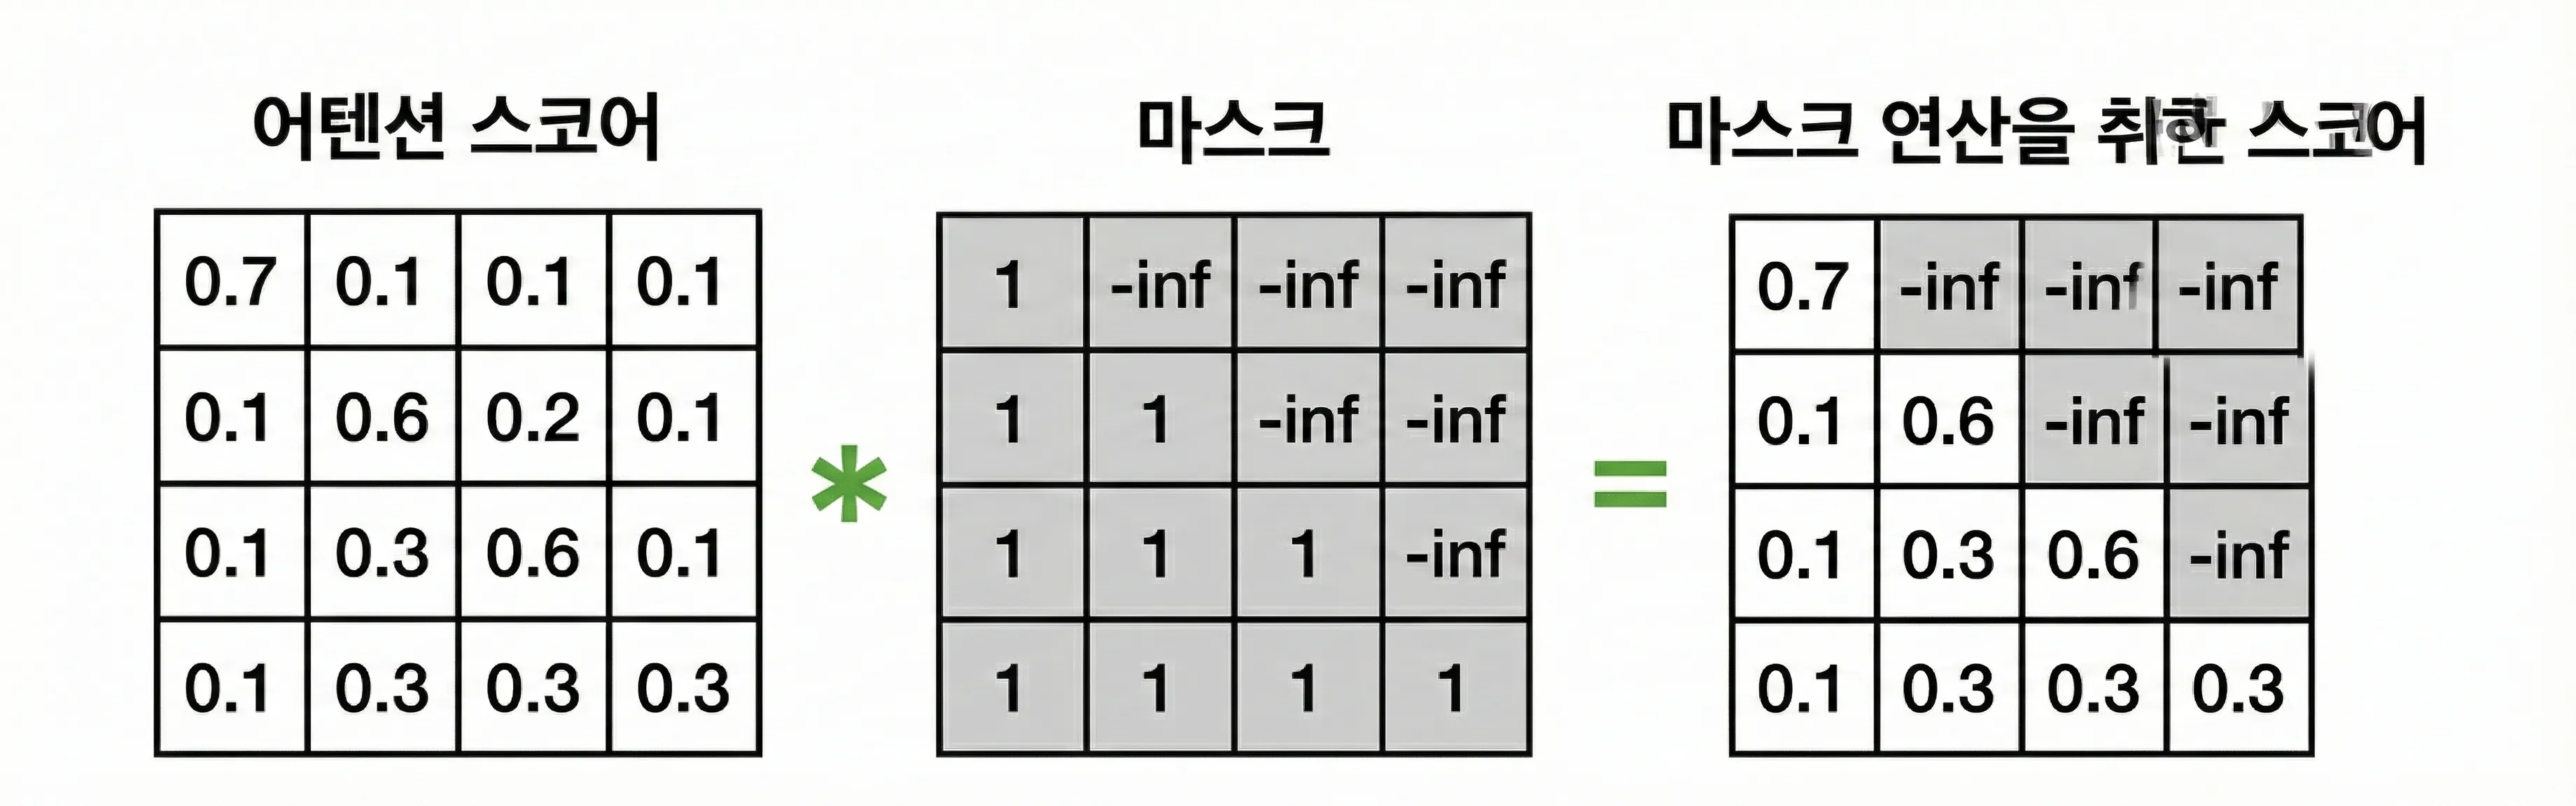
두 그림에서 아래쪽 삼각형만 보이는 이유가 인과 마스크다. 현재 위치는 자신과 이전 위치만 참고한다. 이를 torch.triu(..., diagonal=1)로 구현할 때 불리언 True는 파이토치의 nn.Transformer 계열에서 참고 금지를 뜻한다. 이 규칙은 API마다 다를 수 있으므로 사용 중인 어텐션 함수의 마스크 의미를 확인해야 한다.
인코더·디코더 구조의 디코더에는 두 종류의 어텐션이 있다. 첫 번째는 출력 토큰끼리의 마스크된 셀프 어텐션이다. 두 번째 크로스 어텐션에서는 디코더 상태가 쿼리이고 인코더 출력이 키와 값이다. 따라서 출력 길이와 입력 길이가 달라도 된다. 디코더 전용 LLM에는 이 크로스 어텐션이 필수 요소가 아니다.
파이토치로 한 번 연결해 보기
아래 코드는 학습된 번역기가 아니라 구조와 모양을 확인하는 작은 예제다. 입력 임베딩, 인코더, 한 칸 이동한 디코더 입력, 인과 마스크, 어휘 점수까지 연결한다. 가중치는 무작위 초기화 상태이므로 출력 토큰의 의미를 평가할 수 없다.
import torch
from torch import nn

torch.manual_seed(7)
vocab_size, d_model = 32, 16
embedding = nn.Embedding(vocab_size, d_model)
position = nn.Embedding(16, d_model)

encoder_layer = nn.TransformerEncoderLayer(
    d_model=d_model, nhead=4, dim_feedforward=64,
    dropout=0.0, batch_first=True, norm_first=True,
)
decoder_layer = nn.TransformerDecoderLayer(
    d_model=d_model, nhead=4, dim_feedforward=64,
    dropout=0.0, batch_first=True, norm_first=True,
)
encoder = nn.TransformerEncoder(encoder_layer, num_layers=1)
decoder = nn.TransformerDecoder(decoder_layer, num_layers=1)
output_layer = nn.Linear(d_model, vocab_size)

src_ids = torch.tensor([[3, 5, 7, 9]])
target_ids = torch.tensor([[1, 8, 6, 2]])  # 예시: 시작, 내용, 내용, 종료
decoder_input = target_ids[:, :-1]         # [1, 8, 6]
labels = target_ids[:, 1:]                 # [8, 6, 2]

def embed(ids):
    positions = torch.arange(ids.size(1), device=ids.device).unsqueeze(0)
    return embedding(ids) + position(positions)

memory = encoder(embed(src_ids))
tgt_length = decoder_input.size(1)
causal_mask = torch.triu(
    torch.ones(tgt_length, tgt_length, dtype=torch.bool), diagonal=1
)
hidden = decoder(embed(decoder_input), memory, tgt_mask=causal_mask)
logits = output_layer(hidden)
loss = nn.CrossEntropyLoss()(logits.reshape(-1, vocab_size), labels.reshape(-1))
print(memory.shape, logits.shape, labels.shape)
print(torch.isfinite(loss).item())
# torch.Size([1, 4, 16]) torch.Size([1, 3, 32]) torch.Size([1, 3])
# Truememory의 길이 4는 입력 길이, logits의 길이 3은 디코더 입력 길이다. 마지막 차원 32는 다음 토큰 후보의 수다. CrossEntropyLoss는 각 위치의 어휘 점수와 오른쪽으로 한 칸 민 정답 ID를 비교한다. True는 손실이 유한하다는 모양 확인일 뿐, 번역 품질이 좋다는 뜻이 아니다. 학습 때는 최적화 단계와 여러 예시가 더 필요하다. 실제 데이터에 패딩이 있으면 입력·출력 패딩 마스크도 전달해야 패딩 토큰에 주의가 쏠리지 않는다.
실무에서 결과를 해석할 때
| 관찰 | 먼저 확인할 것 | 다음 판단 |
|---|---|---|
| 학습 손실은 낮지만 생성 결과가 불량함 | 디코더 입력과 정답을 한 칸 이동했는지, 추론 마스크가 학습과 같은지 | 작은 문장으로 다음 토큰 예측을 검산한다 |
| 긴 문장에서 메모리가 급증함 | 실제 토큰 수, 배치 크기, 어텐션 구현, 패딩 양 | 길이 제한·배치 조정·메모리 효율적 어텐션을 검토한다 |
| 서로 다른 길이의 입력과 출력에서 모양 오류가 남 | 쿼리 길이와 키 길이를 같은 값으로 가정한 자체 구현인지 | T_q와 T_k를 분리하고 크로스 어텐션 마스크 모양을 확인한다 |
| 동일한 단어가 매번 다른 의미로 쓰이는 듯함 | 임베딩만 보는지, 어텐션 이후의 문맥 벡터를 보는지 | 층별 표현과 문장 전체의 문맥을 함께 살핀다 |
표의 첫 번째 행처럼 낮은 학습 손실만으로 생성 품질을 판단하면 안 된다. 학습에는 정답의 이전 토큰이 제공되지만, 생성 시에는 모델 자신의 이전 출력이 이어지기 때문이다. 작업별 검증 데이터에서 정확도나 번역 품질뿐 아니라 길이별 오류와 지연 시간도 본다. 마스크와 토크나이저가 다른 모델을 연결할 때는 먼저 작은 입력의 텐서 모양과 한 단계 출력부터 검산하는 편이 안전하다.
참고
같은 카테고리의 글
이어서 읽을 글
3. 트랜스포머 모델을 다루기 위한 허깅 페이스 트랜스포머 라이브러리
Transformers의 pipeline, 토크나이저, 모델을 연결해 텍스트 분류 추론이 이루어지는 과정을 살펴본다.
3. 대규모 언어 모델 자세히 살펴보기
프롬프트 입력부터 다음 토큰 선택, KV 캐시, 어텐션과 피드포워드 층까지 생성 모델의 계산 흐름을 따라간다.
15. LLM 에이전트
도구 호출 루프와 상태 관리, 권한 검증, 프롬프트 인젝션 방어를 환불 문의 처리 예제로 설명합니다.
14. 멀티모달 LLM
이미지·오디오·비디오 입력의 처리 흐름과 영수증 추출 예제, 모달리티별 평가 항목을 살펴봅니다.