목차
대규모 언어 모델 자세히 살펴보기
사전 준비
“이메일을 써 줘”라는 프롬프트를 주면 답장이 한꺼번에 나오는 것처럼 보인다. 실제 모델은 현재 문맥에서 다음 토큰의 점수를 계산 → 한 토큰 선택 → 문맥에 붙이기를 반복한다. 이 글은 그 한 번의 정방향 계산을 안쪽으로 따라가고, 길이가 늘어날 때 비용을 줄이는 방법까지 살펴본다.
예제는 transformers와 PyTorch, 모델 파일 다운로드가 필요하다. Hugging Face 설치 가이드를 먼저 확인하자. 아래의 mps는 Apple Silicon 환경 예시다. CUDA나 CPU 환경이라면 장치와 자료형 설정을 그 환경에 맞게 바꾸어야 한다.
from transformers import AutoModelForCausalLM, AutoTokenizer, pipeline
# 모델명
model_name = "microsoft/Phi-3-mini-4k-instruct"

# 모델 로드
model = AutoModelForCausalLM.from_pretrained(
    model_name,
    device_map="mps",
    dtype="auto",
)
#토크나이저 로드
tokenizer = AutoTokenizer.from_pretrained(model_name)

# 파이프라인 객체 생성
generator = pipeline(
    "text-generation",
    model=model,
    tokenizer=tokenizer,
    return_full_text=False,
    max_new_tokens=50,
    do_sample=False
)AutoTokenizer는 프롬프트를 토큰 ID로, AutoModelForCausalLM은 ID 시퀀스를 다음 토큰 점수로 바꾼다. pipeline은 이 둘과 생성 루프를 묶는다. return_full_text=False는 결과 문자열에서 입력 프롬프트를 제외하고, max_new_tokens=50은 새로 생성할 수 있는 토큰 수의 상한이다. do_sample=False이면 기본 탐욕적 선택을 사용한다. 이 설정들은 학습을 다시 하는 옵션이 아니라 추론 방식을 정한다.
트랜스포머 모델 개요
1. 훈련된 트랜스포머 LLM의 입출력
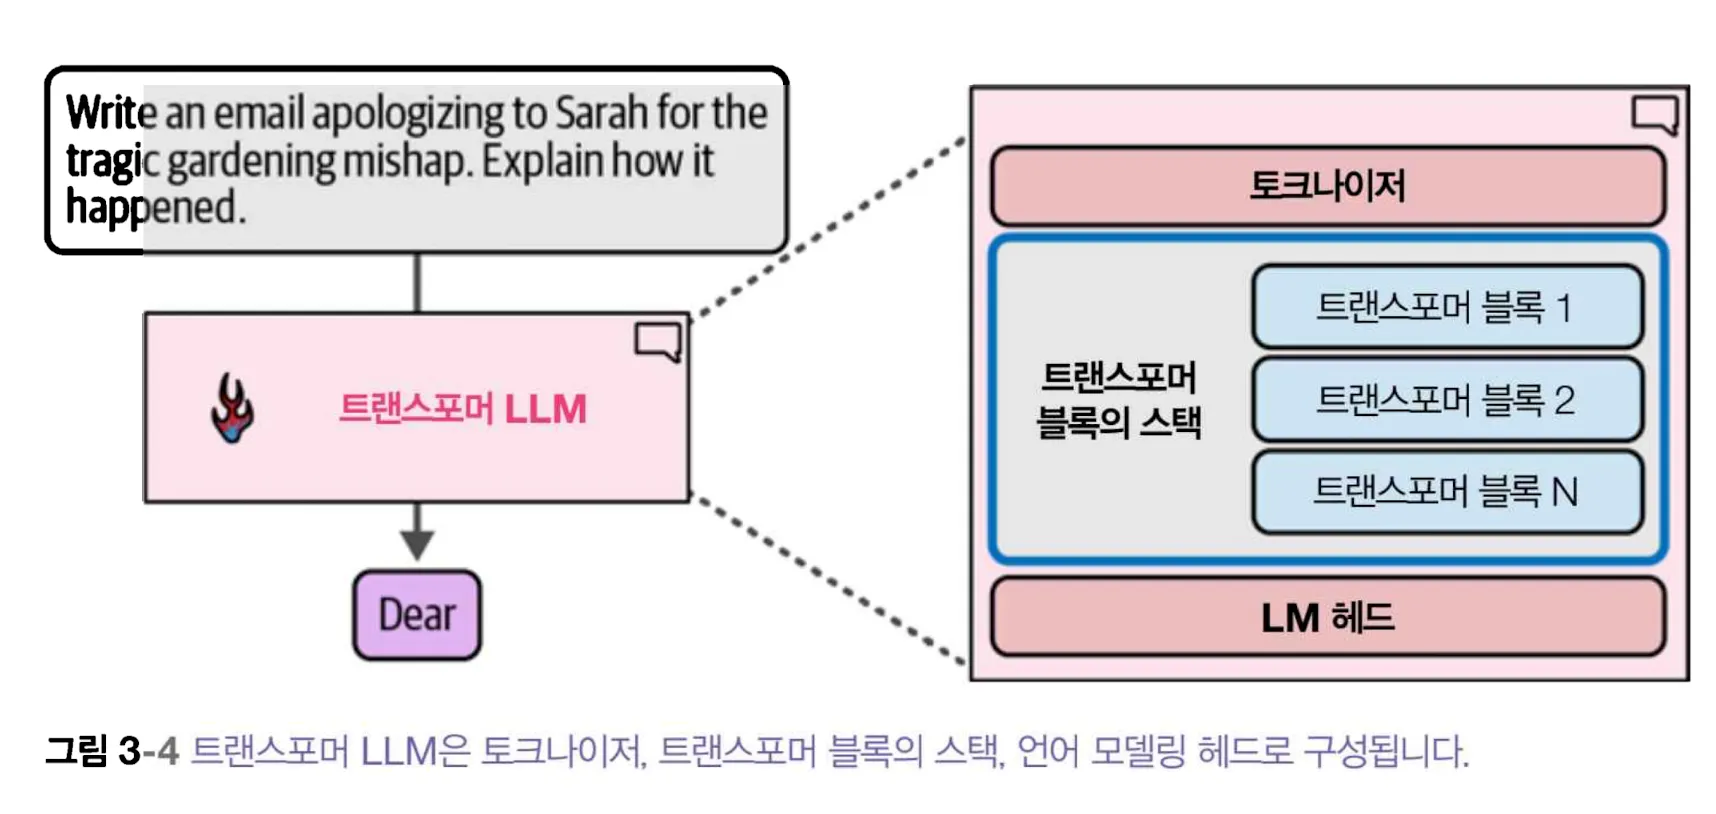
입력과 출력만 보는 검은 상자 관점에서 한 단계 들어가 보자. 이메일 프롬프트를 토큰화하면 각 ID가 임베딩으로 바뀌고, 여러 트랜스포머 블록을 통과한 마지막 위치의 표현에서 어휘 전체의 로짓(logits)을 얻는다. 로짓은 정규화 이전 점수다. 그중 다음 토큰을 고르면 새로운 문맥이 생긴다.
[이메일 작성 모델 예시]
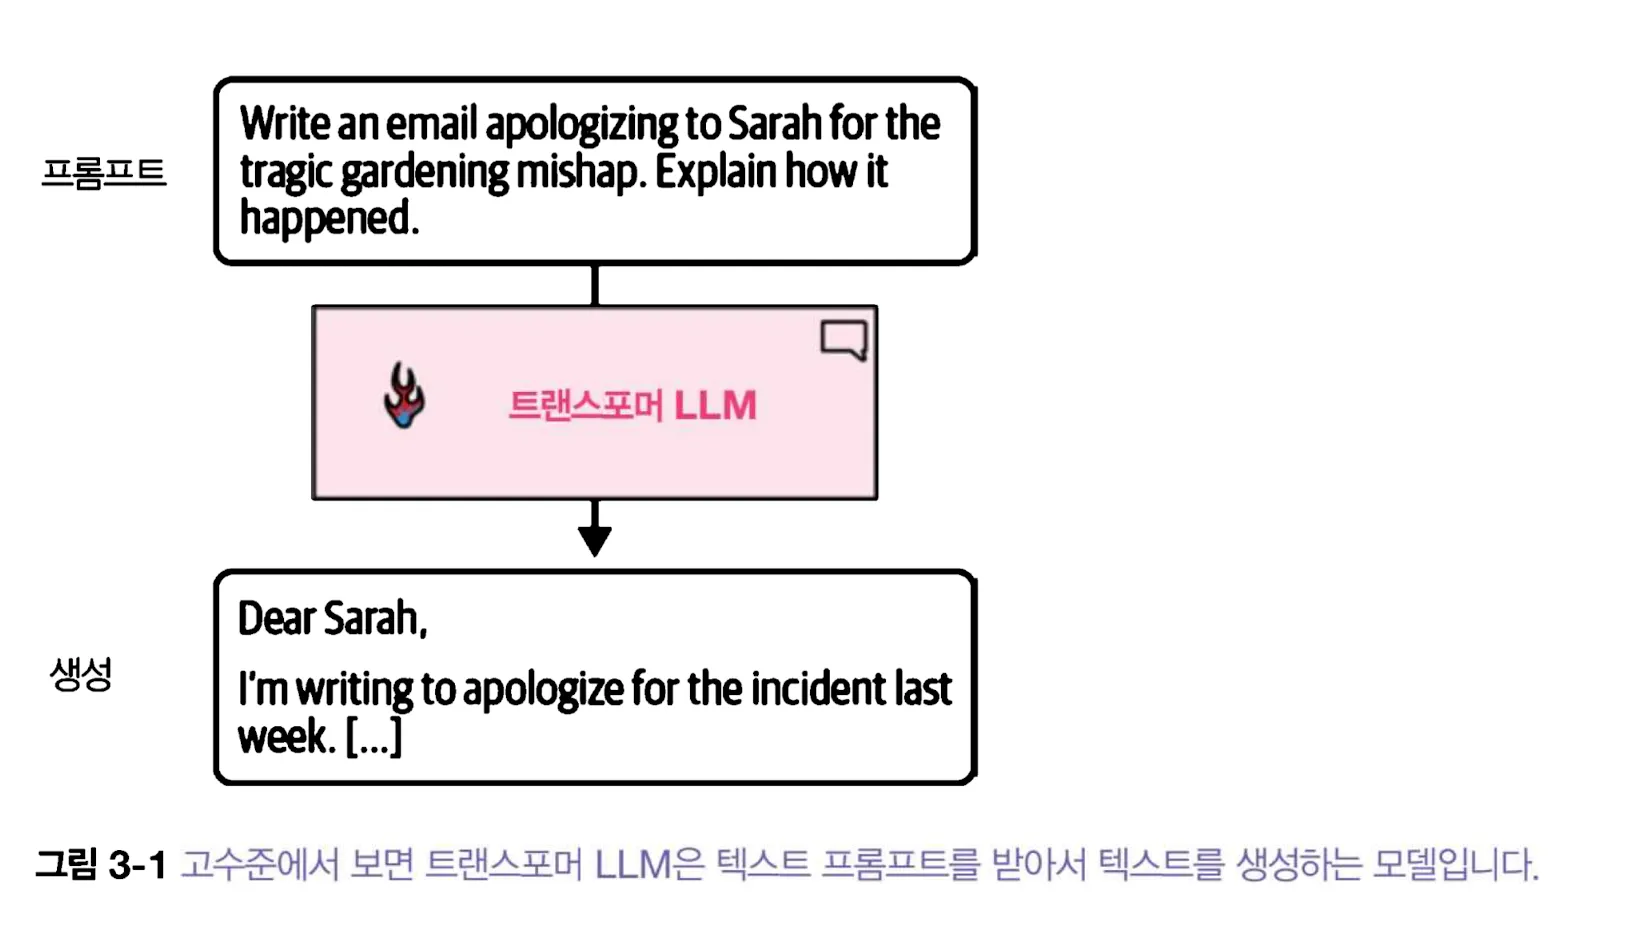
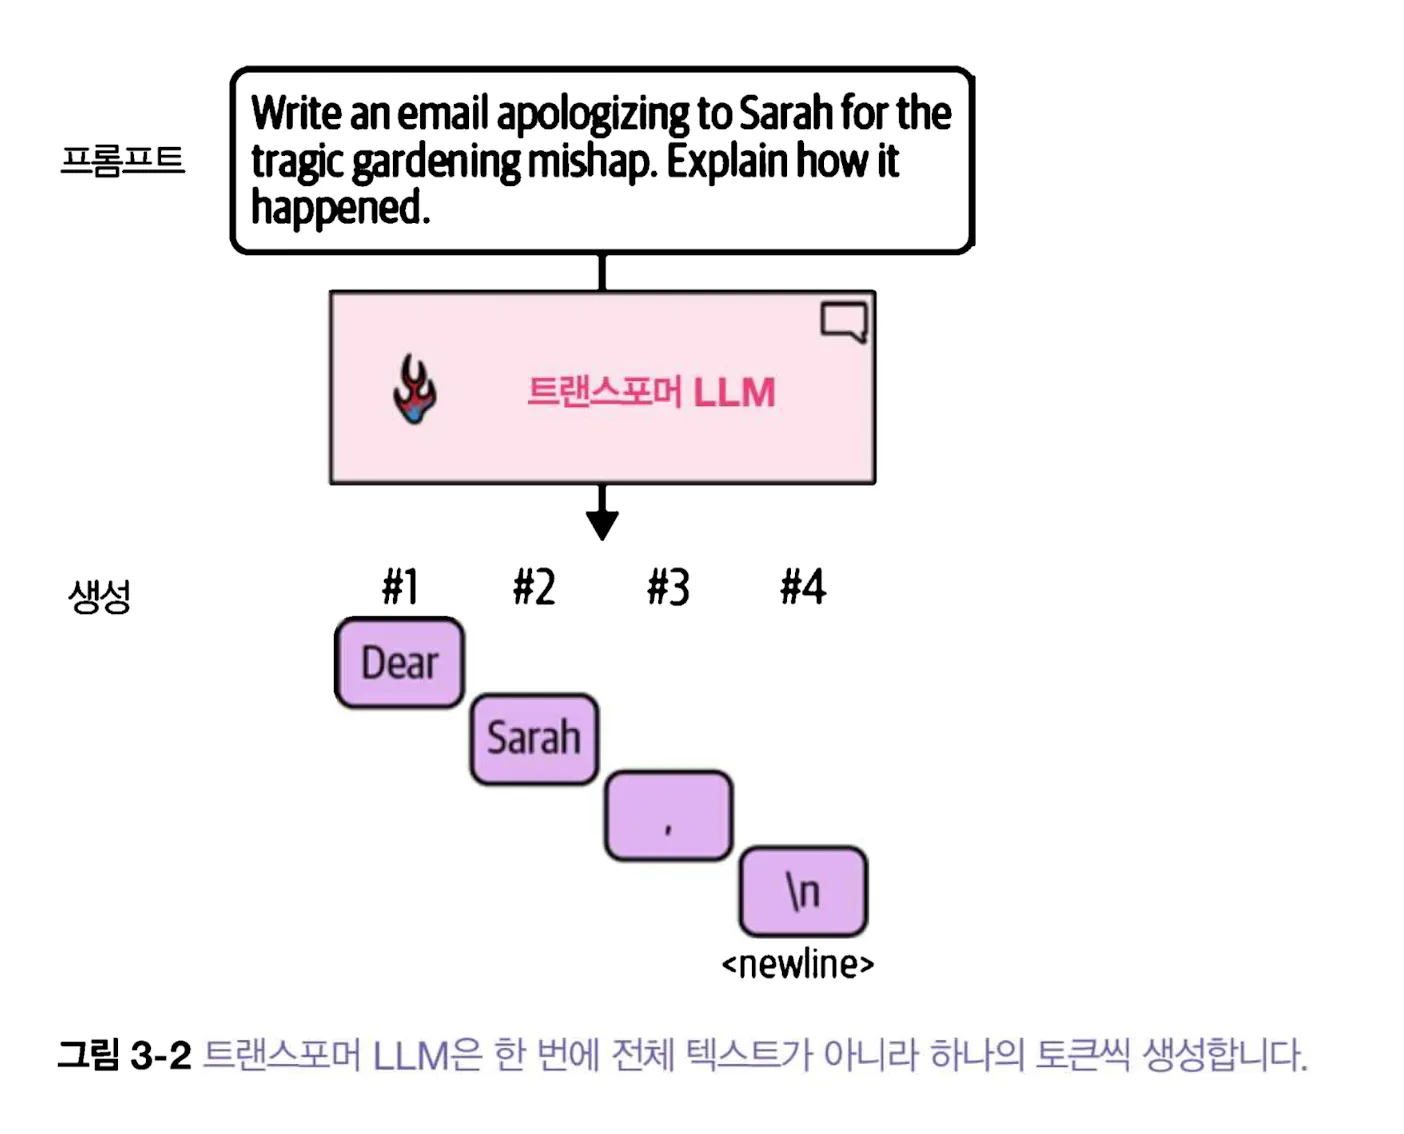
해당 모델은 한 번에 모든 텍스트를 생성하지 않고, 한 번에 하나의 토큰을 생성한다.
[입력 프롬프트에 대한 4개의 토큰을 생성하는 과정]
각 토큰 생성 단계에 모델의 정방향 계산이 필요하다. 첫 단계에서는 프롬프트의 여러 위치를 처리하고, 이후 단계에서는 KV 캐시를 쓰는 경우 새 토큰 위치에 필요한 계산을 수행한다. 따라서 “새 토큰마다 전체 프롬프트를 처음부터 다시 계산한다”는 설명은 캐시를 끈 단순화된 경우에만 맞다.
하나의 토큰을 생성 후 출력 토큰을 입력 프롬프트 끝에 추가하여 다음 생성단계를 위한 프롬프트를 사용
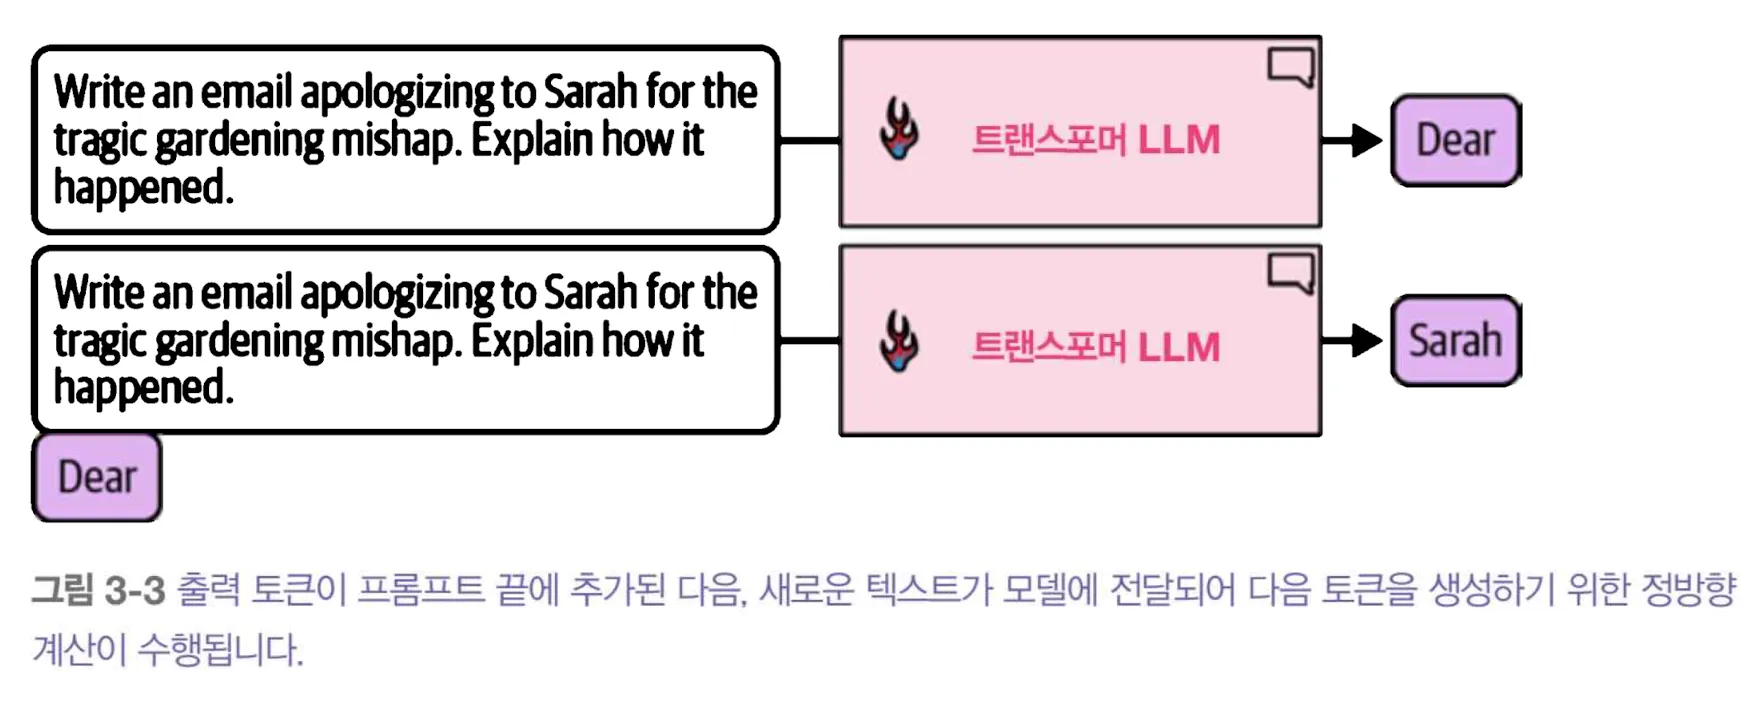
반복은 종료 토큰이 나오거나 길이 제한 등 중단 조건에 도달하면 멈춘다. 예제의 50토큰 결과가 문장 중간에서 끝난 이유도 길이 상한 때문이다. 상한을 500으로 늘려도 반드시 완결된 이메일이 되는 것은 아니다. 종료 토큰을 먼저 내거나, 반대로 500토큰에 걸려 중간에서 잘릴 수 있다.
[LLM으로 텍스트를 생성할 때 LLM 내부에서 생성된 텍스트 결과]
prompt = "Write an email apologizing to Sarah for the tragic gardening mishap. Explain how it happened."

output = generator(prompt)

print(output[0]['generated_text'])
[출력 결과]
Dear Sarah,

I hope this message finds you well. I am writing to express my deepest apologies for the unfortunate incident that occurred in
이 예시에서는 인사말부터 쓰기 시작했고 max_new_tokens=50에 도달해 중간에 멈춘 것으로 볼 수 있다. 50은 문자나 단어가 아닌 새 토큰의 수다. 다음의 긴 출력은 한 번의 실행 예시이며, 라이브러리·모델 버전과 생성 설정이 달라지면 문장도 달라진다. 이메일 안의 구체적인 사건과 사과 방법은 프롬프트에 없던 내용이므로 사실로 취급해서는 안 된다.
max_new_tokens을 500으로 변경했을 때
from transformers import AutoModelForCausalLM, AutoTokenizer, pipeline
# 모델명
model_name = "microsoft/Phi-3-mini-4k-instruct"

# 모델 로드
model = AutoModelForCausalLM.from_pretrained(
    model_name,
    device_map="mps",
    dtype="auto",
)
#토크나이저 로드
tokenizer = AutoTokenizer.from_pretrained(model_name)

# 파이프라인 객체 생성
generator = pipeline(
    "text-generation",
    model=model,
    tokenizer=tokenizer,
    return_full_text=False,
    max_new_tokens=500,
    do_sample=False
)

prompt = "Write an email apologizing to Sarah for the tragic gardening mishap. Explain how it happened."

output = generator(prompt)

print(output[0]['generated_text'])
[결과]
Dear Sarah,

I hope this message finds you well. I am writing to express my deepest apologies for the unfortunate incident that occurred in your garden. It was a tragic mishap that I never intended to happen.

As you know, I have been helping you with your gardening projects for quite some time now. I take great pride in my work and always strive to ensure that everything goes smoothly. However, on the day of the incident, I made a grave mistake that led to the damage of your beautiful garden.

The incident happened when I was using a new type of fertilizer that I had recently purchased. I had read about its benefits and thought it would be a great addition to your garden. Unfortunately, I did not realize that it contained chemicals that were harmful to certain plants. As a result, several of your plants suffered irreversible damage.

I am truly sorry for the pain and disappointment this has caused you. I understand how much time and effort you put into maintaining your garden, and I can only imagine the heartbreak you must be feeling right now. Please know that I am taking full responsibility for my actions and will do everything in my power to make things right.

To prevent such incidents from happening in the future, I have taken several steps. Firstly, I have thoroughly researched all the products I use in your garden to ensure they are safe for your plants. Secondly, I have consulted with a professional gardener to gain more knowledge about the best practices for maintaining a healthy garden. Lastly, I have enrolled myself in a gardening course to further improve my skills and knowledge.

I am committed to restoring your garden to its former glory and will work tirelessly to achieve this goal. I will personally oversee the entire process and ensure that every step is taken with utmost care and attention.

Once again, I sincerely apologize for the damage caused to your garden. I understand that words cannot undo the harm that has been done, but I hope that you can find it in your heart to forgive me. I am grateful for your understanding and patience during this difficult time.

Please feel free to reach out to me if you have any questions or concerns. I am more
긴 답변을 생성하면 새 토큰마다 정방향 계산이 필요하므로 짧은 답변보다 시간이 걸린다. 입력 문서가 길 때는 첫 토큰까지의 시간도 늘어난다. 속도를 비교할 때는 같은 프롬프트와 생성 길이, 캐시 설정, 장치에서 측정해야 한다.
2. 정방향 계산의 구성 요소
정방향 계산을 한 줄로 적으면 토큰 ID → 임베딩 → 위치 정보와 트랜스포머 블록 → 마지막 위치의 은닉 벡터 → LM 헤드의 로짓 → 토큰 선택이다. 토크나이저는 신경망 바깥에서 ID를 준비한다. LM 헤드는 마지막 위치의 은닉 벡터를 어휘 크기만큼의 점수로 투영한다. 이 점수에 softmax를 적용하면 후보 토큰의 확률 분포를 얻는다.
[5만개의 토큰으로 구성된 어휘사전과 모델에 있는 토큰 임베딩 표현]
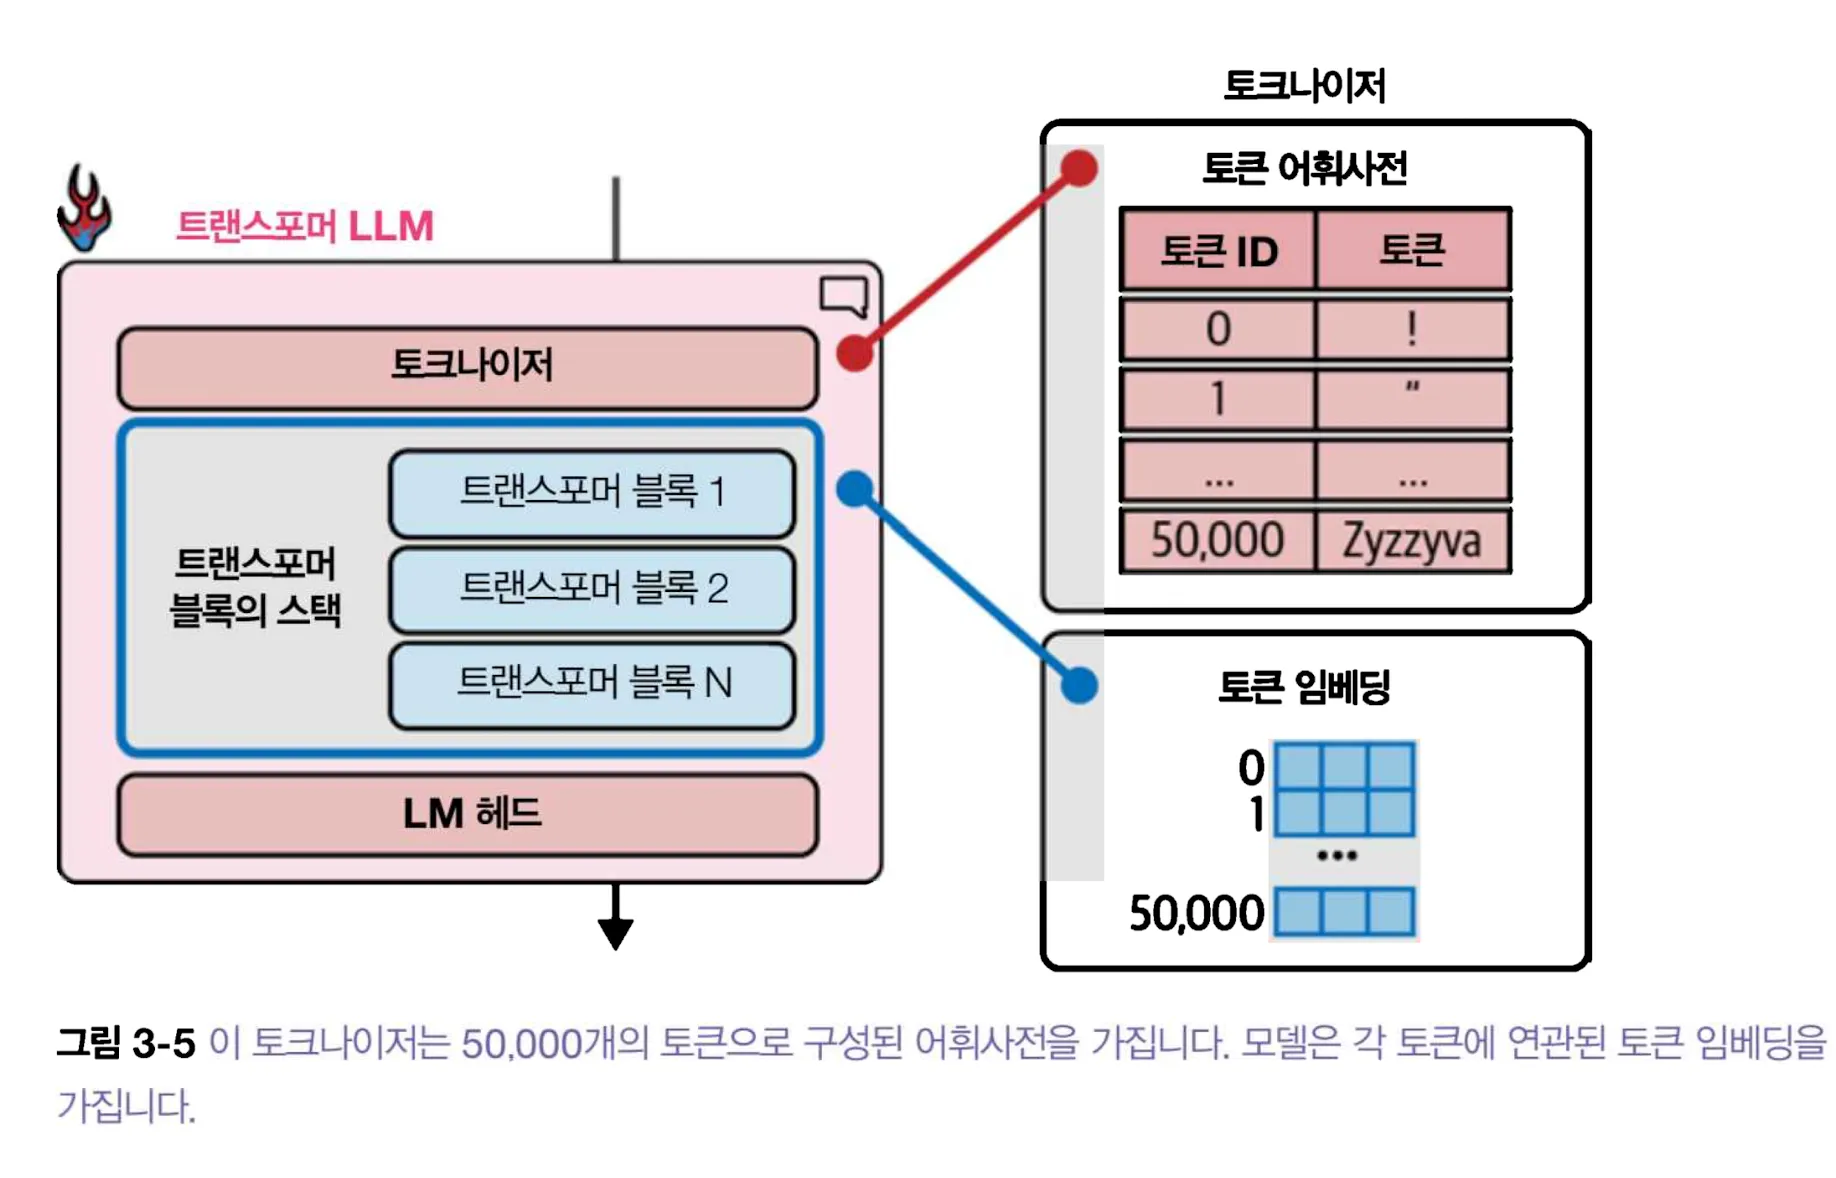
어휘가 5만 개라면 한 위치의 로짓도 대략 5만 개다. 그림의 5만은 원리를 보여 주는 예시이며 실제 어휘 크기는 모델 설정마다 다르다. 토큰 하나를 확정한 뒤에는 다시 같은 파이프라인을 통과한다.
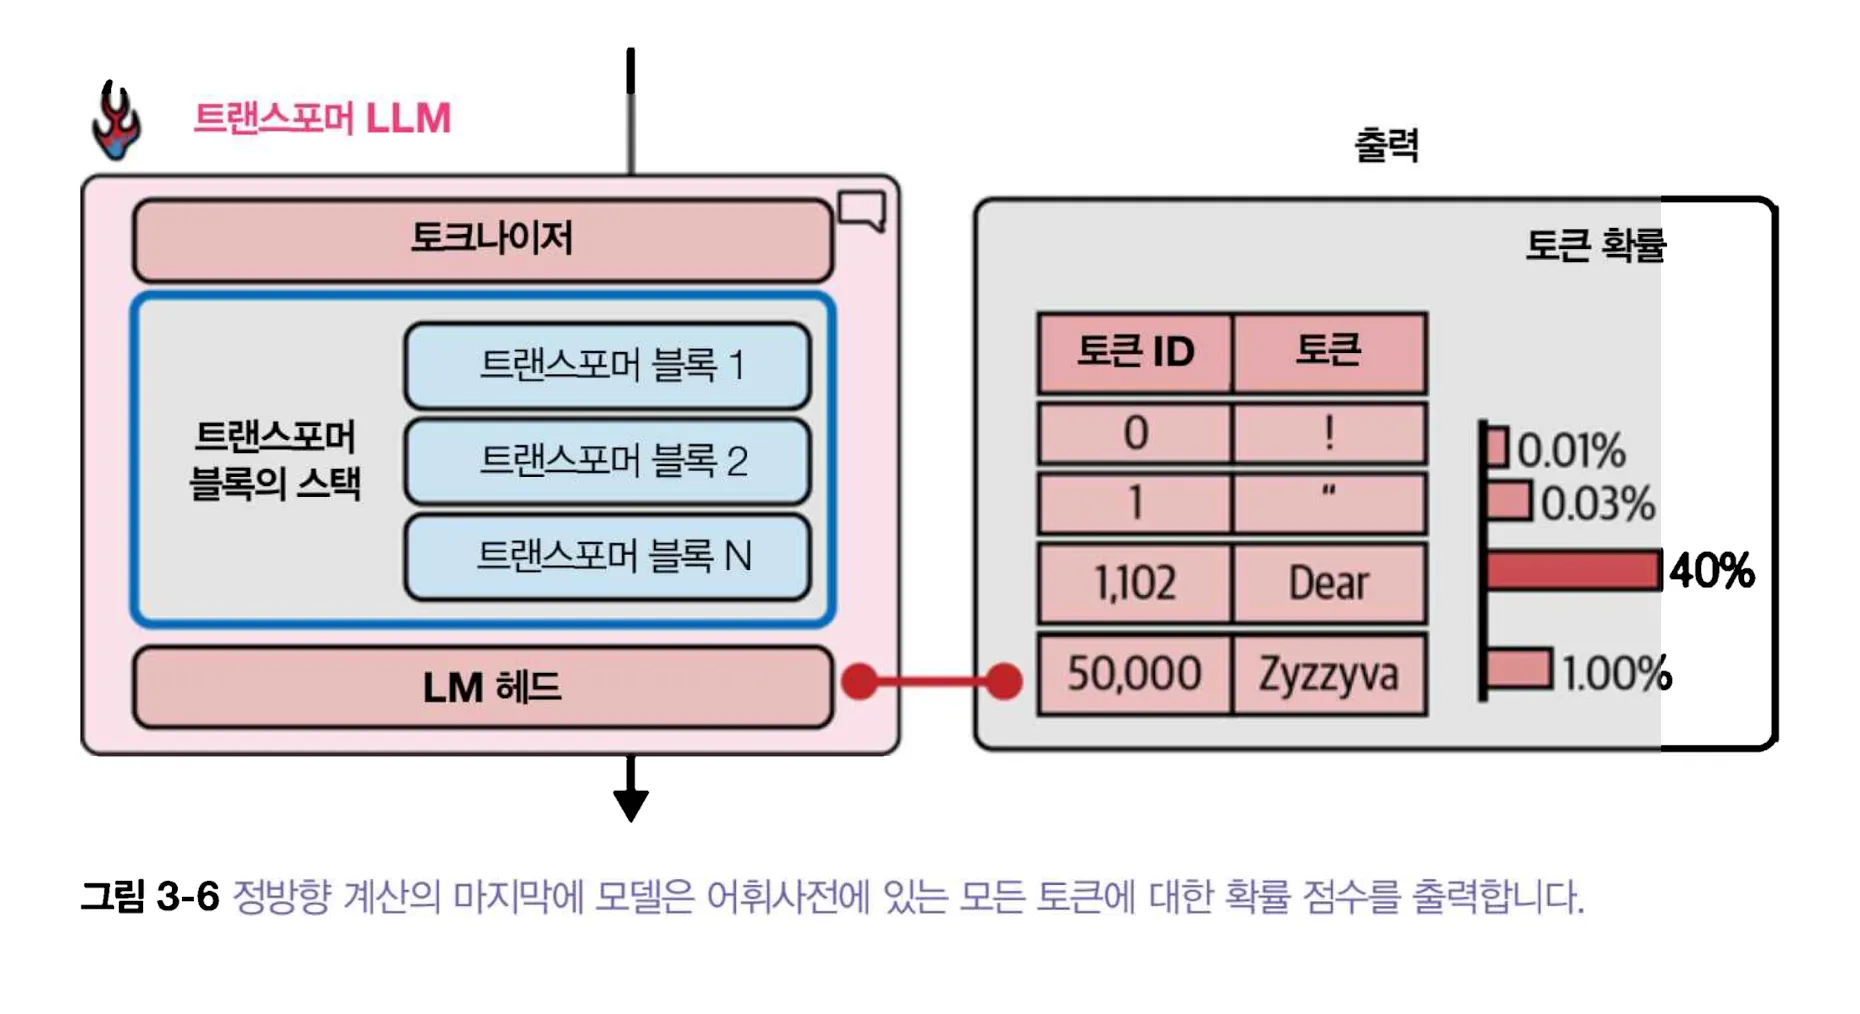
3. 확률 분포로부터 하나의 토큰 선택하기(샘플링/디코딩)
모델의 직접 출력은 토큰별 로짓이다. softmax를 통과시키면 합이 1인 확률 분포로 읽을 수 있다. 아주 작은 예로 다음 토큰 후보가 비, 눈, 해이고 확률이 0.6, 0.3, 0.1이라면 탐욕적 선택은 항상 비를 택한다. 샘플링은 이 분포를 따라 다른 후보도 뽑을 수 있다. 실제 어휘는 이보다 훨씬 크다.
확률 분포에서 하나의 토큰을 선택하는 방법을 디코딩 전략(Decoding strategy)이라 부른다.
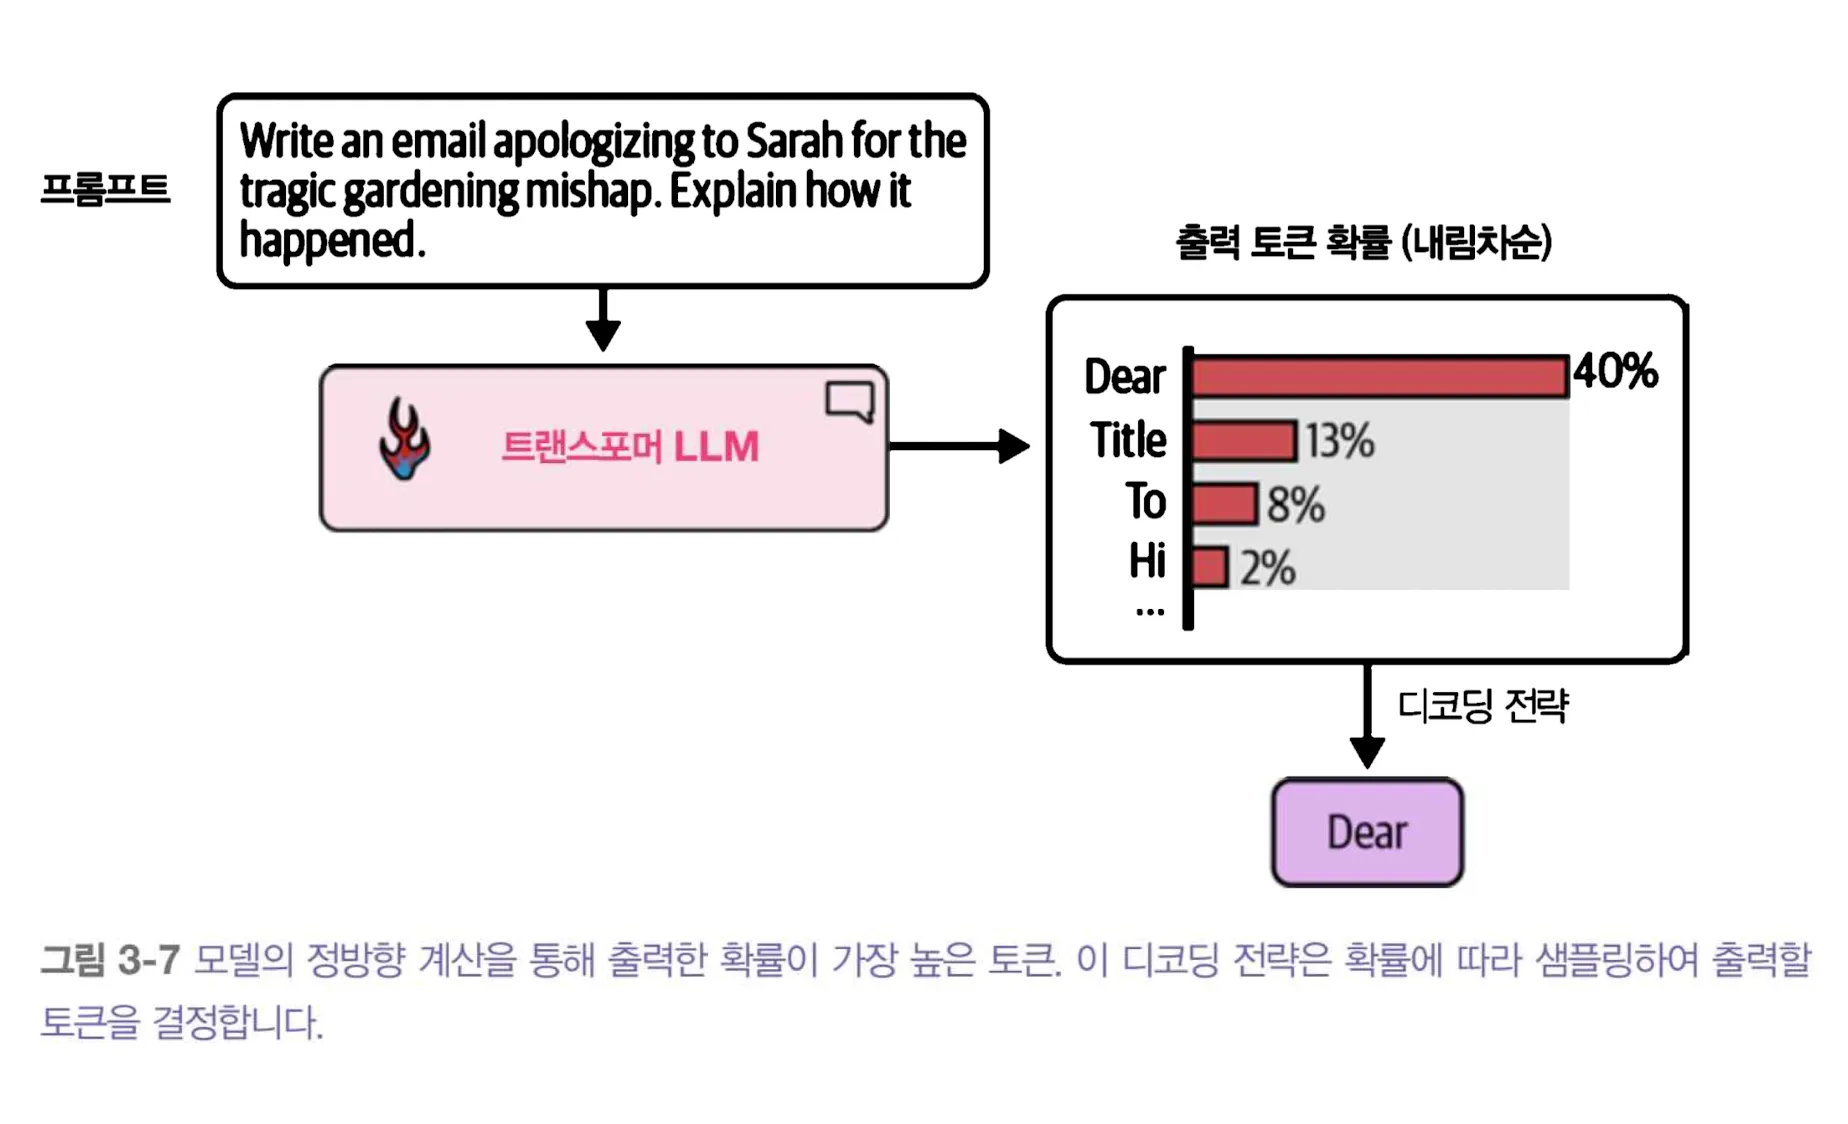
탐욕적 디코딩은 매 단계 가장 큰 점수를 택한다. 재현성이 필요한 실험에 유용하지만 한 단계의 최선이 문장 전체의 최선이라는 보장은 없다. do_sample=True는 확률에 따라 선택한다. temperature는 분포의 뾰족함을, top_p는 누적 확률로 남길 후보 집합을 조절한다. 창작에서는 다양한 후보를 살릴 수 있지만 분류 결과처럼 출력 형식을 엄격하게 지켜야 한다면 무작위성이 오히려 방해가 될 수 있다. 생성 방법은 Hugging Face 생성 문서를 참고했다.
4. 병렬 토큰 처리와 문맥 크기
트랜스포머의 인코더나 디코더 훈련에서는 이미 주어진 토큰 위치를 여러 개 병렬 계산할 수 있다. 생성 시에는 다음 출력 토큰이 아직 없으므로 출력 위치 간 병렬화에는 제약이 있다. “트랜스포머는 항상 모든 토큰을 한 번에 생성한다”는 뜻은 아니다.
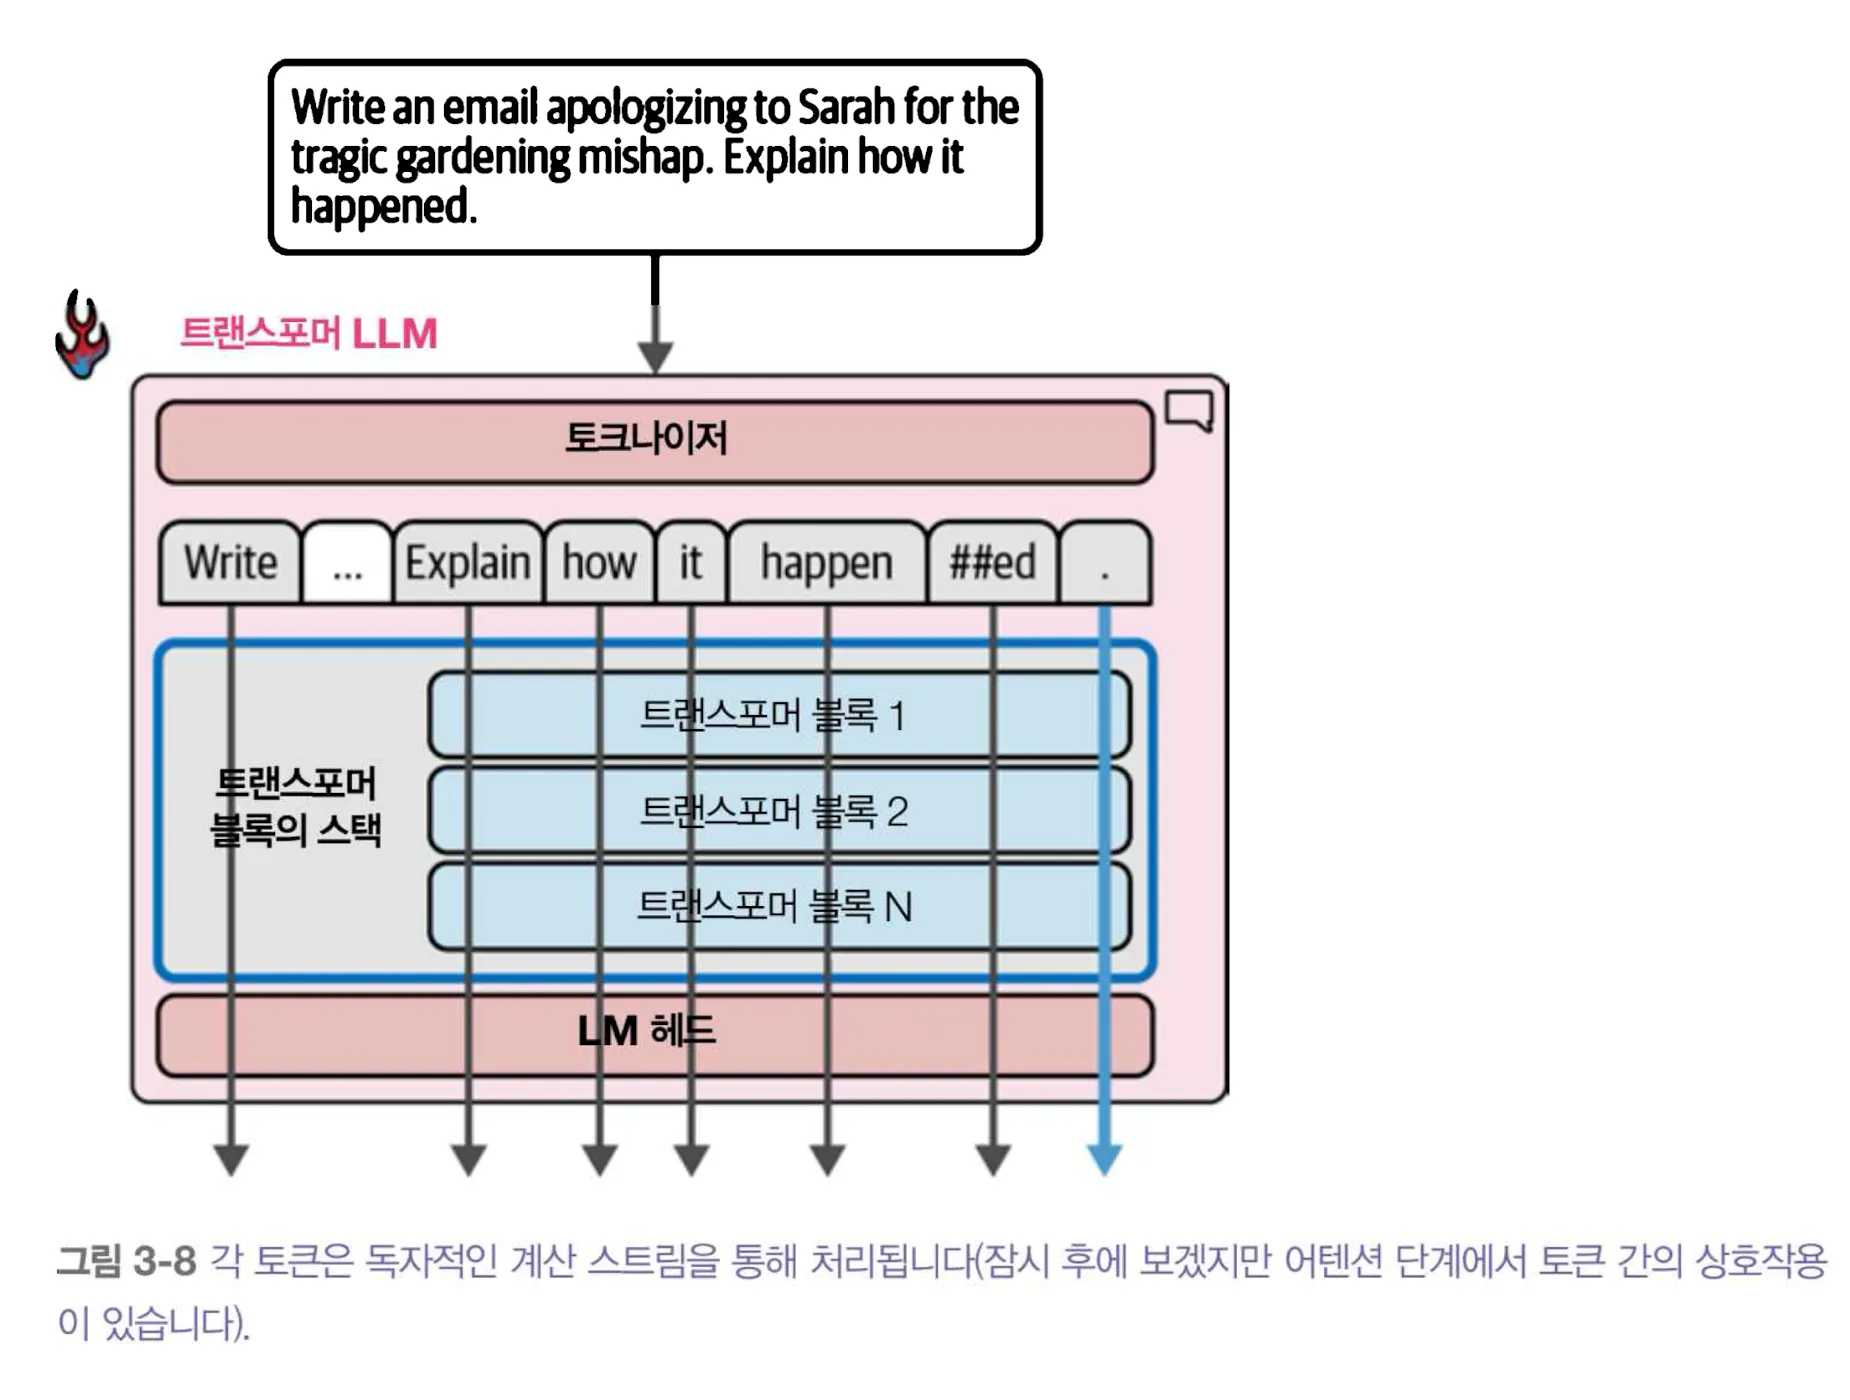
트랜스포머 모델은 동시에 처리할 수 있는 토큰 수가 제한되고, 이걸 모델의 문맥 길이 라고 부른다.
문맥 길이가 약 4K인 모델이라면 프롬프트와 생성 토큰이 그 범위에 맞아야 한다. 4K는 글자 4천 개가 아니며 토크나이저로 센 ID 수다. 긴 입력에서 문맥이 잘리면 초반의 중요한 지시가 사라질 수 있으므로 생성 전에 입력 토큰 길이를 확인한다.
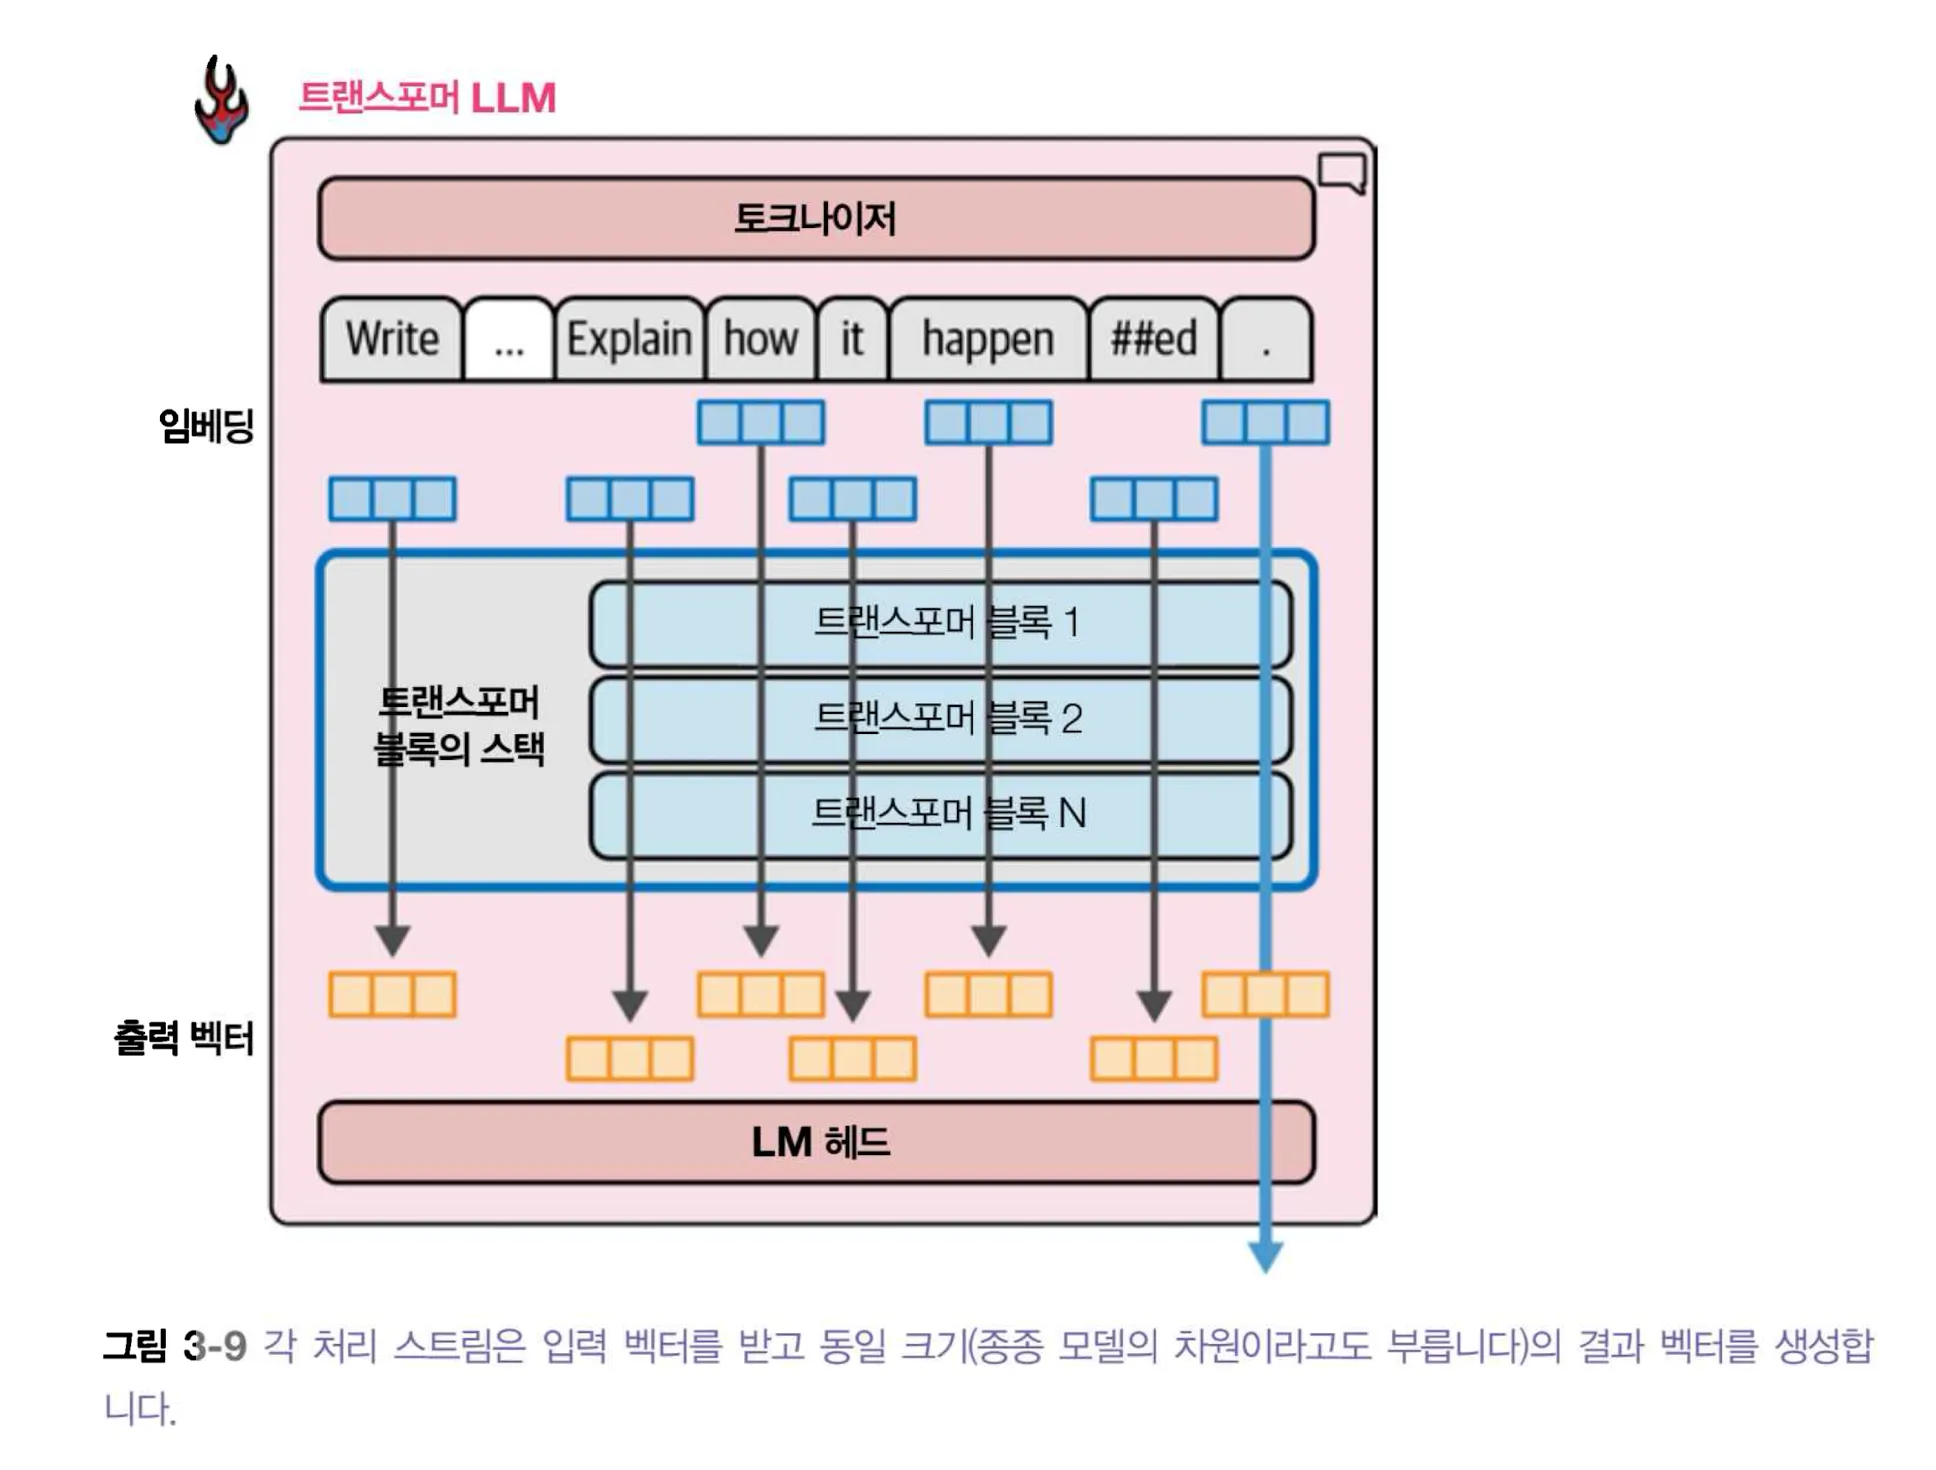
텍스트 생성의 경우
- 현재 다음 토큰을 고를 때는 마지막 위치의 최종 은닉 벡터를 LM 헤드에 보낸다.
이때 마지막 이전 위치의 최종 출력 로짓은 다음 토큰 선택에 직접 쓰지 않는다. 그렇다고 이전 위치의 계산이 불필요한 것은 아니다.
- 이전 위치의 중간 표현은 마지막 위치의 어텐션 계산에 참여한다. 따라서 이전 위치의 LM 헤드 결과를 쓰지 않는다고 해서 그 위치의 블록 계산까지 무의미한 것은 아니다.
5. 키와 값을 캐싱하여 생성 속도 높이기
첫 출력 토큰을 계산할 때 모델은 프롬프트 위치들의 키(K)와 값(V)을 만든다. 다음 토큰을 만들 때 과거 위치의 K·V는 인과적 마스크 아래에서 변하지 않으므로 보관해 다시 사용할 수 있다. 새로운 위치의 쿼리(Q)가 캐시에 있는 K와 비교하고, 가중치로 V를 모은다. 이를 KV 캐시라고 한다. 과거 위치의 K·V 계산을 줄여 생성 지연을 낮추지만, 생성 길이와 배치가 커질수록 캐시 메모리는 늘어난다.
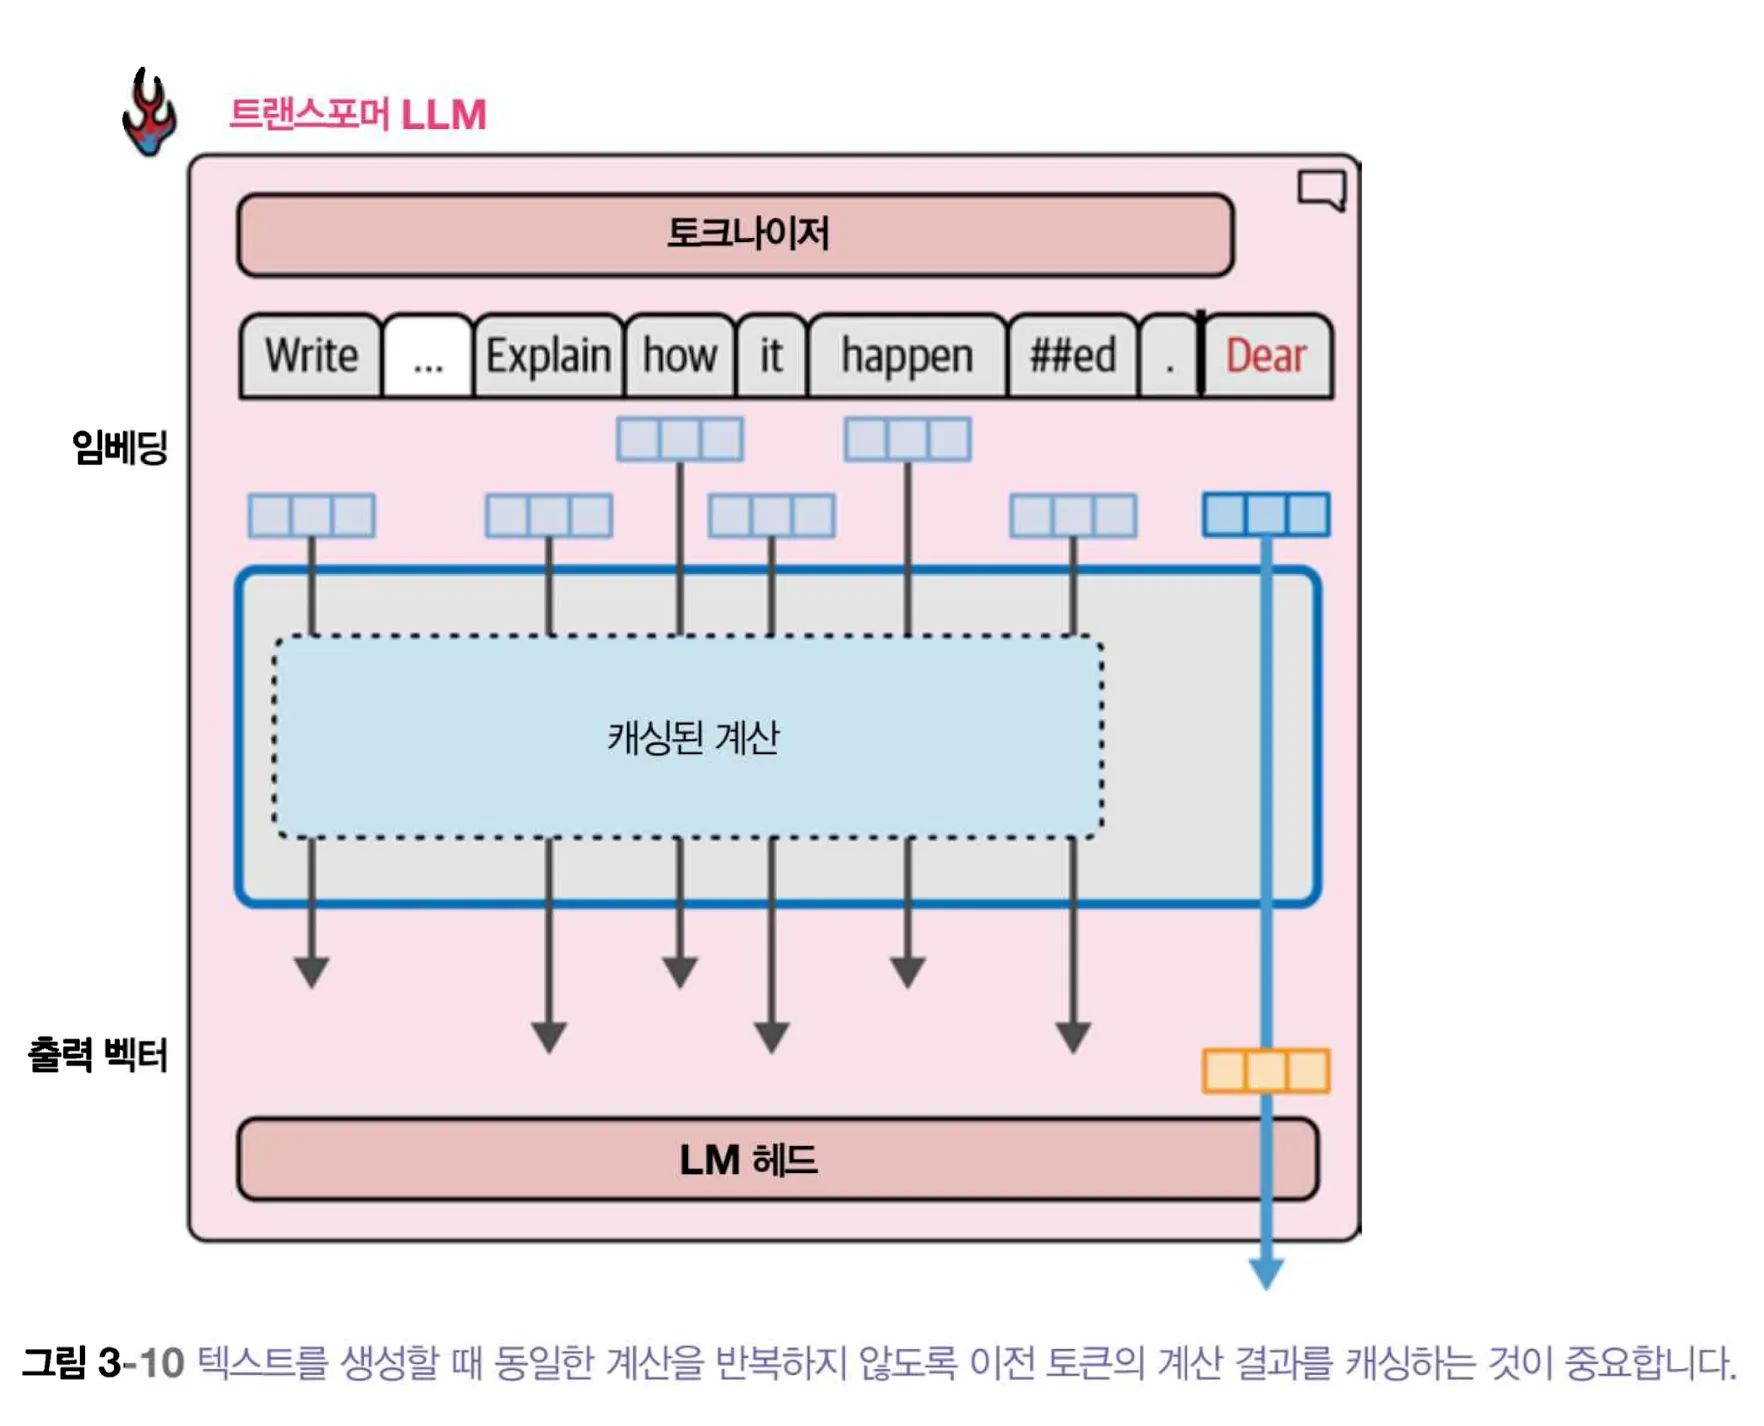
Hugging Face의 KV 캐시 가이드에 따르면 generate(use_cache=False)로 캐시를 끌 수 있다. 캐시 이점은 프롬프트 길이와 새 토큰 수, 메모리 상태에 따라 달라진다. 아래 코드는 같은 조건에서 캐시 설정만 바꾸어 벽시계 시간을 비교한다.
import time

prompt = "Write an email apologizing to Sarah for the gardening mishap."

for use_cache in (True, False):
    start = time.perf_counter()
    # 위에서 로드한 model, tokenizer를 그대로 사용한다.
    inputs = tokenizer(prompt, return_tensors="pt").to(model.device)
    for _ in range(5):
        model.generate(**inputs, max_new_tokens=100, do_sample=False,
                       use_cache=use_cache)
    elapsed = time.perf_counter() - start
    print(f"use_cache={use_cache}: {elapsed:.2f}초")
기존 실행에서 캐시를 켠 경우의 기록:
실행 시간: 19.380688190460205초기존 실행에서 캐시를 끈 경우의 기록:
실행 시간: 67.72738885879517초위 수치는 한 환경의 과거 기록이지 이 코드의 보장된 출력은 아니다. 첫 호출의 모델 준비 비용과 장치 상태가 영향을 줄 수 있다. MPS나 CUDA에서 정확한 측정이 필요하면 각 조건을 예열하고 장치를 동기화한 뒤 여러 번 반복해야 한다. 두 조건이 모두 같은 수의 토큰을 생성했는지도 확인해야 한다.
6. 트랜스포머 블록 내부
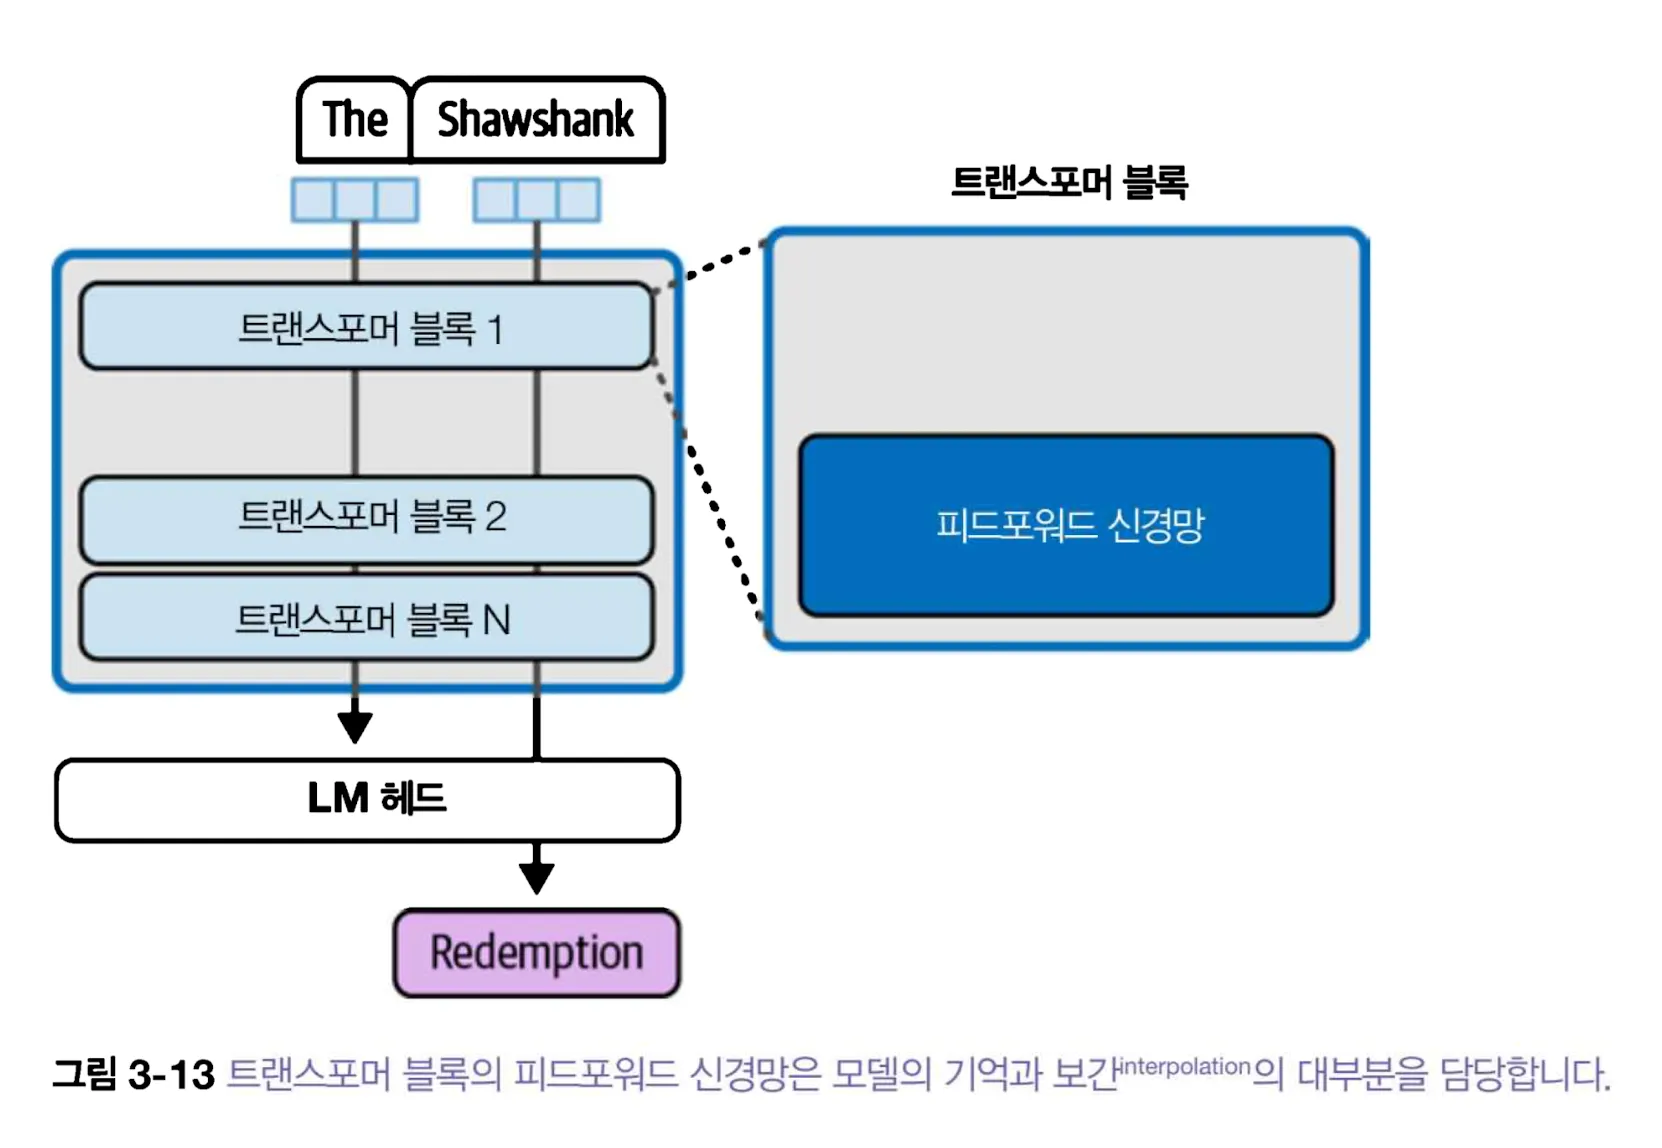
트랜스포머 LLM은 일련의 블록으로 구성되고, 각 블록의 출력이 다음 블록의 입력이 된다. 블록 안의 두 핵심 계산은 어텐션과 위치별 피드포워드 네트워크(FFN)다. 어텐션은 다른 위치에서 정보를 모으고, FFN은 모인 정보를 각 위치에서 비선형 변환한다. 둘을 한쪽만으로 대체할 수 있다고 생각하면 생성 흐름을 설명하기 어렵다.
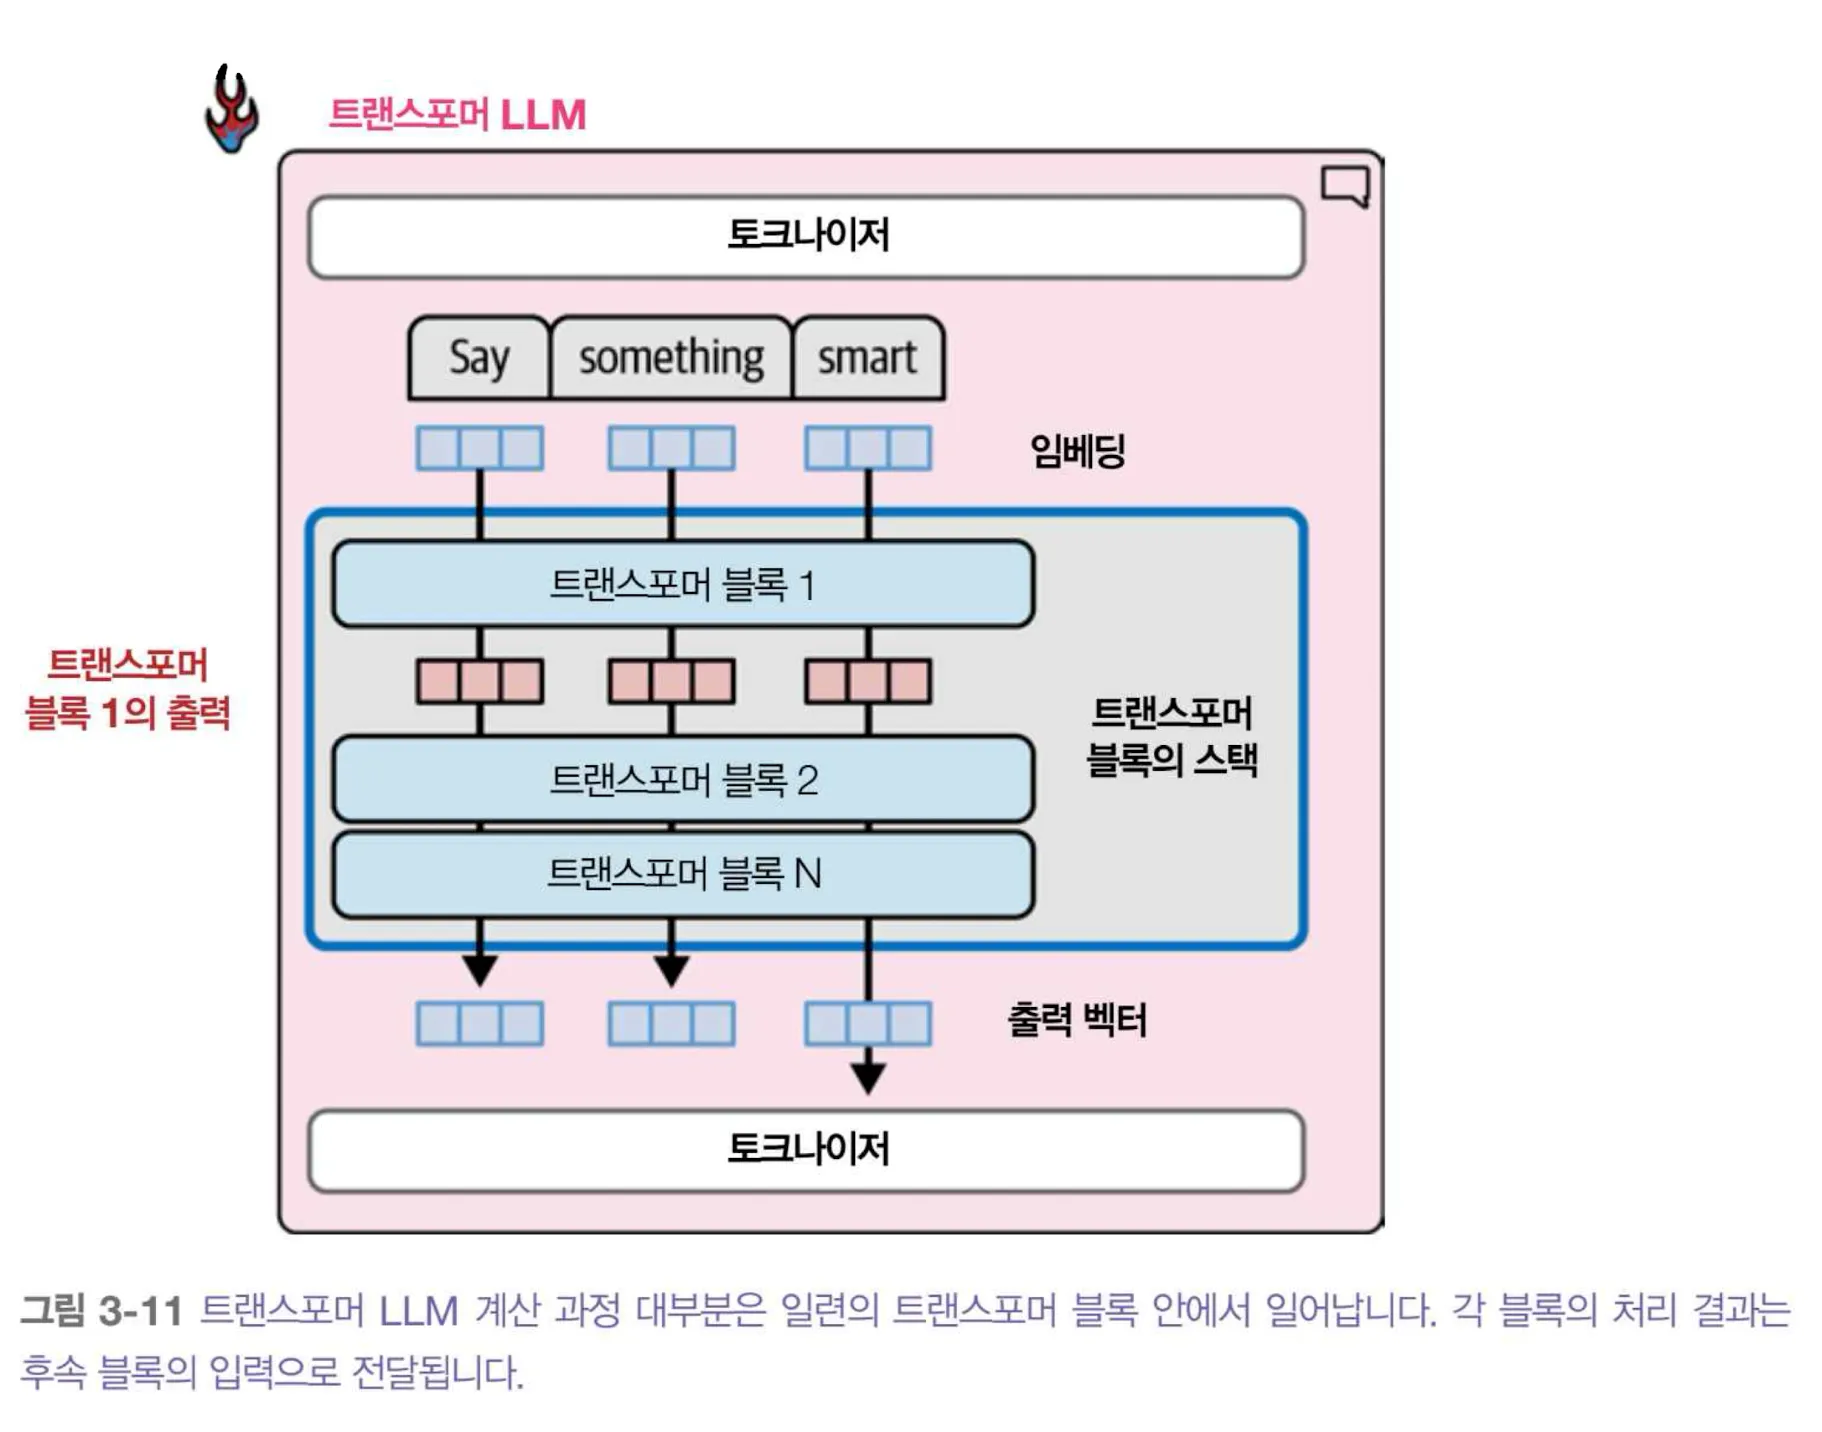
트랜스 포머 블록 내의 두 개의 구성요소
-
어텐션 층(Attention Layer) : 다른 입력 토큰과 위치에 대한 정보를 통합
-
피드포워드 층(Feedforward Layer) : 각 위치의 벡터를 같은 가중치로 독립적으로 변환
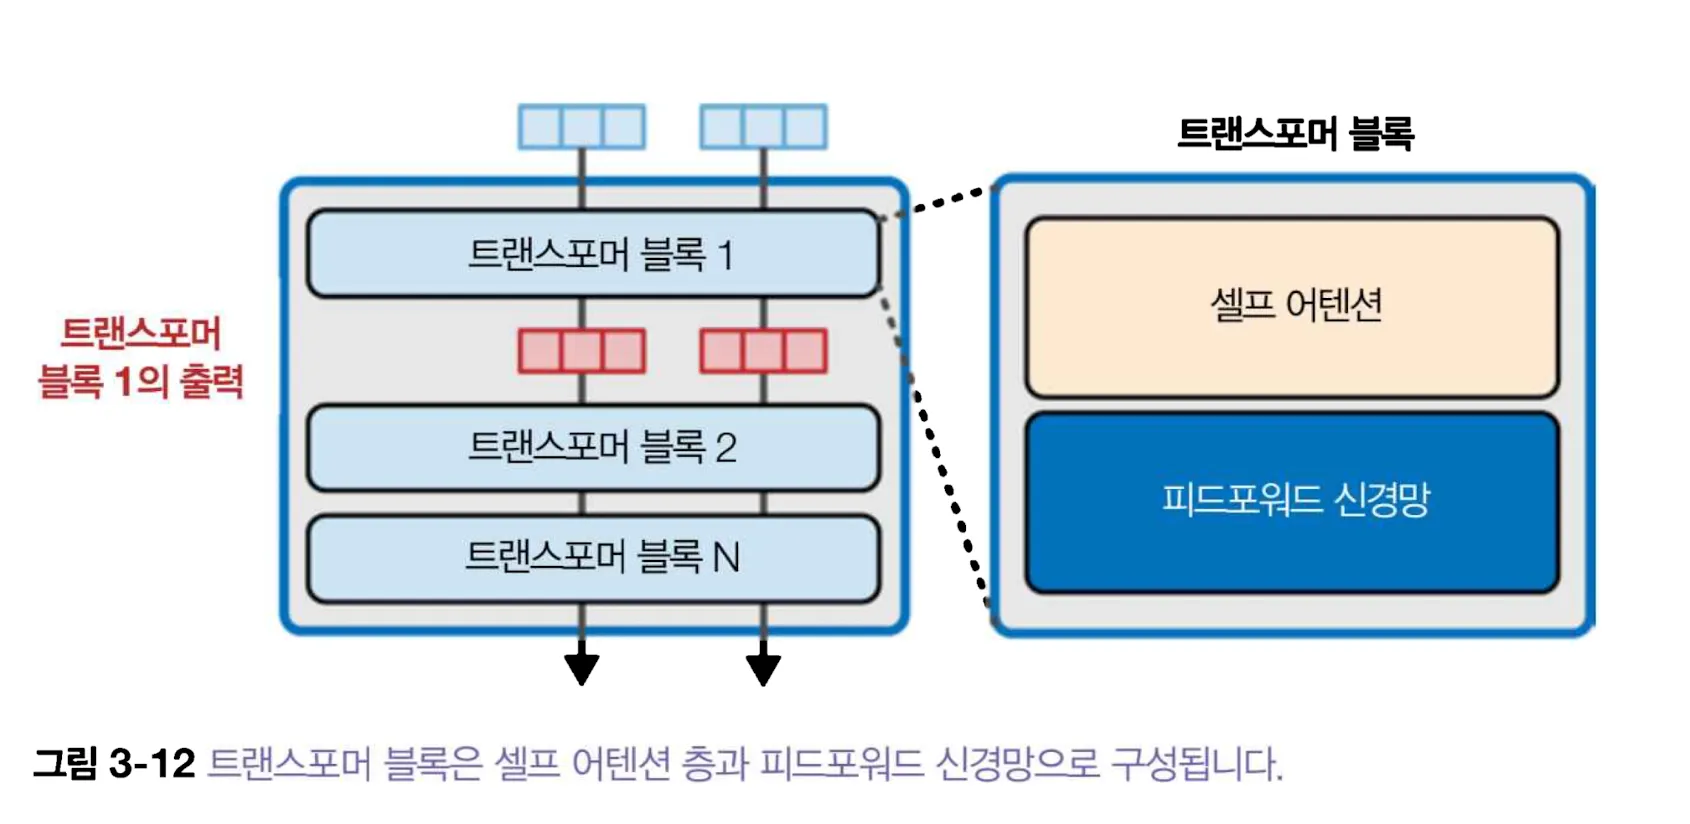
피드포워드 신경망
FFN은 보통 한 벡터를 더 큰 중간 차원으로 보낸 뒤 활성화 함수를 거쳐 다시 원래 차원으로 돌린다. 같은 FFN 가중치를 모든 토큰 위치에 적용하지만, 각 위치의 입력 벡터는 어텐션 이후 달라져 있다. 따라서 어텐션이 문맥을 가져오는 과정이라면 FFN은 그 문맥을 포함한 현재 벡터를 가공하는 과정이다.
훈련된 가중치에는 특정 문구나 연관 관계를 이어 쓰는 패턴도 반영될 수 있다. 다만 FFN 전체를 사실 저장소나 데이터베이스로 보기는 어렵다. 모델의 출력은 어텐션, FFN, 입력 문맥, 학습 분포가 함께 만든 결과이며 특정 사실을 언제나 정확히 복원한다는 보장은 없다.
[예시]
The Shawshank 뒤에 Redemption이 이어질 가능성이 높다면, 자주 본 제목이라는 학습 신호가 작용했을 수 있다. 그러나 모델의 실제 선택은 토큰화 결과와 앞 문맥, 디코딩 전략에 달린다. 아래 그림은 FFN이 특정 패턴의 점수를 높이는 직관을 보여 주는 것으로, 해당 문자열이 FFN 한 곳에 그대로 저장되었다는 증거는 아니다.
어텐션 층
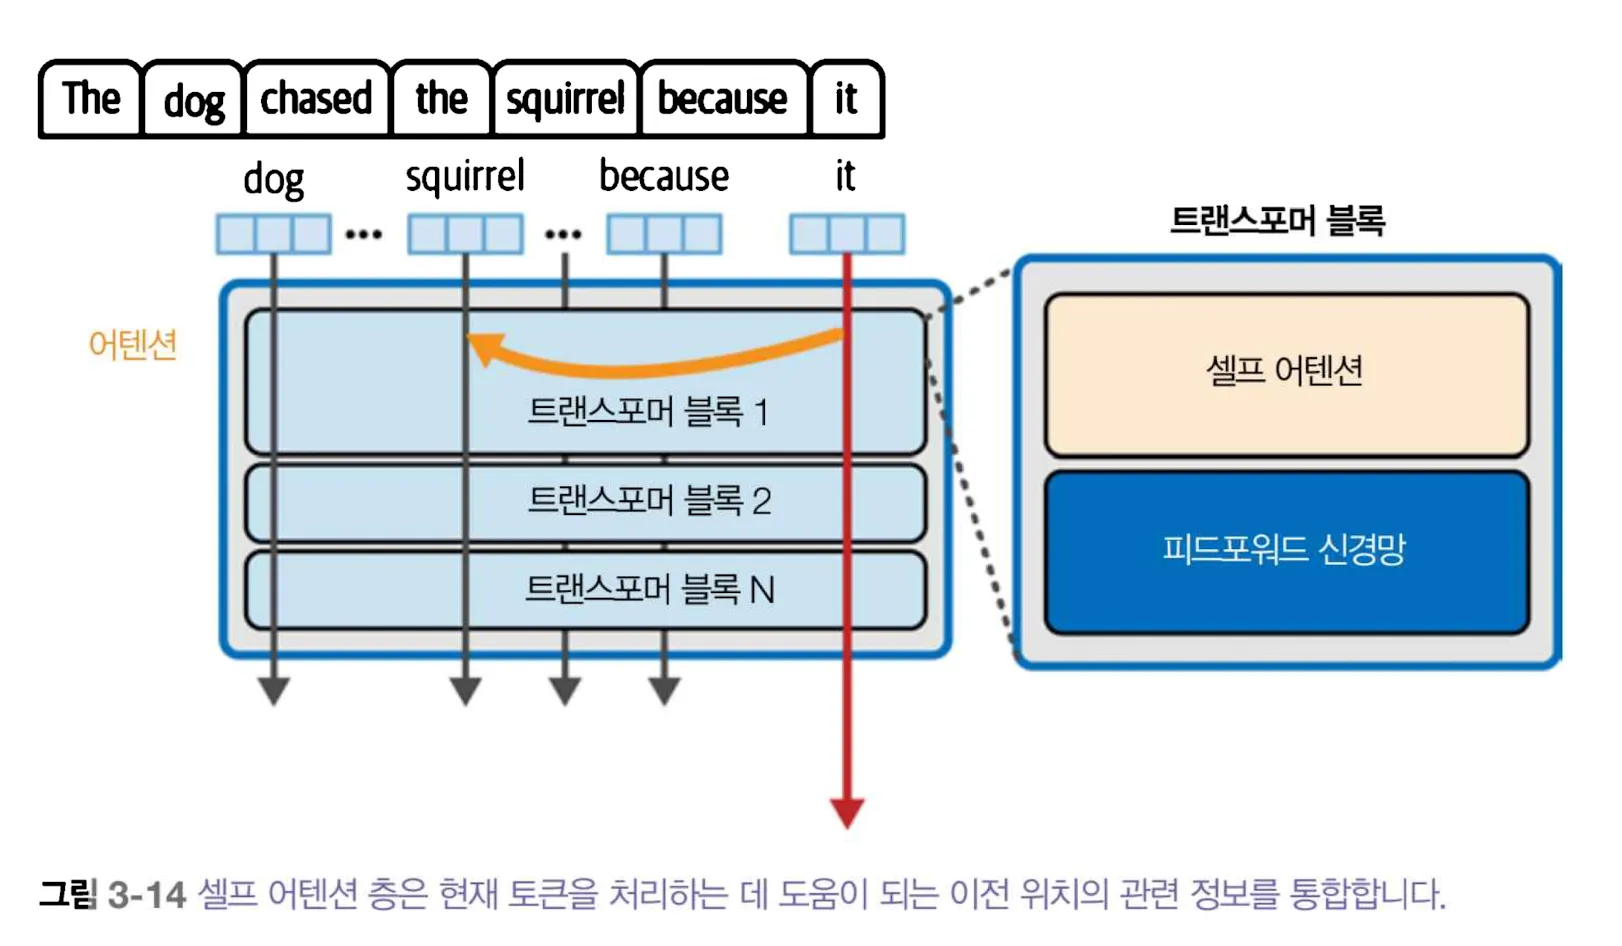
어텐션은 모델이 특정 토큰을 처리할 때 문맥을 통합해주는 메커니즘이다.
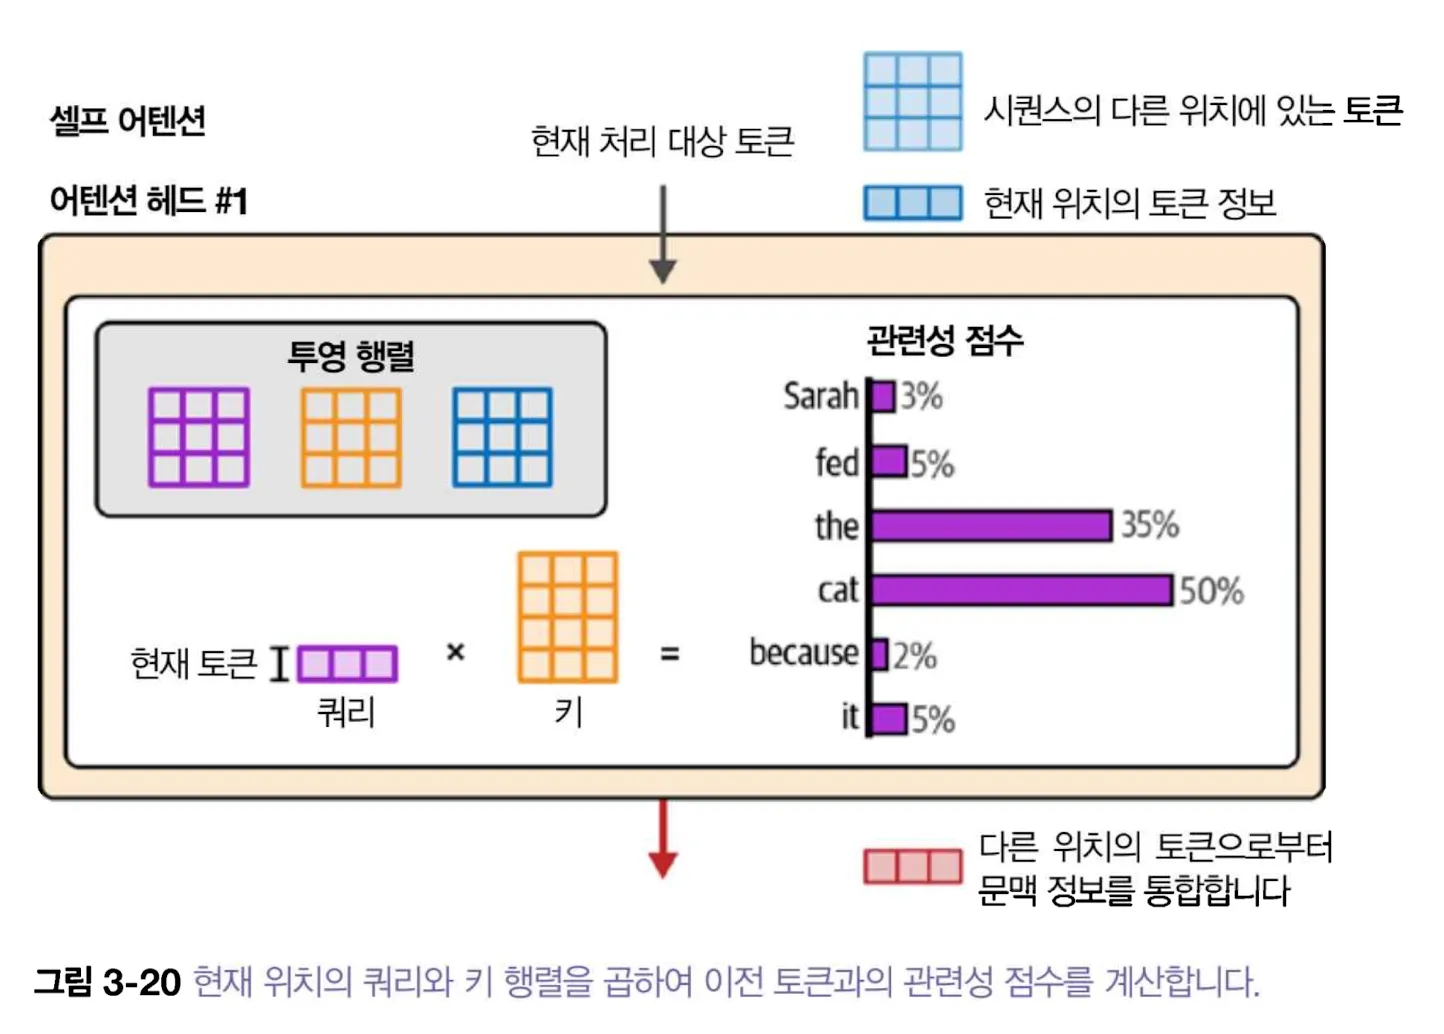
원본 인코더-디코더 트랜스포머에는 디코더가 인코더 출력을 참조하는 교차 어텐션이 있다. 이 글의 Phi-3처럼 디코더만 사용하는 모델에서는 인과적 셀프 어텐션으로 이전 입력·출력 위치를 참조한다. 두 구조를 혼동하지 말자. 예를 들어 Sarah fed the cat because it 다음을 예측할 때, 마지막 위치의 표현이 앞쪽 cat을 비롯한 토큰에서 필요한 단서를 모은다.
훈련된 트랜스포머 LLM에서는 어텐션 메커니즘이 이런 결정을 내린다.
- 어텐션은 문맥 정보를 ‘it’ 토큰의 표현에 추가
- 모델은 훈련 데이터셋에서 보고 배운 패턴을 기반으로 수행
- 이전 문장에 더 많은 단서가 있을 수 도 있음
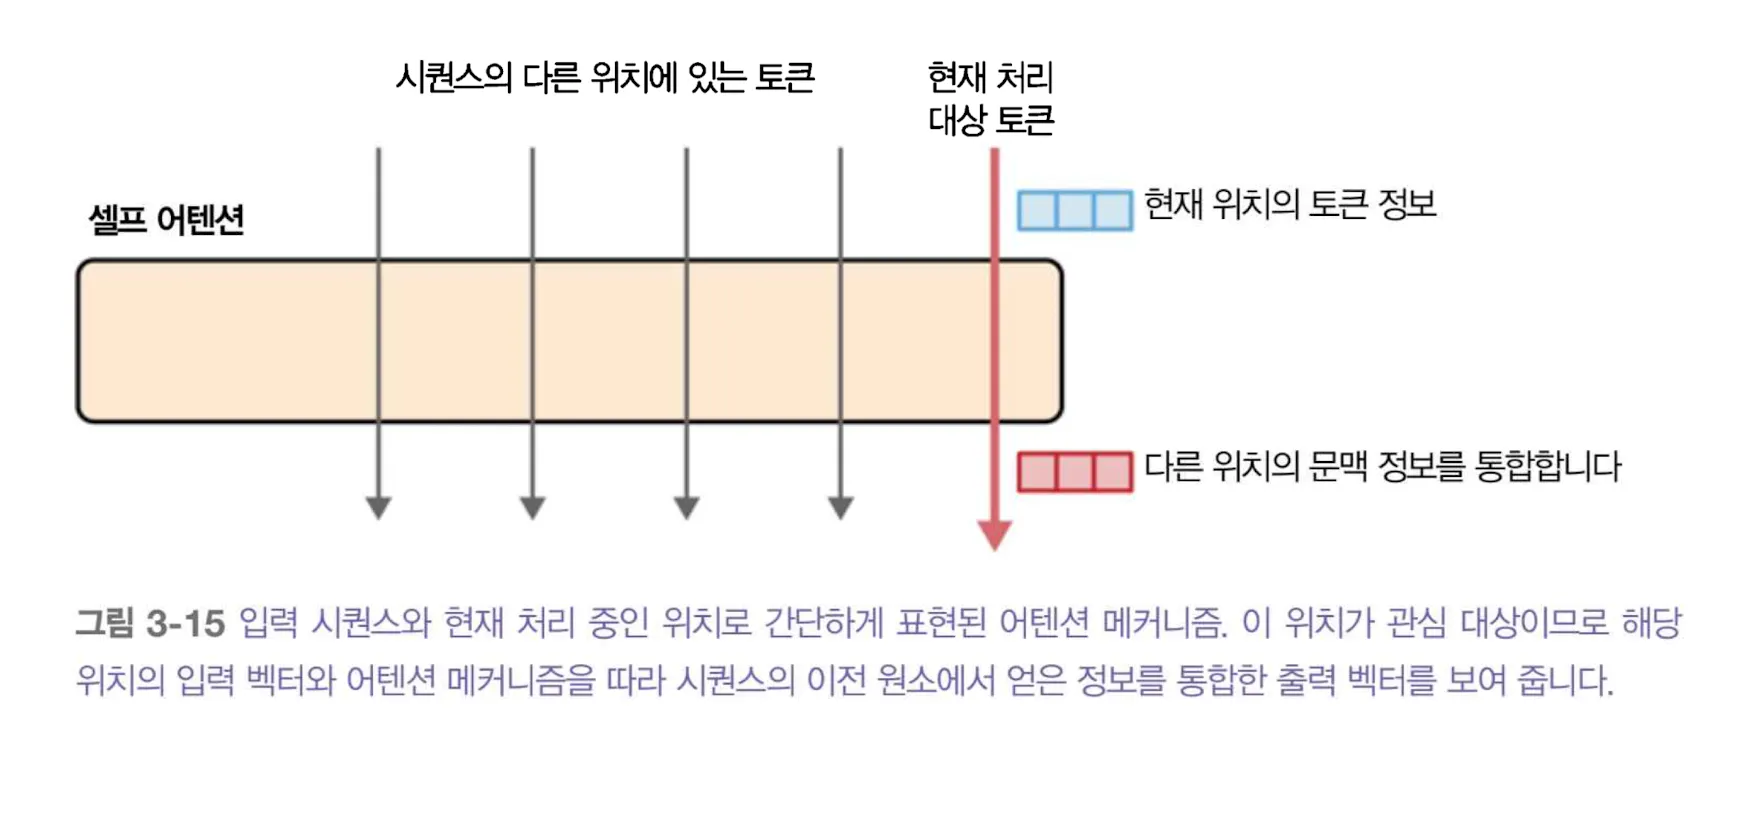
어텐션 메커니즘
문맥에서 관련된 정보를 이 위치의 출력 벡터에 통합
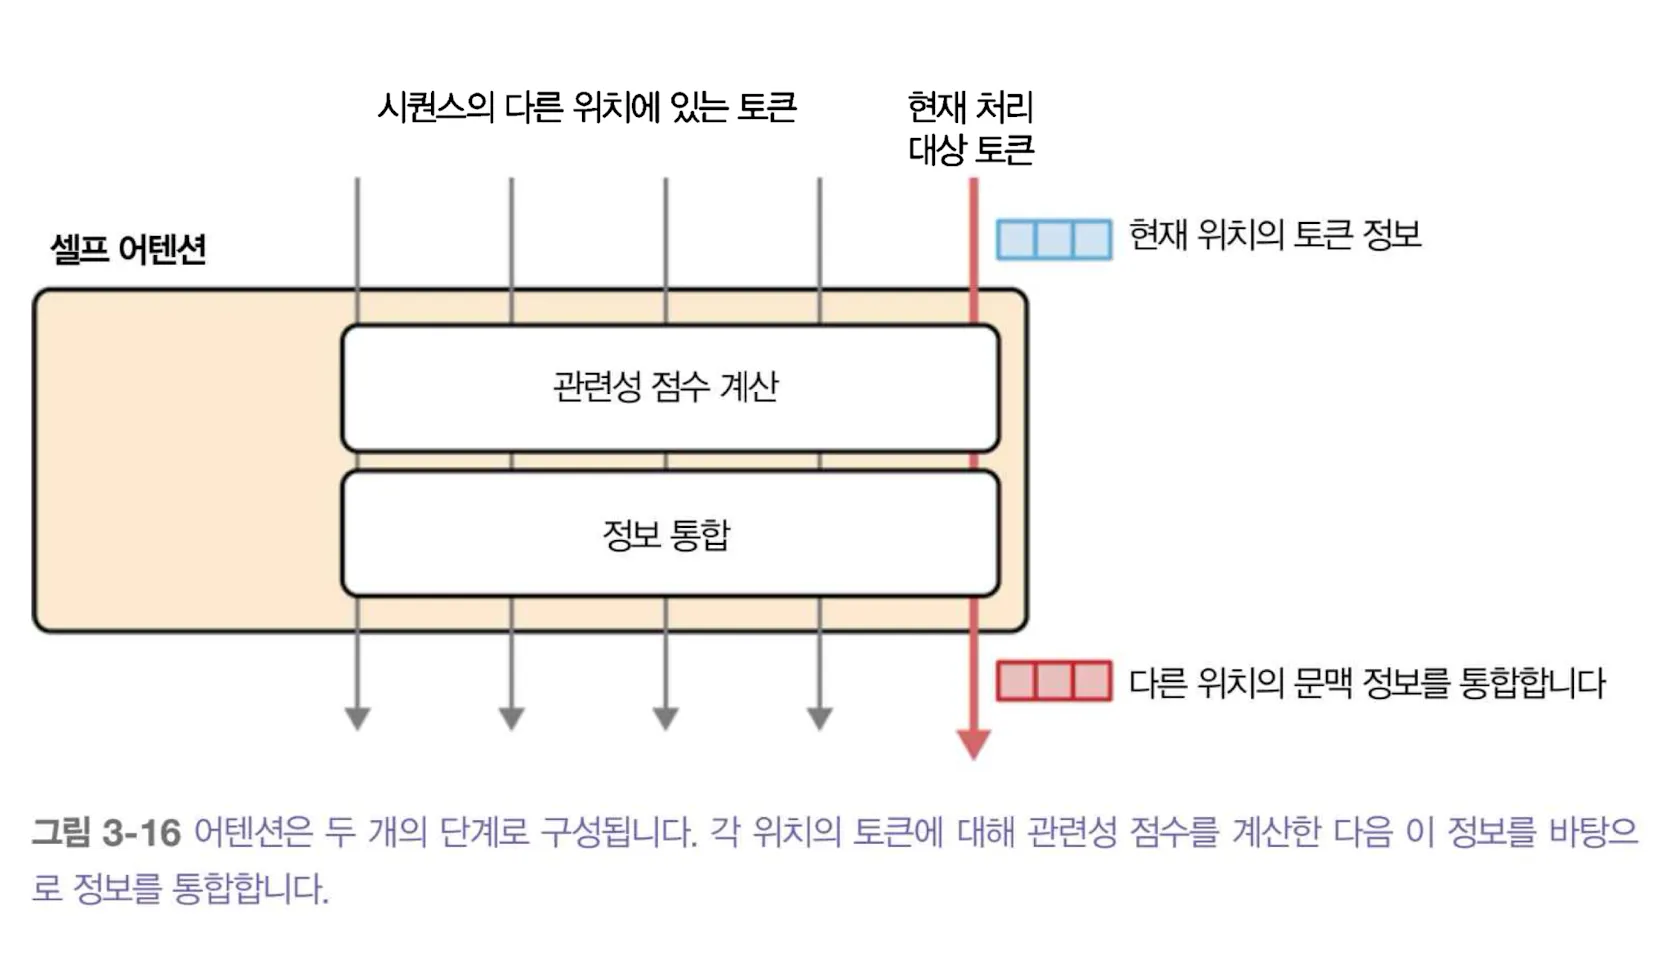
- 이전 토큰이 현재 처리 대상 토큰에 얼마나 관련이 있는지 점수를 매김
- 이 점수를 사용해 다양한 위치의 토큰에서 얻은 정보를 하나의 출력 벡터에 통합
하나의 어텐션 헤드에는 자체 투영 가중치가 있다. 여러 헤드를 병렬로 계산하면 각 헤드가 서로 다른 표현 공간에서 관계를 학습할 여지가 생긴다. 특정 헤드가 언제나 특정 문법만 담당한다고 고정해서 해석해서는 안 된다.
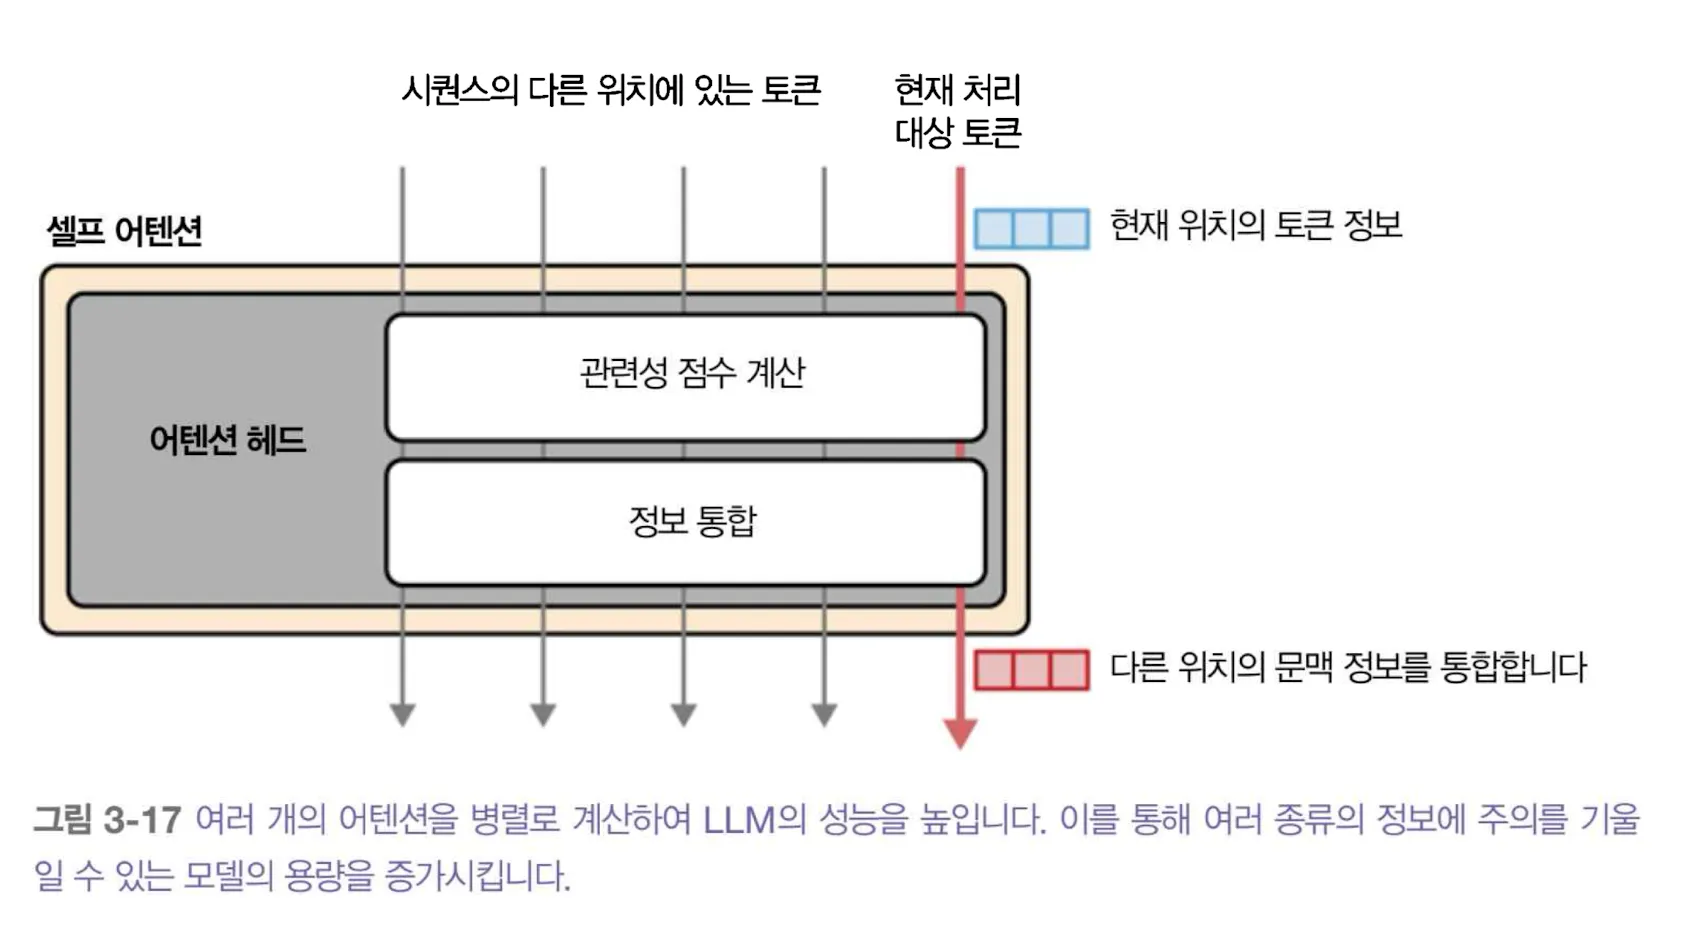
어텐션 계산과정
- (생성 LLM의) 어텐션 층은 한 위치의 토큰에 대한 어텐션을 처리
- 입력 층
- 현재 위치 또는 토큰에 대한 벡터 표현
- 이전 토큰에 대한 벡터 표현
- 이전 토큰에서 관련 정보를 통합 후 현재 위치에 대한 새로운 표현을 생성하는 것이 목표
- 예를 들어
Sarah fed the cat because it의it위치를 처리할 때cat이 지시 대상일 수 있다. 다만 앞 문맥이 달라지면it의 지시 대상도 달라질 수 있다.
- 예를 들어
- 훈련 과정을 통해 이 계산에 활용되는 세 개의 투영 행렬이(projection metrix) 만들어진다.
- 쿼리(Query) 투영 행렬
- 키(Key) 투영 행렬
- 값(Value) 투영 행렬
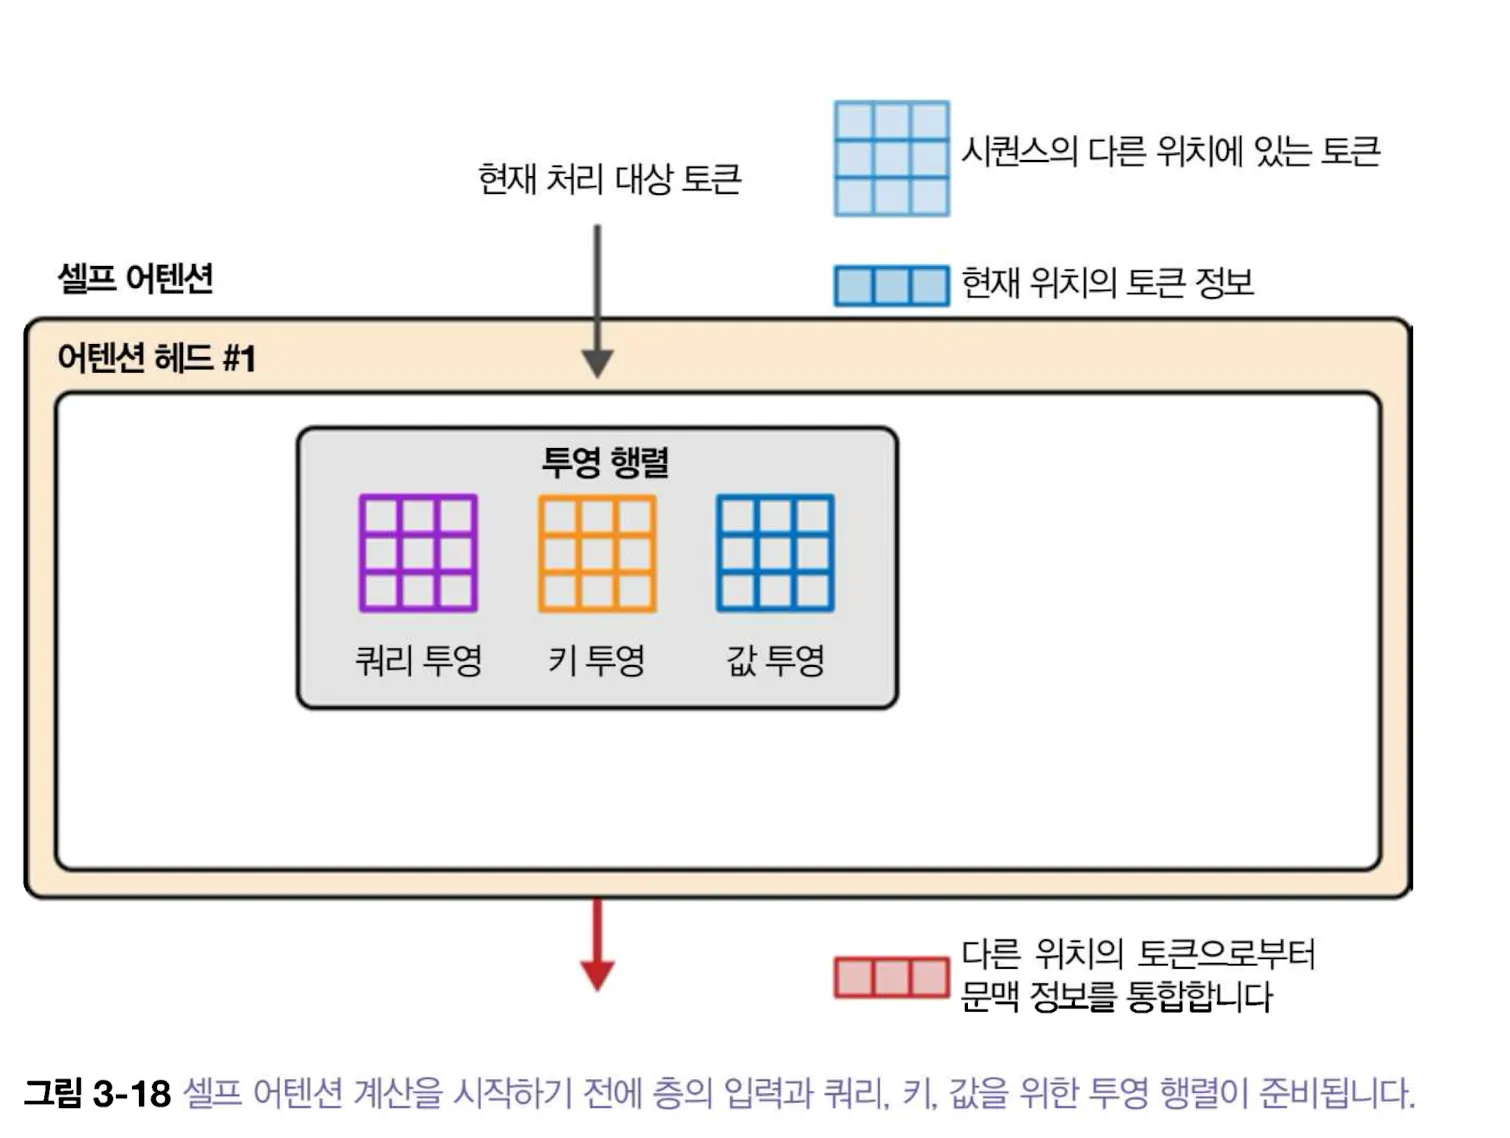
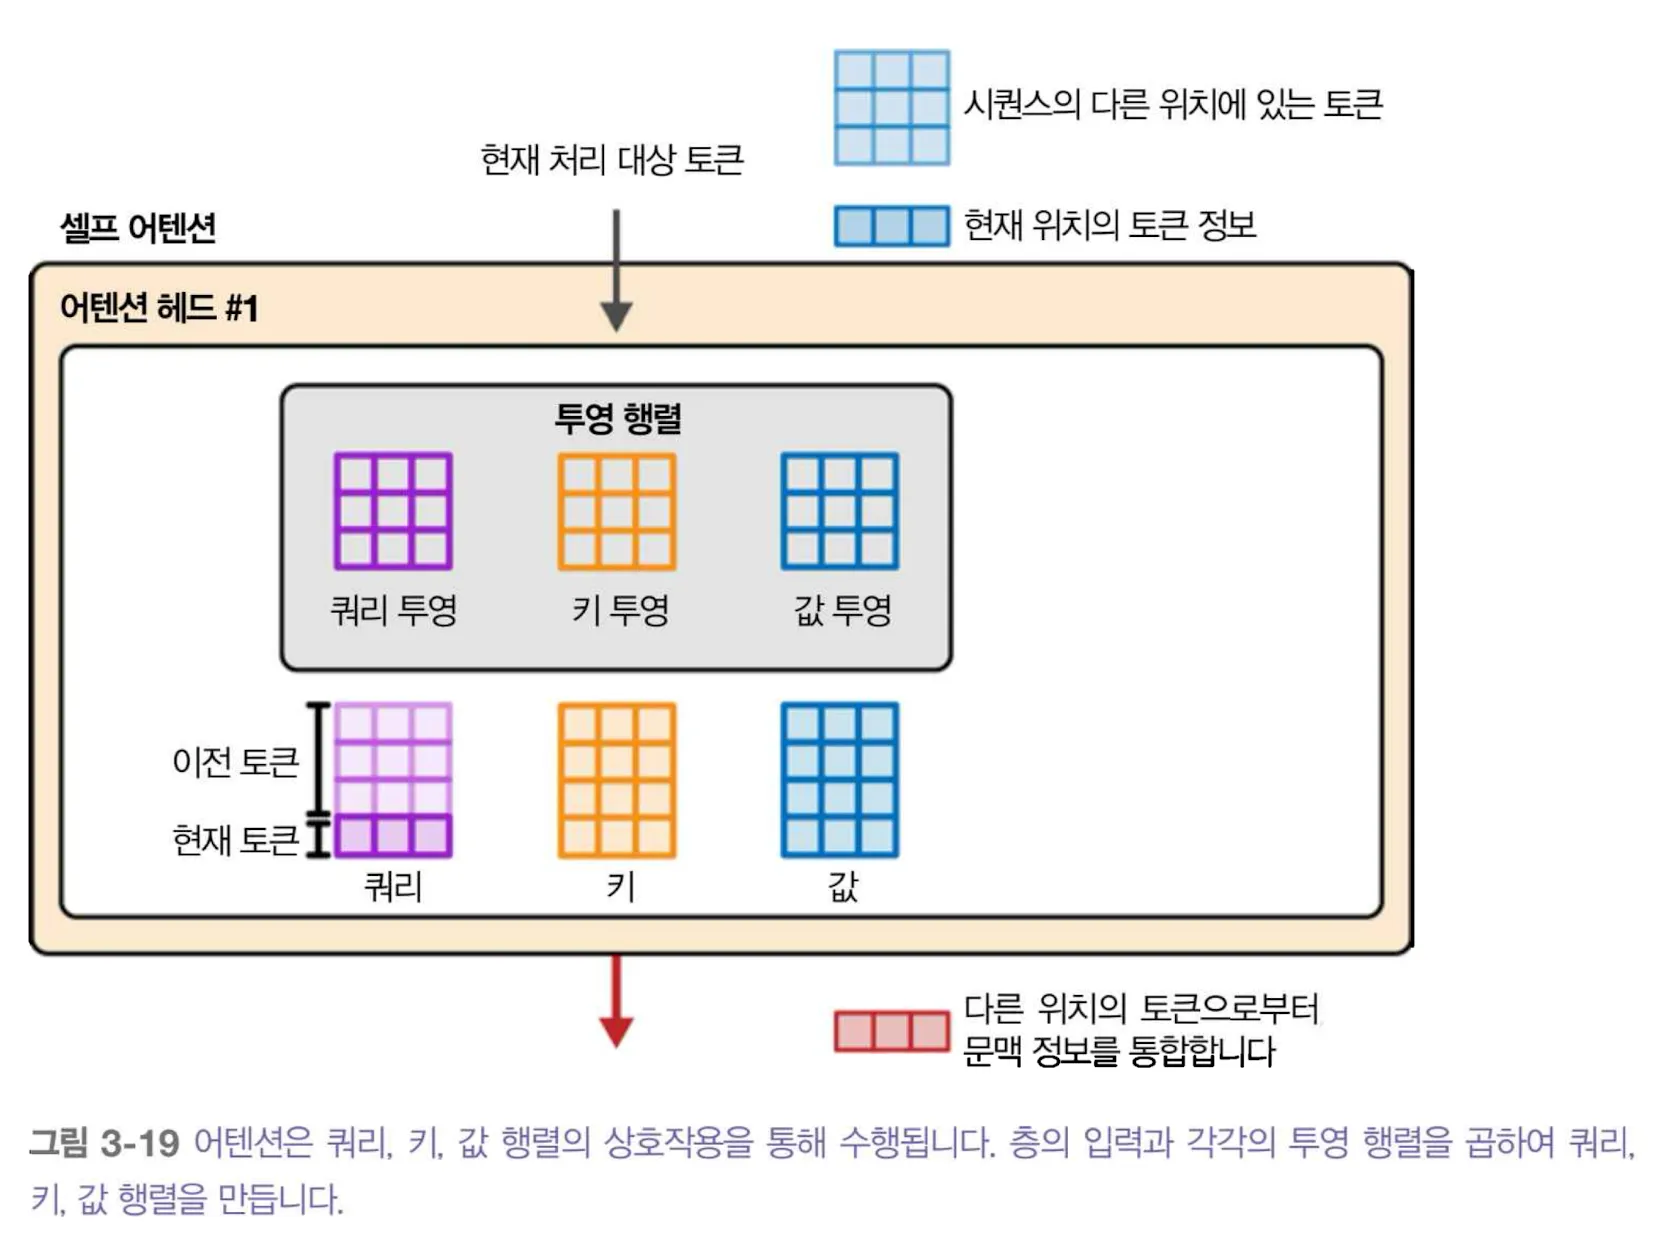
입력 위치의 은닉 벡터에 각각 학습된 투영 행렬을 곱해 쿼리(Q), 키(K), 값(V)을 만든다. Q는 “현재 위치가 무엇을 찾는가”, K는 “이 위치가 어떤 단서와 매칭되는가”, V는 “매칭됐을 때 가져올 정보”라는 비유로 이해할 수 있다. 이들은 사람이 작성한 키워드가 아니라 모델이 학습한 수치 벡터다.
이 행렬에는 세 개의 다른 공간에 투영된 입력 토큰의 정보가 담기며, 이 정보는 두개의 어텐션 단계에서 수행하는데 도움을 준다.
- 관련성 점수 계산
- 정보 통합
셀프어텐션: 관련성 점수 계산
생성형 트랜스포머에서는 한 번에 하나의 토큰을 생성
현재 위치의 Q와 참조 가능한 위치들의 K를 점곱하고, 키 차원의 제곱근으로 나눈다. 인과적 마스크로 미래 위치의 점수를 가린 뒤 softmax를 적용해 각 위치의 가중치를 만든다. 예를 들어 참조 위치가 세 개이고 가중치가 [0.1, 0.7, 0.2]라면 두 번째 위치의 V가 결과에 더 크게 기여한다. 이 숫자는 원리를 보이는 예시이지 실제 모델을 측정한 값은 아니다.
이를 통해 이전 토큰이 얼마나 관련 있는지를 나타내는 점수가 만들어진다.
그 후 소프트맥스 연산을 통해 이 점수의 합이 1이 되도록 정규화를 한다.
셀프어텐션: 정보 통합
각 V에 대응하는 가중치를 곱해 더하면 현재 위치의 어텐션 출력이 된다. 여러 헤드의 출력을 결합하고 투영한 뒤 잔차 연결을 거쳐 다음 계산으로 보낸다. 그림에서 선이 진하다는 것은 해당 예시의 가중치가 크다는 의미일 뿐, 모델이 사람처럼 그 단어를 ‘이해했다’는 직접적인 증거는 아니다.
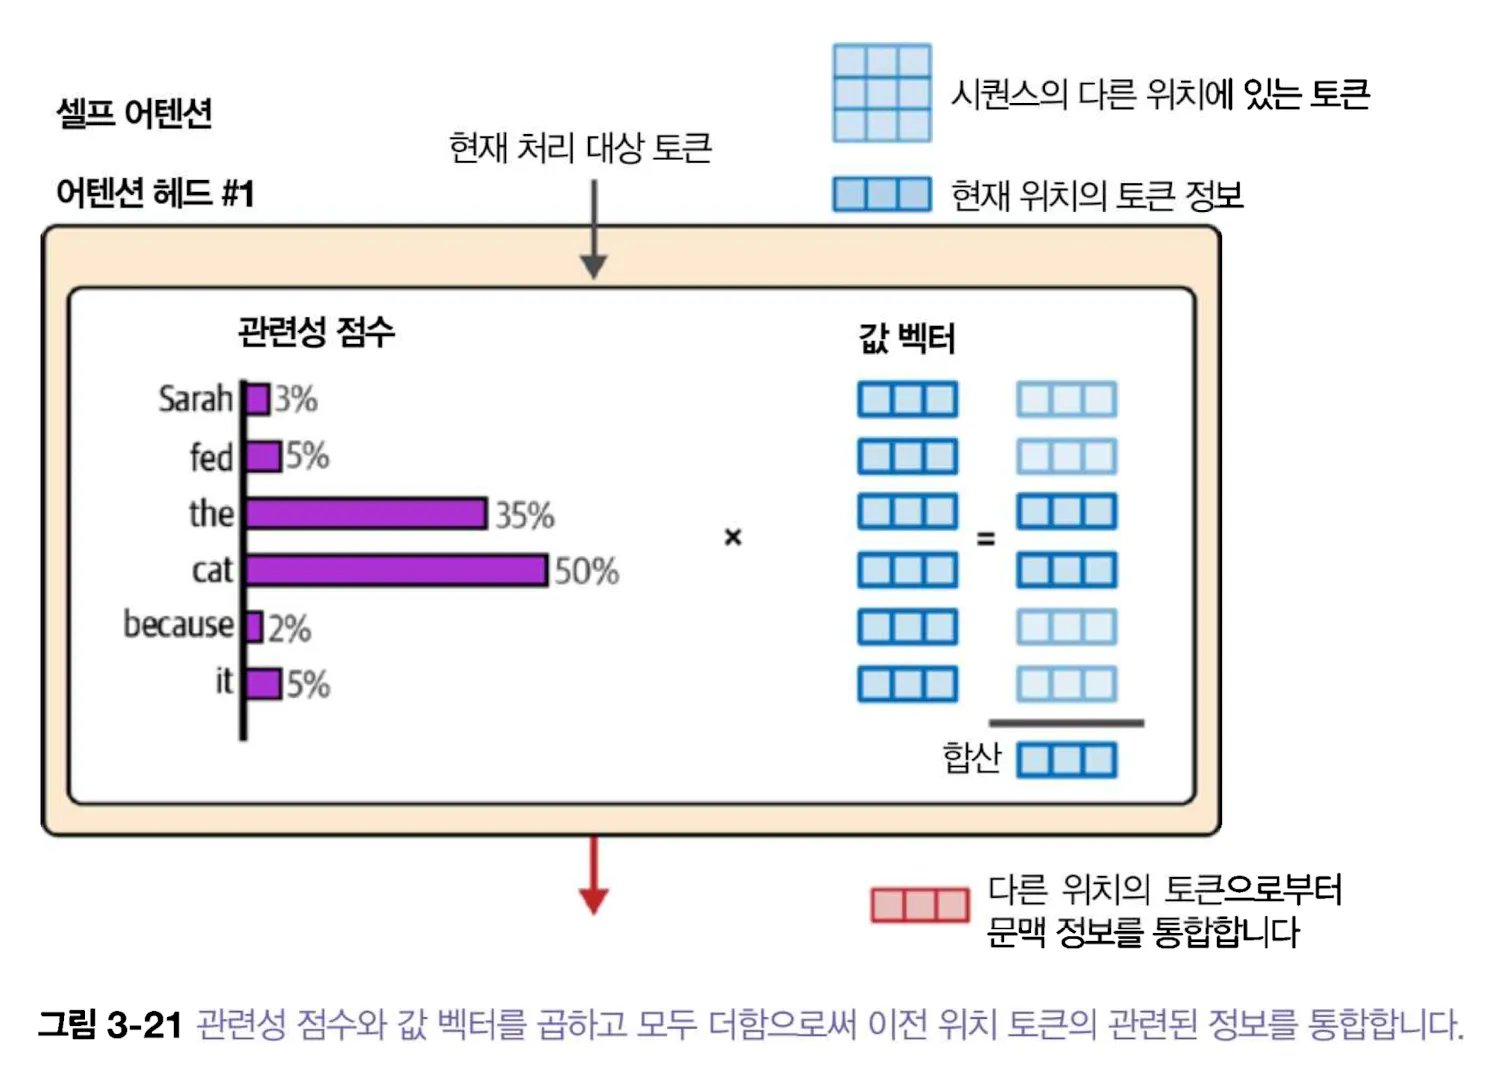
효율적인 어텐션
로컬/희소 어텐션
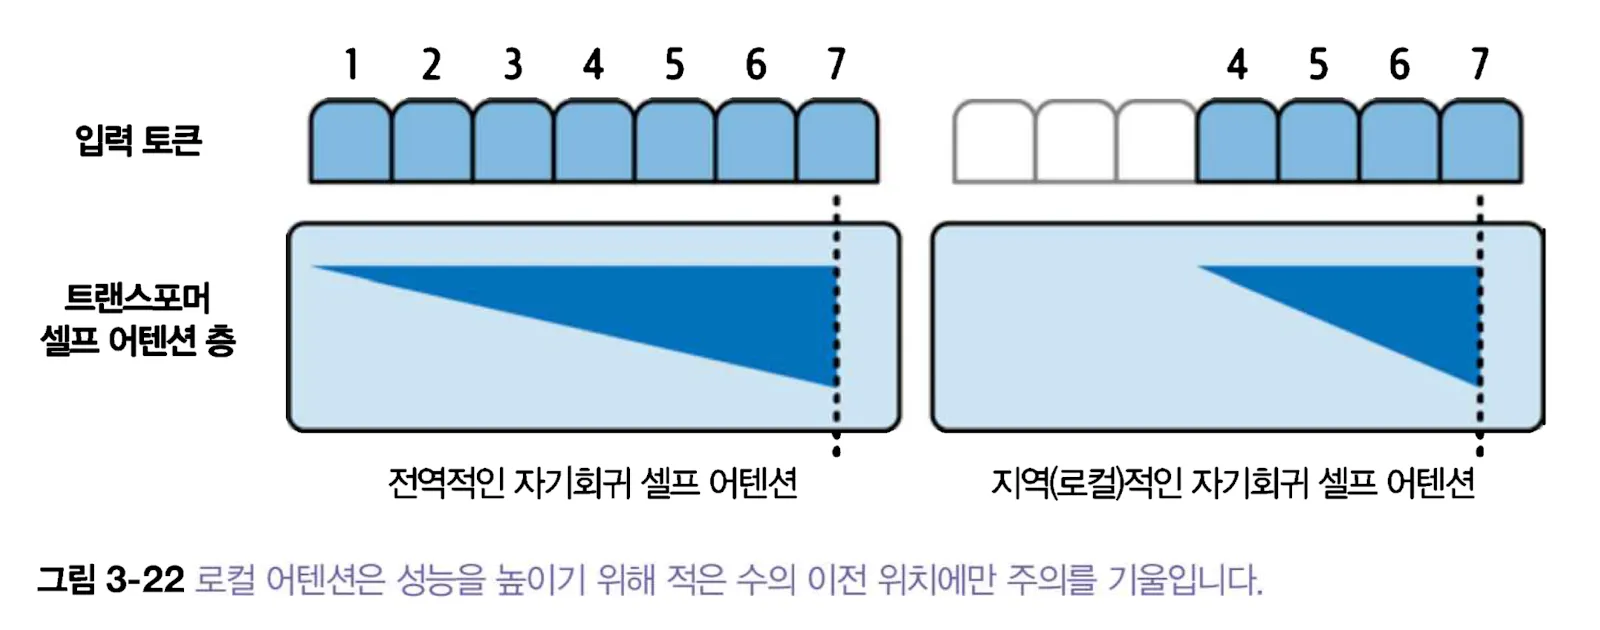
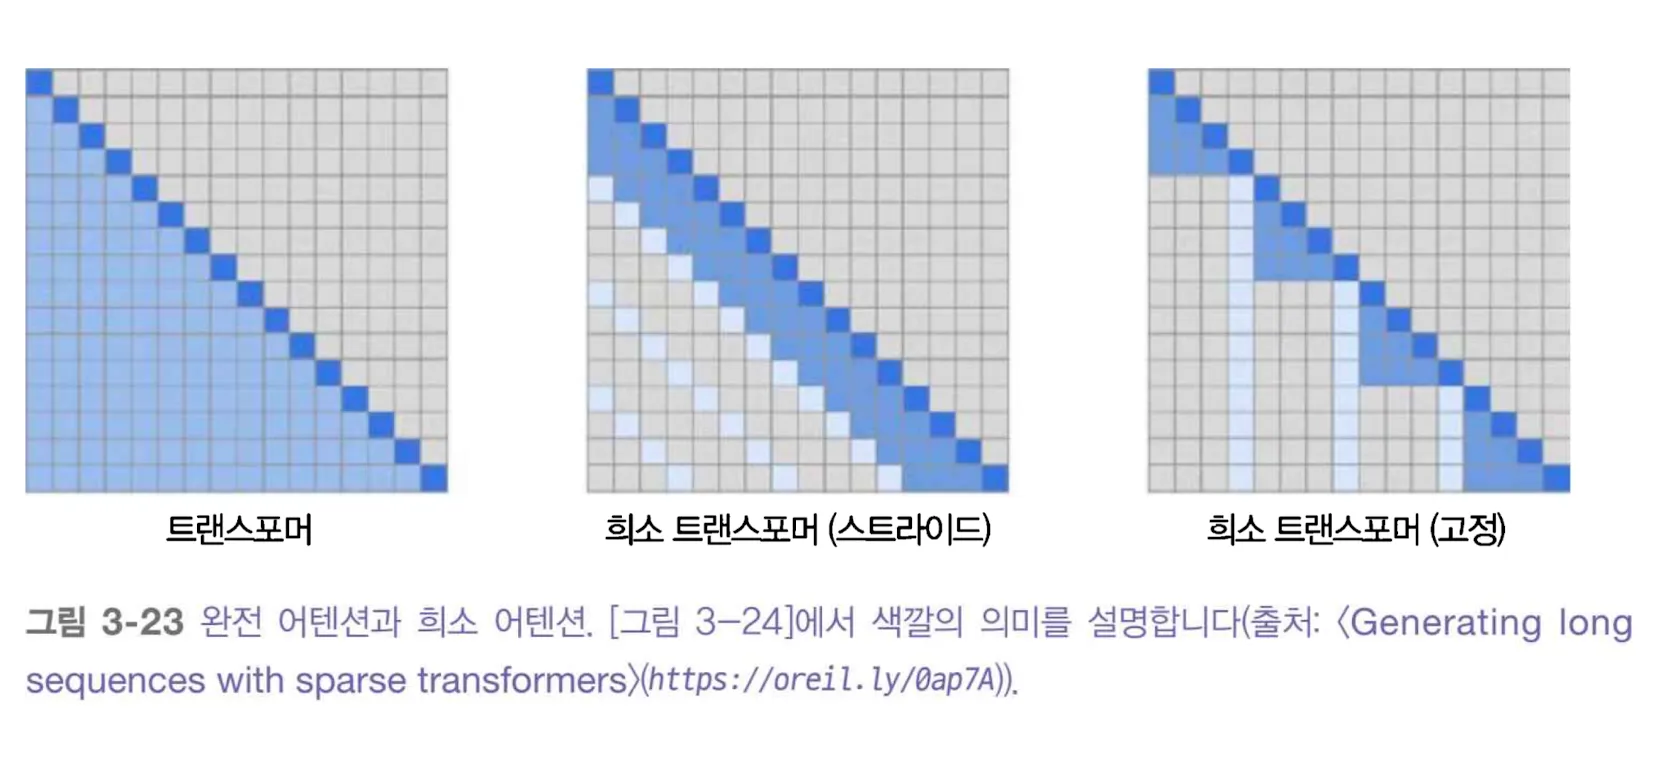
전체 셀프 어텐션은 시퀀스가 길어질수록 비교할 위치 쌍이 빠르게 늘어난다. 슬라이딩 윈도는 가까운 이전 토큰 위주로 참조 범위를 제한하고, 희소 어텐션은 일부 먼 위치만 추가로 연결한다. 계산량을 줄일 수 있지만 먼 과거의 단서가 필요한 질문에서는 연결 방식에 따라 정보가 닿지 않을 수 있다. 그림의 선이 빠진 곳은 모델이 그 위치에 직접 어텐션을 주지 않는다는 뜻이다.
멀티 쿼리 어텐션과 그룹 쿼리 어텐션
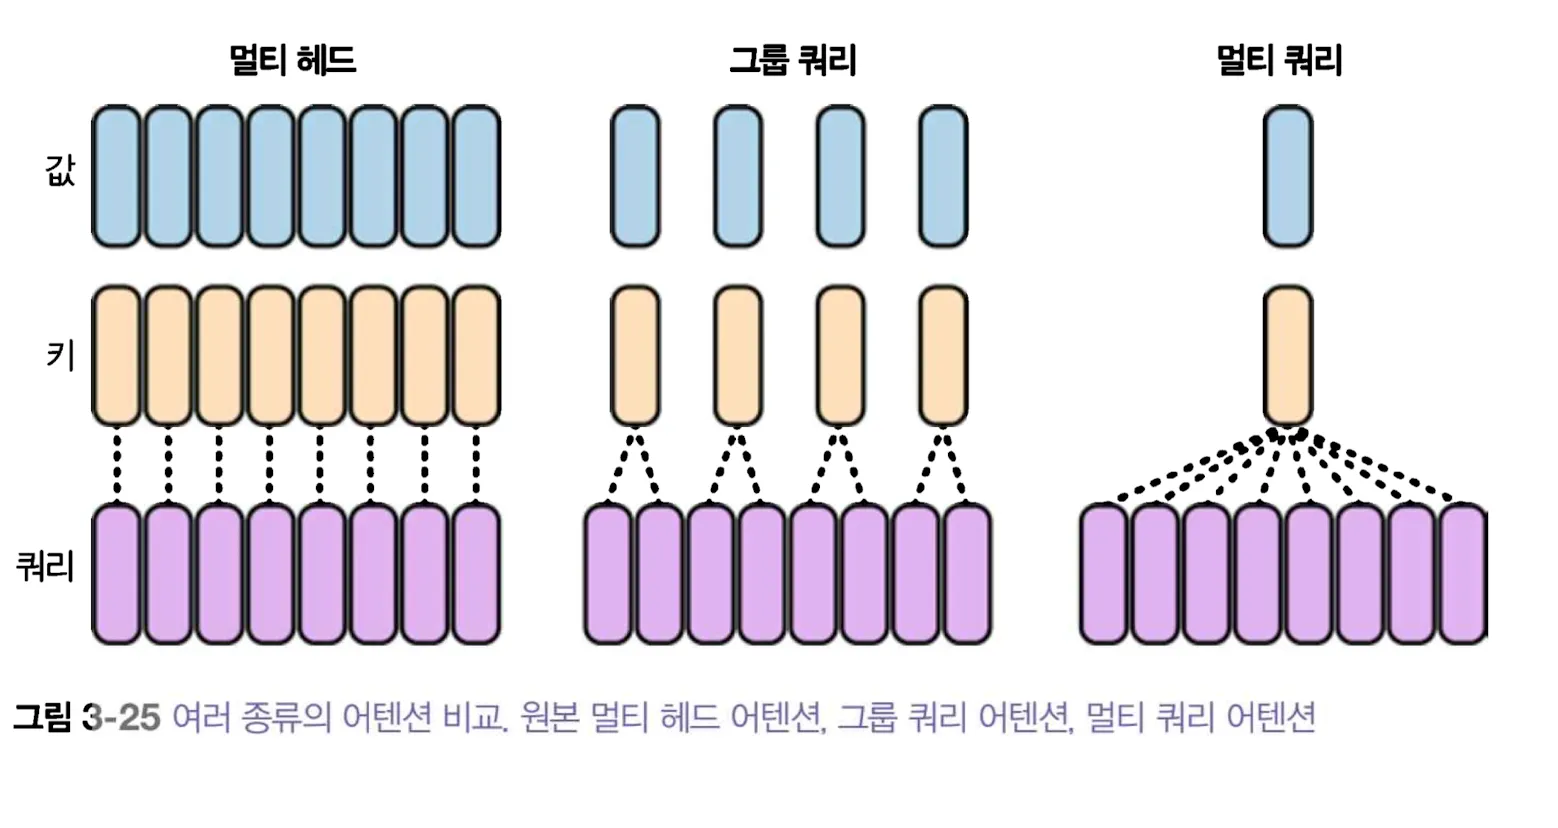
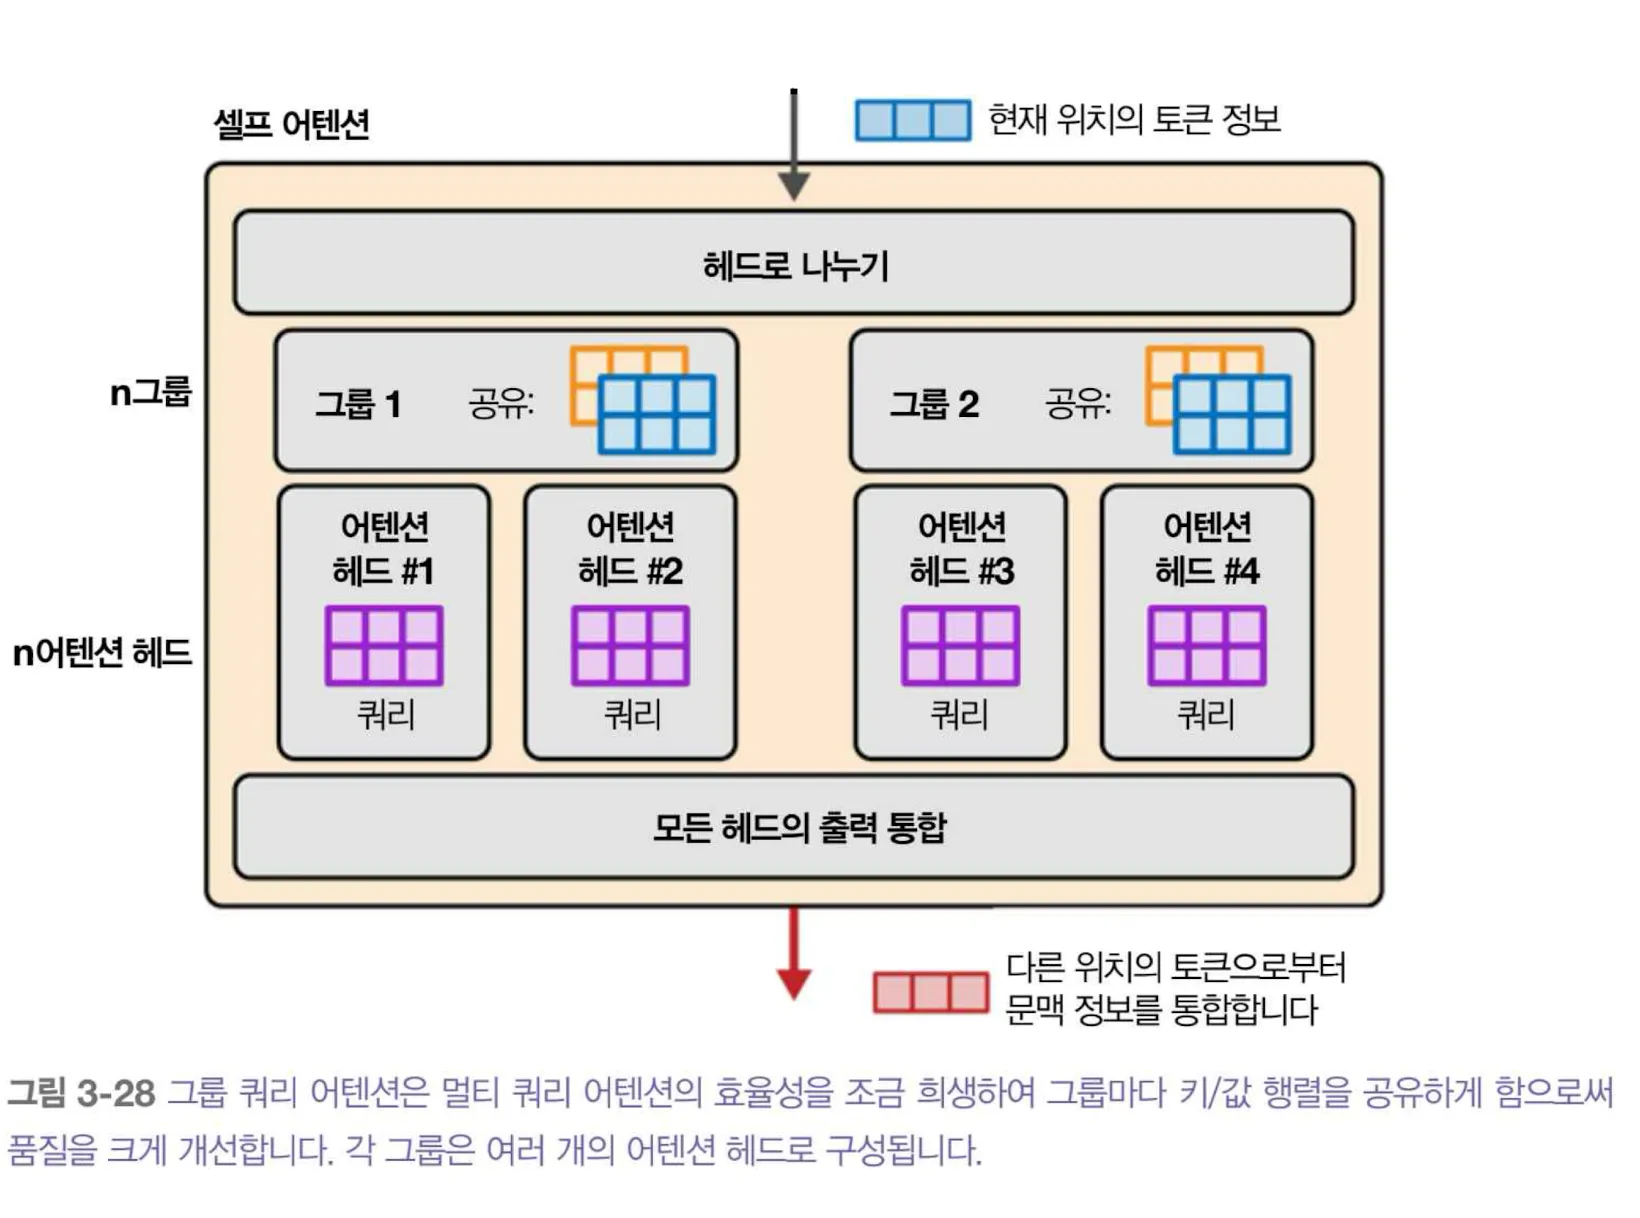
일반적인 다중 헤드 어텐션은 헤드마다 Q·K·V를 가진다. 멀티 쿼리 어텐션(MQA)은 여러 Q 헤드가 하나의 K·V 헤드를 공유한다. 생성 중 보관할 KV 캐시가 작아지고 메모리 대역폭 부담이 줄어드는 것이 핵심 이점이다. 대신 K·V 표현의 다양성은 줄어든다.
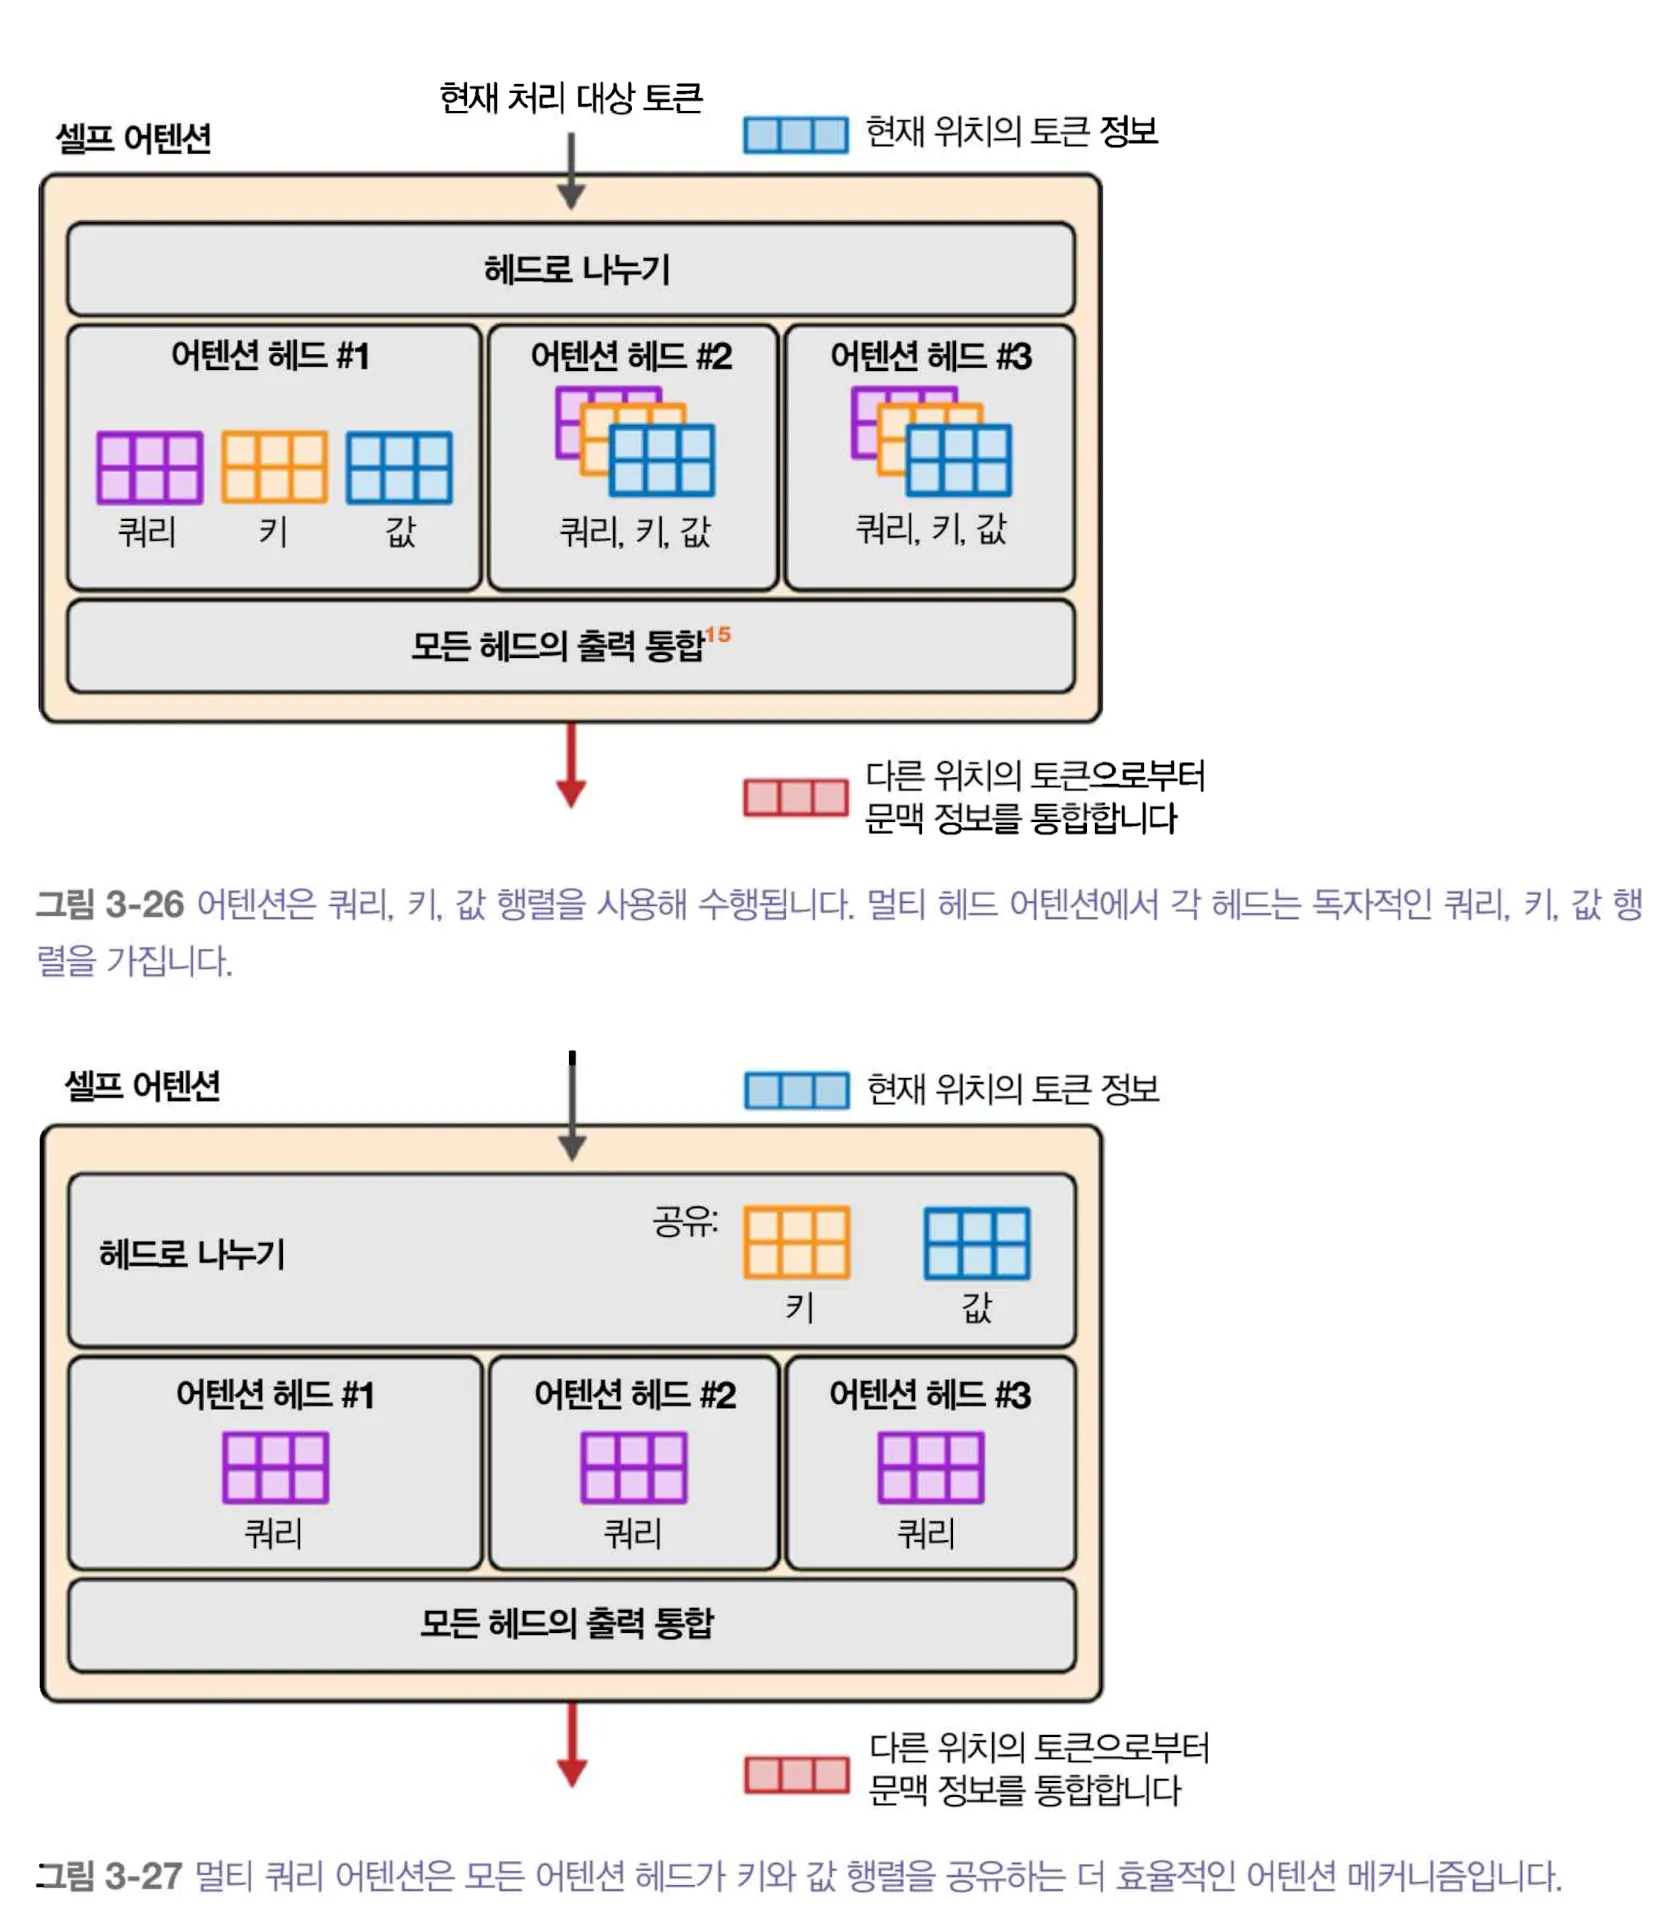
그룹 쿼리 어텐션(GQA)은 여러 Q 헤드를 그룹으로 묶어 그룹마다 K·V를 공유한다. MQA와 일반 다중 헤드 방식의 중간 형태다. 위 그림은 모든 Q가 하나를 공유하는 경우, 아래 그림은 그룹별로 공유하는 경우를 비교한다. 실제 속도와 품질은 모델 구조·장치·배치에 따라 달라진다.
플래시 어텐션
플래시 어텐션은 어텐션 행렬 전체를 고대역폭 메모리에 써 놓고 다시 읽는 비용을 줄이도록 계산을 분할·재배열한다. 앞의 슬라이딩 윈도처럼 참조 대상을 줄이는 방식과 목적이 다르다. 계산하는 어텐션을 수치적으로 안정적인 방식으로 유지하면서 메모리 입출력을 줄이는 구현이다. 장치와 커널 지원에 따라 사용할 수 있는지 확인해야 한다. 원리는 FlashAttention 논문을 참고했다.
트랜스포머 블록
트랜스포머 블록의 주요 구성요소
- 어텐션 층
- 피드포워드 신경망
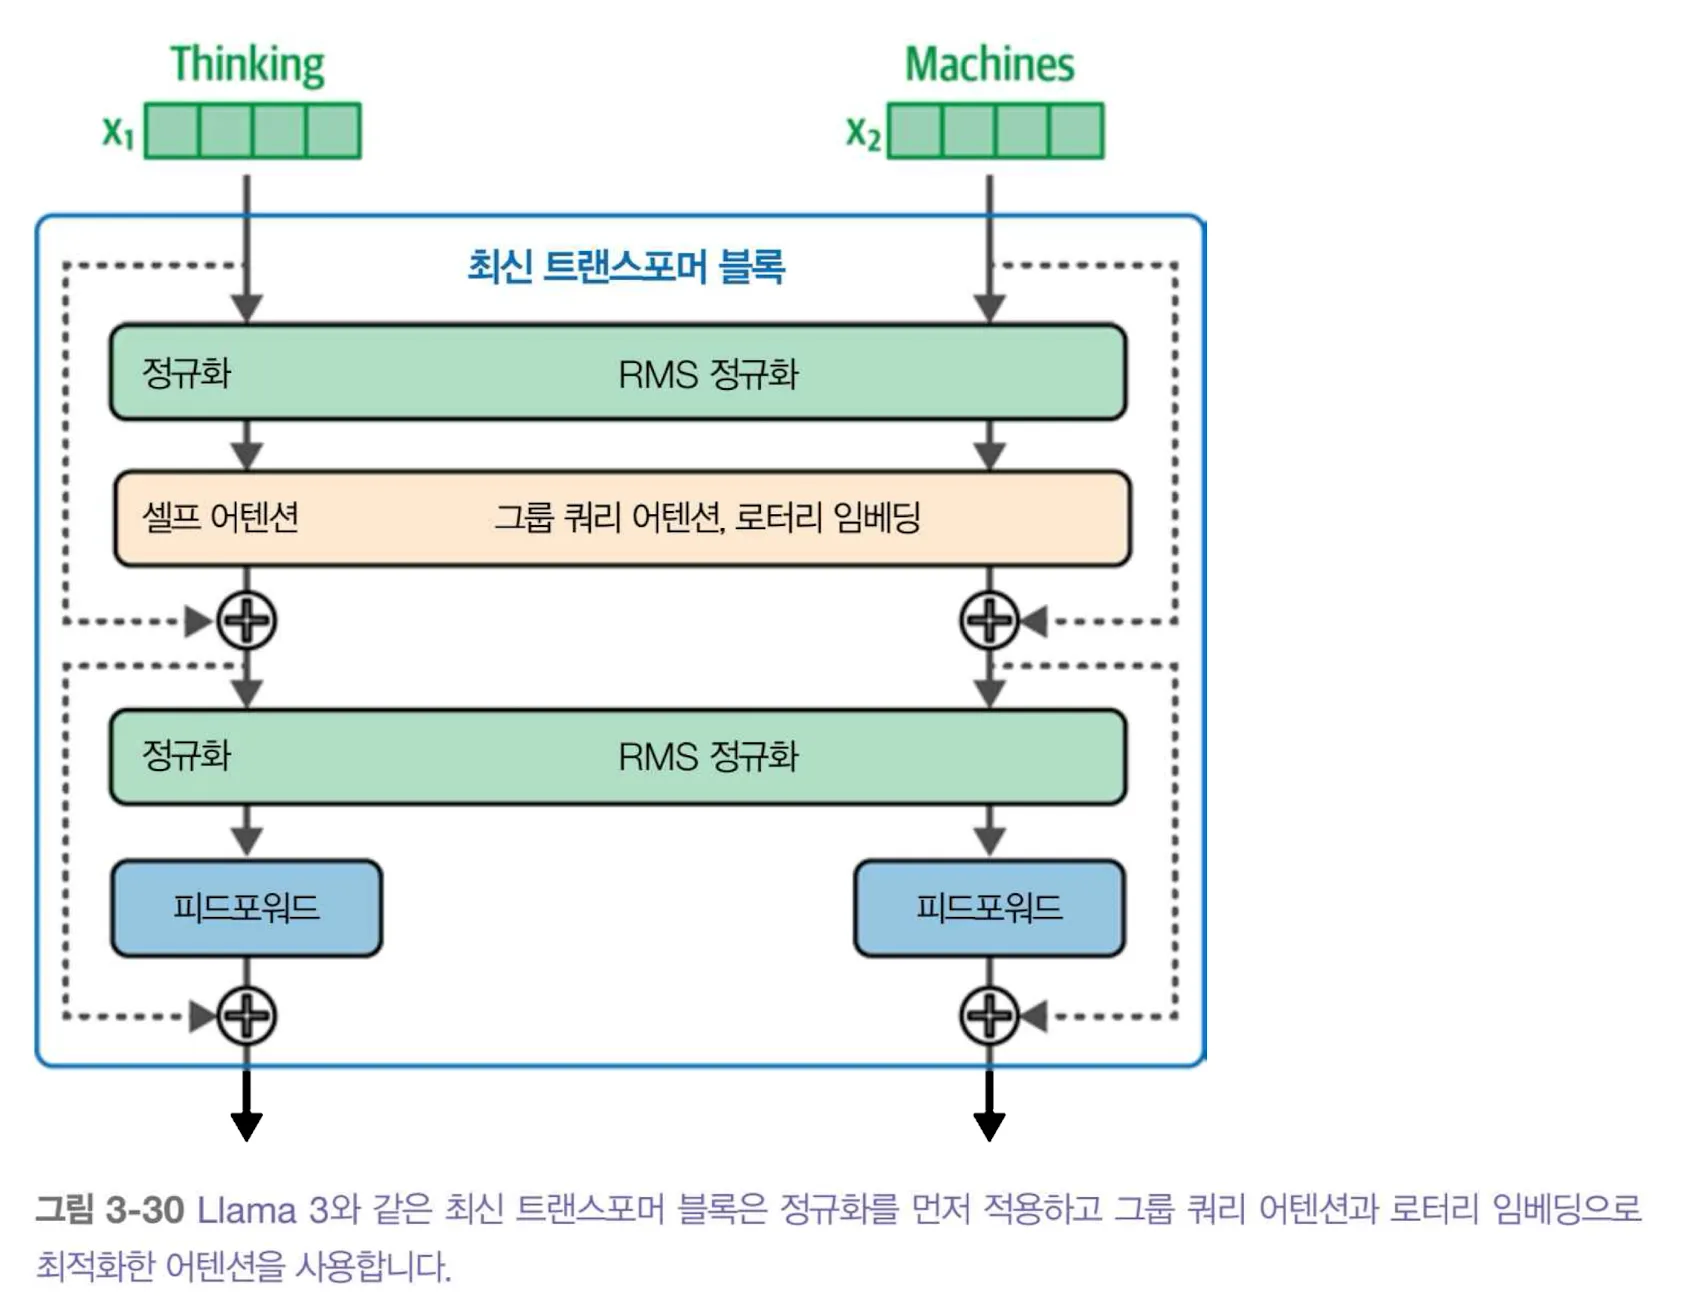
블록의 출력에는 어텐션과 FFN 외에 잔차 연결과 정규화도 관여한다. 잔차 연결은 변환 결과에 입력 경로를 더해 깊은 층까지 정보를 전달하고, 정규화는 층을 지나는 수치 규모를 조절한다. 아래 그림에서는 각 연산이 어느 순서에 놓이는지 보자.
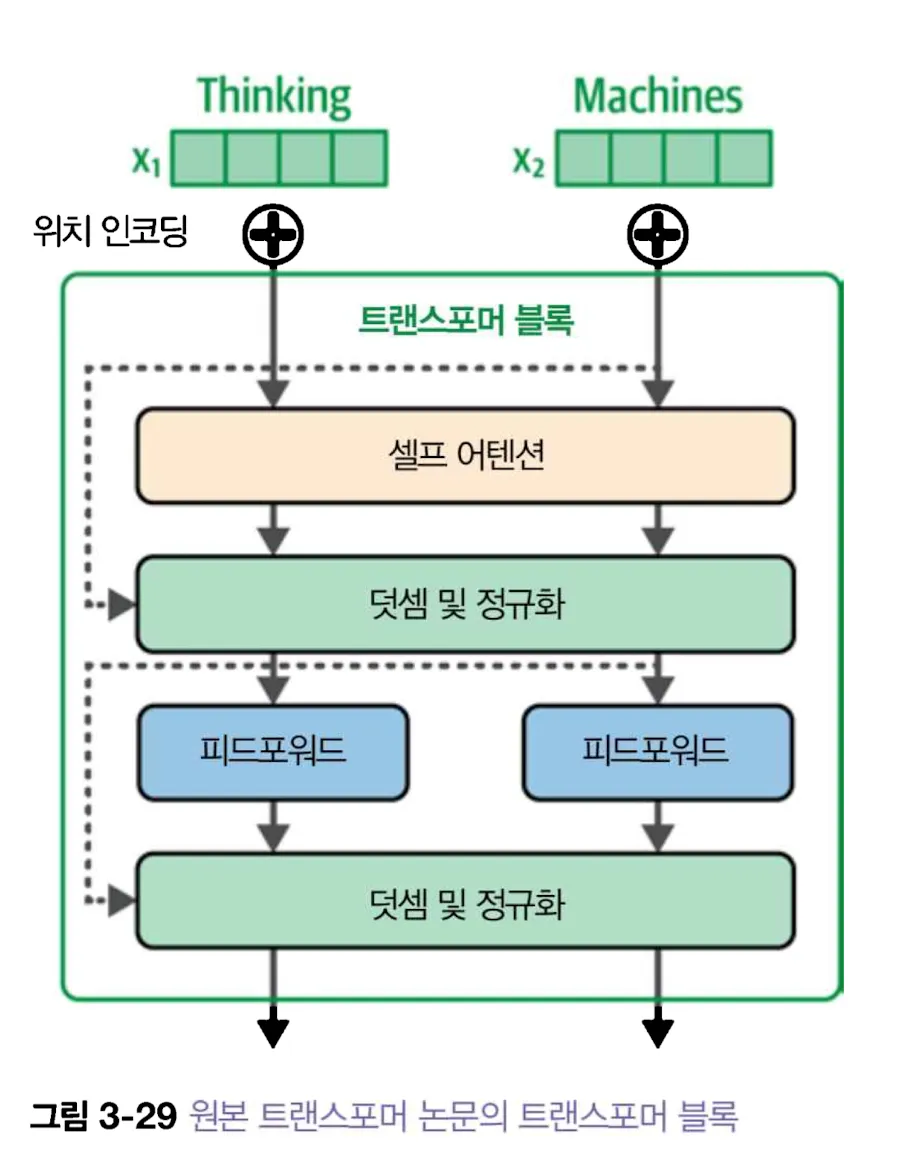
원본 트랜스포머에서는 변환 뒤에 정규화를 적용하는 구성으로 설명하는 경우가 많고, 여러 후속 모델은 변환 전에 정규화하는 pre-norm 방식을 쓴다. RMSNorm과 SwiGLU도 일부 모델에서 쓰는 설계 선택이다. 모든 최신 모델이 같은 블록이라는 뜻은 아니다. 구체적인 모델을 분석할 때는 모델 설정과 논문에서 정규화 위치, 활성화 함수, 어텐션 헤드 수를 확인해야 한다.
위치 임베딩(RoPE:Rotary Positional Embedding)
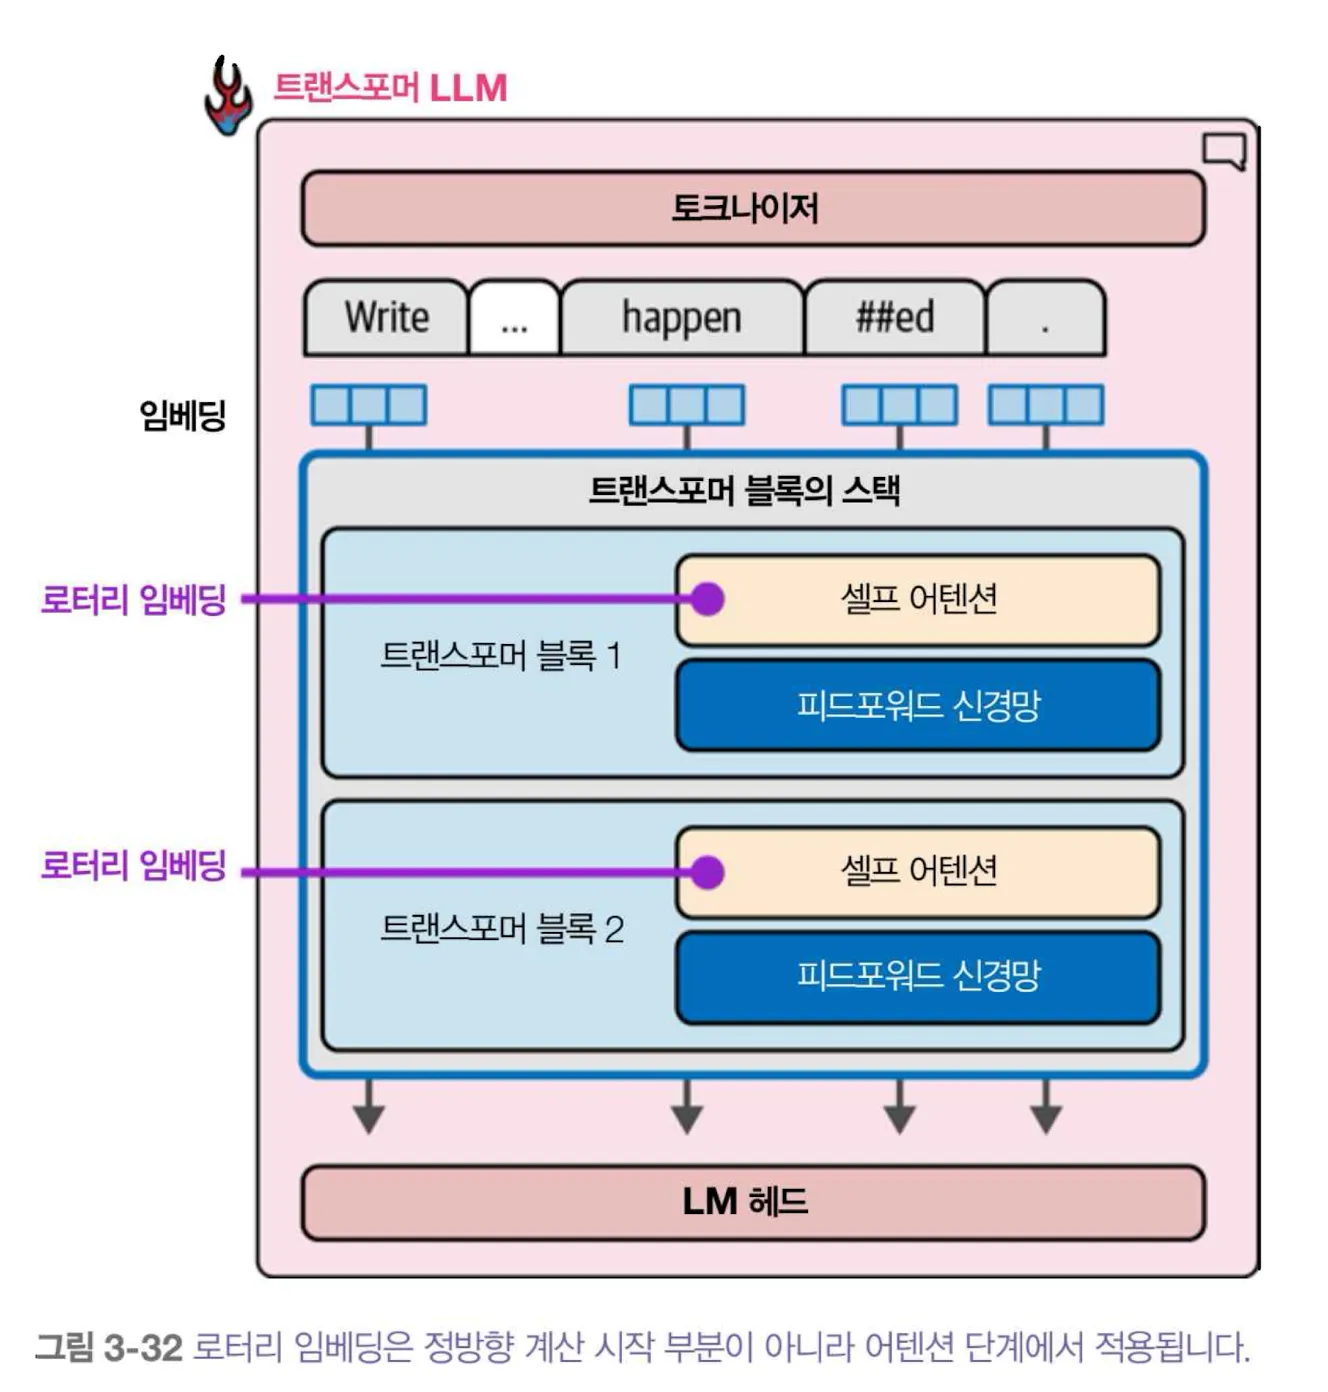
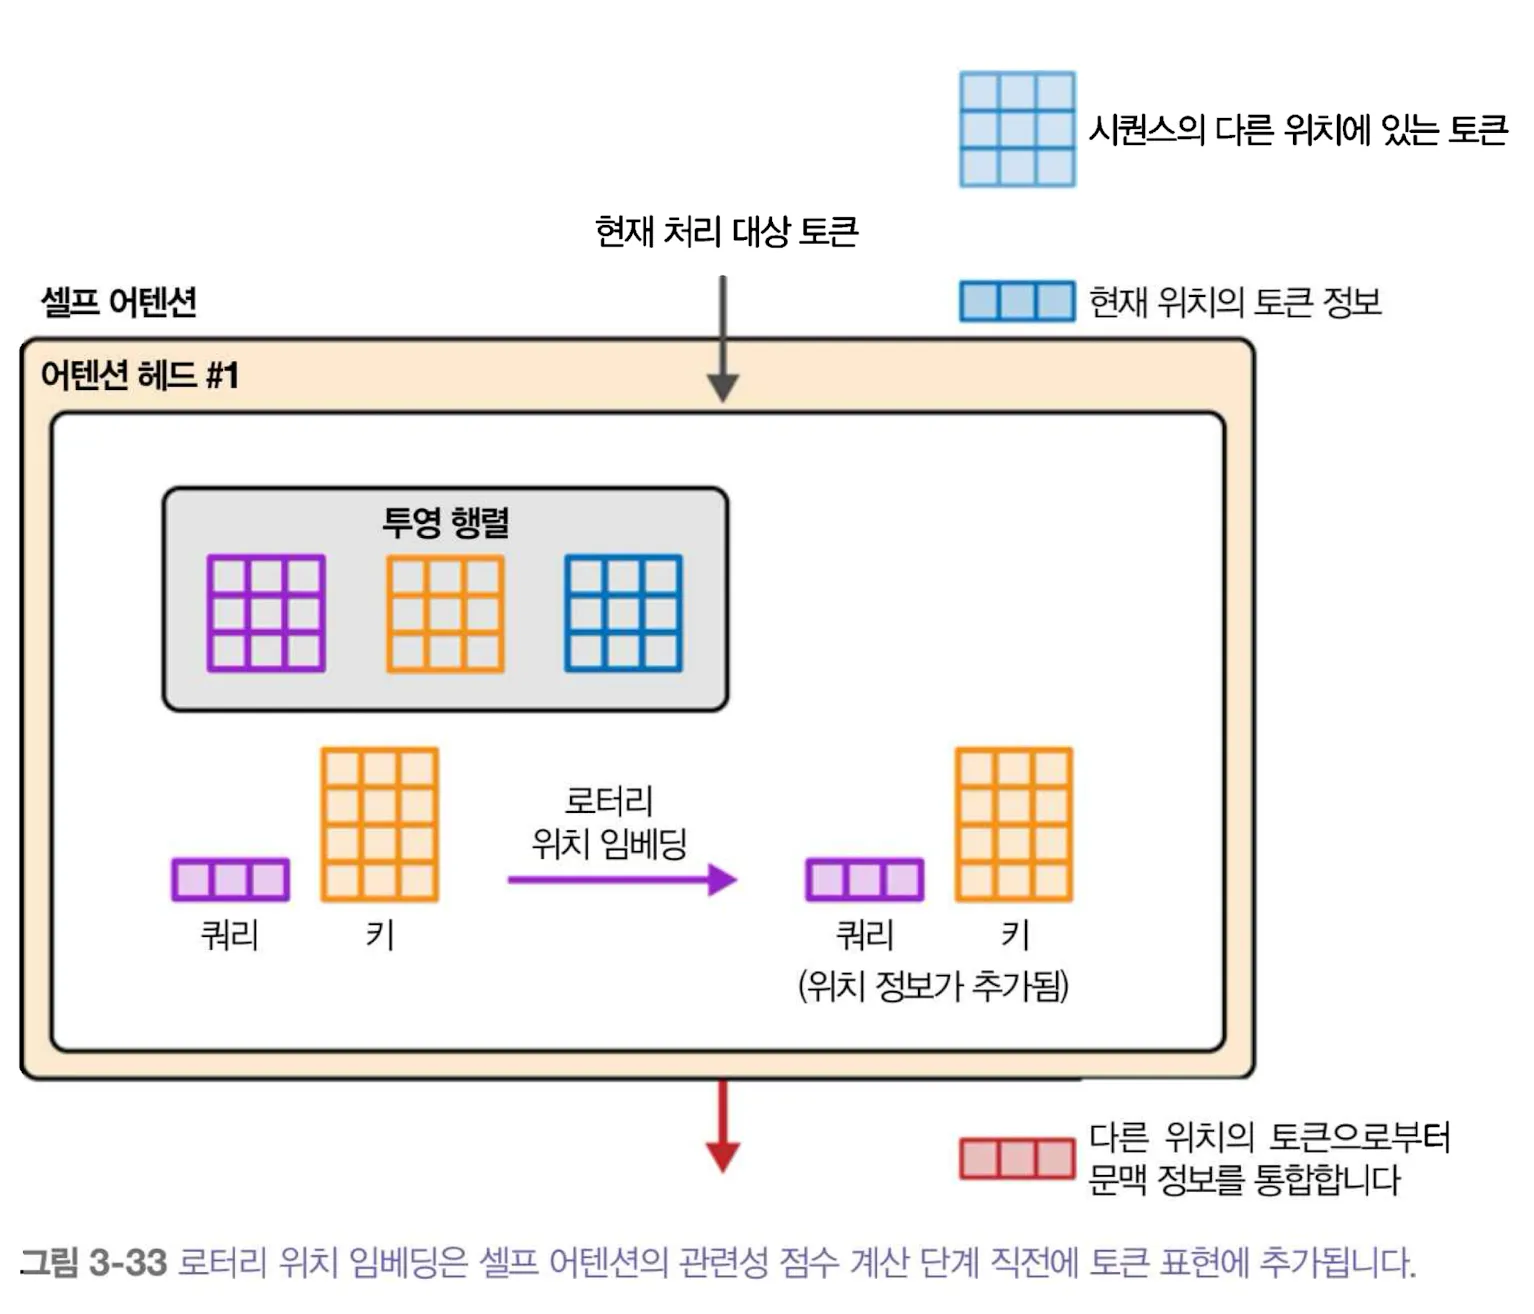
어텐션 점수만으로는 동일한 토큰들이 어떤 순서로 들어왔는지 충분히 구별하기 어렵다. 그래서 위치 정보를 넣는다. 원본 트랜스포머는 위치 표현을 입력에 더했고, RoPE를 쓰는 모델은 어텐션의 Q·K에 위치에 따른 회전을 적용한다. 두 방법을 같은 연산으로 생각하면 안 된다.
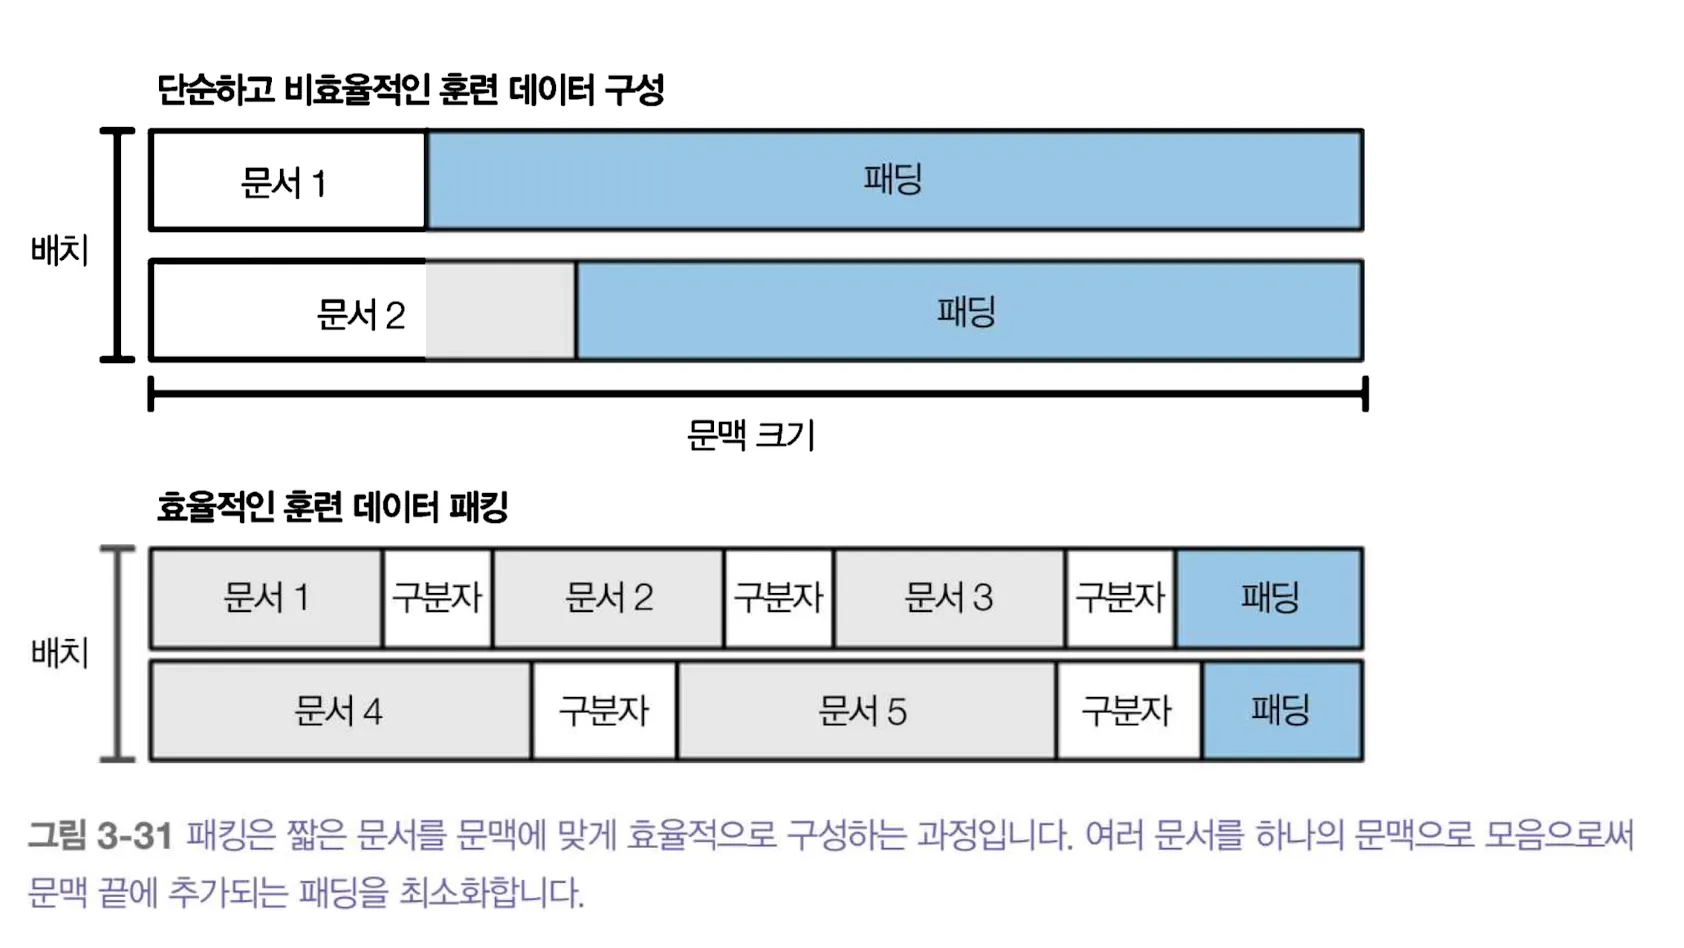
RoPE의 직관은 위치가 다른 Q와 K를 서로 다른 각도로 회전시켜, 점곱에 두 위치의 상대적 거리가 반영되게 하는 것이다. 그림의 회전 화살표는 이 과정을 시각화한다. RoPE를 쓴다고 문맥 길이를 제한 없이 늘릴 수 있는 것은 아니다. 학습 때 본 길이보다 긴 입력의 성능은 별도로 평가해야 한다. 자세한 수식은 RoFormer 논문을 참고했다.
실제로 읽을 때 확인할 것
모델의 답변이 느리다면 먼저 입력 토큰 수, 생성 토큰 수, KV 캐시 사용 여부를 분리해서 본다. 반복적인 답변이면 샘플링 설정과 종료 조건을 본다. 긴 문서의 앞부분을 놓친다면 문맥 창 안에 들어갔는지뿐 아니라 관련 내용이 어디에 배치됐는지 확인한다. 어텐션 구조를 이해하면 원인을 분류하기 쉬워지지만, 내부 가중치만 보고 답변의 사실성을 판정할 수는 없다.
참고 자료
- Attention Is All You Need: 트랜스포머, 마스킹, 다중 헤드 어텐션.
- Hugging Face 생성 가이드와 KV 캐시 가이드: 생성 옵션과 캐시.
- FlashAttention, RoFormer: 효율적인 어텐션과 회전 위치 표현.
같은 카테고리의 글
이어서 읽을 글
7. 고급 텍스트 생성 기술과 도구
모델 호출, 프롬프트 체인, 대화 기록, 도구 호출을 데이터 흐름과 실패 사례로 이해하기
1. 대규모 언어 모델 소개
BoW의 단어 빈도부터 문맥 임베딩, 어텐션, 트랜스포머까지: 언어를 숫자로 표현하고 생성하는 방식이 어떻게 달라졌는지 살펴본다.
13. LLM 운영하기
LLM 서비스의 모델·색인 버전 관리, 품질 평가, 추적 지표와 안전한 배포 절차를 정리합니다.
9. LLM 애플리케이션 개발하기
검색 증강 생성으로 근거를 연결하고 권한, 출력 검증, 프롬프트 인젝션과 평가를 다루는 애플리케이션 구성법을 정리한다.