목차
인지 아키텍처(Cognitive Architectures)
단순히 LLM에게 질문하고 답을 받는 것을 넘어, LLM이 사람처럼 기억하고, 계획하고, 행동하도록 만드는 ‘시스템의 구조’를 말한다.
[대표적인 인지 아키텍처 패턴]
- ReAct (Reasoning + Acting) 패턴
“생각(Reasoning)하고, 행동(Acting)하고, 관찰(Observation)한다.”
- 사용자: “이효리 최신 뉴스 요약해서 메일 보내줘.”
- LLM (생각): “먼저 이효리 뉴스를 검색해야겠어.”
- 도구 (행동): 검색 엔진 호출 -> 결과 수집
- LLM (관찰): “검색 결과를 보니 제주도 카페 관련 뉴스가 있네. 이제 이걸 요약해야지.”
- LLM (생각): “요약이 끝났으니 메일 전송 도구를 써야겠어.”
- 도구 (행동): 메일 전송 API 호출
[생각 → 행동 → 관찰 → 다시 생각]의 반복이 기초적인 인지 아키텍처다. 실제 그래프에는 최대 단계 수, 완료 조건, 사람의 승인 지점을 둔다.
관련 문서를 검색하거나(RAG) 사고의 연쇄 프롬프트(CoT)를 활용해 LLM을 호출
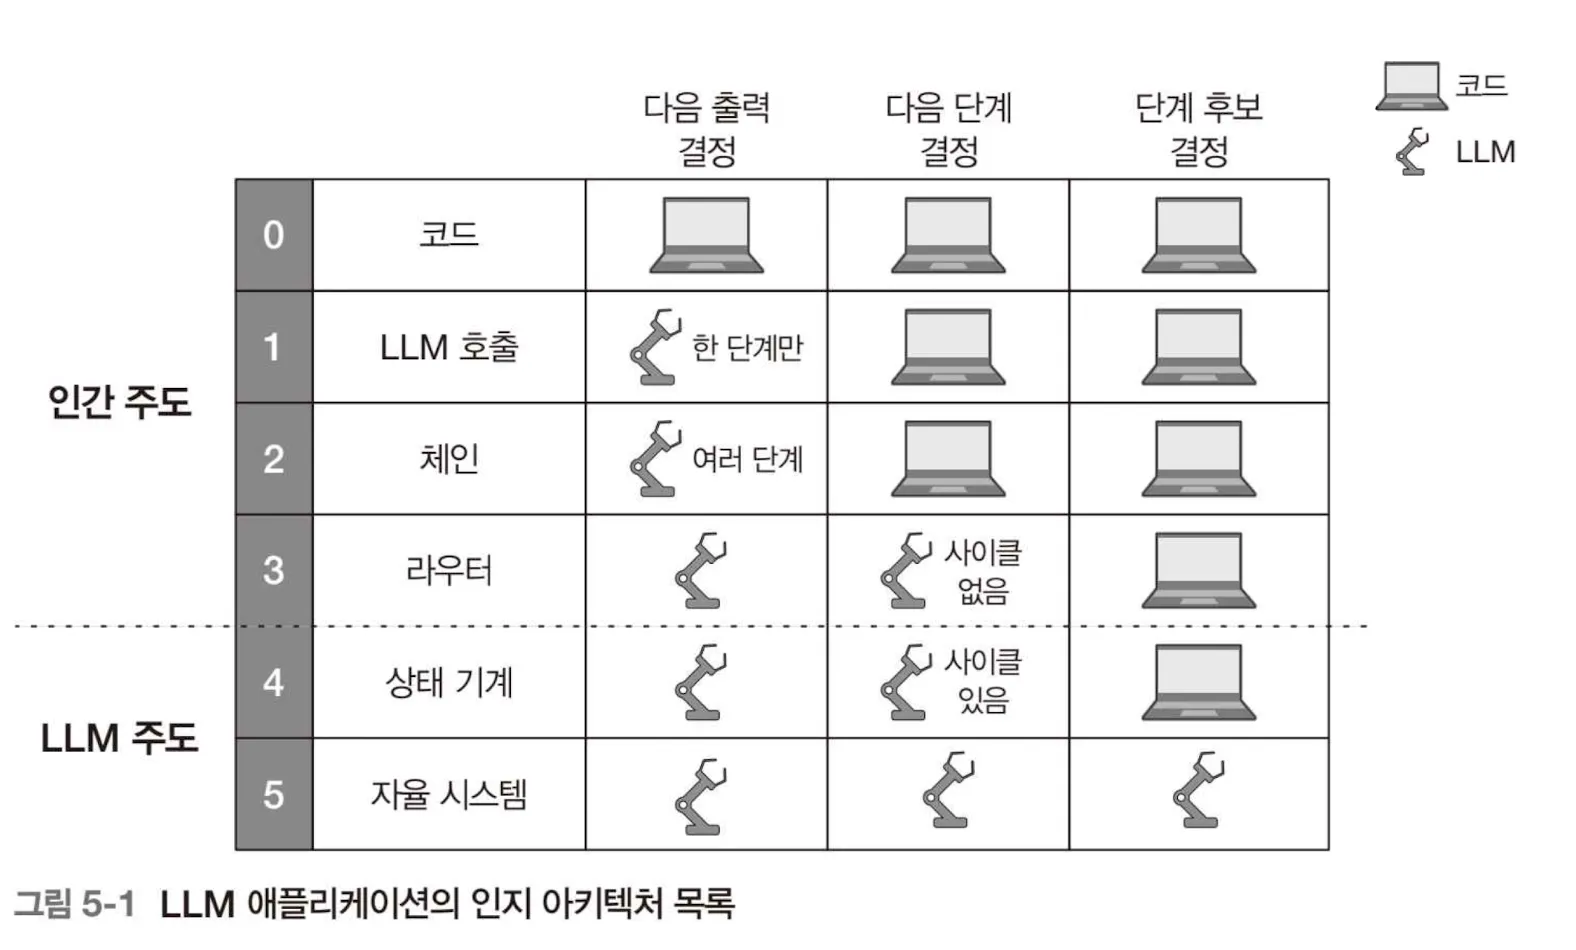
- 코드 : LLM 인지 아키텍처에 속하지 않음(LLM을 전혀 사용하지 않음)
- LLM 호출 : 텍스트 번역 요약 같이 특정 작업을 한 번 수행하는데 LLM을 활용
- 체인 : 미리 정해진 순서에 따라 여러 번의 LLM 호출을 구현
- 라우터 : LLM을 활용해 실행할 단계의 순서를 정의 (미리 정의된 몇몇 단 계중 하나를 선택)
- RAG : [ Load → Split → embedding → VectorStore → Retrieval]
1. LLM 호출
[가장 단순한 방식의 아키텍처]
from typing import Annotated, TypedDict

from langchain_core.messages import HumanMessage
from langchain_ollama import ChatOllama
from langgraph.graph import StateGraph, START, END, add_messages

from config.load_sys import gemma_model

class State(TypedDict):
    ## 메시지 유형 : list
    ## add_messages func : 상태를 업데이트하는 방법
    #### 이전 메시지를 대체하는 대신 새 메시지를 추가
    messages: Annotated[list, add_messages]

builder = StateGraph(State)

model = ChatOllama(model=gemma_model)

def chatbot(state: State):
    answer = model.invoke(state['messages'])
    return {'messages': [answer]}

## 챗봇 노드 추가
## 첫 번째 인자 : 고유한 노드 이름
## 두 번재 인자 : 실행할 함수 또는 Runnable
builder.add_node('chatbot', chatbot)

## 엣지 추가
builder.add_edge(START, 'chatbot')
builder.add_edge('chatbot', END)

graph = builder.compile()

## 시각화 저장
graph.get_graph().draw_mermaid_png(output_file_path='graph1.png')

## 스트림을 활용하여 그래프 실행
input = {'messages' : [HumanMessage('안녕하세요.')]}
for chunk in graph.stream(input):
    print(chunk)
[활용 사례]
- 요약 및 번역 등 AI 기능은 LLM을 한 번으로 구현가능(예: 노션AI)
- 단일 LLM 호출로도 간단한 SQL 쿼리를 생성 할 수 있다.(개발자가 생각하는 대상 사용자와 UX에 따라 바뀜)
2. 체인
체인 아키텍처는 사전에 정해진 순서에 따라 여러 차례의 LLM 호출을 활용해 확장한다.
- 서로 다른 애플리케이션 호출이 같은 순서로 LLM 호출을 수행하지만 입력 및 결과는 각각 다르다.
[플로우 엔지니어링]
여러 번의 LLM 호출을 순차적으로 활용해 보다 정교한 애플리케이션 구현
from typing import TypedDict, Annotated

from langchain_core.messages import SystemMessage, HumanMessage
from langchain_ollama import ChatOllama
from langgraph.constants import START, END

from config.load_sys import gemma_model
from langgraph.graph import add_messages, StateGraph

#SQL 쿼리 생성용
model_low_temp = ChatOllama(model=gemma_model, temperature=0.1)
# 자연어 출력 생성용
model_high_temp = ChatOllama(model=gemma_model, temperature=0.7)

class State(TypedDict):
    # 대화기록
    messages: Annotated[list, add_messages]
    # 입력
    user_query: str
    # 출력
    sql_query: str
    sql_explanation: str

class Input(TypedDict):
    user_query: str

class Output(TypedDict):
    sql_query: str
    sql_explanation: str

generate_prompt = SystemMessage(
    '당신은 친절한 데이터 분석가입니다. 사용자의 질문을 바탕으로 SQL 쿼리를 작성해주세요.'
)

def generate_sql(state: State) -> State:
    user_message = HumanMessage(state['user_query'])
    messages = [generate_prompt, *state['messages'], user_message]
    res = model_low_temp.invoke(messages)
    return {
        'sql_query': res.content,
        # 대화 기록 업데이트
        'messages': [user_message, res]
    }

explain_prompt = SystemMessage(
    '당신은 친절한 데이터 분석가입니다. 사용자에게 SQL 쿼리를 설명해주세요.'
)

def explain_sql(state: State) -> State:
    messages = [
        explain_prompt,
        # 이전 단계의 사용자의 질문과 SQL 쿼리
        *state['messages']
    ]
    res = model_high_temp.invoke(messages)
    return {
        'sql_explanation': res.content,
        # 대화 기록 업데이트
        'messages': res
    }

## input=Input, output=Output 파라미터는 deprecated 됨
builder = StateGraph(State, input_schema=Input, output_schema=Output)
builder.add_node('generate_sql', generate_sql)
builder.add_node('explain_sql', explain_sql)
builder.add_edge(START, 'generate_sql')
builder.add_edge('generate_sql', 'explain_sql')
builder.add_edge('explain_sql', END)

graph = builder.compile()

graph.get_graph().draw_mermaid_png(output_file_path='graph_chain.png')
response = graph.invoke({'user_query': '각 품목의 판매량을 구해주세요.'})

print(response)
[그래프 시각화]
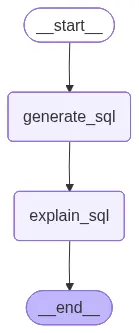
[결과]
{'sql_query': '알겠습니다. 각 품목의 판매량을 구하는 SQL 쿼리를 작성해 드리겠습니다.\n\n```sql\nSELECT\n item_id, -- 품목 ID\n SUM(quantity) AS total_sales -- 총 판매량\nFROM\n sales -- 판매 테이블 (테이블 이름은 실제 테이블 이름으로 변경해주세요)\nGROUP BY\n item_id -- 품목 ID로 그룹화\nORDER BY\n total_sales DESC; -- 판매량 내림차순으로 정렬 (선택 사항)\n```\n\n**설명:**\n\n* **`SELECT item_id, SUM(quantity) AS total_sales`**: `item_id` (품목 ID)와 `quantity` (판매 수량)를 선택합니다. `SUM(quantity)`는 각 품목별 판매 수량의 합계를 계산하고 `total_sales`라는 별칭으로 지정합니다.\n* **`FROM sales`**: `sales` 테이블에서 데이터를 가져옵니다. **`sales`는 실제 판매 데이터를 담고 있는 테이블 이름으로 바꿔주세요.**\n* **`GROUP BY item_id`**: `item_id`를 기준으로 데이터를 그룹화합니다. 이렇게 하면 각 품목별로 판매량을 합산할 수 있습니다.\n* **`ORDER BY total_sales DESC`**: (선택 사항) `total_sales`를 기준으로 내림차순으로 정렬합니다. 이렇게 하면 판매량이 많은 품목부터 표시됩니다.\n\n**참고:**\n\n* **테이블 이름 및 컬럼 이름**: `sales` 테이블과 `item_id`, `quantity` 컬럼 이름은 실제 데이터베이스 스키마에 맞게 변경해야 합니다.\n* **데이터베이스 종류**: 이 쿼리는 표준 SQL을 사용하므로 대부분의 데이터베이스 시스템(MySQL, PostgreSQL, SQL Server, Oracle 등)에서 작동합니다. 하지만 데이터베이스 시스템에 따라 약간의 문법 차이가 있을 수 있습니다.\n\n**예시:**\n\n만약 `sales` 테이블이 다음과 같은 데이터를 가지고 있다면:\n\n| item_id | quantity |\n|---|---|\n| 1 | 10 |\n| 2 | 5 |\n| 1 | 5 |\n| 3 | 8 |\n| 2 | 3 |\n\n위 쿼리를 실행하면 다음과 같은 결과가 반환됩니다:\n\n| item_id | total_sales |\n|---|---|\n| 1 | 15 |\n| 3 | 8 |\n| 2 | 8 |\n\n궁금한 점이 있다면 언제든지 다시 질문해주세요!', 'sql_explanation': ''}generate_sql 노드가 sql_query와 messages를 채우고, explain_sql 노드가 앞 단계의 메시지를 참조해 sql_explanation을 채우는 설계다. 위 기록에는 sql_explanation이 빈 문자열이므로 설명 단계가 의도대로 작동했다고 볼 수 없다. 생성 결과가 sql_query 필드에 순수 SQL 대신 안내 문장과 코드 블록을 포함한 점도 확인해야 한다. 실제 구현에서는 SQL과 설명을 구조화된 별도 필드로 요청하고, 두 필드가 비어 있지 않은지 검사한다.
StateGraph 생성시 입력 스키마와 출력 스키마를 별도로 사용. 이렇게 하면 상태의 일부 구성요소를 사용자 입력으로 사용하고 나머지는 최종 출력으로 반환할 수 있다.
3. 라우터
자율성의 사다리를 한 칸 더 오르기위해 앞서 설명한 향후 진행할 단계의 결정이라는 작업을 LLM에게 부여
즉 체인 아키텍처는 개발자가 정한 정적인 단계를 실행하는 반면, 라우터 아키텍처는 LLM이 미리 정의된 몇몇 단계중 하나를 선택
[전체 과정의 흐름]
- LLM 호출. 사용자가 제공한 쿼리와 개발자가 제시한 인덱스 설명을 토대로 사용할 수 있는 인덱스 중 활용할 인덱스를 결정
- 선택된 인덱스를 대상으로 사용자 쿼리와 가장 부합하는 문서를 찾는 쿼리 수행
- LLM 호출. 사용자가 제공한 쿼리와 인덱싱을 통해 수집된 관련 문서 목록을 바탕으로 답변을 생성
아래는 배송 정책과 환불 정책 중 하나를 고르는 작은 예제다. 기존 의료 기록·보험 예시는 빈 인덱스에서 근거 없이 민감한 답변을 생성할 수 있어 서비스 예제로 적합하지 않다. 이 예제는 허용된 세 경로(배송·환불·지원 범위 밖)만 사용하고, 검색 결과가 없으면 모델 생성으로 넘어가지 않는다. langgraph, langchain-ollama가 필요하며 OLLAMA_MODEL과 OLLAMA_EMBED_MODEL에 로컬에 준비된 모델 이름을 설정한다.
flowchart LR
    Q[질문] --> R[라우터]
    R -->|shipping| S[배송 문서 검색]
    R -->|refund| F[환불 문서 검색]
    R -->|unsupported| U[지원 범위 안내]
    S --> G[근거 기반 답변]
    F --> G
    G --> E[결과]
    U --> E
라우터는 도메인 이름을 제안할 뿐이다. 코드는 그 값을 허용 목록과 비교하고 알 수 없는 값을 unsupported로 보낸다. 두 검색 경로는 각자의 문서 집합에만 접근한다. 민감한 사용자별 문서를 다룬다면 라우팅과 별개로 검색기에서 인증된 사용자 권한을 적용해야 한다.
import os
from typing import TypedDict

from langchain_core.documents import Document
from langchain_core.vectorstores import InMemoryVectorStore
from langchain_ollama import ChatOllama, OllamaEmbeddings
from langgraph.graph import END, START, StateGraph

chat = ChatOllama(model=os.environ["OLLAMA_MODEL"], temperature=0)
embeddings = OllamaEmbeddings(model=os.environ["OLLAMA_EMBED_MODEL"])
shipping = InMemoryVectorStore.from_documents(
    [Document("배송은 결제 확인 후 2영업일 이내 시작한다.",
              metadata={"id": "SHIP-01"})],
    embeddings,
)
refund = InMemoryVectorStore.from_documents(
    [Document("환불은 반품 접수 뒤 검수 결과에 따라 처리한다.",
              metadata={"id": "REF-01"})],
    embeddings,
)

class State(TypedDict):
    question: str
    domain: str
    documents: list[Document]
    answer: str

def choose_domain(state: State) -> dict:
    response = chat.invoke([
        ("system", "질문을 shipping, refund, unsupported 중 하나로 분류하세요. "
                   "도메인 이름 하나만 출력하세요."),
        ("user", state["question"]),
    ])
    raw = str(response.content).strip().lower()
    allowed = {"shipping", "refund"}
    return {"domain": raw if raw in allowed else "unsupported"}

def next_node(state: State) -> str:
    return {
        "shipping": "search_shipping",
        "refund": "search_refund",
    }.get(state["domain"], "unsupported")

def search_shipping(state: State) -> dict:
    return {"documents": shipping.similarity_search(state["question"], k=2)}

def search_refund(state: State) -> dict:
    return {"documents": refund.similarity_search(state["question"], k=2)}

def unsupported(state: State) -> dict:
    return {"answer": "이 예제는 배송·환불 질문만 처리합니다."}

def answer(state: State) -> dict:
    if not state["documents"]:
        return {"answer": "근거 문서를 찾지 못했습니다."}
    context = "\n".join(
        f"[{doc.metadata['id']}] {doc.page_content}"
        for doc in state["documents"]
    )
    response = chat.invoke([
        ("system", "제공된 자료만 근거로 답하세요. 자료에 없으면 모른다고 답하세요."),
        ("user", f"질문: {state['question']}\n자료:\n{context}"),
    ])
    return {"answer": str(response.content)}

builder = StateGraph(State)
builder.add_node("route", choose_domain)
builder.add_node("search_shipping", search_shipping)
builder.add_node("search_refund", search_refund)
builder.add_node("unsupported", unsupported)
builder.add_node("answer", answer)
builder.add_edge(START, "route")
builder.add_conditional_edges("route", next_node)
builder.add_edge("search_shipping", "answer")
builder.add_edge("search_refund", "answer")
builder.add_edge("unsupported", END)
builder.add_edge("answer", END)
graph = builder.compile()

result = graph.invoke({
    "question": "배송은 언제 시작하나요?",
    "domain": "", "documents": [], "answer": "",
})
print(result["domain"], result["answer"])choose_domain은 모델이 예상하지 못한 문장을 반환할 수도 있으므로 허용값을 검사한다. search_shipping과 search_refund는 라우터가 선택한 자료군만 조회한다. answer는 검색된 문서를 문맥에 넣지만, 모델이 실제로 그 문장을 충실히 사용했는지까지 보장하지 않는다. 배송과 환불이 함께 들어간 질문, 문서에 없는 요금 질문, 검색 결과 0건을 평가 사례로 넣어야 한다. 인용 ID를 결과에 제공하려면 모델 출력에서 ID를 파싱해 검색된 ID와 비교하는 검증 노드를 추가한다.
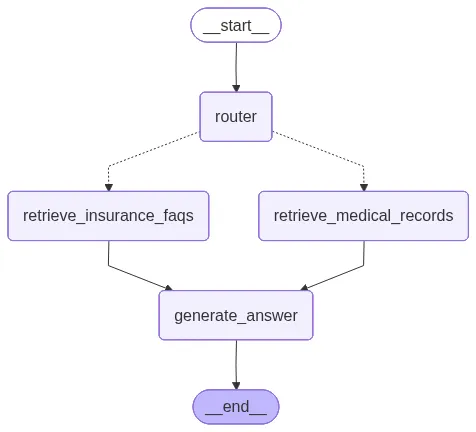
위 이미지는 이전 실습의 분기 구조를 보여준다. 현재 코드의 shipping/refund 노드 이름과는 다르지만, 라우터 하나가 두 검색 경로 중 하나를 선택하고 다시 답변 노드로 합류한다는 구조는 같다. LangGraph 워크플로 문서에서 조건부 분기 패턴을 확인할 수 있다.
결과를 해석할 때
출력의 domain이 shipping이고 답에 “2영업일”이 포함되어도 그것만으로 검색 품질이 좋다는 결론을 내릴 수 없다. 어떤 문서 ID가 검색됐는지와 답의 주장에 그 문서가 실제 근거가 되는지를 함께 봐야 한다. unsupported는 모델이 무관한 경로를 반환한 경우에도 사용되므로, 정상적인 범위 밖 질문과 라우터 오분류를 별도로 기록한다. 라우터 호출 하나가 추가되므로 단순한 키워드 규칙으로 충분한 서비스라면 그 규칙이 지연과 비용 면에서 나을 수 있다.
또 앞의 SQL 체인은 생성된 쿼리를 설명하는 예시다. 모델이 출력한 SQL 문자열을 운영 DB에 바로 실행하지 않는다. 실제 실행이 필요하다면 스키마를 제한하고, 읽기 전용 계정·쿼리 시간 제한·결과 건수 제한을 적용하고, 실행 전 문법과 허용 테이블을 검사한다.
같은 카테고리의 글
이어서 읽을 글
4. 랭그래프를 활용한 메모리 기능
LangGraph 상태 그래프와 체크포인터로 대화 기록을 보존하고, 메시지 축약·필터링으로 컨텍스트를 관리하는 방법을 살펴본다.
11. LLM 애플리케이션 개발
문서 기반 질문 응답 서비스를 예로 들어 문제 정의, RAG 그래프 구현, 인용 검증, 평가와 배포까지 연결하는 개발 절차.
10. 테스트: 평가, 모니터링, 개선
LLM 애플리케이션의 회귀 테스트, 오프라인 평가 데이터, 운영 추적과 실패 사례를 개선으로 연결하는 방법.
9. AI 애플리케이션 배포
LangGraph 애플리케이션을 서버로 실행할 때 필요한 구성, 상태 저장, 보안, 스트리밍, 배포 검증과 운영 절차.