목차
멀티모달(Multimodal)
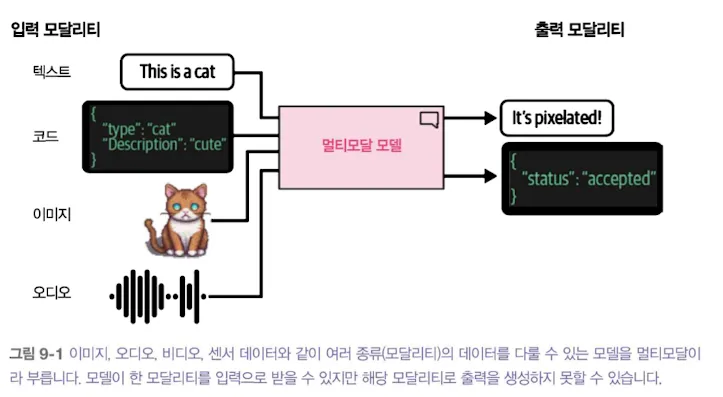
멀티모달 모델은 텍스트뿐 아니라 이미지·음성처럼 형식이 다른 입력을 함께 다룬다. “사진에 고양이가 있는가?”라는 질문을 생각해 보면, 텍스트 모델에는 사진의 픽셀을 바로 넣을 수 없다. 이미지를 모델이 처리할 수 있는 표현으로 바꾸고 텍스트와 연결하는 단계가 필요하다. 이 글에서는 이미지 표현을 만드는 ViT, 이미지와 문장의 관계를 학습하는 CLIP, 이미지 정보를 언어 모델의 생성 입력으로 연결하는 BLIP-2를 순서대로 본다.
flowchart LR
  I[이미지 픽셀] --> V[ViT 등 이미지 인코더]
  V --> E[시각 표현]
  T[문장] --> X[텍스트 인코더]
  X --> F[텍스트 표현]
  E --> C[CLIP: 표현 유사도 비교]
  F --> C
  E --> Q[BLIP-2: Q-Former]
  Q --> L[언어 모델: 답변 생성]
CLIP의 목표는 이미지와 문장이 서로 잘 맞는지 점수화하는 것이다. BLIP-2는 시각 표현을 언어 모델에 전달해 문장을 생성한다. 두 목적을 혼동하면 “CLIP이 이미지 질문에 답변 문장을 직접 쓴다”는 오해가 생긴다.
1. 비전 트랜스포머(ViT: Vision Transformer)
ViT는 큰 데이터로 사전 학습한 뒤 여러 이미지 분류 과제에서 강한 성능을 보였다. 이것이 모든 데이터 규모와 작업에서 CNN보다 항상 낫다는 뜻은 아니다. 입력 이미지의 공간 구조를 패치 시퀀스로 바꾸어 Transformer 인코더에 넣는 설계가 핵심이다.
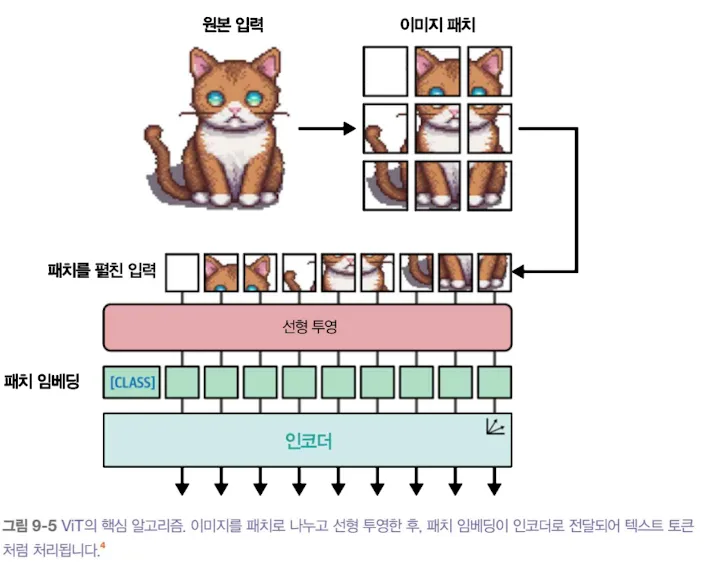
이미지를 패치 벡터의 순서열로 바꾸면 텍스트 토큰을 처리하던 인코더 구조를 이미지에도 적용할 수 있다. 패치가 이미지의 어느 위치에서 왔는지는 별도의 위치 임베딩으로 알려 준다.
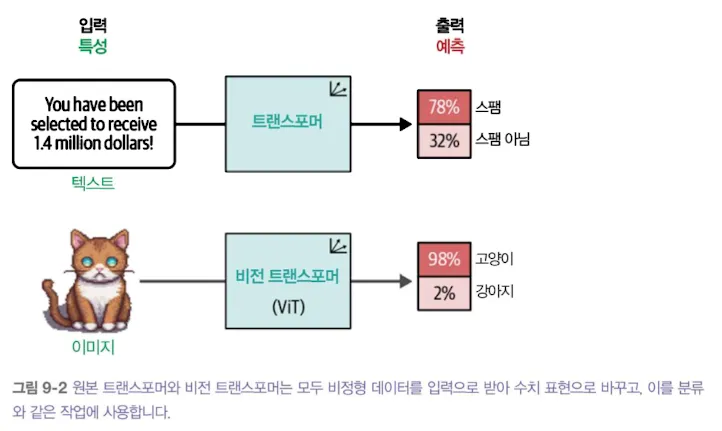
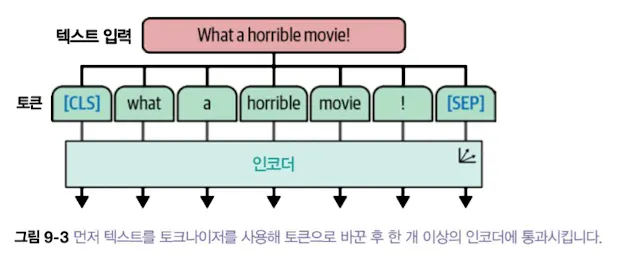
ViT는 트랜스포머 인코더를 사용한다.
- 텍스트 인코더가 단어·토큰을 받듯, 이미지 인코더에도 입력 단위가 필요하다.
이미지는 단어로 구성되어 있지 않으므로 픽셀을 그대로 텍스트 토큰 ID로 바꿀 수는 없다.
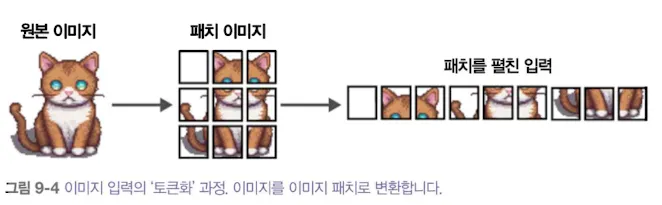
- 대신 이미지를 작은 패치로 나누고 각 패치를 벡터로 투영한다.
- 하나의 패치에는 그 구역의 픽셀 값이 함께 들어간다.
- 패치의 픽셀 배열을 어휘집의 ID처럼 취급하지 않고 수치 벡터로 변환한다.
-
패치를 선형적으로 임베딩하여 수치 표현 임베딩을 만든다.
-
[원본 입력] → [이미지 패치(조각화)] → [패치를 펼친 입력(수평화)] → [선형 투영] → [패치 임베딩] → [인코더]
224×224 RGB 이미지를 16×16 패치로 자른다고 해 보자. 가로와 세로가 각각 14칸이므로 196개 패치가 생긴다. 한 패치의 원시 값은 16×16×3=768개다. 모델은 이를 펼쳐 선형층으로 일정한 크기의 벡터로 투영한다. 패치만 나열하면 모델이 왼쪽 위와 오른쪽 아래를 구별하기 어려우므로 위치 임베딩을 더한다. 분류용 ViT에서는 별도의 분류 토큰을 앞에 붙이고 인코더 출력의 해당 토큰을 분류 헤드에 전달한다.
패치가 작으면 세부 묘사를 더 담을 수 있지만 토큰 수가 늘어 주의 연산 비용이 커진다. 패치가 크면 비용은 줄어도 작은 글씨나 미세한 물체가 사라질 수 있다. 따라서 문서 이미지의 표를 읽는 작업과 일반 사진을 분류하는 작업은 입력 해상도와 패치 크기에 대한 요구가 다르다.
2. 멀티모달 임베딩 모델
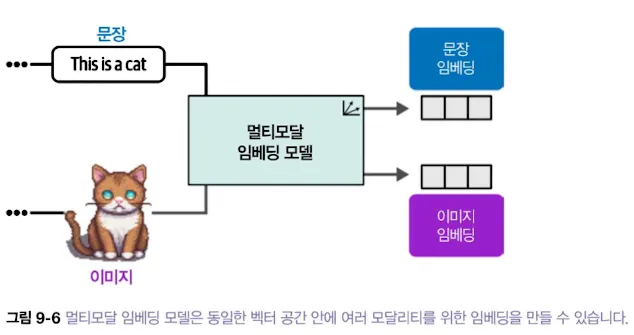
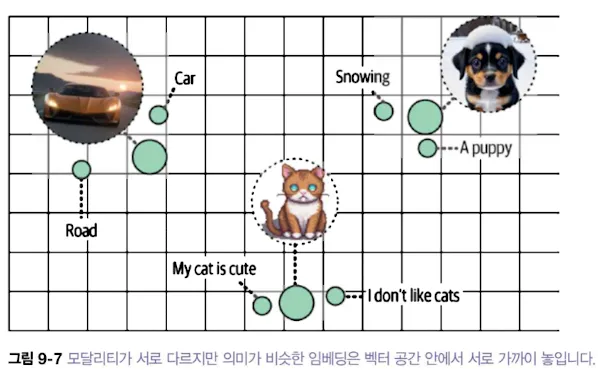
멀티모달 임베딩은 서로 다른 모달리티를 비교 가능한 벡터 공간에 놓는다. 텍스트와 이미지의 원래 형식은 다르지만, “갈색 강아지가 잔디에 앉은 사진”이라는 문장과 해당 사진의 벡터가 가까워지도록 학습할 수 있다.
-
대표적인 모델 중 하나는 CLIP(Contrastive Language-Image Pre-training)이다.
2-1. CLIP: 텍스트와 이미지 연결
CLIP는 이미지와 텍스트의 임베딩을 모두 계산할 수 있는 임베딩 모델이며, 만들어진 임베딩은 동일한 벡터 공간에 놓인다.
- 제로샷 분류 : 이미지 임베딩을 후보 클래스 설명의 임베딩과 비교하여 가장 비슷한 클래스를 찾는 것
- 클러스터링 : 이미지 임베딩을 군집화한 뒤 텍스트 후보와의 유사도로 각 군집을 설명할 수 있다.
- 검색 : 이미지와 텍스트 벡터를 비교해 후보를 찾는다. 대규모 자료에서는 별도의 검색 색인이 필요하다.
- 생성 모델의 구성요소 : 일부 이미지 생성 시스템이 CLIP 계열 텍스트 인코더를 조건 입력으로 사용한다. CLIP 자체가 이미지를 생성하는 것은 아니다.
2-2. CLIP이 멀티모달 임베딩을 생성하는 방법
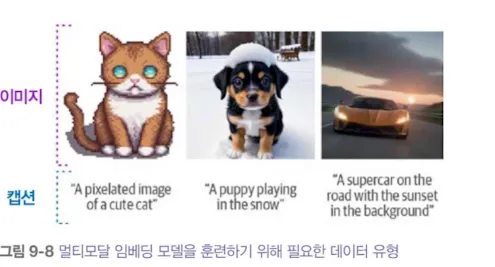
이미지와 캡션이 짝지어진 데이터셋을 생각해 보자. 한 배치에 이미지 3개와 캡션 3개가 있다면 이미지 인코더와 텍스트 인코더가 각각 벡터 3개를 만든다. 두 집합의 유사도를 모두 계산하면 3×3 표가 된다.
-
데이터셋을 사용해 이미지와 캡션에 대해 두 개의 표현을 만들 수 있다.
-
CLIP는 텍스트 인코더를 사용해 텍스트를 임베딩하고 이미지 인코더를 사용해 이미지를 임베딩한다.
-
이미지와 이와 관련된 캡션을 위한 임베딩이 생성됨.
-
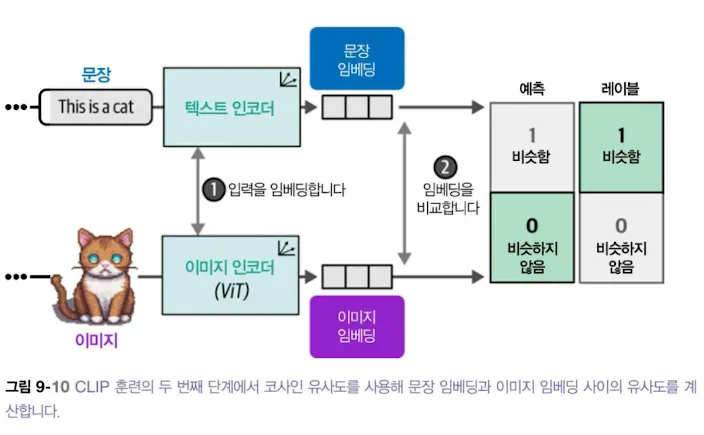
생성된 임베딩 쌍을 코사인 유사도로 비교
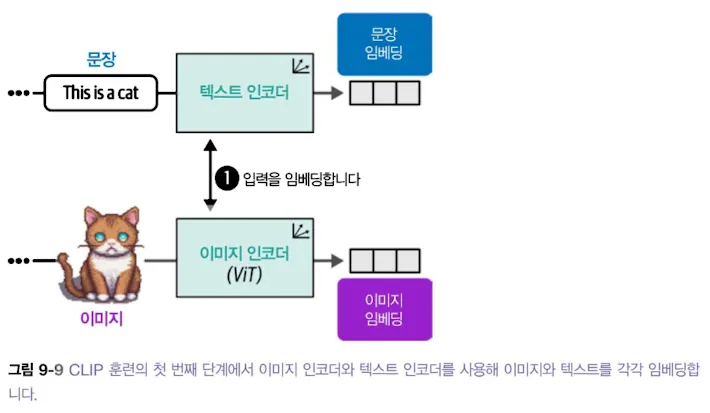
훈련을 시작할 때에는 짝이 맞는 이미지와 문장의 점수가 다른 쌍보다 높다는 보장이 없다.
- 두 인코더가 짝을 구별하도록 아직 충분히 조정되지 않았기 때문이다.
- 훈련하는 동안 임베딩 사이의 유사도를 최적화
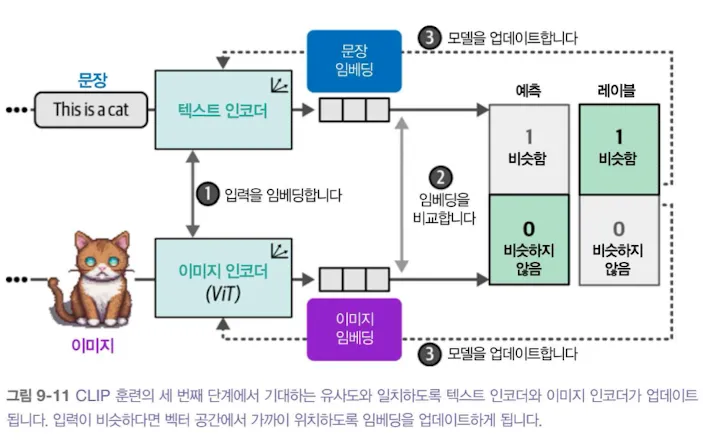
짝이 맞는 세 칸은 대각선에 놓이고, 나머지 여섯 칸은 다른 쌍이다. 대조 학습은 대각선 점수를 상대적으로 높이고 나머지 점수를 낮춘다. 배치 안의 다른 캡션도 실제로는 이미지를 설명할 수 있으므로 “비대각선 = 절대적으로 틀린 문장”으로 해석해서는 안 된다. 학습된 점수는 주어진 후보들 사이의 상대적인 적합도다.
대조 학습(contrastive learning) : 유사도를 계산 후 모델이 업데이트 되고 새로운 배치 데이터와 업데이트된 표현으로 다시 재수행
CLIP으로 후보 문장 비교하기
아래 실습은 로컬 이미지 파일과 후보 문장들의 유사도를 비교한다. 코드를 실행하려면 transformers, torch, Pillow가 필요하고 IMAGE_PATH에 직접 고른 사진 경로를 지정해야 한다. 실행 결과는 이미지에 따라 달라진다.
import os
import torch
from PIL import Image
from transformers import AutoProcessor, CLIPModel

model_id = "openai/clip-vit-base-patch32"
model = CLIPModel.from_pretrained(model_id)
processor = AutoProcessor.from_pretrained(model_id)
image = Image.open(os.environ["IMAGE_PATH"]).convert("RGB")
labels = ["a photo of a dog", "a photo of a cat", "a photo of a bicycle"]
inputs = processor(text=labels, images=image, return_tensors="pt", padding=True)

with torch.no_grad():
    logits = model(**inputs).logits_per_image[0]
scores = logits.softmax(dim=0)

for label, score in sorted(zip(labels, scores.tolist()), key=lambda item: item[1], reverse=True):
print(label, round(score, 3))processor는 이미지 크기와 픽셀 값을 모델 설정에 맞게 전처리하고 문장은 토큰화한다. logits_per_image[0]은 한 이미지와 각 문장의 적합도 점수다. softmax는 이 세 후보 사이의 상대 점수를 합계 1로 만든다. dog의 값이 0.9라도 이미지가 90% 확률로 개라는 보증은 아니다. 후보에 정답 설명이 없으면 틀린 후보 중 하나가 반드시 1위가 된다. 사진의 사람·장소·작은 글자를 정확히 판별하는 데도 한계가 있다.
3. 텍스트 생성 모델을 멀티모달로 만들기
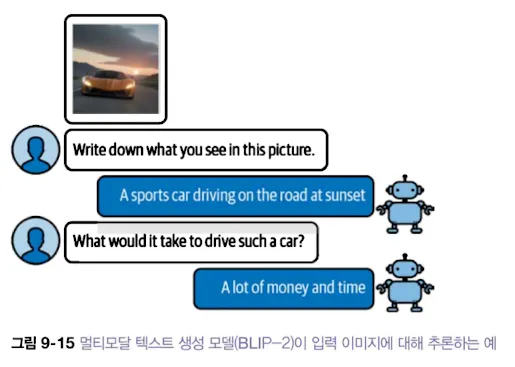
이미지에 관한 열린 질문에 문장으로 답하려면 시각 정보를 생성 모델이 사용할 수 있는 입력으로 전달해야 한다. 위 CLIP처럼 후보만 고르는 점수 모델과 다른 문제다.
텍스트 생성 모델의 경우 특정 입력 이미지에 대해 추론할 수 있다.
두 도메인 사이 간극을 메꾸기 위해 기존 모델에 멀티모달 기능을 추가하려고 했었다.
BLIP-2는 이미지 인코더와 언어 모델 사이에 학습 가능한 연결 모듈을 둔다.
3-1. BLIP-2: 모달리티 간극 메꾸기
밑바닥부터 멀티모달 언어 모델을 만들려면 많은 시간과 노력과 데이터가 필요하다.
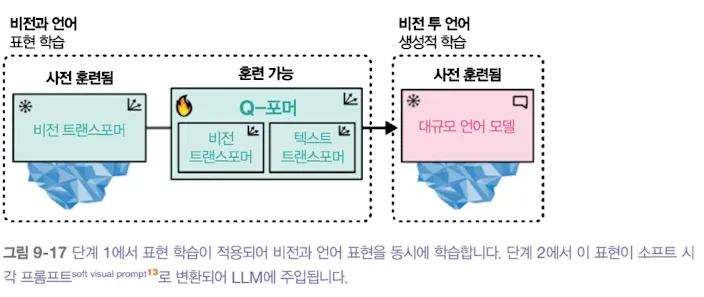
BLIP-2는 밑바닥부터 모델을 구축하는 대신 Q-포머(Querying Transformer)로 비전과 언어 사이의 간극을 메꾼다. 이를 위해 Q-포머는 사전 훈련된 이미지 인코더와 사전 훈련된 LLM 사이에 다리를 연결한다.
BLIP-2는 사전 학습한 이미지 인코더와 언어 모델을 동결하고, 그 사이의 Q-Former와 투영층을 훈련하는 접근을 제안했다. 모든 멀티모달 모델이 이 구조를 쓰는 것은 아니다.
Q-Former에는 이미지 특징을 조회하는 부분과 텍스트를 처리하는 부분이 있으며, 두 부분은 일부 self-attention 층을 공유한다.
- 특성 추출을 위해 동결된 비전 트랜스포머와 상호작용하는 이미지 트랜스포머
- LLM과 상호작용할 수 있는 텍스트 트랜스포머
Q-Former의 학습은 시각·언어 표현을 맞추는 단계와 언어 생성에 연결하는 단계로 나뉜다.
1단계: 이미지-텍스트 쌍으로 시각 표현과 언어 표현을 맞추도록 Q-Former를 훈련
- 데이터 쌍은 일반적으로 이미지 캡션
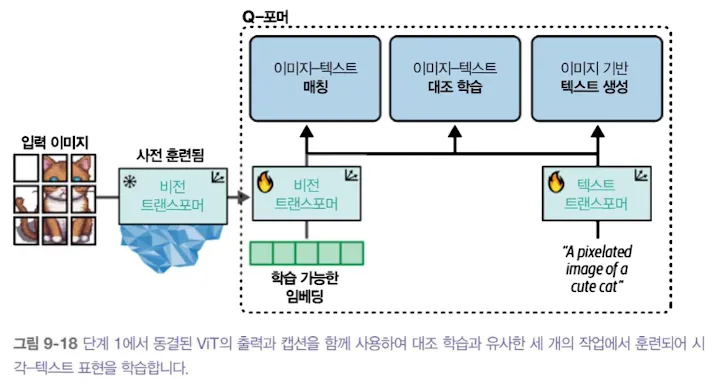
이미지를 동결된 ViT에 주입하여 비전 임베딩을 얻는다. 이 임베딩을 Q-포머의 비전 트랜스포머를 위한 입력으로 사용하고 캡션은 Q-포머의 텍스트 트랜스포머에 입력된다.
Q-포머는 세가지 작업에서 훈련
- 이미지-텍스트 대조 학습: 이 작업은 공동 정보가 최대가 되도록 이미지 임베딩과 텍스트 임베딩 쌍을 정렬
- 이미지-텍스트 매칭: 이미지와 텍스트 쌍이 양성(일치함)인지 음성(일치하지 않음)인지 예측하는 분류 작업
- 이미지 기반 텍스트 생성: 입력 이미지에서 추출한 정보를 바탕으로 텍스트를 생성하기 위해 모델을 훈련
이 세 목적을 통해 Q-Former가 동결된 이미지 인코더의 출력에서 언어 작업에 유용한 정보를 선택하도록 학습한다. 이미지 인코더의 가중치가 바뀌는 것은 아니다.
2단계: 학습한 시각 표현을 언어 모델에 전달
- 이 임베딩은 Q-포머에서 추출한 시각 정보로 LLM에게 조건을 부여하는 소프트 시각 프롬프트로 동작
그 사이에서는 학습 가능한 임베딩을 LLM이 기대하는 크기에 맞추기 위한 완전 연결 층이 있다.
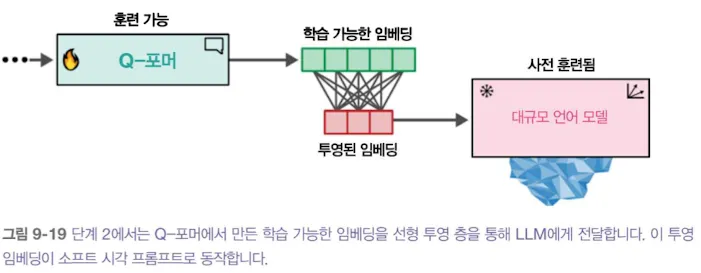
이 두 단계를 거쳐 Q-Former가 이미지에서 언어 작업에 필요한 정보를 뽑고, 투영층은 그 표현을 언어 모델이 받을 수 있는 차원으로 맞춘다. 이때 이미지의 모든 픽셀이 원형 그대로 언어 모델에 들어가는 것이 아니다. 제한된 수의 쿼리 표현으로 압축되기 때문에 작게 적힌 문구나 복잡한 표의 정보가 빠질 수 있다.
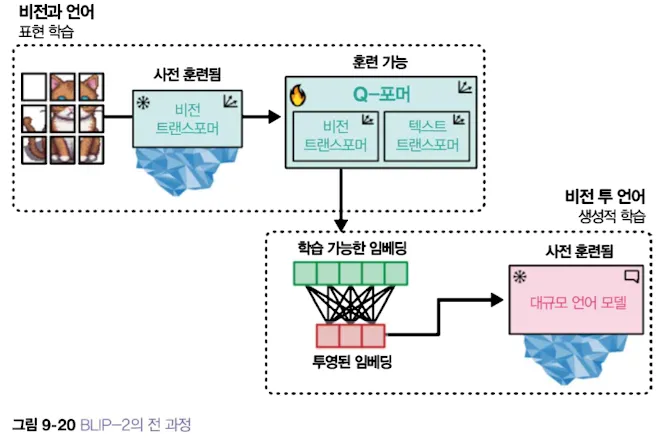
이를 LLM의 소프트 프롬프트로 사용한다. 결과적으로 프롬프트로 LLM에게 문맥을 제공하는 것과 비슷한 방식으로 이미지에 대한 정보를 제공할 수 있다.
어떤 모델을 고를까
이미지 집합에서 “빨간 자전거”와 비슷한 사진을 찾거나 후보 설명을 순위로 정하려면 CLIP형 모델이 맞는다. 한 사진에 대해 “왜 이 장면이 위험한가?”처럼 문장을 생성하려면 이미지 조건부 생성 모델이 필요하다. 단, BLIP-2의 문장도 이미지에 없는 세부 사항을 만들어낼 수 있으므로 중요한 답은 원본 이미지와 대조해야 한다. 특히 숫자, 작은 글씨, 표, 얼굴 식별처럼 실패 비용이 높은 작업에는 별도 OCR·검증 단계가 필요하다.
참고 문서: ViT 원 논문, CLIP 소개, Hugging Face CLIP API, BLIP-2 원 논문