목차
RAG(Retrieval Augmented Generation)
RAG(Retrieval-Augmented Generation)는 검색으로 찾은 자료를 모델 입력에 더해 답변을 생성하는 방식이다. 예를 들어 사내 휴가 규정을 묻는 질문에 모델의 학습 내용만 쓰면 회사별 조항을 알 수 없다. 최신 규정 문서를 찾아 관련 문단을 함께 주면 그 문단을 근거로 답하도록 만들 수 있다. 다만 검색 자료가 틀리거나 모델이 근거를 무시하면 답변도 틀릴 수 있다.
모델은 답을 모를 때에도 유창한 문장을 만들 수 있다. RAG는 관련 문서를 검색해 입력에 넣고, 답변의 주장을 그 문서와 대조할 수 있게 한다. 검색이 실패하거나 문서 자체가 틀리면 RAG를 붙여도 답은 틀릴 수 있다. 차이를 간단히 비교하면 다음과 같다.
| 항목 | 외부 검색 없이 생성 | RAG로 검색 근거를 제공 |
|---|---|---|
| 지식 범위 | 입력 프롬프트와 학습된 내용에 의존 | 색인된 외부 문서를 입력에 추가 가능 |
| 신뢰성 | 근거 없는 주장 가능 | 근거를 대조할 수 있지만 오류가 사라지지는 않음 |
| 업데이트 | 새 문서를 직접 참조하려면 입력 경로나 모델을 바꿔야 함 | 문서와 색인을 갱신해 새 근거를 제공 가능 |
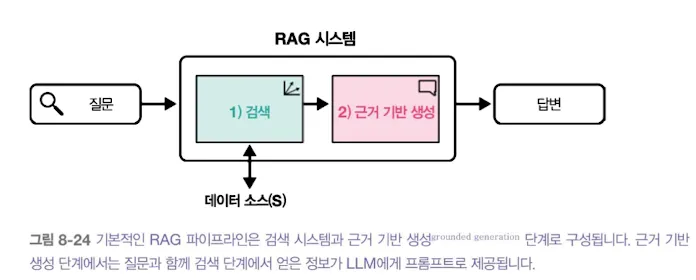
검색과 생성을 분리해서 보면 오류가 발생한 단계를 추적하기 쉽다. 질문에 맞는 문서를 찾았는가, 찾은 문서에 답이 있는가, 모델이 문서에 없는 내용을 보태지 않았는가를 각각 확인할 수 있다.
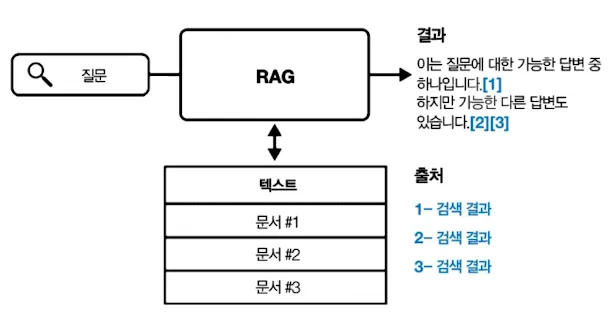
RAG 시스템은 검색과 생성 기능을 통합한다.
질문에 맞는 근거를 찾고 모델이 그 근거를 정확히 사용하면, 외부 자료가 없는 답변보다 사실을 확인하기 쉬워진다. 회사 내부 문서나 특정 데이터에 관해 대화할 수 있지만, 문서 접근 권한과 최신성도 검색 단계에서 관리해야 한다.
RAG가 필요한 이유
- 학습 후 바뀐 규정이나 제품 정보를 모델 재학습 없이 가져올 수 있다. 색인도 갱신되어야 새 문서가 검색된다.
- 답변과 함께 문서 ID·문단·버전을 돌려주면 사용자가 주장을 확인할 수 있다. 출처 표시는 진실 보증이 아니다.
- 접근 권한이 있는 내부 자료를 사용할 수 있다. 사용자별 검색 권한을 적용하고 외부 모델에 전달되는 내용과 로그 보관 정책을 확인해야 한다.
flowchart LR
  A[원본 문서] --> B[정리·분할]
  B --> C[조각 임베딩과 색인]
  Q[사용자 질문] --> R[질문 임베딩·검색]
  C --> R
  R --> S[관련 조각과 출처]
  S --> P[질문과 근거를 프롬프트로 구성]
  P --> G[모델 답변]
  G --> V[출처·근거 일치 검증]
왼쪽은 문서가 바뀔 때 수행하는 색인 과정, 오른쪽은 질문이 들어올 때 수행하는 응답 과정이다. 한 조각이 너무 짧으면 조건과 예외가 갈라지고, 너무 길면 무관한 문장이 함께 들어와 입력 길이와 비용을 늘린다. 조항 번호, 제목, 문서 날짜를 메타데이터로 남겨야 인용과 갱신이 가능하다.
RAG의 작동 단계
RAG 시스템은 크게 3단계로 작동
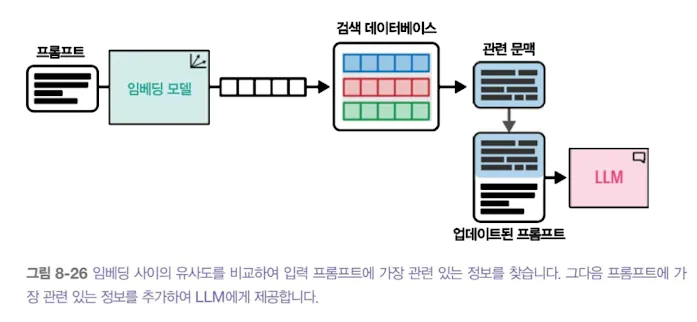
- 검색 (Retrieval): 질문에서 키워드를 추출하거나 임베딩을 계산해 문서 조각을 찾는다. 벡터 검색은 한 방법일 뿐이며, 정확한 규정 번호나 제품 코드는 키워드 검색이 더 잘 찾을 수 있다.
- 증강 (Augmentation): 찾아낸 문서 내용과 사용자의 원래 질문을 하나로 합친다. (예: “다음 내용을 참고해서 질문에 답해줘: [검색된 문서 내용] + [사용자 질문]”)
- 생성 (Generation): 모델이 근거로 답을 작성한다. 문서에 답이 없을 때는 모른다고 말하게 하고, 각 주장에 사용한 조각 ID를 연결한다.
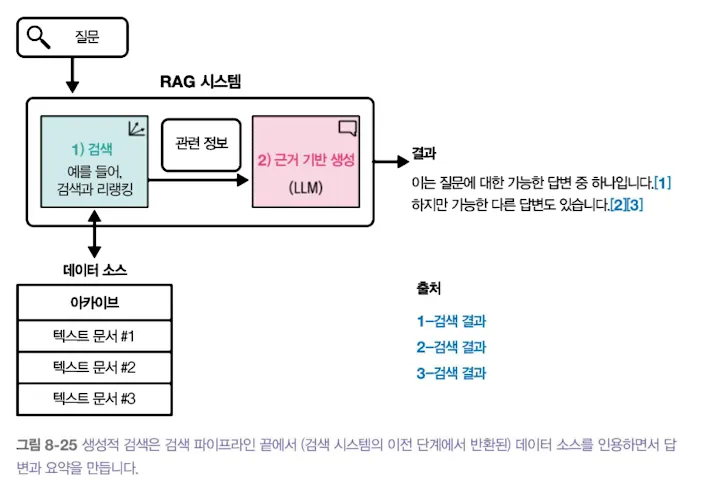
이 생성 단계를 근거 기반 생성(grounded generation)이라고 부른다. LLM에게 제공하는 관련 정보가 특정 맥락을 형성하여 LLM이 우리의 관심 도메인에 기반을 두도록 만들기 때문이다.
예를 들어 질문이 “Interstellar의 미국 첫 개봉 매출은?”이고 검색 결과에 전 세계 누적 수익만 있다면 정확한 미국 첫 개봉 매출은 답할 수 없다. 검색된 수치와 질문의 지표가 다르기 때문이다.
근거를 확인하는 작은 검색 실습
아래는 영화 예제의 두 문장으로 검색 단계만 확인하는 코드다. 대규모 벡터 DB 없이도 질문과 문서 조각의 임베딩을 비교할 수 있다. 모델 파일이나 API 키가 필요하지 않지만 sentence-transformers와 영어 임베딩 모델을 내려받을 환경은 필요하다.
from sentence_transformers import SentenceTransformer

chunks = [
    {"id": "release", "text": "Interstellar premiered on October 26, 2014, in Los Angeles."},
    {"id": "gross", "text": "The film had a worldwide gross over $677 million."},
]
question = "What was Interstellar's worldwide box office gross?"
encoder = SentenceTransformer("BAAI/bge-small-en-v1.5")
texts = [item["text"] for item in chunks]
doc_vectors = encoder.encode(texts, normalize_embeddings=True)
query_vector = encoder.encode([question], normalize_embeddings=True)[0]
scores = doc_vectors @ query_vector
ranked = sorted(zip(scores, chunks), key=lambda item: item[0], reverse=True)
for score, item in ranked:
print(item["id"], round(float(score), 3), item["text"])normalize_embeddings=True로 벡터 길이를 1로 맞추면 내적이 코사인 유사도와 같다. 점수는 정답 확률이 아니라 검색 순위 신호이다. gross 조각이 위에 오르는지 확인하고, 그 문장이 전 세계 수익에만 답한다는 것도 사람이 확인해야 한다. 사용자가 “미국 첫 개봉 매출”을 묻는다면 비슷한 조각이 1위여도 답변 근거는 부족하다.
검색 결과를 생성 모델에 넘길 때는 출처 ID와 답변 규칙을 함께 전달한다. 문서 조각은 외부 입력이므로 그 안의 명령문을 시스템 지시로 취급해서는 안 된다.
질문: Interstellar의 전 세계 수익은 얼마인가?
근거 [gross]: The film had a worldwide gross over $677 million.
규칙: 근거에 있는 수치만 사용하고, 답변에 근거 ID를 표시한다.
예상 답변 형식: 전 세계 수익은 6억 7,700만 달러를 넘었습니다. [gross]
마지막 줄은 실행 출력이 아니라 근거에 맞는 답변 형식 예시다. 실제 모델이 생성한 내용은 별도로 검증해야 한다.
검색 코드에 이어 다음처럼 생성 단계를 연결할 수 있다. LOCAL_CHAT_MODEL에는 사용 가능한 채팅 모델 ID를 지정하고, 모델 구동에 필요한 메모리도 확인한다. 검색 조각은 모델의 지시가 아니라 인용할 자료로 경계를 표시한다.
import os
from transformers import pipeline

evidence = ranked[0][1]
messages = [
    {"role": "system", "content": "제공된 근거로만 답하세요. 답이 없으면 '근거 없음'이라고 하세요. 근거 ID를 표시하세요."},
    {"role": "user", "content": (
        f"질문: {question}\n"
        f"<source id='{evidence['id']}'>\n{evidence['text']}\n</source>"
    )},
]
generator = pipeline("text-generation", model=os.environ["LOCAL_CHAT_MODEL"], device_map="auto")
generated = generator(messages, max_new_tokens=120, do_sample=False, return_full_text=False)
print(generated[0]["generated_text"])ranked[0]은 검색 1위 조각이고, messages는 질문과 그 조각을 별도 역할로 포장한다. 모델은 채팅 템플릿을 통해 이를 토큰으로 바꾼다. 생성 후에는 gross 문장에 있는 전 세계 수익만 답했는지와 인용 ID가 실제 근거를 가리키는지 확인한다. 검색 1위가 질문에 답하지 못하면 생성 호출을 멈추거나 추가 검색해야 한다. 이 검사는 예제 코드에 자동으로 구현되어 있지 않다.
검색 오류와 생성 오류를 나누어 보기
질문 열 개에 대해 정답이 들어 있는 문서 조각을 미리 표시했다고 가정하자. 검색 상위 세 조각에 정답이 들어온 질문이 여덟 개라면 이 예시의 검색 성공률은 8/10이다. 그 여덟 개 중 생성 답변이 근거와 일치한 것이 여섯 개라면, 나머지 두 개는 검색 후 생성 단계에서 실패한 셈이다. 정답 조각이 처음부터 없던 두 질문은 프롬프트만 바꿔서는 고치기 어렵다. 숫자는 설명용이며 이 코드의 실행 결과가 아니다.
오류 표를 만들 때는 질문, 검색된 조각 ID, 정답 조각 ID, 답변의 각 주장과 근거 문장을 함께 남긴다. 검색 실패라면 문서 분할, 색인 누락, 질문 표현, 권한 필터를 살핀다. 검색은 성공했는데 답이 틀렸다면 입력 길이 때문에 근거가 잘렸는지, 모델이 다른 조각의 수치를 섞었는지 확인한다. 두 오류를 하나의 답변 정확도로만 합치면 개선할 단계를 찾기 어렵다.
로컬 모델을 사용한 RAG: 기존 LangChain 실습 읽기
아래는 작성 당시의 LangChain RetrievalQA 기반 실습이다. import 경로와 체인 API는 버전에 따라 달라지므로 실행 환경의 LangChain RAG 문서를 확인해야 한다. 핵심은 FAISS.from_texts가 문장 벡터를 색인하고, as_retriever()가 가까운 문장을 찾아, 프롬프트가 검색 결과를 모델에 전달한다는 데이터 흐름이다.
로컬 모델을 사용한 RAG
import os
from langchain import LlamaCpp, PromptTemplate
from langchain.embeddings.huggingface import HuggingFaceEmbeddings
from langchain.vectorstores import FAISS
from langchain.chains import RetrievalQA

text = """
Interstellar is a 2014 epic science fiction film co-written, directed, and produced by Christopher Nolan.
It stars Matthew McConaughey, Anne Hathaway, Jessica Chastain, Bill Irwin, Ellen Burstyn, Matt Damon, and Michael Caine.
Set in a dystopian future where humanity is struggling to survive, the film follows a group of astronauts who travel through a wormhole near Saturn in search of a new home for mankind.

Brothers Christopher and Jonathan Nolan wrote the screenplay, which had its origins in a script Jonathan developed in 2007.
Caltech theoretical physicist and 2017 Nobel laureate in Physics[4] Kip Thorne was an executive producer, acted as a scientific consultant, and wrote a tie-in book, The Science of Interstellar.
Cinematographer Hoyte van Hoytema shot it on 35 mm movie film in the Panavision anamorphic format and IMAX 70 mm.
Principal photography began in late 2013 and took place in Alberta, Iceland, and Los Angeles.
Interstellar uses extensive practical and miniature effects and the company Double Negative created additional digital effects.

Interstellar premiered on October 26, 2014, in Los Angeles.
In the United States, it was first released on film stock, expanding to venues using digital projectors.
The film had a worldwide gross over $677 million (and $773 million with subsequent re-releases), making it the tenth-highest grossing film of 2014.
It received acclaim for its performances, direction, screenplay, musical score, visual effects, ambition, themes, and emotional weight.
It has also received praise from many astronomers for its scientific accuracy and portrayal of theoretical astrophysics. Since its premiere, Interstellar gained a cult following,[5] and now is regarded by many sci-fi experts as one of the best science-fiction films of all time.
Interstellar was nominated for five awards at the 87th Academy Awards, winning Best Visual Effects, and received numerous other accolades"""

# 문장을 나누어 리스트로 만듭니다.
texts = text.split('.')

# 공백과 줄바꿈 문자를 삭제합니다.
texts = [t.strip(' \n') for t in texts]

## 생성 모델 로드
llm = LlamaCpp(
    model_path=os.environ["LOCAL_GGUF_MODEL"],
    n_gpu_layers=-1,
    max_tokens=500,
    n_ctx=2048,
    seed=42,
    verbose=False,
)

## 임베딩 모델 로드
embbeding_model = HuggingFaceEmbeddings(model_name='BAAI/bge-small-en-v1.5')

## 벡터 데이터베이스 구축
db = FAISS.from_texts(texts, embbeding_model)

## 프롬프트 템플릿 생성
template = """
<|user|>
Relevant information:
{context}
Provide a concise answer the following question using the relevant information provided above:
{question}<|end|>
<|assistant|>
"""
prompt = PromptTemplate(template=template, input_variables=["context", "question"])

## RAG 파이프라인
rag = RetrievalQA.from_chain_type(
    llm=llm,
    chain_type="stuff",
    retriever=db.as_retriever(),
    chain_type_kwargs={
        "prompt": prompt
    },
    verbose=True
)

response = rag.invoke('What was the worldwide box office gross of Interstellar?')

print(response)
원래 Income generated 질문은 전 세계 박스오피스인지 총수입인지 불명확했고, 게시된 출력은 본문에 수익 문장이 있는데도 수익 정보가 없다고 말해 성공 사례로 사용할 수 없었다. 질문을 구체화했지만 새 코드를 실행한 결과를 여기서 주장하지 않는다. text.split('.')는 약어와 소수점까지 자르므로 실무에서는 문단·문장 경계를 보존하는 분할기를 사용한다. LOCAL_GGUF_MODEL에는 사용자가 보유한 GGUF 경로를 지정해야 한다.
검색이 빗나갈 때
“그 영화가 얼마 벌었어?”처럼 대화 앞부분의 제목을 생략하면 검색 질문만으로 작품을 특정할 수 없다. 대화에서 제목을 복원해 검색용 질문을 재작성할 수 있다. “첫 개봉일과 총수익을 비교해 줘”는 날짜와 수익이 다른 조각에 있으므로 두 종류의 문서를 검색해야 한다. 질문 재작성은 원래 뜻을 바꿀 위험이 있으므로 재작성 결과도 기록해 둔다.
사내 문서라면 문서 ID와 최신 버전 외에도 사용자 권한을 검색 전에 필터링해야 한다. 검색 후 프롬프트에서만 숨기면 권한 없는 조각이 이미 모델 입력이나 로그에 남을 수 있다.
고급 RAG 기술
- 쿼리 재작성
- RAG 시스템이 챗봇이라면 앞서 본 간단한 RAG 구현은 질문이 장황하거나 이전 대화에서 맥락을 찾는 경우 검색 단계에서 문제가 있을 수 있다.
- 올바른 정보를 얻도록 LLM을 사용해 쿼리를 재작성하는 것이 좋다.
- 멀티 쿼리 RAG
- 특정 질문에 답하기 위해 한 개 이상의 쿼리가 필요한 경우 여러 개의 쿼리를 검색할 수 있도록 쿼리 재작성을 확장하는 것을 말한다.
- 멀티 홉(multi-hop) RAG
- 더 고급 질문에는 일련의 순차적인 쿼리가 필요할 수 있다.
- 쿼리 라우팅(routing)
- 모델에게 여러 데이터 소스를 검색할 수 있는 능력을 주는 것이다.
- 에이전트 RAG
- 개선 사항들은 점점 더 복잡한 문제를 해결하기 위해 더 많은 책임을 LLM위임
- 필요한 정보 요구사항을 파악하는 것과 여러 데이터 소스를 활용하는 LLM의 능력에 달려 있다.
- 이런 새로운 특징은 LLM을 세상과 상호작용하는 에이전트에 점점 더 가깝게 만든다.
RAG 평가
RAG는 검색과 생성을 따로 평가해야 실패 원인을 알 수 있다. 정답 근거가 알려진 질문 묶음을 만들고, 상위 k개 검색 결과에 그 근거가 있는지 확인한다. 이어서 답변의 각 주장과 인용 조각을 사람이 대조한다. 정답 근거가 없는 질문도 넣어야 거절 동작을 확인할 수 있다.
- 유창성 : 생성된 텍스트가 자연스럽고 일관성이 있는지 여부
- 인지된 유용성 : 생성된 답변이 도움이 되고 유익한지 여부
- 인용 재현율 : 검증이 필요한 주장 중 근거 인용이 붙은 비율
- 인용 정밀도 : 붙은 인용 중 실제로 해당 주장을 뒷받침하는 비율
Ragas 같은 평가 도구는 여러 축의 점수를 계산하는 데 도움을 준다. 자동 점수만으로 정확성을 확정하지 말고, 오류가 큰 사례는 질문·검색 조각·완성 답변을 함께 읽어야 한다.
- 충실도 : 답변이 제공된 문맥과 일치하는지 여부
- 답변 관련성 : 답변이 질문과 얼마나 관련이 있는지 정도
예를 들어 전 세계 수익 질문에 대한 검색 결과가 개봉일 조각뿐이면 검색 실패다. 수익 조각은 검색했는데 답이 “수익 자료가 없다”라면 생성 또는 문맥 구성 실패다. 수익 숫자는 맞지만 다른 문서를 인용했다면 인용 실패다. 셋을 분리해야 청크 크기를 조정할지, 검색 방식을 바꿀지, 답변 형식을 고칠지 결정할 수 있다.
참고 문서: RAG 원 논문, FAISS 기본 사용법, LangChain RAG 개요
같은 카테고리의 글
이어서 읽을 글
12. 벡터 데이터베이스로 확장하기 : RAG 구현하기
pgvector 예제로 벡터 저장과 색인, 권한 필터, 근거 기반 답변까지 RAG 흐름을 구현합니다.
11. 자신의 데이터에 맞춘 임베딩 모델 만들기 : RAG 개선하기
질문·문서 쌍으로 임베딩 모델을 미세 튜닝하고 RAG 검색과 답변 품질을 평가하는 방법을 정리합니다.
3. RAG 2단계 : 데이터 기반 대화
인덱싱한 문서를 검색해 답변의 근거로 쓰고, 질의 재작성·다중 검색·라우팅으로 검색 품질을 개선하는 방법을 다룬다.
2. RAG 1단계 : 데이터 인덱싱
RAG에 쓸 문서를 불러와 청크로 나누고 임베딩·벡터 저장소에 색인하는 과정과 문서 변경 추적 방법을 살펴본다.