목차
Apache ZooKeeper 개념
Apache ZooKeeper는 분산 애플리케이션이 설정, 구성원 정보, 동기화에 필요한 작은 상태를 공유하도록 돕는 조정 서비스다. 이름은 “사육사”라는 뜻이다. 파일 시스템과 비슷한 경로 구조를 갖지만, 큰 파일을 저장하는 범용 저장소로 생각하면 안 된다. 각 경로의 데이터 노드를 znode라고 부른다.
이 글은 Kafka를 공부하며 적었던 ZooKeeper 메모를 보완한 것이다. Kafka 3.x의 ZooKeeper 모드를 이해할 때는 유용하지만, Kafka 4.0부터는 ZooKeeper 모드가 제거되어 KRaft만 지원한다. 따라서 새로운 Kafka 클러스터의 설치 지침으로 읽기보다는 이전 구조와 마이그레이션 배경을 이해하는 자료로 보면 된다.
znode와 세션
ZooKeeper의 네임스페이스는 /services/api/instance-1 같은 경로로 구성된다. znode에는 작은 데이터와 자식 znode가 있을 수 있다. 클라이언트는 경로를 읽고 쓰며, 변경을 알고 싶으면 watch를 등록한다.
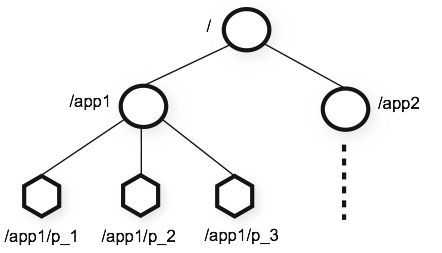
원래 메모의 “파일 시스템 trie와 비슷하다”는 표현은 계층 구조를 이해하는 데 도움이 된다. 다만 일반 파일처럼 큰 내용을 넣는 용도가 아니라 상태와 조정 정보를 두는 데 적합하다. 임시 znode(ephemeral znode)는 이를 만든 클라이언트의 세션이 끝나면 삭제된다. 예를 들어 살아 있는 서버의 등록 정보를 임시 znode로 두면 세션이 종료됐을 때 구성원 목록에서도 사라지게 할 수 있다. 일반 watch는 변경을 알려 준 후 해제되므로 계속 감시하려면 다시 등록해야 한다. ZooKeeper 개요에 데이터 모델과 watch가 설명되어 있다.
앙상블과 복제
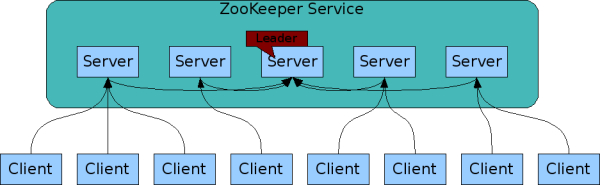
서버 여러 대로 구성한 ZooKeeper 집합을 앙상블(ensemble)이라고 한다. 클라이언트는 한 서버에 연결해 요청을 보내지만, 서버들은 상태를 복제한다. 쓰기 요청은 리더를 거쳐 합의 절차를 밟고, 읽기는 연결한 서버의 복제본에서 처리할 수 있다.
flowchart LR
    C[클라이언트] --> F1[ZooKeeper 서버 A]
    F1 --> L[리더: 쓰기 순서 결정]
    L --> F1
    L --> F2[ZooKeeper 서버 B]
    L --> F3[ZooKeeper 서버 C]
    F1 --> W[watch 알림]
    W --> C
그림은 세 서버 앙상블의 개념도다. 리더와 팔로어의 역할은 장애 시 바뀔 수 있다. 서버가 여러 대라고 해서 한 대만 살아 있어도 계속 쓰기가 가능한 것은 아니다. 공식 개요는 다수 서버가 사용 가능해야 서비스가 유지된다고 설명한다.
메모의 네 가지 특징 다시 보기
| 특징 | 의미 | 주의할 점 |
|---|---|---|
| Simple | 계층형 경로와 작은 API로 상태를 관리 | 대용량 데이터를 저장하는 파일 시스템은 아님 |
| Replicated | 여러 서버가 상태를 복제 | 다수 서버의 가용성이 중요 |
| Ordered | 업데이트 순서를 기록 | 클라이언트 로직도 순서와 버전을 고려해야 함 |
| Fast | 읽기가 많은 작업에 적합 | 쓰기는 합의가 필요하므로 비용이 다름 |
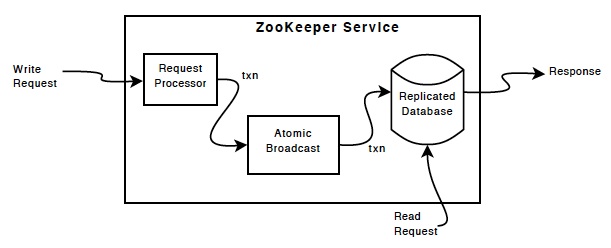
위 그림의 서버들은 데이터 트리와 트랜잭션 로그를 유지한다. 원래 메모의 “요청 처리기를 제외한 구성 요소가 복제된다”는 설명은 공식 구현 설명에 나온다. 이 구조를 이해하면 Kafka의 예전 ZooKeeper 모드가 왜 별도 앙상블의 상태와 가용성에 의존했는지 알 수 있다. 기존 클러스터를 운영한다면 현재 버전을 확인하고 Kafka의 공식 마이그레이션 절차를 기준으로 계획해야 한다.
같은 카테고리의 글
이어서 읽을 글
Kafka에 Spark 스트리밍 연결
Kafka 데이터를 Spark Structured Streaming으로 읽는 흐름을 살펴보고, 오프셋·체크포인트·출력 저장소의 복구 역할을 구분한다.
kafka에 Storm 연결하기
KafkaSpout에서 Bolt로 메시지가 전달되는 과정을 따라가며, 커넥터 설정과 오프셋·재처리·중복 처리 문제를 살펴본다.
Kafka REST Proxy
Confluent REST Proxy의 HTTP API로 Kafka 메시지를 보내고 구독·조회하며, 컨슈머 정리와 v2·v3의 차이를 살펴본다.
[Kafka] 8. Spring Boot를 이용한 Kafka API 구축
Spring Boot에서 Kafka 메시지를 발행·소비하는 API를 구성하고, HTTP 응답과 비동기 메시지 처리 시점의 차이를 살펴본다.