목차
랭체인(LangChain)
LLM과 프롬프트 구성요소와 툴을 제공하는 오픈소스. ML 배경이 없어도 랭체인을 사용해 AI 챗봇부터 AI 에이전트까지 다양한 애플리케이션 구축 가능 라이브러리
[장점]
- 프롬프트는 서로 결합할 때 가장 효과적인데, 랭체인은 이 아이디어를 기반으로 설계되어 있어, 주요 프롬프트 작성 기법을 간단한 추상화(abstraction)로 제공해 프롬프트를 쉽게 결합할 수 있다.
- 주요 LLM업체(오픈AI, 구글 등) 및 오픈소스 등과의 통합을 제공
- 프롬프트 템플릿 추상화를 제공함으로 프롬프트를 여러 번 재사용 할 수 있다.
- RAG를 구현 할 수 있도록 주요 임베딩 모델, 벡터 저장소, 벡터 인덱스와의 통합을 제공
- LangGraph를 통해 상태와 도구 호출을 가진 작업 흐름을 그래프로 구성할 수 있다.
- 랭체인의 오케스트레이션 기능은 여러 구성 요소를 활용한 LLM 애플리케이션을 구축하는데 유용
- 모든 주요 구성 요소는 관측 간으성을 확보하기 위해 콜백 시스템으로 계측
- 모델·프롬프트·파서 등 주요 구성 요소는 Runnable 인터페이스로 연결할 수 있다.
- 체크포인터를 설정한 LangGraph 작업은 상태를 저장하고 재개할 수 있다.
랭체인 기본 LLM 사용법
LLM애플리케이션을 만들 때 가장 어려운 것은 프롬프트를 효과적으로 작성해 LLM에 전달하고 LLM의 예측 결과를 처리해 정확한 출력으로 반환하는 것.
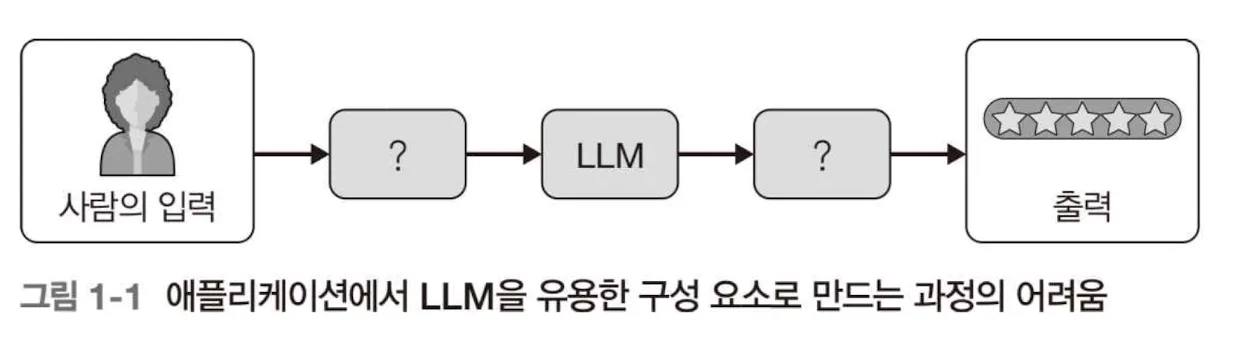
랭체인은 대부분 LLM 제공업체와 상호작용하는 두 가지 인터페이스를 제공
- 채팅 모델
- 기본 LLM
- 기본 LLM 인터페이스는 문자열 프롬프트를 입력받아 입력을 기본 LLM에 전송한 후, 다음에 이어질 표현을 예측해 출력으로 반환
[기본LLM 호출]
아래 OpenAI 코드는 문자열 완성(text completion) 모델을 이해하기 위한 예시다. 실제 애플리케이션에서 사용할 모델의 제공 여부와 이름은 공급자 문서에서 확인해야 한다. 채팅 모델 이름을 이 클래스에 그대로 넣으면 요청 형식이 맞지 않는다. 키와 모델 이름은 환경 변수로 전달한다.
Open AI
from langchain_openai.llms import OpenAI
from dotenv import load_dotenv
import os

load_dotenv()

model = OpenAI(
    model=os.environ['OPENAI_COMPLETION_MODEL'],
    temperature=0.5,
)

print(model.invoke('안녕하세요'))
Gemini는 메시지 기반 채팅 모델이므로 기본 LLM 예제가 아니라 아래 채팅 모델 절에서 사용한다.
문자열 완성 모델은 입력 문자열에서 다음 텍스트를 생성한다. 채팅 모델은 역할이 지정된 메시지 목록을 받으며, 출력은 보통 AIMessage다. 그 안의 content가 항상 단순 문자열이라고 가정하지 말고 통합 모델의 출력 계약을 확인한다.
기본 LLM과 달리 채팅 모델 인터페이스는 사용자와 모델이 양방향 대화를 주고 받는다.
별도의 인터페이스를 제공하는 이유는 제미나이 같은 사용자가 많은 LLM 제공업체가 메시지를 user(사용자), assistant(어시스턴트), system(시스템) 같은 역할로 구분하기 때문이다.
- system: 사용자 질문에 답변하는데 사용하는 지시사항
- user: 사용자 쿼리와 사용자가 생성한 그 밖의 모든 컨텐츠
- assistant: 채팅 모델이 생성한 컨텐츠
채팅 모델 인터페이스로 AI 챗봇 애플리케이션에서 구성을 쉽게 변환하고 관리할 수 있다.
[채팅 모델 호출]
Open AI
from langchain_core.messages import HumanMessage
from langchain_core.messages import SystemMessage
from langchain_openai import ChatOpenAI
from dotenv import load_dotenv
import os

load_dotenv()

##채팅 모델 호출
model = ChatOpenAI(model=os.environ['OPENAI_CHAT_MODEL'])
## HumanMessage: 사용자 역할인 인간 관점으로 작성한 메시지
human_prompt = HumanMessage('한국의 수도는 어디인가요?')
## SystemMessage : 시스템 역할인 AI가 준수할 지침을 설정하는 메시지
sys_prompt = SystemMessage('정확하고 간결한 한국어로 답하세요.')
print(model.invoke([sys_prompt, human_prompt]).content)
Gemini
from langchain_google_genai.chat_models import ChatGoogleGenerativeAI
from langchain_core.messages import HumanMessage, SystemMessage
from dotenv import load_dotenv
import os

load_dotenv()
##채팅 모델 호출
model = ChatGoogleGenerativeAI(model=os.environ['GOOGLE_CHAT_MODEL'])
## HumanMessage: 사용자 역할인 인간 관점으로 작성한 메시지
human_prompt = HumanMessage('한국의 수도는 어디인가요?')
## SystemMessage : 시스템 역할인 AI가 준수할 지침을 설정하는 메시지
sys_prompt = SystemMessage('정확하고 간결한 한국어로 답하세요.')
print(model.invoke([sys_prompt, human_prompt]).content)
채팅 모델은 하나의 프롬프트 문자열 대신 각 역할에 따른 형태의 메시지 인터페이스를 이용
- HumanMessage: 사용자 역할인 인간 관점으로 작성한 메시지
- AIMessage : 어시스턴트 역할인 AI 관점으로 작성한 메시지
- SystemMessage : 시스템 역할인 AI가 준수할 지침을 설정하는 메시지
- ChatMessage: 임의의 역할을 설정하는 메시지
채팅모델은 사용자 질문에는 포함하지 않았던 SystemMessage 내의 지시를 따른다. 사용자 입력을 바탕으로 AI 애플리케이션이 비교적 예측 가능한 방식으로 응답을 하도록 미리 설정이 가능하다.
한국의 수도는 서울입니다.이 출력은 메시지 역할을 설명하기 위한 예시다. 시스템 지시를 추가했다고 해서 사실성이 보장되지는 않는다. 날짜·가격·날씨처럼 바뀌는 정보는 외부 데이터와 검증 단계가 필요하다.
LLM 프롬프트 템플릿
프롬프트는 LLM이 컨텍스트를 이해하고, 질의에 적절한 답변을 생성하도록 유도한다.
프롬프트가 단순한 문자열처럼 보이지만, LLM이 필요한 내용을 판단하고 입력에 따라 다른 결과를 내도록 만들어야 한다.
현재까지는 컨텍스트(Context)와 질문(Question)을 하드코딩.
랭체인은 동적 입력으로 프롬프트를 손쉽게 수정하는 프롬프트 템플릿 인터페이스를 제공
[프롬프트 템플릿]
정적(static) 프롬프트를 동적 프롬프트로 생성
from langchain_core.prompts import PromptTemplate

template = PromptTemplate.from_template('''
    아래 작성한 컨텍스트(Context)를 기반으로 질문(Question)에 대답하세요. 제공된 정보롤 대답할 수 없는 질문이라면 "모르겠어요" 라고 대답하세요.

    Context: {context}

    Question: {question}

    Answer: '''
)

response = template.invoke({
    'context': '''대한민국의 수도는 서울 입니다.''',
    'question': '''대한민국의 수도는 어디 입니까?'''

})
print(response)
[출력]
text='\n 아래 작성한 컨텍스트(Context)를 기반으로 질문(Question)에 대답하세요. 제공된 정보롤 대답할 수 없는 질문이라면 "모르겠어요" 라고 대답하세요.\n \n Context: 대한민국의 수도는 서울 입니다.\n \n Question: 대한민국의 수도는 어디 입니까?\n \n Answer: 'template은 최종 프롬프트의 구조와 동적 입력이 삽입될 위치에 대한 정의를 구성. 따라서 템플릿은 여러 개의 정적이고 구체적인 프롬프트를 제작하는 재료로 사용가능하며, 특정 값을 사용하여 프롬프트를 채워 LLM에 입력할 정적 프롬프트를 생성할 수 있다.
동적(dynamic)프롬프트 생성
from langchain_core.prompts import PromptTemplate
from langchain_google_genai import ChatGoogleGenerativeAI
import os

## 정적 프롬프트 생성

template = PromptTemplate.from_template('''
    아래 작성한 컨텍스트(Context)를 기반으로 질문(Question)에 대답하세요. 제공된 정보롤 대답할 수 없는 질문이라면 "모르겠어요" 라고 대답하세요.

    Context: {context}

    Question: {question}

    Answer: '''
)

prompt = template.invoke({
    'context': '''랭체인(LangChain)은 대규모 언어 모델(LLM)을 기반으로 하는 애플리케이션 개발을 쉽게 만들어주는 오픈소스 프레임워크로, LLM을 외부 데이터 소스와 연결하고 복잡한 다단계 작업을 수행할 수 있도록 돕는 다양한 도구와 구성 요소를 제공합니다. 이름처럼 언어 모델(Language Model)과 외부 데이터/도구를 '사슬(Chain)'처럼 연결해, 챗봇, 가상 에이전트 등 실제 사용 가능한 AI 앱을 만들 수 있게 해줍니다. ''',
    'question': '''랭체인이란?'''
})

model = ChatGoogleGenerativeAI(
    model=os.environ['GOOGLE_CHAT_MODEL'],
    temperature=0.5,
    max_tokens=300
)

print(model.invoke(prompt))
AI 채팅 애플리케이션을 구축한다면, ChatPromptTemplate을 활용해 채팅 메시지의 역할에 따른 동적 프롬프트를 제공할 수 있다.
from langchain_core.prompts import ChatPromptTemplate
from langchain_google_genai import ChatGoogleGenerativeAI

import os

template = ChatPromptTemplate.from_messages([
    ("system", '''
    아래 작성한 컨텍스트(Context)를 기반으로 질문(Question)에 대답하세요. 제공된 정보롤 대답할 수 없는 질문이라면 "모르겠어요" 라고 대답하세요.
    '''),
    ('human','Context: {context}'),
('human','Question: {question}')
])

prompt = template.invoke({
    'context': '''
        거대 언어 모델(LLM)은 자연어 처리(NPL) 분야의 최신 발전을 이끌고 있습니다.
        거대 언어 모델은 더 작은 모델보다 우수한 성능을 보이며
        NLP 기능을 갖춘 애플리케이션을 개발하는 개발자들에게 매우 중요한 도구가 되었습니다.
        개발자들은 Hugging Face의 'transformers' 라이브러리르 활용하거나,
        'openai' 및 'cohere' 라이브러리를 통해 OpenAI와 Cohere의 서비스를 이용하여
         거대 언어 모델을 활용할 수 있습니다.
    ''',
    'question': '거대 언어 모델은 어디서 제공하나요?'
})

print(prompt)

##채팅 모델 호출
model = ChatGoogleGenerativeAI(model=os.environ['GOOGLE_CHAT_MODEL'])

response = model.invoke(prompt)

print(response)
LLM에서 특정 형식의 답변 지정
LLM을 사용하면서 구조화된 형식(Structured Format)의 출력이 필요할 때가 있다.
JSON 출력
from langchain_ollama import ChatOllama
from  pydantic import BaseModel

class AnswerWithJustification(BaseModel):
    '''사용자 질문에 대한 답변과 그에 대한 근거(justification)를 함께 제공하세요.'''
    answer: str
    '''사용자 질문에 대한 답변'''
    justification: str
    '''답변에 대한 근거'''

llm = ChatOllama(
    model="gemma3:12b",
    temperature=0.5,
)
structured_llm = llm.with_structured_output(AnswerWithJustification)

result = structured_llm.invoke('''1 킬로그램의 벽돌과 1 킬로그램의 깃털 중 어느 쪽이 더 무겁나요?''')

print(result.model_dump_json())
[출력]
{"answer":"둘 다 똑같이 무겁습니다. 둘 다 1킬로그램입니다.","justification":"질문은 속임수입니다. 무게는 질량과 같습니다. 둘 다 1킬로그램이므로 무게도 같습니다."}기계 바로 이해할 수 있는 형식과 출력 파서
LLM 또는 채팅 모델이 CSV나 XML 같은 다른 형식의 출력물을 생성하도록 지시할 수 있다. 이런 것을 출력 파서(Output Parser)라고 하는데, LLM 응답을 구조화하는 클래스다.
- 출력 형식 지정 : 프롬프트에 추가 지시 사항을 삽입해, LLM이 파싱하기 좋은 형식으로 텍스트를 출력하도록 유도
- 출력 검증 및 파싱 : 모델의 텍스트를 구조화된 값으로 변환한다. 파서가 있다고 해서 깨진 출력이 자동으로 안전하게 복구되는 것은 아니다. 실패한 요청은 명시적으로 처리한다.
from langchain_core.output_parsers import CommaSeparatedListOutputParser

parser = CommaSeparatedListOutputParser()
items = parser.invoke("apple, banana, cherry")
print(items)['apple', 'banana', 'cherry']구성요소를 조합한 LLM 애플리케이션
어떤 요소를 결합해야 좋은 LLM 애플리케이션을 구축할가?
1. Runnable 인터페이스
위 예시는 모델, 프롬프트 템플릿, 출력 파서 등 서로 다른 구성요소를 호출 했지만, 유사한 인터페이스와 invoke() 메서드를 사용. 랭체인의 핵심 구성요소는 다음과 같은 공통점을 갖는다.
- 공통 인터페이스를 사용
- invoke : 하나의 입력을 하나의 출력으로 반환
- batch: 여러 입력 리스트를 받아 출력 리스트로 반환
- stream: 하나의 입력을 받아 출력의 일부가 준비되는 대로 반환을 반복
- 재시도, 폴백, 스키마 및 런타임을 구성
- 파이썬의 세 메서드는 각각 asyncio 전용 비동기 메서드를 지원
같은 메서드 이름을 쓸 수 있어도 입력·출력 타입과 스트리밍 지원 범위는 구성 요소마다 다르다. 예를 들어 PromptTemplate.invoke()는 프롬프트 값을, 채팅 모델의 invoke()는 메시지를 반환한다. 아래 긴 메시지 덤프는 과거 호출 결과의 형식을 보여주는 기록이며, 모델 버전과 실행 환경에 따라 내용과 메타데이터가 달라진다.
아래처럼 같은 모델에서 세 메서드를 호출할 수 있다. batch()는 여러 질문을 처리하지만 공급자·설정에 따라 내부 실행 방식이 다르다.
import os
from langchain_ollama import ChatOllama

model = ChatOllama(model=os.environ["OLLAMA_CHAT_MODEL"])
one = model.invoke("안녕하세요")
many = model.batch(["안녕하세요", "자기소개를 해 주세요"])
for chunk in model.stream("안녕하세요"):
    print(chunk.content, end="")
기존 실행 기록에서 invoke()는 AIMessage 하나를, batch()는 메시지 목록을, stream()은 여러 AIMessageChunk를 돌려줬다. 예를 들어 스트림 기록에는 content='네', content=','처럼 나뉜 조각과 마지막 메타데이터가 있었다. 조각마다 완성된 답변이나 사용량 정보가 들어 있는 것은 아니다. 화면에는 조각의 content를 이어 붙이고, 완료 후 사용량과 종료 사유를 따로 읽어야 한다.
컴포넌트가 반복 출력을 지원하지 않아 모든 출력을 하나로 모와 구성하는 경우 두 가지 방식
- 명령형 : 직접 model.invoke(…) 같은 메서드로 구성요소를 호출
- 선언형 : 랭체인 표현 언어(LCEL:Langchain Expression Language)를 사용
[명령적 구성과 선언적 구성의 주요 차이점]
| 명령형 | 선언형 | |
|---|---|---|
| 문법 | 파이썬 / 자바스크립트 | LCEL |
| 병렬실행 | 파이썬: 스레드 혹은 코루틴 사용 | 자동 |
| 자바스크립트: Promise.all 사용 | 자동 | |
| 스트리밍 | yield 사용 | 자동 |
| 비동기 | 비동기 함수 사용 | 자동 |
2. 명령형 구성
명령형 구성(imperative composition)은 단지 익숙하게 코드를 작성하는 방식의 다른 이름으로, 각 구성 요소를 함수와 클래스로 결합하는 행위를 말한다.
# 구성요소 -> 함수로 결합 -> 실행
from langchain_ollama.chat_models import ChatOllama
from langchain_core.prompts import ChatPromptTemplate
from langchain_core.runnables import chain

from config.load_sys import gemma_model

# 구성요소
template = ChatPromptTemplate.from_messages(
    [
        ('system', '너는 친절한 어시스턴트야'),
        ('human', '{question}')
    ]
)

model = ChatOllama(model=gemma_model)

## 함수로 결합
## 데코레이터 @chain을 추가해 작성한 함수에 Runnable 인터페이스르 추가
@chain
def chatbot(values):
    prompt = template.invoke(values)
    return model.invoke(prompt)

## 사용
response = chatbot.invoke({'question': '오늘 날씨는 어때?'})
print(response)
기존 기록에서는 모델이 현재 날씨를 아는 듯 구체적인 기온을 제시했다. 이 코드는 날씨 API를 호출하지 않았으므로 근거 없는 생성 결과다. 이 결과를 성공 사례로 취급하지 않는다.
스트리밍이나 비동기 지원을 활성화할 경우
## 함수로 결합(스트림 방식)
@chain
def chatbot_streaming(values):
    prompt = template.invoke(values)
    for token in model.stream(prompt):
        yield token

## 사용
for part in chatbot_streaming.stream({'question': '오늘 날씨는 어때?'}):
    print(part)
기존 스트리밍 기록은 여러 AIMessageChunk가 순서대로 도착하는 형태였다. 같은 실행에서 한 조각이 content='안녕하세요', 다음 조각이 content='!'인 식이다. 토큰 경계가 단어나 문장 경계와 같다고 가정하지 않는다.
비동기를 통한 실행방법
## 함수로 결합(비동기 방식)
import asyncio

@chain
async def chatbot_async(values):
    prompt = await template.ainvoke(values)
    return await model.ainvoke(prompt)

async def main():
    aResponse = await chatbot_async.ainvoke({'question': '오늘 날씨는 어때?'})
    print(aResponse)

# 스크립트를 직접 실행할 때 main 함수를 실행
if __name__ == "__main__":
    # asyncio.run()을 사용하여 비동기 main 함수를 실행
    asyncio.run(main())
기존 호출 기록은 AIMessage 또는 AIMessageChunk로 반환됐다. 답변 내용과 response_metadata, usage_metadata는 모델·실행 환경에 따라 달라지므로 고정된 기대 출력으로 사용하지 않는다.
3. 선언형 구성
LCEL(LangChain Expression Language)은 |로 Runnable의 출력을 다음 Runnable의 입력으로 연결하는 표기다. 각 단계가 지원하는 범위에서 스트리밍과 비동기 실행을 조합할 수 있다. 단순 연결만으로 항상 병렬 실행되거나 모든 단계가 실시간으로 스트리밍되는 것은 아니다.
from langchain_ollama import ChatOllama
from langchain_core.prompts import ChatPromptTemplate

from config.load_sys import gemma_model

template = ChatPromptTemplate.from_messages(
    [
        ('system', '너는 친절한 어시스턴트야.'),
        ('human','{question}')
    ]
)

model = ChatOllama(model=gemma_model)

# 연산자 | 로 결합
chatbot = template | model

# 사용
response = chatbot.invoke({'question': '너는 어떤 모델이니?'})
print(response)
기존 호출 기록은 AIMessage 또는 AIMessageChunk로 반환됐다. 답변 내용과 response_metadata, usage_metadata는 모델·실행 환경에 따라 달라지므로 고정된 기대 출력으로 사용하지 않는다.
선언형 구성을 사용한 스트리밍 호출 방식
chatbot = template | model
response = chatbot.stream({'question': '너는 어떤 모델이니?'})
for token in response:
    print(token)
기존 호출 기록은 AIMessage 또는 AIMessageChunk로 반환됐다. 답변 내용과 response_metadata, usage_metadata는 모델·실행 환경에 따라 달라지므로 고정된 기대 출력으로 사용하지 않는다.
선언형 구성을 사용한 비동기 실행
chatbot = template | model
import asyncio

async def main():
    response = await chatbot.ainvoke({'question': '너는 어떤 모델이니?'})
    print(response)

if __name__ == "__main__":
    asyncio.run(main())
기존 호출 기록은 AIMessage 또는 AIMessageChunk로 반환됐다. 답변 내용과 response_metadata, usage_metadata는 모델·실행 환경에 따라 달라지므로 고정된 기대 출력으로 사용하지 않는다.
모델 호출부터 응답까지의 데이터 흐름
flowchart LR
    U["질문과 입력값"] --> P["프롬프트 템플릿"]
    P --> M["채팅 모델"]
    M --> A["AIMessage"]
    A --> V["형식·근거 검증"]
    V --> R["사용자 응답"]
    V --> E["재질문 또는 오류"]
템플릿은 아직 답을 만들지 않는다. {context}와 {question}을 채워 모델에 보낼 메시지를 만드는 역할이다. 모델 호출은 네트워크 또는 로컬 추론을 수행하고 AIMessage를 돌려준다. 그 뒤 애플리케이션은 필요한 필드가 있는지, 빈 답은 아닌지, 제공한 근거와 충돌하지 않는지를 검사한다. 구조화 출력이 필요한 API라면 with_structured_output과 Pydantic 스키마를 사용하고, 스키마 검증 오류를 호출자에게 어떻게 전달할지도 정해야 한다.
가령 내부 문서에 있는 출고일을 묻는 FAQ를 만든다고 하자. 문서에 날짜가 없으면 모델이 임의로 채우지 않도록 프롬프트에 모르면 모른다고 답하기를 넣는다. 다만 이 문장은 행동 요청이지 접근 제어나 사실 검증이 아니다. 답변 전 문서 검색 결과를 확인하고, 검색 결과가 비었으면 모델을 호출하지 않고 근거 부족 응답을 내는 편이 비용과 오답 위험을 줄인다.
작은 입력으로 조합을 확인하기
아래 예제는 로컬 Ollama에 이미 설치된 모델 이름을 환경 변수로 받는다. 독립 실행 예제이므로 앞의 프로젝트 전용 config.load_sys 파일이 없어도 된다.
import os

from langchain_core.output_parsers import StrOutputParser
from langchain_core.prompts import ChatPromptTemplate
from langchain_ollama import ChatOllama

prompt = ChatPromptTemplate.from_messages([
    ("system", "제공된 문서에 없는 정보는 '근거 없음'이라고 답하세요."),
    ("human", "문서: {context}\n질문: {question}"),
])
model = ChatOllama(model=os.environ["OLLAMA_CHAT_MODEL"], temperature=0)
chain = prompt | model | StrOutputParser()

answer = chain.invoke({
    "context": "반품 신청은 배송 완료 후 7일 이내에 접수한다.",
    "question": "반품 신청 기한은?",
})
print(answer)StrOutputParser가 AIMessage에서 텍스트를 꺼내므로 이 체인의 출력은 문자열이다. temperature=0은 변동성을 줄이려는 설정일 뿐 동일한 출력이나 정확성을 보증하지 않는다. 두 번째 사례로 문서에 없는 “환불 금액은?”을 넣어 근거 없음이 나오는지 확인한다. 실패한다면 프롬프트만 늘리기보다 검색 결과 유무 검사나 문장 단위 근거 대조를 추가한다.
| 증상 | 먼저 확인할 곳 | 대응 |
|---|---|---|
| 인증 오류 | 환경 변수와 공급자 권한 | 키를 저장소에 적지 않고 실행 환경에서 주입 |
| 모델을 찾을 수 없음 | 모델 이름, 계정 접근 권한, 로컬 설치 상태 | 공급자 목록과 설치 상태 확인 |
| 메시지 타입 오류 | 완성 모델과 채팅 모델의 입력 차이 | 해당 모델 클래스와 프롬프트 타입 맞추기 |
| 출력 파싱 실패 | 실제 응답 형식과 기대 스키마 | 원문을 민감 정보 없이 기록하고 실패 처리 |
| 날씨를 지어냄 | 최신 데이터 소스 부재 | 날씨 API를 연결하거나 답변 거부 |
실제 운영에서는 입력 토큰 수, 출력 토큰 수, 응답 시간, 오류 종류를 함께 기록해야 모델 교체 전후를 비교할 수 있다. 사용자 질문과 내부 문서 전체를 그대로 로그에 남기면 개인정보나 기밀이 노출될 수 있으므로 로그 필드를 별도로 설계한다.
공식 문서: LangChain 채팅 모델, OpenAI 채팅 통합, Google Gemini 채팅 통합, 프롬프트, 구조화 출력.
같은 카테고리의 글
이어서 읽을 글
11. LLM 애플리케이션 개발
문서 기반 질문 응답 서비스를 예로 들어 문제 정의, RAG 그래프 구현, 인용 검증, 평가와 배포까지 연결하는 개발 절차.
8. LLM 성능을 높이는 패턴
프롬프트 연결, 라우팅, 병렬 실행, 평가-개선 루프를 언제 적용할지와 RAG 품질·지연 시간의 병목을 구분하는 방법.
7. 고급 텍스트 생성 기술과 도구
모델 호출, 프롬프트 체인, 대화 기록, 도구 호출을 데이터 흐름과 실패 사례로 이해하기
10. 테스트: 평가, 모니터링, 개선
LLM 애플리케이션의 회귀 테스트, 오프라인 평가 데이터, 운영 추적과 실패 사례를 개선으로 연결하는 방법.