목차
Q. LLM이 학습하지 않은 지식이 필요하다면?
모델 제공업체들이 지속적으로 저장 형식과 관계없이 전 세계의 공개 정보를 학습 데이터셋에 반영하지만, LLM의 지식 코퍼스에는 두 가지 한계가 존재한다.
- 비공개 데이터: 공개되지 않은 정보는 LLM의 훈련 데이터에 포함되지 않는다.
- 현재 정보: LLM 학습은 상당한 비용과 시간이 소요되므로 초기 단계에 데이터 수집을 수행한다. 이에 따라 LLM이 현재 정보를 보유하지 못하는 기준 날짜인 ‘지식 컷오프(knowledge cutoff)‘가 생긴다. 보통 학습 데이터셋이 최종 확정된 날짜가 지식 컷오프가 된다. 대상 모델에 따라 기준 시점은 과거 몇 달 전일 수도, 몇 년 전일 수도 있다.
LLM은 환각(Hallucination: 잘못된 정보를 출력하는 현상)을 일으키고 부정확한 정보를 제공할 가능성이 높다. 이는 프롬프트로 해결되지 않으며 모델의 지식 한계로 인해 생기는 문제이기 때문이다.
2.1 목표: LLM을 위한 적절한 컨텍스트 선정
만약 LLM 활용에 필요한 비공개/최신 데이터가 한두 페이지의 분량의 텍스트라면 큰 문제가 되지 않지만, LLM은 입력크기의 제한이 있어 프롬프트에 입력할 수 있는 범위를 초과할 가능성이 높다.
[해결방법]
- 인덱싱(Indexing) : 애플리케이션이 질문에 가장 적합한 자료를 손쉽게 탐색할 수 있도록 문서를 전처리
- 검색(Retrieval) : LLM이 데이터를 바탕으로 정확한 답변을 생성하도록 인덱스에서 외부 데이터를 가져와 컨텍스트로 전달.
문서를 LLM이 이해하고 검색할 수 있는 형식으로 사전 처리하는 과정을 검색 증강 생성(RAG: Retrieval Augmented Generation) 이라고 한다.
[LLM 활용을 위한 문서 전처리 핵심 단계]
- 문서에서 텍스트를 추출
- 텍스트를 효율적으로 처리할 수 있도록 적절한 단위로 분할
- 텍스트를 컴퓨터가 이해할 수 있는 숫자 체계로 변환
- 문서에서 주어진 질문에 대한 부분을 손쉽고 신속하게 조회할 수 있도록, 텍스트 숫자 표현을 적절한 위치에 저장
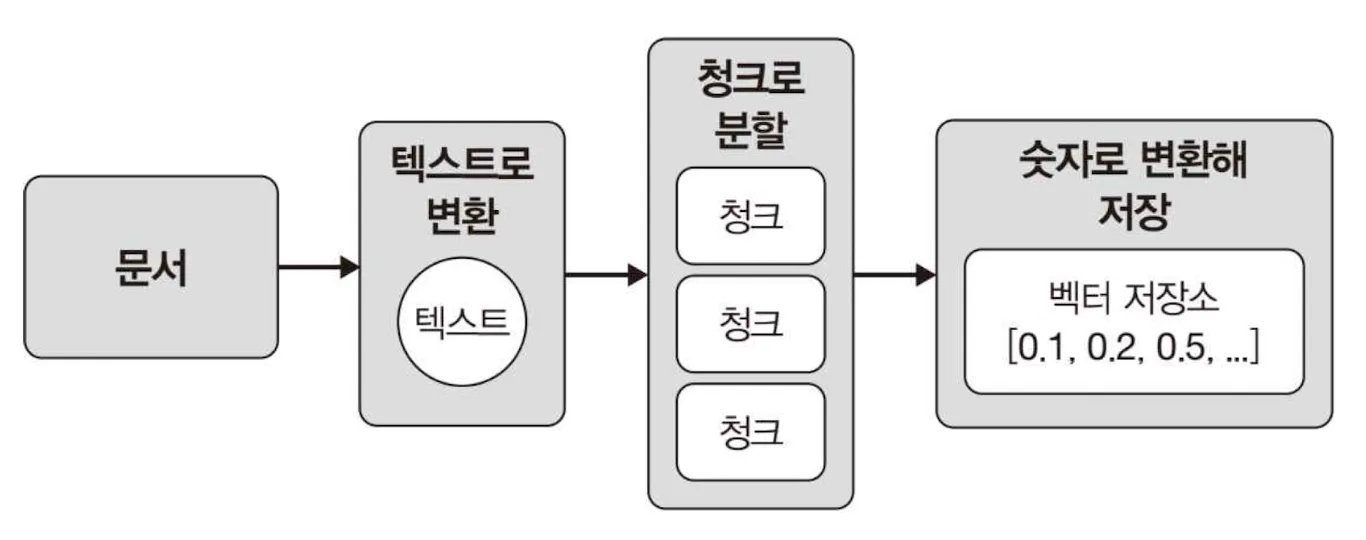
문서를 전처리하는 과정을 인제스천이(Ingestion)라고 하는데, 문서를 컴퓨터가 이해하고 분석하기 좋은 숫자 데이터로 변환한 후 이를 효율적인 검색 증강 생성을 위해 특화된 데이터베이스 저장한다. 숫자 데이터를 임베딩(embedding)이라고 부르며, 특수한 유형의 데이터베이스를 벡터 저장소(Vector Store)라고 부른다.
2.2 임베딩
임베딩 모델(embedding model)은 텍스트를 입력받아 그 의미를 수치로 표현하는 알고리즘으로 보통 100개에서 2000개의 부동소소점 숫자, 즉 차원의 목록을 출력하고 모든 차원이 0이 아닌 값을 가진 값을 가져 밀집 임베딩(dense embedding)이라 부른다.
의미론적 임베딩
컴퓨터가 lion, pet, dog를 구분하도록 하려면 각 대상을 컴퓨터가 사용하는 언어인 숫자로 변환하는 과정이 필요
[각 단어를 본래 의미를 반영한 가상의 숫자 표상으로 전환하는 과정]
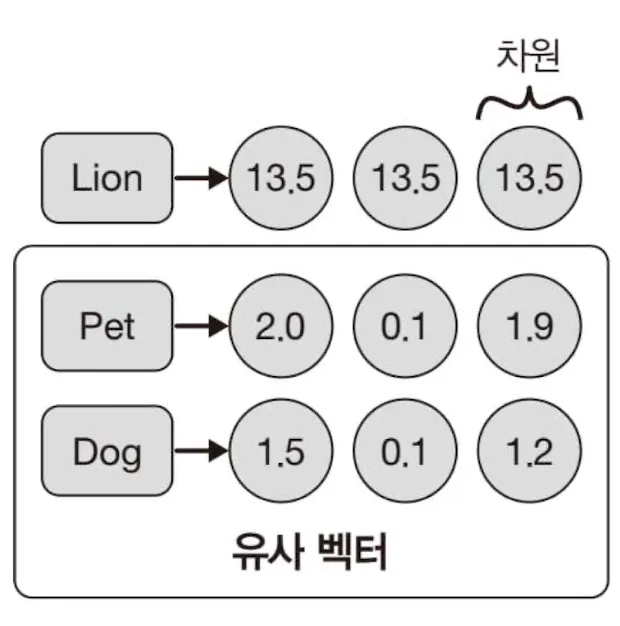
각 단어와 이에 상응하는 의미론적 임베딩이 나란히 배치. 숫자 자체는 특별한 의미를 갖지 않으므로, 의미 유사성이 높은 단어나 문장을 표현하는 숫자 배열은 관련성이 없는 경우 ‘가깝게’ 구성. 각 숫자는 부동소수점 값으로 의미론적 차원(시멘틱 차원)을 나타낸다. ‘가갑게’라는 의미를 보면 3차원 공간에 모든 벡터를 배치하면 그림과 같은 유사한 형태가 나타난다.
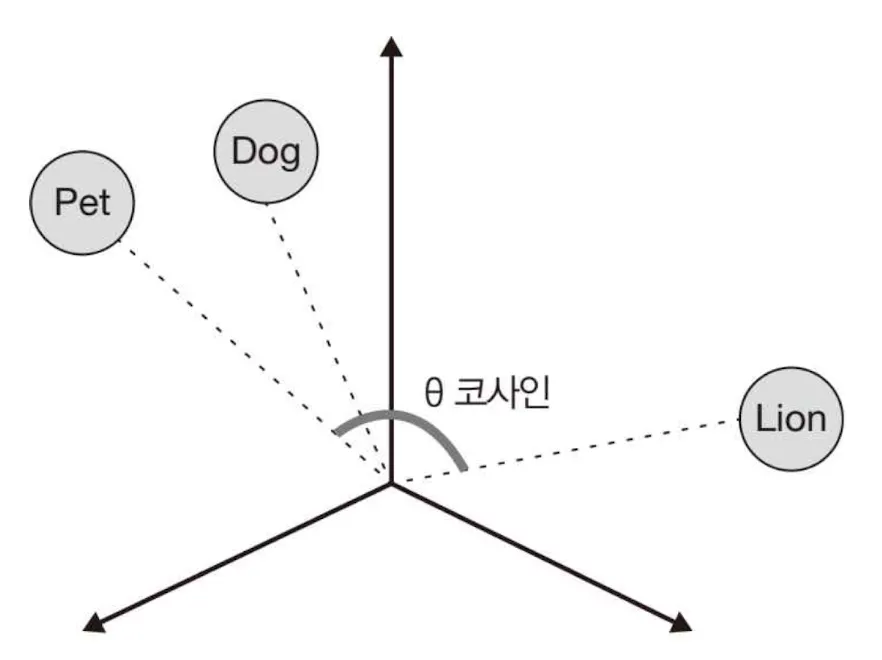
pet과 dog의 벡터 거리가 lion과 다른 단어의 거리보다 가깝다. 또한 벡터 간 각도는 유사도에 따라 달라진다. 두 벡터 사이의 각도가 작거나 거리가 짧을수록 더욱 유사하다고 판단. 그래서 다차원 공간 내 두 벡터 간 유사도를 산출하는 효과적인 방법이 코사인 유사도(cosine similarity)이다.
코사인 유사도(cosine similarity)
- 벡터 간 내적을 계산하고, 각 벡터의 크기의 곱을 나눈 결과를 -1부터 1 까지의 수치로 나타낸다.
- 0은 벡터끼리 상관관계가 없음
- -1은 전혀 유사하지 않음
- 1은 완전히 유사함
2.3 문서-텍스트 변환
문서 전처리의 첫 단계 → 문서를 텍스트로 변환
랭체인은 파싱 로직을 처리하고 다양한 소스 데이터를 ‘load’하는 문서 로더(Document Loader) 를 제공
문서를 텍스트와 관련 메타데이터로 구성된 클래스 Document로 전환 가능.
## txt 파일 추출
from langchain_community.document_loaders import TextLoader

loader = TextLoader('hello.txt', encoding='utf-8')
docs = loader.load()
print(docs)[Document(metadata={'source': 'hello.txt'}, page_content='안녕하세요.\n만나서 반가워요.')]랭체인 문서 로더를 사용하는 코드는 모두 구조가 비슷
- 문서 유형에 적합한 로더를 선택
- 해당 로더의 인스턴스를 생성 후 문서위치(파일 경로, 웹 주소)를 비롯한 모든 설정 및 매개변수 지정
- load()를 호출하여 문서로를 로드하면 다음 단계에 전달할 준비가 끝난 문서 목록을 반환
랭체인은 .txt 파일 이외에도 .csv, .json, .md, 같은 주요 파일 형식에 대응하는 문서로더를 제공하고 슬랙과 노션등 유명 플랫폼도 지원
WebBaseLoader 를 활용하면 Web URL에서 HTML을 불러와 이를 텍스트로 변환할 수도 있다.
# 웹페이지 파싱 전용 패키지 설치
uv add beautifulsoup4
from langchain_community.document_loaders import WebBaseLoader
loader = WebBaseLoader("https://www.google.com")
load = loader.load()
print(load)[Document(metadata={'source': 'https://www.google.com', 'title': 'Google', 'language': 'ko'}, page_content='GoogleGmail이미지로그인\xa0고급검색Google 지원 언어: English 광고비즈니스 솔루션Google 정보Google.co.kr© 2026 - 개인정보처리방침 - 약관Google 앱')]PDF의 경우 랭체인의 PDFLoader 로 PDF 문서의 텍스트를 추출할 수 있다.
# PDF 전용 패키지(pypdf) 설치
uv add pypdf
from langchain_community.document_loaders import PyPDFLoader
loader = PyPDFLoader('sample.pdf')
pages = loader.load()
print(pages)PDF 문서에서 추출한 텍스트는 Document 클래스에 저장된다. 만약 문서의 길이가 100,000자를 초과할 경우 대다수의 LLM 및 임베딩 모델이 제공하는 컨텍스트 윈도에 모두 수용되지 않는다.
그럴려면 Document를 관리 가능한 텍스트 단위로 분할하여 추후 임베딩과 의미론적 검색을 할 수 있도록 해야한다.
<aside> 💡
LLM 및 임베딩 모델은 입출력 토큰 크기에 대해 엄격한 제한을 둔다. 이를 컨텍스트 윈도(Context Window)라고 하며 입력과 출력의 결합에 적용된다. 예를 들어, 컨텍스트 윈도가 100인 경우 입력길이가 90이면 출력은 최대 10 길이로 제한된다. 컨텍스트 윈도는 일반적으로 로큰 수를 기준으로 측정
</aside>
2.4 텍스트를 여러 조각으로 분할
텍스트를 여러 조각으로 분할하는 작업은 의미론적으로 연관 텍스트 조각끼리 함께 유지하는 작업은 복잡하다.
랭체인은 대량의 문서를 의미 있는 소규모 단위(청크Chunk) 단위로 손쉽게 분할할 수 있다.
RecursiveCharacterTextSplitter- 중요도 순서에 따라 구분자 목록을 작성
- 문단 구분자 : \n\n
- 줄 구분자 : \n
- 단어 구분자 : 공백 문자
- 우선 제한된 청크(예:1000자)를 만족하도록 단어를 분할하는 작업부터 진행
- 청크의 허용크기를 초과하는 단락의 경우 이후 등장하는 구분자(줄 바꿈)을 기준으로 분할한다. 모든 청크가 목표 길이보다 작아지니 적요할 추가 구분자가 없을 때까지 이 과정을 반복
- 각 청크는 Document 형식으로 출력되며, 원본 문서의 메타데이터와 원본 문서에서의 위치에 관한 추가 정보를 함께 제공
- 중요도 순서에 따라 구분자 목록을 작성
## 문서를 청크로 분할
from langchain_text_splitters import RecursiveCharacterTextSplitter
from langchain_community.document_loaders import TextLoader

loader = TextLoader('ateention.txt', encoding='utf-8')
docs = loader.load()

splitter = RecursiveCharacterTextSplitter(chunk_size=1000, chunk_overlap=200)
splitter_docs = splitter.split_documents(docs)

print(splitter_docs)
문서 로더가 생성한 문서를 각 1,000자 청크 단위로 분할하고, 일부 청크에는 200자의 중복 구간을 두어 컨텍스트를 유지된다. 이 방법은 각 청크를 일관되고 가독성 높은 텍스트 조각으로 유지
[마크다운 문서를 의미론적 청크로 분할하는 용도로 활용]
각 언어에 대한 고유한 키워드를 구분자로 활용하면 함수를 여러 부분으로 나누는 대신 단일 청크에 통합해 처리
프로그래밍 언어는 글보다 체계적인 구조를 갖추고 있어, 청크 사이에 중복을 둘 필요가 없다.
from langchain_text_splitters import (
    Language,
    RecursiveCharacterTextSplitter
)

PYTHON_CODE = '''
def hello_world():
    print("Hello, World!")

hello_world()
'''

python_splitter = RecursiveCharacterTextSplitter.from_language(language=Language.PYTHON, chunk_size=50, chunk_overlap=0)
python_docs = python_splitter.create_documents([PYTHON_CODE])

print(python_docs)[Document(metadata={}, page_content='def hello_world():\n print("Hello, World!")'), Document(metadata={}, page_content='hello_world()')]from_language 메서드를 특정 언어에 맞는 인스턴스를 생성하면 언어와 청크 크기 등 매개변수를 입력받는다.
create_documents는 텍스트 문자열만으로 구성된 자료를 분할하는데 유용
from langchain_text_splitters import (
    Language,
    RecursiveCharacterTextSplitter
)

markdownText = '''
# Hello world!!
# LangChain Build applications with LLMs through composability

## Quick Install
\'\'\'bash
pip install langchain
\'\'\'

'''

markdown_splitter = RecursiveCharacterTextSplitter.from_language(language=Language.MARKDOWN, chunk_size=60, chunk_overlap=0)
markdown_docs = markdown_splitter.create_documents([markdownText])

print(markdown_docs)[Document(metadata={}, page_content='# Hello world!!'), Document(metadata={}, page_content='# LangChain Build applications with LLMs through'), Document(metadata={}, page_content='composability'), Document(metadata={}, page_content="## Quick Install\n'''bash\npip install langchain\n'''")]- 마크다운 문서에 존재하는 자연스러운 중단 지점을 기준으로 텍스트를 분할. (예를들어, 제목은 하나의 청크로 구분하고, 그 아래의 본문은 별도의 청크로 분리)
- 두 번째 인수로 전달한 메타데이터가 각 생성 문서에 첨부.
2.5. 텍스트 임베딩 생성
랭체인의 Embeddings 클래스는 텍스트 임베딩 모델과 상호작용해 텍스트의 벡터 표현을 생성
해당 클래스는 Open AI, Cohere, HuggingFace 등과 연동.
Embeddings 클래스는 문서를 임베딩하는 메서드와 질의를 임베딩하는 메서드를 제공.
- 첫 번재 메서드 : 텍스트 문자열 목록을 입력
- 두 번째 메서드 : 단일 텍스트 문자열을 입력
올라마에서 embeddinggemma:300m 을 받아 사용한 임베딩 예시
from langchain_ollama import OllamaEmbeddings

from config.load_sys import gemma_model

#임베딩 전용 gemma 모델
model = OllamaEmbeddings(model='embeddinggemma:300m')
embeddings = model.embed_documents([
    "여러분 안녕하세요!",
    "안녕?",
    "이름이 뭐에요?",
    "내 이름은 홍길동 이에요.",
    "반가워요"
])

print(embeddings)
## 벡터 임베딩 결과
[[-0.18879442, -0.03203271, 0.031989742, -0.03667487, 0.046645533, 0.004753672, -0.010554943, -0.026293429, -0.005499569, -0.05226316, 0.01473215, -0.061852895, 0.016186755, -0.052615836, 0.09439589, -0.038778942, 0.0010498706, -0.07437531, -0.041529708, -0.032287225, 0.0043256287, -0.025839496, -0.008371316, -0.0617615, 0.04397569, -0.0011141563, -0.006058816, -0.008532174, -0.040607907, 0.034424488, -0.029805327, -0.017107792, 0.050611805, -0.003824204, 0.0013469666, 0.043440264, -0.015015539, -0.017381877, 0.075708315, 0.007909364, -0.015788993, 0.06555399, -0.06373626, -0.023081966, 0.03109749, 0.025922926, -0.026470888, -0.039132696, -0.031761214, -0.015794655, -0.027328849, 0.016831713, -0.049691483, 0.06539922, 0.031815644, -0.00049497606, 0.02831893, 0.008123934, -0.007844208, 0.038593143, -0.03692178, 0.006229334, 0.013515137, 0.055310797, 0.06866549, 0.008571451, -0.012246219, -0.011608469, 0.014982624, 0.15507519, 0.02006388, -0.020093197, 0.006230159, -0.05793066, 0.16709831, 0.05393749, -0.00923878, -0.01438686, -0.017560463, -0.008772132, 0.029628381, -0.044470195, 0.028316015, -0.06327297, 0.102707624, -0.011779712, -0.007579808, -0.01716196, 0.044187352, -0.03699209, 0.003909213, 0.01683231, -0.04904679, 0.0005612343, 0.038200445, -0.0020275384, 0.0033733777, 0.07418137.....임비뎅 모델은 동시에 여러 문서를 임베딩 할 수 있으므로, 한 번에 하나씩 임베딩하기 보다 동시에 임베딩하는 것이 더 효율적이다.
위의 세 가지 기능을 살펴보면 이렇다.
- 문서 로더 : 임의의 문서를 평문으로 변환
- 텍스트 분할기: 대형 문서를 다수의 수규모 문서로 분할
- 임베딩 모델 : 각 분할 요소의 의미를 수치로 표현
[전체코드]
# 텍스트 로드 후 임베딩

from langchain_community.document_loaders import TextLoader
from langchain_text_splitters import RecursiveCharacterTextSplitter
from langchain_ollama import OllamaEmbeddings

## 1. 문서 로드
loader = TextLoader('data/hello.txt')
docs = loader.load()

## 2. 문서 분할
splitter = RecursiveCharacterTextSplitter(chunk_size=1000, chunk_overlap=200)
chunks = splitter.split_documents(docs)

## 3. 임베딩 생성
embedding_model = OllamaEmbeddings(model='embeddinggemma:300m')
embeddings = embedding_model.embed_documents([chunk.page_content for chunk in chunks])

print(embeddings)
이렇게 임베딩 생성 후 벡터 데이터베이스 저장하면 된다.
2.6. 벡터 저장소에 임베딩 저장
벡터 저장소(Vector Store)는 벡터를 저장해 코사인 유사도 등의 복잡한 계산을 효율적이고 신속하게 처리하도록 설계된 데이터베이스다.
일반적인 데이터베이스는 JSON 문서나 관계형 데이터베이스 스키마에 따른 정형 데이터를 저장하지만, 벡터 데이터베이스는 텍스트와 이미지 등 비정형 데이터를 저장 할 수 있다.
벡터 데이터베이스도 CRUD 및 검색 연산을 수행할 수 있다.
벡터 데이터베이스를 활용하면 AI에 대용량 문서를 바탕으로 질의응답을 할 수 있는 확장성 있는 애플리케이션을 만들 수 있다.
[벡터 저장소에서 관련 문서 임베딩 저장 검색]
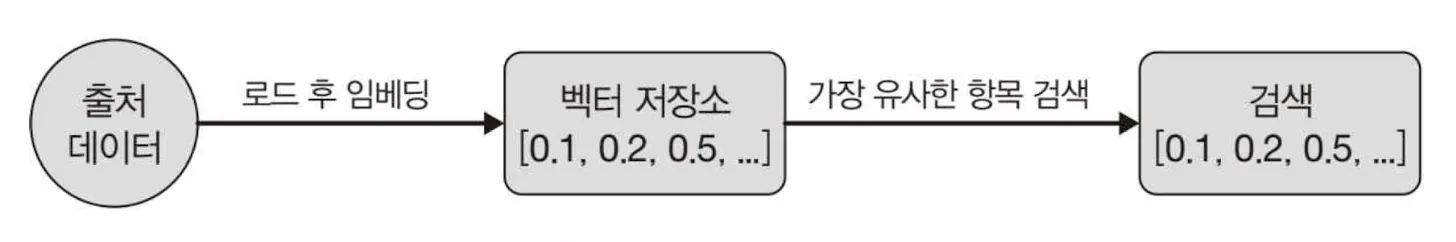
다양한 종류의 벡터 데이터베이스가 존재하며, 서로 다른 기능에 특화되어 있다. 벡터 데이터베이스는 다중 테넌시, 메타데이터 필터링 키능, 성능, 비용, 확장성 등 핵심 조건을 기준으로 결정
[단점]
- 대부분의 벡터 데이터베이스는 비교적 최근 기술로 안정성을 보장하기 어렵다.
- 벡터 데이터베이스의 관리와 최적화는 비교적 가파른 학습 곡선을 요구한다.
- 별도의 데이터베이스를 관리하려면 애플리케이션의 복잡성이 증가하며, 많은 자원이 소모될 위험이 있다.
최근에는 PostgreSQL에 벡터 저장소 기능이 pgvector가 확장으로 추가되어, 이미 익숙한 데이터베이스를 그대로 활용해 트랜잭션 테이블과 벡터 검색 테이블까지 함께 구동할 수 있다.
1. PGVector 환경 구축
[docker-compose.yml]
services:
  db:
    image: pgvector/pgvector:pg17
    container_name: pgvector_db
    ports:
      - "127.0.0.1:5432:5432"
    environment:
      - POSTGRES_DB=test_vector_db
      - POSTGRES_USER=postgres
      - POSTGRES_PASSWORD=${PGVECTOR_PASSWORD:?set PGVECTOR_PASSWORD}
    volumes:
      - pgdata_v17:/var/lib/postgresql/data
    restart: always

volumes:
pgdata_v17:postgresql+psycopg://<user>:<URL-encoded-password>@localhost:5432/test_vector_dbPGVector 를 활용해 문서를 로드 후 분할하여 임베딩을 저장
문서를 로드 후 청크로 분할 후 임베딩 모델 인스턴스화 후 벡터 데이터베이스에 저장.
# 텍스트 로드 후 임베딩
from langchain_community.document_loaders import TextLoader
from langchain_text_splitters import RecursiveCharacterTextSplitter
from langchain_ollama import OllamaEmbeddings
from langchain_postgres.vectorstores import PGVector

## 1. 문서 로드
loader = TextLoader('data/hello.txt')
docs = loader.load()

## 2. 문서 분할
splitter = RecursiveCharacterTextSplitter(chunk_size=1000, chunk_overlap=200)
chunks = splitter.split_documents(docs)

## 3. 임베딩 인스턴스화
embedding_model = OllamaEmbeddings(model='embeddinggemma:300m')

# 4. 벡터 데이터베이스 저장
import os
connection = os.environ["PGVECTOR_URL"]
PGVector.from_documents(chunks, embedding_model, connection=connection)
벡터 데이터베이스에 저장한 임베딩 검색
results = db.similarity_search('query', k=4)
print(results)similarity_search를 사용하여 인덱싱한 문서 중 가장 관련성이 높은 문서를 찾아낸다.
- 검색쿼리를 임베딩 모델에 전달해 임베딩을 얻는다.
- PostgreSQL에 질의를 실행해 입력된 질의와 가장 유사한 임베딩N개(K=4)개를 검색
- 각 임베딩과 연관된 텍스트 내용 및 메타데이터를 가져온다.
- 모델은 질의와 유사도에 따라 Document 목록을 반환한다. 목록은 가장 유사한 항목부터 차례대로 정렬
[전체코드]
# 텍스트 로드 후 임베딩
import uuid

from langchain_community.document_loaders import TextLoader
from langchain_core.documents import Document
from langchain_ollama import OllamaEmbeddings
from langchain_postgres.vectorstores import PGVector
from langchain_text_splitters import RecursiveCharacterTextSplitter

## 1. 문서 로드
loader = TextLoader('data/hello.txt')
docs = loader.load()

## 2. 문서 분할
splitter = RecursiveCharacterTextSplitter(chunk_size=1000, chunk_overlap=200)
chunks = splitter.split_documents(docs)

## 3. 임베딩 생성
embedding_model = OllamaEmbeddings(model='embeddinggemma:300m')
embeddings = embedding_model.embed_documents([chunk.page_content for chunk in chunks])

# 4. 벡터 데이터베이스 저장
import os
connection = os.environ["PGVECTOR_URL"]
db = PGVector.from_documents(chunks, embedding_model, connection=connection)

## query 조회
results = db.similarity_search('지역', k=5)
print(results)

## 문서 추가
ids = [str(uuid.uuid4()), str(uuid.uuid4())]
db.add_documents([
    Document(page_content='일하는 지역은 서울이에요',
             meta_data={'location:':'서울', 'topic':'지역'}),
    Document(page_content='서울에 있는 강남 지역에서 일해요.',
             meta_data={'location:':'지역', 'topic':'지역'}),
],
ids=ids)

## 문서 삭제
# db.delete(ids=ids)[Document(id='2c9e9d8c-3185-4c35-b116-ffda4370003a', metadata={'source': 'data/hello.txt'}, page_content='안녕하세요.\n만나서 반가워요.\n내이름은 홍길동이에요.\n취미는 피아노\n일하는 지역은 한국이에요.')]2.7 문서의 변경 사항 추적
벡터데이터베이스는 데이터가 지속적으로 변화하는 상황에서 지속적으로 다시 데이터를 인덱싱한다. 이로인해 계산 비용이 발생하고, 기존 콘텐츠가 중복된다.
랭체인은 인덱싱 API를 통해 문서를 벡터 저장소와 손쉽게 동기화 할 수 있다. 인덱싱 API는 벡터 저장소에 문서가 기록되는 상황을 관리하기 위해 RecordManager 클래스를 사용
인덱싱을 하면 각 문서의 해시값이 산출되어 다음 정보가 RecordManager에 저장
- 문서 해시(페이지 내용과 메타데이터에 대한 해시 값)
- 작성 시간
- 출처 ID(각 문서의 메타데이터에 해당 문서의 최종 출처를 판별할 수 있도록 정보를 반드시 포함)
인덱싱 API는 벡터 저장소에 저장된 문서 삭제 방식을 결정하는데 도움을 주는 클린업 모드를 제공
예를 들어 인제스천 이전에 문서를 처리하는 방식에 변화가 있거나, 원본 문서가 수정된 경우, 인덱싱되는 새 문서와 같은 출처에서 기존 문서를 제거하는 것이 좋다.
일부 문서가 삭제되었다면, 벡터 저장소에 보관된 모든 기존 문서를 삭제 후 인덱싱을 새로 수행한 문서로 교체
[클린 업 모드]
- None 모드 : 자동 정리 기능을 수행하지 않으며, 기존 콘텐츠를 수동으로 정리할 수 있다.
- Incremental, Full 모드 : 원본 문서나 파생문서의 내용이 변경되는 경우 기존 버전으 콘텐츠를 삭제
- Full 모드 : 현재 인덱싱 중인 문서에 포함되지 않은 모든 문서를 추가로 삭제
[PostgreSQL 데이터베이스를 레코드 관리자로 설정하는 인덱싱 API 사용]
from langchain_classic.indexes import SQLRecordManager, index
from langchain_ollama import OllamaEmbeddings
from langchain_classic.docstore.document import Document
from langchain_postgres import PGVector

import os
connection = os.environ["PGVECTOR_URL"]
collection_name = "my_docs"

embedding_model = OllamaEmbeddings(model='embeddinggemma:300m')
namespace = "my_docs_namespace"

vectorStore = PGVector(
    embeddings=embedding_model,
    collection_name=collection_name,
    connection=connection,
    use_jsonb=True
)

record_manger = SQLRecordManager(
    namespace,
    db_url=connection
)

## 스키마가 없을 경우 생성
record_manger.create_schema()

## 문서 생성
docs = [
    Document(page_content='고양이가 연못에 있어요.',
             metadata={'id':1, 'source':'cat.txt'}),
    Document(page_content='오리도 연못에 있어요.',
             metadata={'id': 2, 'source': 'duck.txt'}),
]

# 문서 인덱싱 1회차ㅣ
index_1 = index(
    docs,
    record_manger,
    vectorStore,
    cleanup='incremental', ## 문서 중복 방지
    source_id_key='source' ## 출처를 source_id로 사용
)

print(f"인덱싱 1회차 : {index_1}")

# 문서 인덱싱 2회차, 중복 문서 생서 안됨
index_2 = index(
    docs,
    record_manger,
    vectorStore,
    cleanup='incremental',
    source_id_key='source'
)

print(f"인덱싱 2회차 : {index_2}")

# 문서를 수정하면 새 버전을 저장 후 출처가 같은 기존 문서는 제거
docs[0].page_content = '나는 문서를 수정해봅니다.'

index_3 = index(
    docs,
    record_manger,
    vectorStore,
    cleanup='incremental',
    source_id_key='source'
)

print(f"인덱싱 3회차 : {index_3}")
인덱싱 1회차 : {'num_added': 2, 'num_updated': 0, 'num_skipped': 0, 'num_deleted': 0}
인덱싱 2회차 : {'num_added': 0, 'num_updated': 0, 'num_skipped': 2, 'num_deleted': 0}
인덱싱 3회차 : {'num_added': 1, 'num_updated': 0, 'num_skipped': 1, 'num_deleted': 1}- 기존에 인덱싱한 문서를 관리할 레코드를 생성
- 그 후 index 기능을 사용해 벡터 저장소화 새 문서 목록을 동기화(위 예시에서는 증분 모드를 적용해, 이전과 같은 ID를 가진 문서가 새 버전으로 대체)
2.8 인덱싱 최적화
기본 RAG 인덱싱 단계는 주어진 문서를 청크 단위로 단순하게 텍스트 분할 후 임베딩을 수행하며, 데이터 소스에 이미지와 표가 포함된 경우, 검색 결과의 일관성이 떨어지고 허위 생성 현상이 자주 발생한다.
인덱싱 단계에서 정확도와 성능을 제고하는 다양한 전략이 존재
- MultiVectorRetriever
- RAPTOR
- ColBERT
2.8.1 MultiVectorRetriever
텍스트와 표가 혼합된 문서를 단순히 텍스트 기준으로 분할하여 컨텍스트에 임베딩 할 경우 전체 표가 누락되는 상황이 발생한다. 이를 해결하기 위해 답안 합성에 활용되는 문서와 검색에 활용되는 참조 자료를 분리하는 방법을 활용.
- 문서 :답안 합성에 활용
- 참조 자료 : 문서와 검색에 활용
[단일 문서에 있는 여러 요소의 인덱싱 과정]
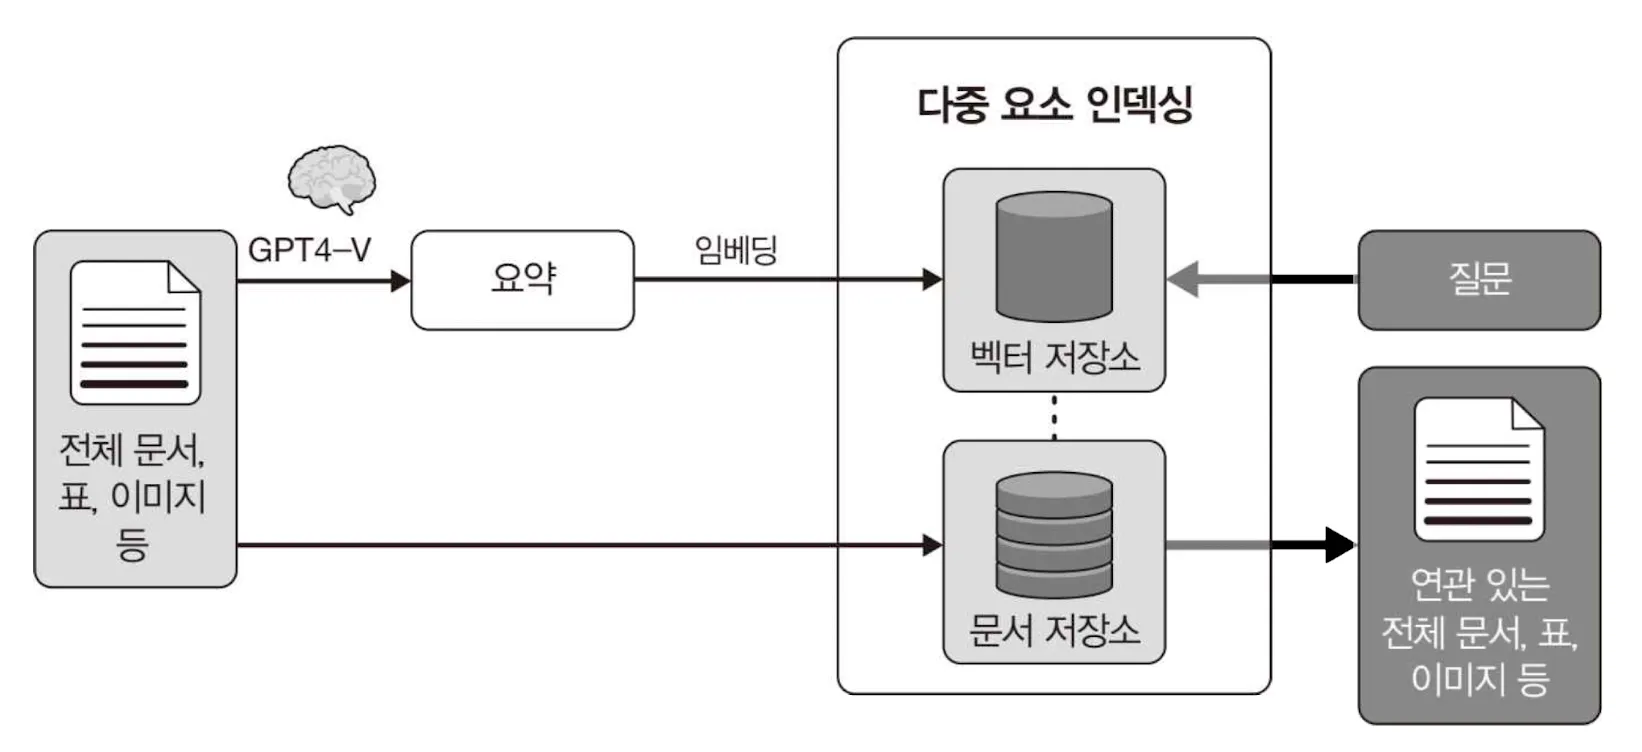
이 방법을 활용하면 질문에 답변하는데 필수적인 정보의 전체 컨텍스트를 LLM에 제공 가능.
- 표가 포함된 문서는 표에 대한 요약을 먼저 생성 후 임베딩
- 각 요약에 전체 원본 표를 참고하는 id를 포함
- 참조할 원본 테이블을 모두 별도의 문서 저장소에 보관
- 최종적으로 사용자 질의 결과에서 표 요약이 검색되면, 참조된 원본 테이블 전체를 답변에 참고해야 하므로 LLM에 전송되는 최종 프롬프트의 컨텍스트로 포함
# 1. 문서 요약 생성을 위해 LLM 활용
# 2. 원시 요약 및 해당 임베딩을 저장할 벡터 저장소화 문서 저장소를 정의
# 3. 질의를 토대로 관련된 전체 컨텍스트 문서를 검색
import uuid

from langchain_community.document_loaders import TextLoader
from langchain_text_splitters import RecursiveCharacterTextSplitter
from langchain_ollama import OllamaEmbeddings
from langchain_postgres.vectorstores import PGVector
from langchain_core.output_parsers import StrOutputParser
from langchain_core.prompts import ChatPromptTemplate
from langchain_core.runnables import RunnablePassthrough
from langchain_ollama import ChatOllama
from langchain_core.documents import Document
from langchain_classic.retrievers import multi_vector, MultiVectorRetriever
from langchain_classic.storage import InMemoryStore
from pydantic import BaseModel

from config.load_sys import gemma_model

import os
connection = os.environ["PGVECTOR_URL"]
collection_name = 'summaries'
embeddings_model = OllamaEmbeddings(model='embeddinggemma:300m')

## 문서 로드
loader = TextLoader('data/hello.txt', encoding='utf-8')
docs = loader.load()

print('length of loaded docs: ', len(docs[0].page_content))

## 문서 분할
splitter = RecursiveCharacterTextSplitter(chunk_size=50, chunk_overlap=10)
chunks = splitter.split_documents(docs)

# 나머지 코드는 동일하게 유지
prompt_text = '다음 문서의 요약을 생성하세요:\n\n{doc}'
prompt: ChatPromptTemplate = ChatPromptTemplate.from_template(prompt_text)
llm = ChatOllama(model=gemma_model)
sumerize_chain = {'doc' : lambda x: x.page_content } | prompt | llm | StrOutputParser()
sumerizes = sumerize_chain.batch(chunks, {'max_concurrency': 5})

## 벡터 저장소는 하위 청크를 인덱싱하는데 사용
vectorstore = PGVector(
    embeddings=embeddings_model,
    collection_name=collection_name,
    connection=connection,
    use_jsonb=True
)

## 상위 문서를 위한 스토리지 레이어
store = InMemoryStore()
id_key = 'doc_id'

## 원본 문서를 문서 저장소에 보관하면서 벡터 저장소에 요약을 인덱싱
retriever = MultiVectorRetriever(
    vectorstore=vectorstore,
    docstore=store,
    id_key=id_key
)

## 문서와 동일한 길이가 필요하므로 summaries에서 chunk로 변경
doc_ids = [str(uuid.uuid4()) for _ in chunks]

# 각 요약은 doc_id를 통해 원본 문서와 연결
summary_docs = [
    Document(page_content=s, metadata={id_key: doc_ids[i]}) for i, s in enumerate(sumerizes)
]

# 유사도 검색을 위해 벡터 저장소에 문서 요약 추가
retriever.vectorstore.add_documents(summary_docs)

## doc_ids를 통해 요약과 연결된 원본 문서를 문서 저장소에 저장
# 이를 통해 먼저 요약을 효율적으로 검색한 다음, 필요할 때 전체 문서를 가져옴
retriever.docstore.mset(list(zip(doc_ids, chunks)))

# 벡터 저장소가 요약을 검색
sub_docs = retriever.vectorstore.similarity_search('chapter on philosophy', k=2)

print('sub docs":',sub_docs[0].page_content)

print('length of sub docs:\n', len(sub_docs[0].page_content))

# retriever는 더 큰 원본 문서 청크를 반환
retrieved_docs = retriever.invoke('chapter on philosophy')

print('retrieved docs: ', retrieved_docs[0].page_content)
2.8.2 RAPTOR
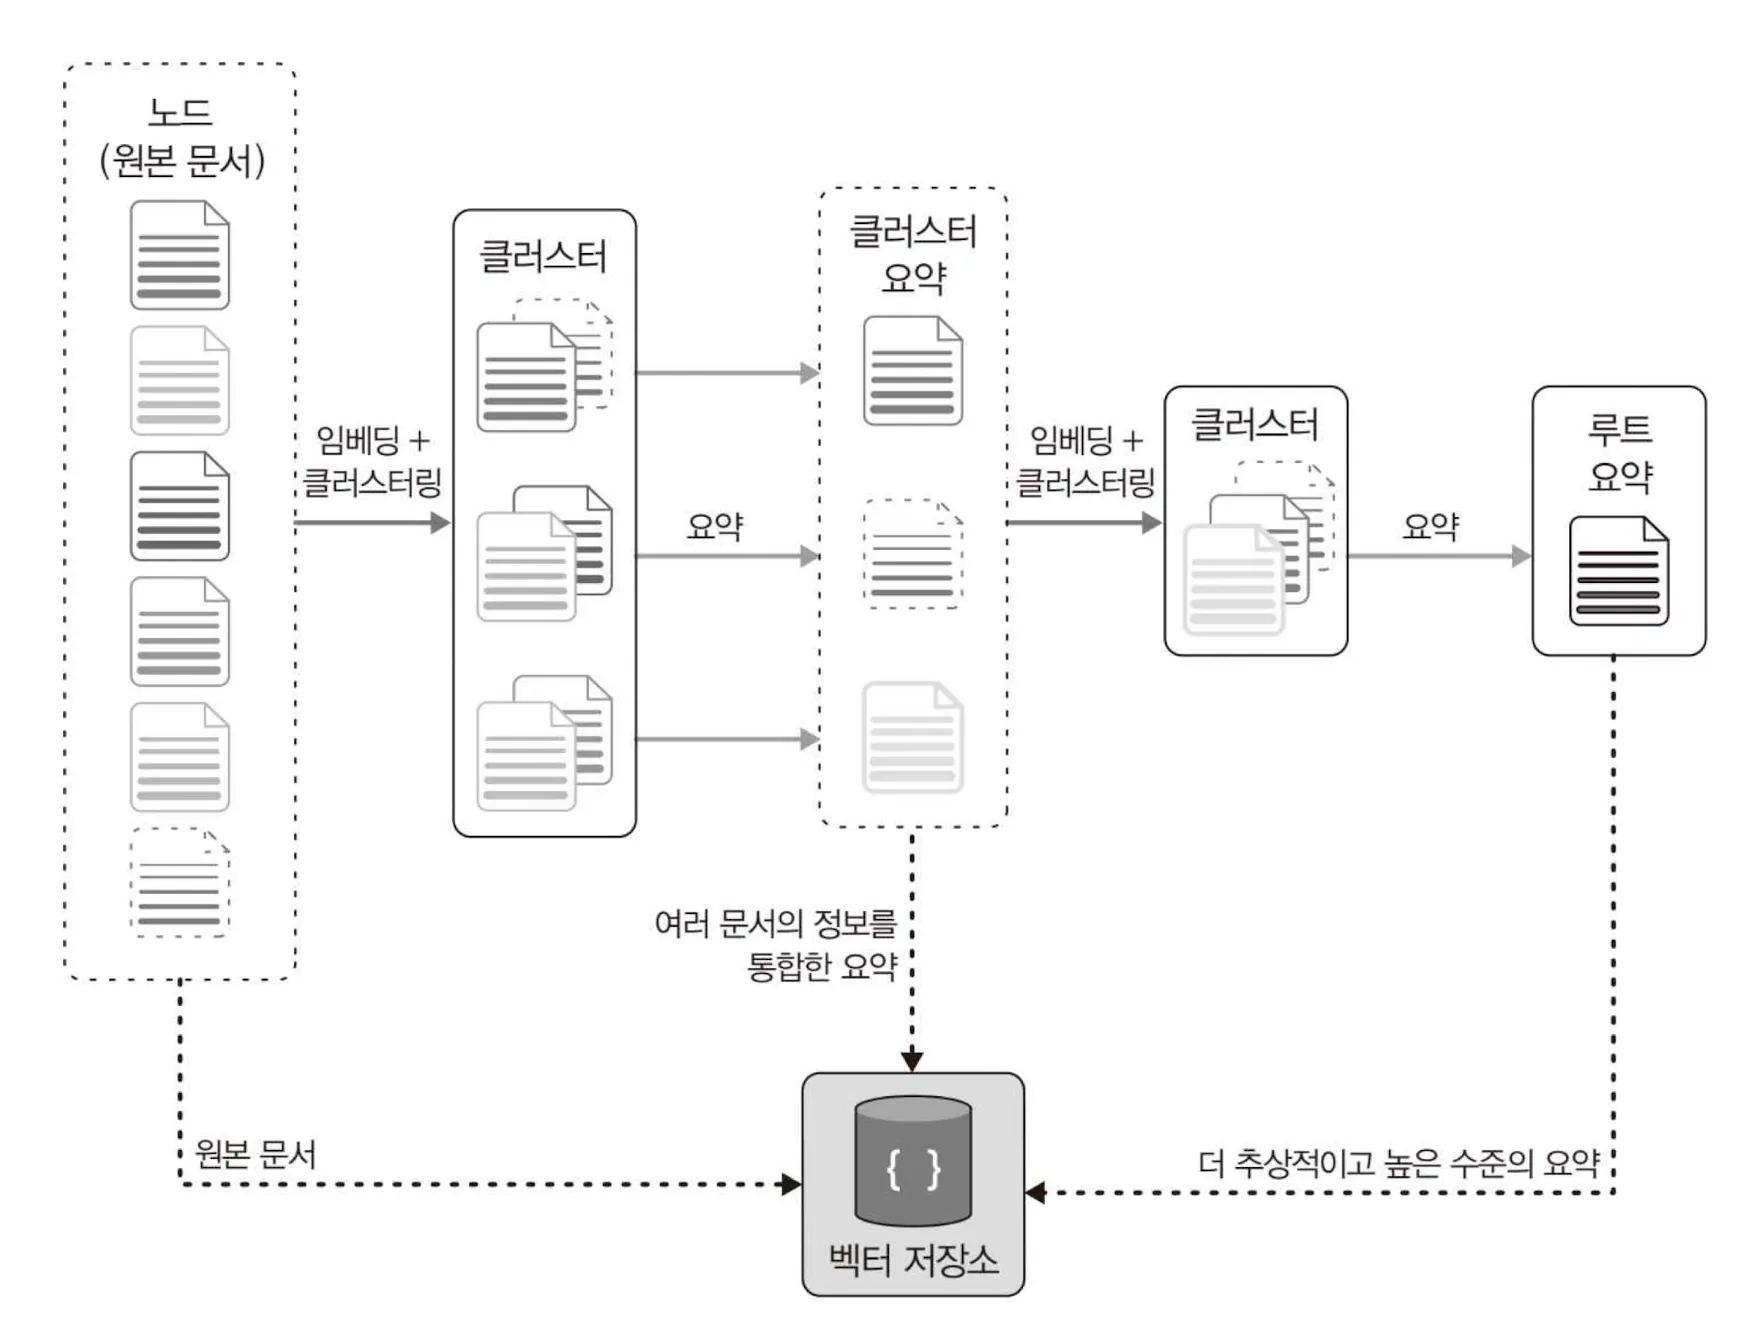
RAG 시스템은 단일 문서에 존재하는 특정 사실을 참조하는 하위 수준의 질문과 여러 문서 사이에 걸쳐 산출된 아이디어를 도출하는 상위 수준 질문을 모두 처리할 수 있어야 한다.
일반적으로 문서 청크 대상으로 하는 k-최근접-이웃(K-NN: k-nearest neighbors) 검색 방식을 적용하면 두 가지 유형의 질문을 모두 처리하는데 어려움이 발생
- 트리 형태 검색을 위한 재귀적 추상 처리(RAPTOR: Recursive abstractive processing for tree-organized retrieval)
- 상위 개념을 반영하는 요약 문서를 작성하고 문서의 임베딩 및 클러스터링을 수행한 후 각 클러스터를 재요약하는 효과적인 전략
- 이 과정을 재귀적으로 진행하고 점차 상위 개념을 반영하는 요약 트리를 형성
- 요약본과 초기 문서를 함께 인덱싱하여 사용자의 기초적인 질문부터 고급적인 질문까지 포괄적으로 다룰 수 있도록 구성
2.8.3 ColBERT
인덱싱 단계에서 임베딩 모델을 사용하면, 텍스트 전체가 고정 길이의 벡터로 표현되기 때문에 문서의 의미는 담을 수 있지만, 세부적인 문맥이나 구조는 손실될 수 있다는 한계가 존재.
압축은 검색에 유용하더라도, 관련이 없거나 중복된 내용의 임베딩은 LLM의 출력 단계에서 환각을 유발
[해결 방법]
- 문서 및 질의의 각 토큰에 대한 컨텍스트 임베딩을 생성
- 각 쿼리 토큰과 문서 내 모든 토큰 간의 유사도를 산출하고 평가
- 모든 질의 임베딩과 해당 문서 임베딩 간의 유사도 중 최댓값을 추출한 후, 이를 모두 합산해 각 문서의 점수를 산정
ColBERT는 질의 토큰마다 문서 토큰의 가장 큰 유사도를 합치는 late interaction 방식을 쓴다. 한 문서를 단일 벡터로 표현하는 검색보다 세부 용어를 잘 구분할 가능성이 있지만, 인덱스 크기와 검색 비용도 커진다. 어느 방식이 더 나은지는 고정된 질문과 정답 문서 집합에서 recall@k와 지연을 비교해야 한다(RAGatouille 공식 저장소).
다음 코드는 네트워크에서 임의의 위키 문서를 받아오지 않고 짧은 실습 문서를 직접 인덱싱한다. 모델 체크포인트 다운로드와 로컬 인덱스 쓰기가 필요하다. RAGatouille와 LangChain의 통합 API는 버전별로 차이가 있으므로, 여기서는 RAG.search 결과만 확인한다.
from ragatouille import RAGPretrainedModel

documents = [
    "휴가는 시작일 3영업일 전까지 신청한다.",
    "병가 신청에는 증빙 서류가 필요하다.",
]
rag = RAGPretrainedModel.from_pretrained("colbert-ir/colbertv2.0")
rag.index(
    collection=documents,
    index_name="policy-demo",
    max_document_length=180,
    split_documents=True,
)
results = rag.search(query="휴가 신청 기한", k=2)
for result in results:
print(result["content"], result["score"])results에는 점수가 높은 조각이 먼저 나온다. 점수가 높다는 사실만으로 그 문서가 최신 규정이거나 사용자에게 허용됐다는 뜻은 아니다. 문서 ID·버전·접근 범위를 별도 메타데이터로 관리해야 한다. 기존 예제에 있던 as_lengchain_retriever는 철자가 잘못됐고, 올바른 as_langchain_retriever도 설치된 LangChain 계열 버전과 통합 패키지의 호환성을 확인해야 한다. 단일 벡터 검색으로 목표 품질이 나온다면 더 무거운 검색기를 도입할 필요는 없다.
인덱싱 결과를 판단하는 순서
문서 두 개를 저장하고 검색 호출이 성공했다고 인덱싱이 끝난 것은 아니다. 다음 네 단계를 같은 질문 집합으로 점검한다.
- 원본 확인: PDF 표의 제목과 열 이름, 적용 날짜가 파싱 후에도 남았는가?
- 청크 확인: 정답의 조건과 예외가 서로 다른 청크로 잘려 의미가 없어지지 않았는가?
- 버전 확인: 수정된 문서가 재인덱싱됐고 이전 버전이 현행 결과에 섞이지 않는가?
- 검색 확인: 질문을 바꿔 말해도 기대 문서가 상위 k개에 들어오는가?
flowchart LR
    A[원본·버전] --> B[파싱]
    B --> C[청크 + 메타데이터]
    C --> D[임베딩]
    D --> E[(인덱스)]
    E --> F[질문별 검색 평가]
    F -->|실패| B
파싱 오류가 있으면 임베딩을 바꿔도 정답 문장이 되살아나지 않는다. 청크 경계가 문제라면 분할 규칙을, 버전 혼합이 문제라면 인덱스 갱신·필터를 고친다. 여러 설정을 한 번에 바꾸면 원인을 찾기 어렵다. 위 Docker Compose 실습에서는 비밀번호를 환경 변수 PGVECTOR_PASSWORD로 받고 포트를 localhost에만 바인딩한다. Python 예제는 PGVECTOR_URL에서 연결 문자열을 읽는다. 비밀번호의 특수 문자는 URL 인코딩하고, 환경 파일과 연결 문자열은 저장소에 올리지 않는다(Docker Compose 환경 변수 문서).
같은 카테고리의 글
이어서 읽을 글
3. RAG 2단계 : 데이터 기반 대화
인덱싱한 문서를 검색해 답변의 근거로 쓰고, 질의 재작성·다중 검색·라우팅으로 검색 품질을 개선하는 방법을 다룬다.
12. 벡터 데이터베이스로 확장하기 : RAG 구현하기
pgvector 예제로 벡터 저장과 색인, 권한 필터, 근거 기반 답변까지 RAG 흐름을 구현합니다.
8. RAG(검색 증강 생성: Retrieval Augmented Generation)
문서를 검색해 근거를 구성하고, 생성 답변의 출처와 한계를 검증하는 RAG의 전체 흐름
11. LLM 애플리케이션 개발
문서 기반 질문 응답 서비스를 예로 들어 문제 정의, RAG 그래프 구현, 인용 검증, 평가와 배포까지 연결하는 개발 절차.