목차
텍스트 클러스터링과 토픽 모델링
텍스트 클러스터링은 정답 레이블 없이 문서의 의미가 가까운 것끼리 묶는 작업이다. 고객 문의 수만 건을 읽기 전에 배송, 결제, 환불 문의가 대략 어떤 비율로 쌓였는지 살피거나, 논문 초록에서 새로 떠오르는 연구 주제를 탐색할 때 유용하다. 반면 클러스터 번호 자체에는 의미가 없다. 17번 군집을 기계 번역이라고 부르려면 그 군집의 문서와 대표 단어를 다시 읽어야 한다. 이 해석 단계까지 포함한 것이 여기서 다룰 토픽 모델링이다.
그림의 핵심은 문장을 단어 빈도만으로 비교하지 않고 임베딩 벡터로 변환한 다음, 가까운 벡터를 묶는다는 점이다. 같은 주제를 다른 단어로 설명한 초록도 가까워질 수 있지만, 임베딩 품질이 낮거나 초록이 여러 주제를 다루면 경계는 흐려진다.
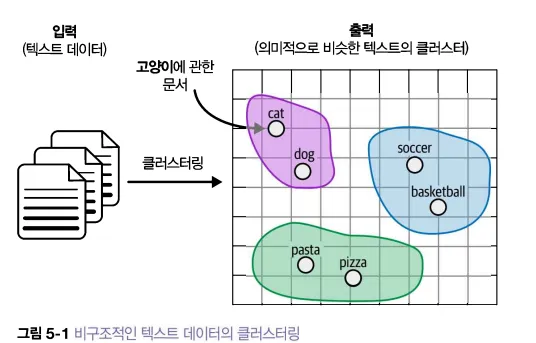
실습 데이터는 arXiv 논문 제목과 초록이다. 기존 예제는 약 4만 5천 건을 한꺼번에 임베딩하므로 CPU 환경에서는 오래 걸릴 수 있다. 처음 따라 해본다면 abstracts = data["Abstracts"][:1000]처럼 일부만 사용하고, 전체 데이터의 결과와 군집 수가 다를 수 있음을 기억하자.
flowchart LR
  A[논문 초록] --> B[문서 임베딩]
  B --> C[UMAP 차원 축소]
  C --> D[HDBSCAN 군집과 잡음]
  D --> E[군집별 대표 단어]
  E --> F[초록 표본을 읽고 주제 이름 붙이기]
이 흐름에서 UMAP과 HDBSCAN은 무엇이 함께 모이는가를 결정하고, 대표 단어와 원문 확인은 그 모임이 무엇을 뜻하는가를 결정한다. 따라서 단어 목록만으로 군집을 확정하지 않는다.
아래 코드는 앞에서 만든 변수들을 다음 단계에서 이어 사용한다. 일부 초록만 선택했다면 이후 임베딩·군집·대표 단어 계산에도 같은 목록을 사용해야 한다.
from datasets import load_dataset

data = load_dataset("maartengr/arxiv_nlp")["train"]

# 데이터 추출
abstracts = data["Abstracts"]
titles = data["Titles"]
텍스트 클러스터링 방법이 많지만 널리 이용되는 파이프라인은 세 개의 단계와 알고리즘으로 구성된다.
- 임베딩 모델
- 입력 문서를 임베딩으로 변환
- 차원 축소 모델
- 임베딩의 차원을 줄임
- 클러스터링 모델
- 의미가 비슷한 문서의 그룹을 찾음
문서 임베딩
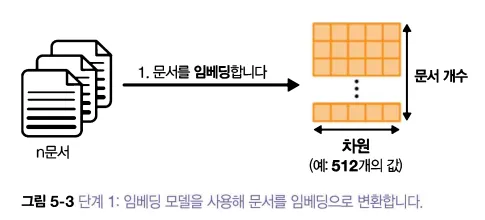
첫 번째 단계는 텍스트를 임베딩으로 바꾼다. 표현이 달라도 비슷한 내용을 가까이 놓아야 하므로, 초록의 언어와 분야에 맞는 임베딩 모델을 고르는 것이 중요하다.
from sentence_transformers import SentenceTransformer

# 임베딩
embedding_model = SentenceTransformer("thenlper/gte-small")
embeddings = embedding_model.encode(list(abstracts), show_progress_bar=True)

print(embeddings.shape)
출력
(44949, 384)- 이 출력 예시에서는 44,949개의 데이터가 각각 384차원 임베딩 벡터로 표현되었다. 데이터셋이 갱신되거나 앞에서 일부만 선택하면 첫 번째 숫자는 달라진다.
임베딩 차원 축소하기
임베딩을 클러스터로 모으기 전에 고차원 공간에서의 거리와 밀도를 고려해야 한다. 차원이 높아지면 같은 밀도로 공간을 채우는 데 필요한 표본이 급격히 늘고, 밀도 기반 군집의 이웃 관계가 불안정해질 수 있다. 여기서는 UMAP으로 차원을 줄인 뒤 군집화한다. 차원 축소가 모든 데이터에서 필수인 것은 아니므로 원본 벡터를 직접 군집화한 결과도 기준선으로 비교할 수 있다.
차원 축소의 목표는 이웃 관계를 가능한 한 유지하면서 거리를 계산하기 쉬운 공간으로 옮기는 것이다. UMAP은 주로 국소적인 이웃 구조를 보존하므로, 축소된 공간에서 멀리 떨어진 두 군집의 거리만 보고 원본 공간에서도 그만큼 다르다고 단정할 수 없다.
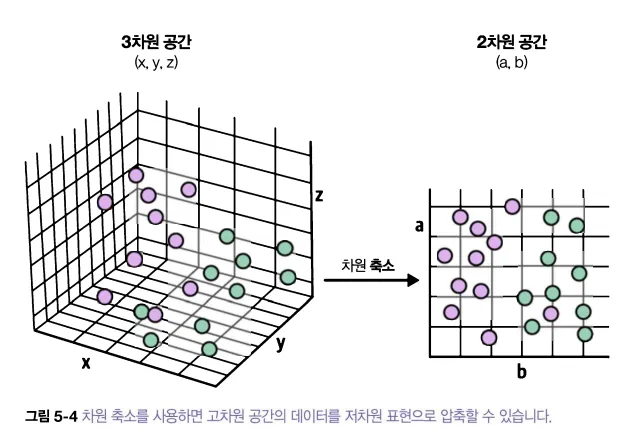
유명한 차원 축소 방법은 PCA와 UMAP이 있다.
차원 축소 기법의 단점은 고차원 데이터를 저차원 데이터로 축소하기에 항상 정보가 손실된다.
from umap import UMAP

umap_model = UMAP(
    n_components=5, min_dist=0.0, metric='cosine', random_state=42
)

reduced_embeddings = umap_model.fit_transform(embeddings)n_components=5는 각 초록을 5차원 점으로 바꾼다는 뜻이다. 그림을 그릴 때는 2차원이 편하지만 군집 품질까지 2차원이 최선이라는 뜻은 아니다. 5~10차원은 출발점일 뿐, 이웃 보존 정도와 군집 결과를 비교해서 조정한다.
min_dist=0.0은 저차원 점을 더 조밀하게 놓을 수 있게 한다. metric='cosine'은 원본 임베딩 사이의 이웃을 코사인 거리로 찾는 설정이다. 두 값 모두 군집 모양에 영향을 주므로 시각적으로 예쁜 그림만 보고 선택하지 않는다.
random_state는 비교 실험을 위한 재현성 설정이다. UMAP 구현에서는 시드 지정 때문에 일부 병렬 최적화가 제한될 수 있으므로, 재현성과 실행 시간을 함께 고려한다.
축소된 임베딩 클러스터링
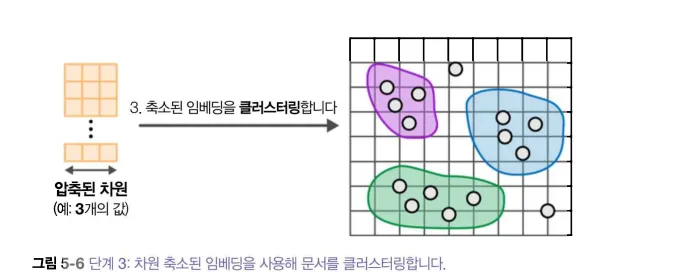
k-평균은 정해 둔 개수의 중심에 모든 문서를 할당한다. 주제 수를 미리 정하기 어렵고 어느 묶음에도 잘 속하지 않는 초록을 따로 살펴보고 싶다면 HDBSCAN을 시도할 수 있다. HDBSCAN은 조밀한 영역을 군집으로 찾고 나머지를 잡음 레이블 -1로 둔다. 그렇다고 -1이 곧 잘못된 논문이나 이상치라는 뜻은 아니다. 짧은 초록, 여러 주제가 섞인 초록, 임베딩 모델의 어휘 밖 표현도 같은 레이블을 받을 수 있다.
from hdbscan import HDBSCAN

# 모델을 훈련하고 클러스터 추출
hdbscan_model = HDBSCAN(min_cluster_size=50).fit(reduced_embeddings)
clusters = hdbscan_model.labels_

# 클러스터 개수 추출
print(len(set(clusters) - {-1}))  # -1은 군집이 아닌 잡음
출력되는 군집 수는 데이터 버전·패키지 버전·설정에 따라 달라진다. 원래 실습의 len(set(clusters))는 잡음 레이블 -1까지 한 군집으로 셀 수 있었다. 위 코드는 -1을 제외하므로 원래 출력 숫자를 그대로 옮기지 않는다. min_cluster_size를 줄이면 작은 군집이 늘어날 가능성이 있지만, 과도한 분할도 생길 수 있다. 아래처럼 잡음 비율을 함께 확인한다.
from collections import Counter

counts = Counter(clusters)
print("군집 수:", len(counts) - (-1 in counts))
print("잡음 문서 비율:", counts[-1] / len(clusters))
print("큰 군집 5개:", [(key, count) for key, count in counts.most_common() if key != -1][:5])
잡음이 많다면 이상한 논문이 많다는 뜻일 수도 있지만, 임베딩 모델이 도메인 용어를 잘 표현하지 못했거나 min_samples가 너무 엄격할 수도 있다. 반대로 거의 모든 초록이 하나의 거대한 군집에 몰리면 의미 있는 주제 구분에 실패한 것이다.
예를 들어 번역 초록 80편이 한 군집에 모였는데 그중 20편은 음성 번역, 60편은 문서 번역이라면 이 군집을 그대로 한 주제로 써도 되는지 목적에 따라 다르다. 연구 동향을 거칠게 훑는다면 번역이라는 이름이 유용할 수 있다. 세부 연구비 배분을 결정한다면 둘을 구분해야 한다. min_cluster_size를 낮추어 두 군집으로 나뉘더라도 각 군집의 초록이 실제로 다른 문제를 다루는지 확인해야 한다. 숫자가 더 많이 나왔다고 토픽 품질이 좋아진 것은 아니다.
반대로 같은 연구팀의 논문들이 문체와 자주 쓰는 표현 때문에 한 군집에 몰릴 수도 있다. 제목과 대표 단어가 비슷하더라도 연구 문제가 다른 초록이 섞여 있으면 임베딩 모델이나 입력 정제 규칙을 재검토한다. 군집 ID만 보고 자동으로 게시판 카테고리를 붙일 계획이라면, 사람이 이름을 붙인 표본에서 잘못 분류된 비율을 먼저 측정한다.
텍스트 클러스터링에서 토픽 모델링으로
텍스트 클러스터링은 대규모 문서 집합에 내재된 구조를 발견하는 데 사용되는 강력한 기법이다. 문서 간의 유사성을 기반으로 문서들을 그룹화함으로써, 방대한 텍스트 데이터 속에서 의미 있는 패턴을 파악할 수 있다. 이러한 텍스트 데이터 집합에서 문서들이 공통적으로 다루는 주제나 잠재적인 의미 구조를 찾아내는 과정을 토픽 모델링(Topic Modeling) 이라고 한다.
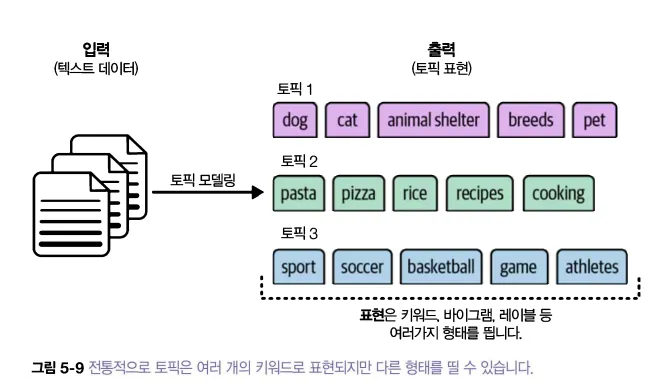
예를 들어 한 군집에서 translation, multilingual, language, cross-lingual이 반복된다면 다국어 번역을 후보 이름으로 붙일 수 있다. 그러나 단어 빈도만 세면 모든 군집에서 model, learning, data처럼 흔한 말이 상위에 오른다. 그래서 군집을 하나의 문서처럼 합친 후, 다른 군집에서도 흔한 단어는 낮게 평가하는 c-TF-IDF 방식이 자주 쓰인다. 군집이 만들어지는 과정과 이름을 붙이는 과정은 별개이다.
아래 코드는 기존 abstracts, clusters를 그대로 받아 대표 단어를 뽑는 간단한 출발점이다. 이 코드는 c-TF-IDF가 아니라 일반 TF-IDF이므로, 엄밀한 토픽 점수라기보다는 사람이 읽을 군집 후보를 좁히는 도구이다.
from collections import defaultdict
from sklearn.feature_extraction.text import TfidfVectorizer

grouped = defaultdict(list)
for label, abstract in zip(clusters, abstracts):
    if label != -1 and abstract:
        grouped[int(label)].append(str(abstract))

labels = sorted(grouped)
corpus = [" ".join(grouped[label]) for label in labels]
vectorizer = TfidfVectorizer(stop_words="english", max_features=10000)
scores = vectorizer.fit_transform(corpus)
terms = vectorizer.get_feature_names_out()

for row, label in enumerate(labels[:10]):
    top_indices = scores[row].toarray().ravel().argsort()[-8:][::-1]
    print(label, [terms[index] for index in top_indices])
print("대표 논문:", grouped[label][0][:180])zip은 문서와 레이블을 한 쌍으로 맞춘다. -1을 빼고 군집별 초록을 이어 붙이면 corpus의 한 원소가 한 군집이 된다. fit_transform의 한 행은 해당 군집의 단어 점수이다. 상위 8개 단어와 실제 초록을 함께 보고 이름을 정한다. 제목까지 읽으면 추상적인 초록 문구로 인한 오해를 줄일 수 있다. 군집 수가 하나뿐이거나 모든 텍스트가 비어 있으면 TF-IDF는 의미 있는 비교를 할 수 없으므로 먼저 입력을 확인한다.
결과가 쓸 만한지 판단하기
군집 수 하나로 품질을 말하기는 어렵다. 각 군집에서 크기가 큰 문서, 중앙에 가까운 문서, 경계에 있는 문서를 몇 개씩 읽어보자. 같은 군집 안에서 논문들이 같은 문제를 다루는지, 다른 군집과 주제가 구분되는지, 잡음으로 분류된 문서가 정말 특이한지 확인한다. 정답 주제 레이블이 일부라도 있다면 사람이 붙인 레이블과의 일치도도 비교할 수 있다.
새 초록이 계속 추가되는 서비스라면 UMAP과 HDBSCAN을 다시 학습할 때 군집 번호가 바뀔 수 있다. 23번 = 번역처럼 번호를 영구 식별자로 저장하지 말고, 대표 단어·대표 문서·모델 버전을 함께 보관하는 편이 안전하다. 짧은 제목만 입력하거나 다른 언어의 논문을 섞으면 임베딩 분포가 바뀌므로 같은 파라미터가 그대로 통하지 않을 수도 있다.
참고 문서: UMAP의 파라미터, UMAP을 군집화에 사용하는 방법, HDBSCAN 기본 사용법