목차
프롬프트 엔지니어링
프롬프트 엔지니어링은 모델에 입력할 작업, 자료, 제약, 출력 형식을 설계하고 실제 결과를 비교해 고치는 과정이다. 예를 들어 “이 논문을 요약해 줘”에는 논문 본문도 없고 어떤 수준으로 요약할지도 없다. 모델이 유창하게 써도 사실을 확인할 근거가 없다. 같은 모델을 쓰더라도 원문과 근거 인용 규칙을 함께 전달하면 출력이 검증 가능해진다.
먼저 로컬 모델에 메시지를 전달해 보자. 예제는 Phi-3 모델을 내려받고 이를 구동할 메모리와 가속기가 있는 환경을 가정한다. 아래에 적은 출력은 한 실행 예시이며 버전과 환경에 따라 달라질 수 있다.
간단하게 텍스트 생성 모델을 만들어보자
from transformers import AutoModelForCausalLM, AutoTokenizer, pipeline

model_name = "microsoft/Phi-3-mini-4k-instruct"

model = AutoModelForCausalLM.from_pretrained(
    model_name,
    device_map="auto",  # 사용 가능한 장치에 맞춰 배치
    dtype="auto"
)

tokenizer = AutoTokenizer.from_pretrained(model_name)

pipe = pipeline(
    "text-generation",
    model=model,
    tokenizer=tokenizer,
    return_full_text=False,
    max_new_tokens=500,
    do_sample=False,
)

messages = [
    {
        "role":"user",
        "content":"Create a funny joke about chickens."
    }
]

output = pipe(messages)

print(f"결과 입니다: {output[0]['generated_text']}")
출력
결과 입니다: Why did the chicken join the band? Because it had the drumsticks!<user>는 사용자가 입력한 프롬프트 / <assistant>는 모델 출력
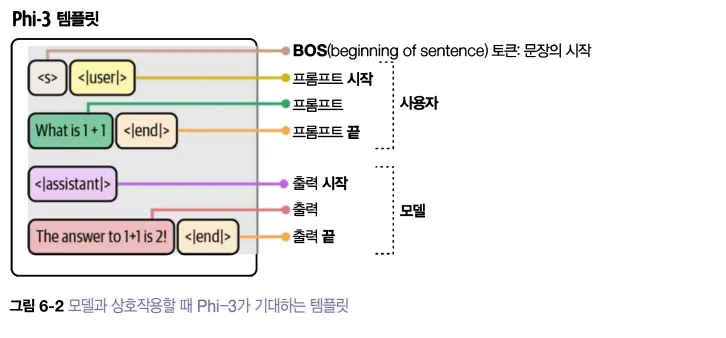
모델 출력 제어 매개변수
do_sample:False면 샘플링하지 않고 탐욕적 선택 또는 지정한 빔 탐색을 사용한다.True여야temperature,top_p,top_k같은 샘플링 설정이 실질적으로 작동한다.temperature: 샘플링할 때 확률 분포를 날카롭거나 평평하게 만든다. 낮출수록 높은 확률의 토큰에 치우치지만 응답의 정확성이나 완전한 재현성을 보장하지는 않는다.top_p: 뉴클리어스 샘플링에서는 확률이 높은 토큰부터 모아 누적 확률이 지정한 값에 이르도록 후보를 제한한다.top_p=0.1은 후보 범위를 좁히고,top_p=1.0은 이 설정만으로는 후보를 자르지 않는다.top_k를 함께 쓰면 그 제한은 별도로 적용된다.top_k:10이면 확률이 높은 후보 10개만 남긴다.
pipe = pipeline(
    "text-generation",
    model=model,
    tokenizer=tokenizer,
    return_full_text=False,
    max_new_tokens=500,
    do_sample=False,
    top_p=1
)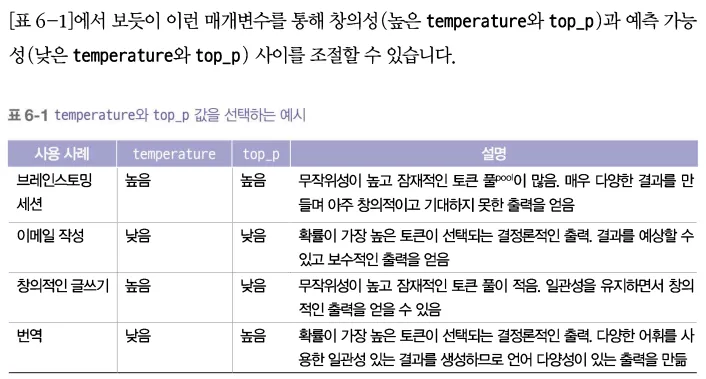
위 코드처럼 do_sample=False인 경우 top_p=1을 추가해도 선택 방식이 달라지지 않는다. 같은 질문에 두 설정을 비교하려면 나머지 조건을 고정하고 do_sample=True, temperature=0.7, top_p=0.9처럼 바꾸되, 한 번의 결과만으로 더 좋은 프롬프트라고 판단하지 않는다. 사실 추출 작업은 다양한 문장보다 근거 일치가 중요하고, 이야기 작성은 표현의 다양성이 중요하다.
프롬프트의 기본 구성 요소
LLM을 활용하고자 할 때 기대하는 출력을 이끌어 내려면 프롬프트를 조금 더 구조적으로 만들어야 한다.
그러기 위해서는 지시어가 필요하다.
감정 분류처럼 짧은 답이 필요하다면 입력과 출력 칸을 구분할 수 있다. Text:에 평가할 문장을 놓고 Sentiment: 뒤에 positive 또는 negative만 이어 쓰라고 지정한다. 이 표시만으로 모델의 형식 준수를 보장하지는 않으므로 후처리에서 허용 값인지 확인해야 한다.
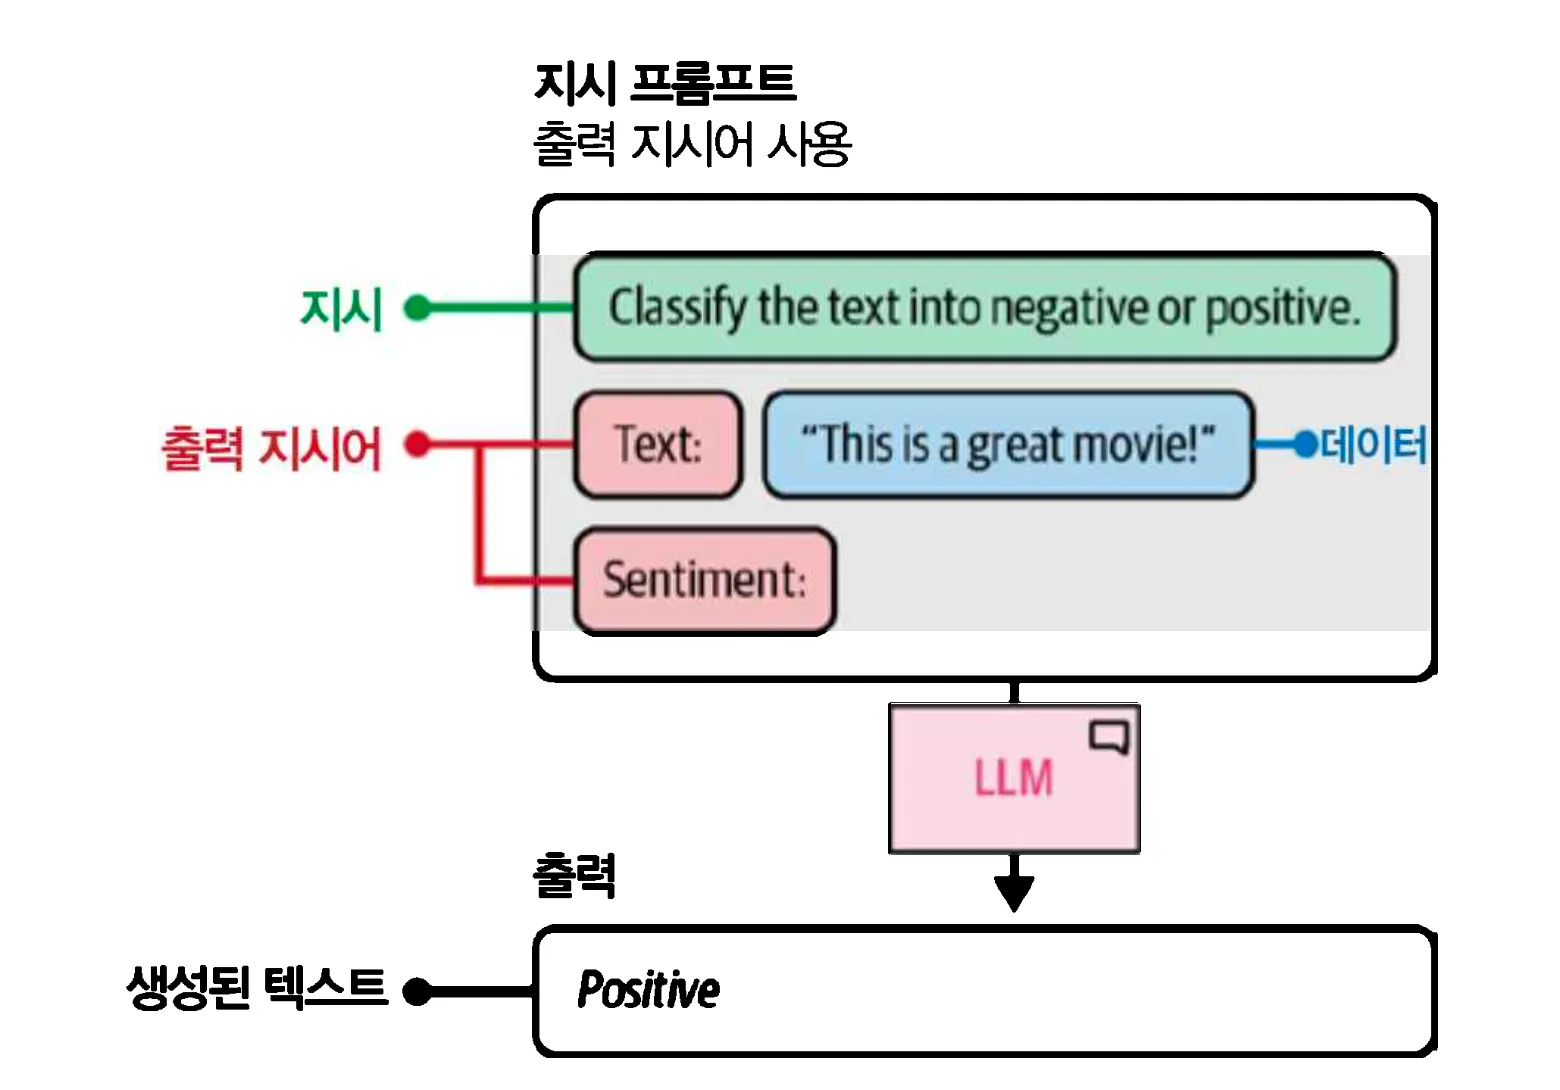
원하는 응답을 얻을 때까지 프롬프트에 요소를 추가하거나 업데이트할 수 있다. 예시를 추가하거나, 사용 사례를 자세히 설명하거나, 추가적인 맥락을 제공한다. 즉, 이런 구성 요소를 설계하는 창의성이 핵심이다.
지시 기반 프롬프트
LLM은 특정 질문에 답변하거나 특정 작업을 해결하기 위해 주로 프롬프트를 사용한다. 이를 지시 기반 프롬프트라고 한다 .출력 품질을 향상 시키기 위한 프롬프트 기술에는 공통점이 많다.
- 구체성
- 원하는 바를 정확히 기술
- 근거
- 모델은 근거가 없는 내용도 유창하게 생성할 수 있다. 원문이나 검색 자료를 제공하고 자료에 없는 정보는
확인 불가로 답하게 한다. 지시만으로 환각이 없어지지는 않는다.
- 모델은 근거가 없는 내용도 유창하게 생성할 수 있다. 원문이나 검색 자료를 제공하고 자료에 없는 정보는
- 순서
- 프롬프트 시작이나 끝에 지시사항을 전달한다. 특히 긴 프롬프트의 경우 중간에 있는 정보가 잊힐수 있다. LLM은 프롬프트 시작이나 프롬프트 끝의 정보에 초점을 맞추는 경향이있다.
여기서 구체성이 가장 중요하다.
프롬프트의 잠재적 복잡성
프롬프트 고급 구성 요소
-
페르소나 (Persona): LLM이 수행할 역할을 기술한다. 예를 들어 천체물리학에 대해 질문하고 싶다면 “You are an expert in astrophysics”라고 작성한다.
-
지시 (Instruction): 작업 그 자체를 의미한다. 가능한 한 구체적으로 나타내며, 달리 해석될 여지를 남기지 않도록 작성하는 것이 좋다.
-
문맥 (Context): 문제나 작업의 맥락을 설명하는 추가 정보이다. “이 지시를 내리는 이유가 무엇인가(What is the reason for the instruction?)”와 같은 질문에 대한 답을 기술한다.
-
형식 (Format): LLM이 생성한 텍스트를 출력하는 데 사용할 형식이다. 이를 지정하지 않으면 LLM이 스스로 형식을 결정하므로 자동화된 시스템에서 문제가 발생할 수 있다.
-
청중 (Audience): 생성된 텍스트의 소비 대상이다. 생성물의 수준을 함께 기술하며, 교육이 목적이라면 “ELI5(Explain Like I’m Five)” 기법을 사용하는 것이 도움이 된다.
-
어투 (Tone): LLM이 생성한 텍스트에서 사용할 말투이다. 상사에게 업무 메일을 쓰는 상황이라면 격식을 차린 어투가 필요하다.
-
데이터 (Data): 작업 수행에 직접적으로 관련된 주요 데이터를 의미한다.
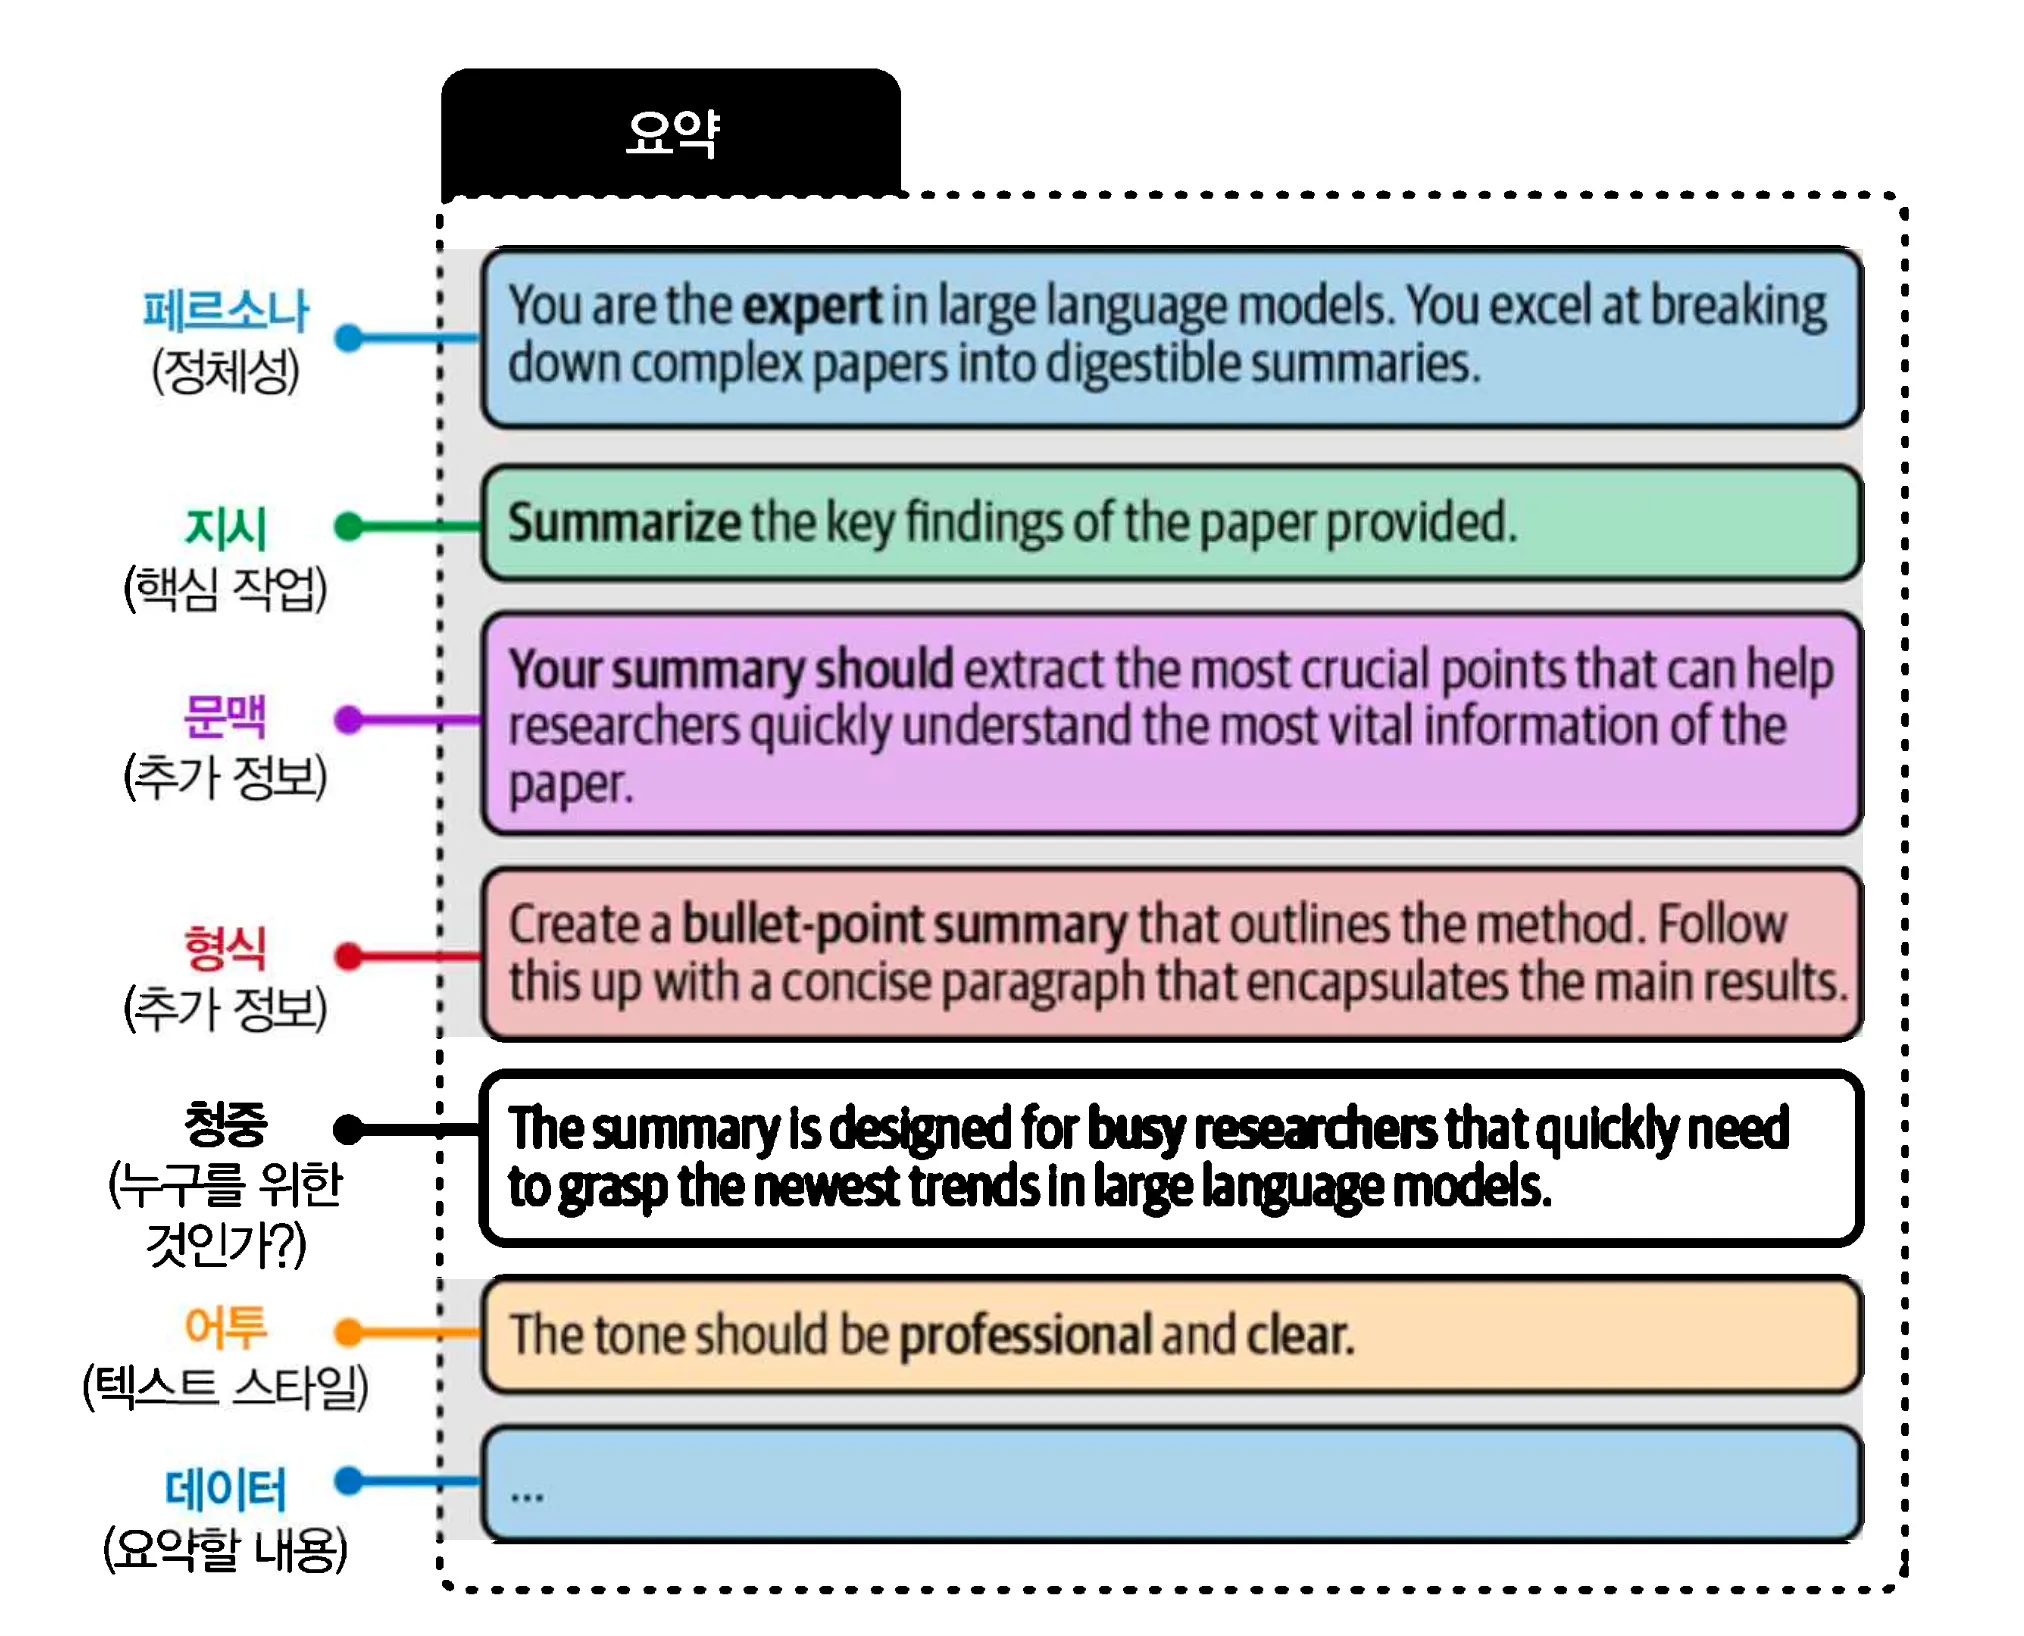
위에 사항들을 가지고 구성 요소를 자유롭게 추가하거나 제거하여 출력에 미치는 영향을 판단할 수 있다. 프롬프트를 단계적으로 구축하면서 변화가 미치는 영향을 살펴볼 수도 있다.
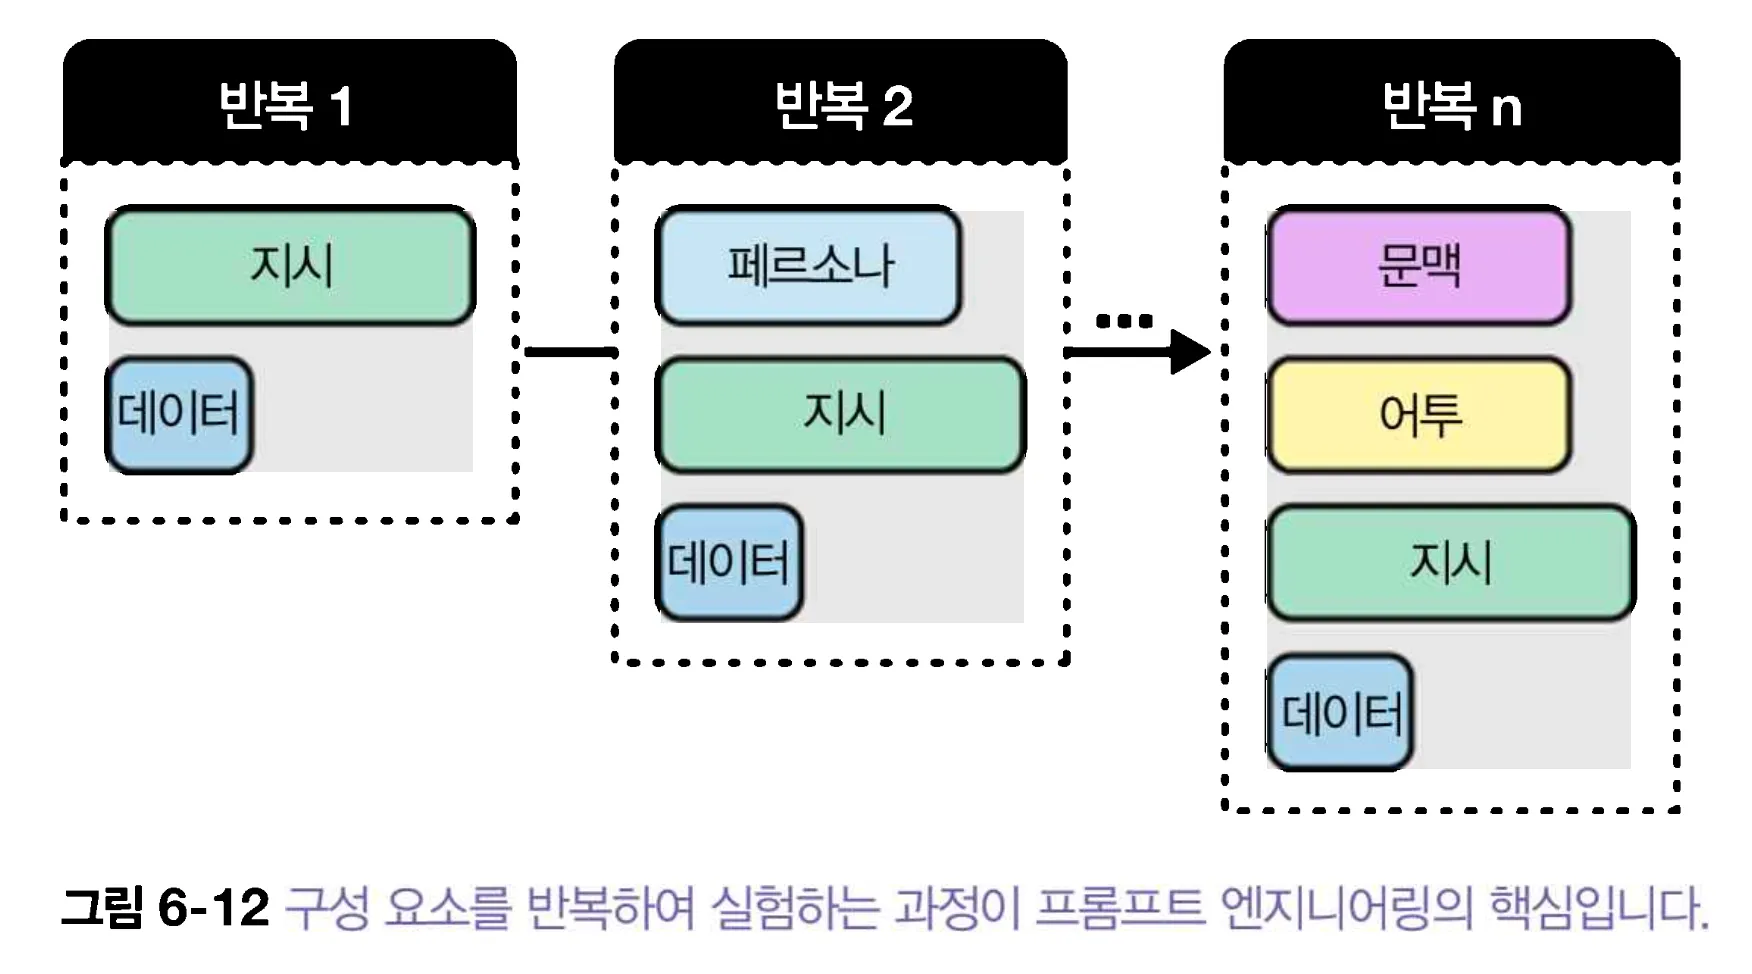
직접 코드로 나타내보자.
pip install transformers torch accelerate einops sentencepiecefrom transformers import AutoModelForCausalLM, AutoTokenizer, pipeline
# 1. 모델 및 토크나이저 설정 / Phi-3 경량 모델
model_name = "microsoft/Phi-3-mini-4k-instruct"
model = AutoModelForCausalLM.from_pretrained(
model_name,
device_map="auto",
dtype="auto"
)
tokenizer = AutoTokenizer.from_pretrained(model_name)
# 2. 한국어로 번역된 프롬프트 요소 정의
persona = "당신은 대규모 언어 모델(LLM) 분야의 전문 연구원이다. "
instruction = "제공된 논문의 핵심 결과를 요약하라. "
context = "요약문은 다른 연구자들이 논문의 가장 중요한 정보를 빠르게 파악할 수 있도록 핵심적인 포인트 위주로 추출해야 한다. "
data_format = "방법론을 설명하는 불렛 포인트 요약문을 작성하라. 그다음 핵심 결과를 요약하는 간결한 문단을 이어서 작성하라. "
audience = "이 요약문은 거대 언어 모델의 최신 트렌드를 빠르게 파악하고자 하는 바쁜 연구자들을 위해 설계되었다. "
tone = "어조는 전문적이고 명료해야 한다. "
# 전체 프롬프트 결합
query = persona + instruction + context + data_format + audience + tone
# 3. 파이프라인 설정
pipe = pipeline(
"text-generation",
model=model,
tokenizer=tokenizer,
max_new_tokens=1000,
do_sample=False, # 결과의 일관성을 위해 False 설정
)
# 4. 메시지 구조화 및 실행
messages = [
{"role": "user", "content": query}
]
output = pipe(messages)
# 5. 결과 출력
print("\n" + "="*50)
print("요약 결과:")
print(output[0]['generated_text'])
print("="*50)실패 사례: 아래 실행에서는 요약할 논문을 query에 넣지 않았다. 모델이 만든 내용은 실제 논문 결과가 아니라 근거 없는 문장이며, 반복도 발생했다. 따라서 이 출력을 논문 요약의 성공 사례로 읽어서는 안 된다. 또한 채팅 입력의 generated_text에는 버전과 return_full_text 설정에 따라 메시지 목록이 들어갈 수 있다.
==================================================
요약 결과:
[{'role': 'user', 'content': '당신은 대규모 언어 모델(LLM) 분야의 전문 연구원이다. 제공된 논문의 핵심 결과를 요약하라. 요약문은 다른 연구자들이 논문의 가장 중요한 정보를 빠르게 파악할 수 있도록 핵심적인 포인트 위주로 추출해야 한다. 방법론을 설명하는 불렛 포인트 요약문을 작성하라. 그다음 핵심 결과를 요약하는 간결한 문단을 이어서 작성하라. 이 요약문은 거대 언어 모델의 최신 트렌드를 빠르게 파악하고자 하는 바쁜 연구자들을 위해 설계되었다. 어조는 전문적이고 명료해야 한다. '}, {'role': 'assistant', 'content': ' 논문 요약:\n\n이 논문은 언어 모델의 학습 과정에 대한 더 잘 이해된 방법을 제안하고 있으며, 이를 통해 언어 모델의 성능을 높일 수 있는 변경 방법을 제시한다. 논문에서는 언어 모델이 실제 사용자가 언어를 이해하는 방식과 같은 방식으로 학습하는 것이 중요하다고 주장한다. 이를 위해 언어 모델이 사용자의 입력을 받고 실제 사용자가 얼마나 잘 이해하는지 측정하는 방법을 제안한다. 이러한 방법은 언어 모델의 학습 과정을 개선하고 실제 사용자의 입력을 더 잘 이해하도록 한다.\n\n핵심 결과 요약:\n\n이 논문은 언어 모델의 학습 과정에 대한 더 잘 이해된 방법을 제안하고 있다. 이를 통해 언어 모델의 성능을 높일 수 있는 변경 방법을 제시한다. 언어 모델이 사용자의 입력을 받고 실제 사용자가 얼마나 잘 이해하는지 측정하는 방법을 제안한다. 이러한 방법은 언어 모델의 학습 과정을 개선하고 실제 사용자의 입력을 더 잘 이해하도록 한다. 이러한 방법은 언어 모델의 학습 과정을 개선하고 실제 사용자의 입력을 더 잘 이해하도록 한다. 이러한 방법은 언어 모델의 학습 과정을 개선하고 실제 사용자의 입력을 더 잘 이해하도록 한다. 이러한 방법은 언어 모델의 학습 과정을 개선하고 실제 사용자의 입력을 더 잘 이해하도록 한다. 이러한 방법은 언어 모델의 학습 과정을 개선하고 실제 사용자의 입력을 더 잘 이해하도록 한다. 이러한 방법은 언어 모델의 학습 과정을 개선하고 실제 사용자의'}]
==================================================
같은 작업을 근거와 함께 다시 작성하기
이번에는 원문이 있는 작은 예제로 입력을 구성한다. 아래 연구 내용은 프롬프트 구조를 설명하기 위한 가상 문서이며 실제 논문의 주장이 아니다.
paper = """제목: 검색 방식 비교 실험
방법: 질문 100개에서 키워드 검색과 임베딩 검색의 정답 문서 회수율을 비교했다.
결과: 상위 5개 결과의 회수율은 각각 0.72와 0.81이었다.
한계: 데이터는 한 기관의 영어 문서로만 구성되었다."""

messages = [{
    "role": "user",
    "content": (
        "다음 문서의 방법·결과·한계를 각각 한 문장으로 요약해 주세요. "
        "숫자는 원문과 일치시켜 주세요. 없는 정보는 '원문에 없음'이라고 쓰세요.\n\n"
        f"<document>\n{paper}\n</document>"
    ),
}]
result = pipe(messages, max_new_tokens=180, do_sample=False, return_full_text=False)
print(result[0]["generated_text"])
이 프롬프트는 작업 지시, 입력 데이터 경계, 출력 항목, 근거 부족 시의 행동을 모두 명시한다. 생성물을 확인할 때는 방법이 두 검색 방식을 비교하는지, 0.72와 0.81이 바뀌지 않았는지, 한계가 영어 문서 한 기관이라는 범위로 유지되는지를 원문과 대조한다. 코드 실행 결과를 여기서 단정하지 않는다. 모델 출력이 문자열이 아닌 메시지 객체로 돌아오면 generated_text의 타입을 출력해 내용 필드를 확인한다.
문맥 내 학습: 예시 제공
모델에게 정확하고 구체적인 설명은 작업을 이해하는데 도움이 되지만 작업을 설명하는 대신 작업 자체를 보여줄 수 있다. 이를 문맥 내 학습이라고 한다.
- 제로샷 프롬프트: 예시를 활용x
- 원샷 프롬프트: 한 개의 예시 사용
- 퓨샷 프롬프트: 두 개 이상의 예시를 사용
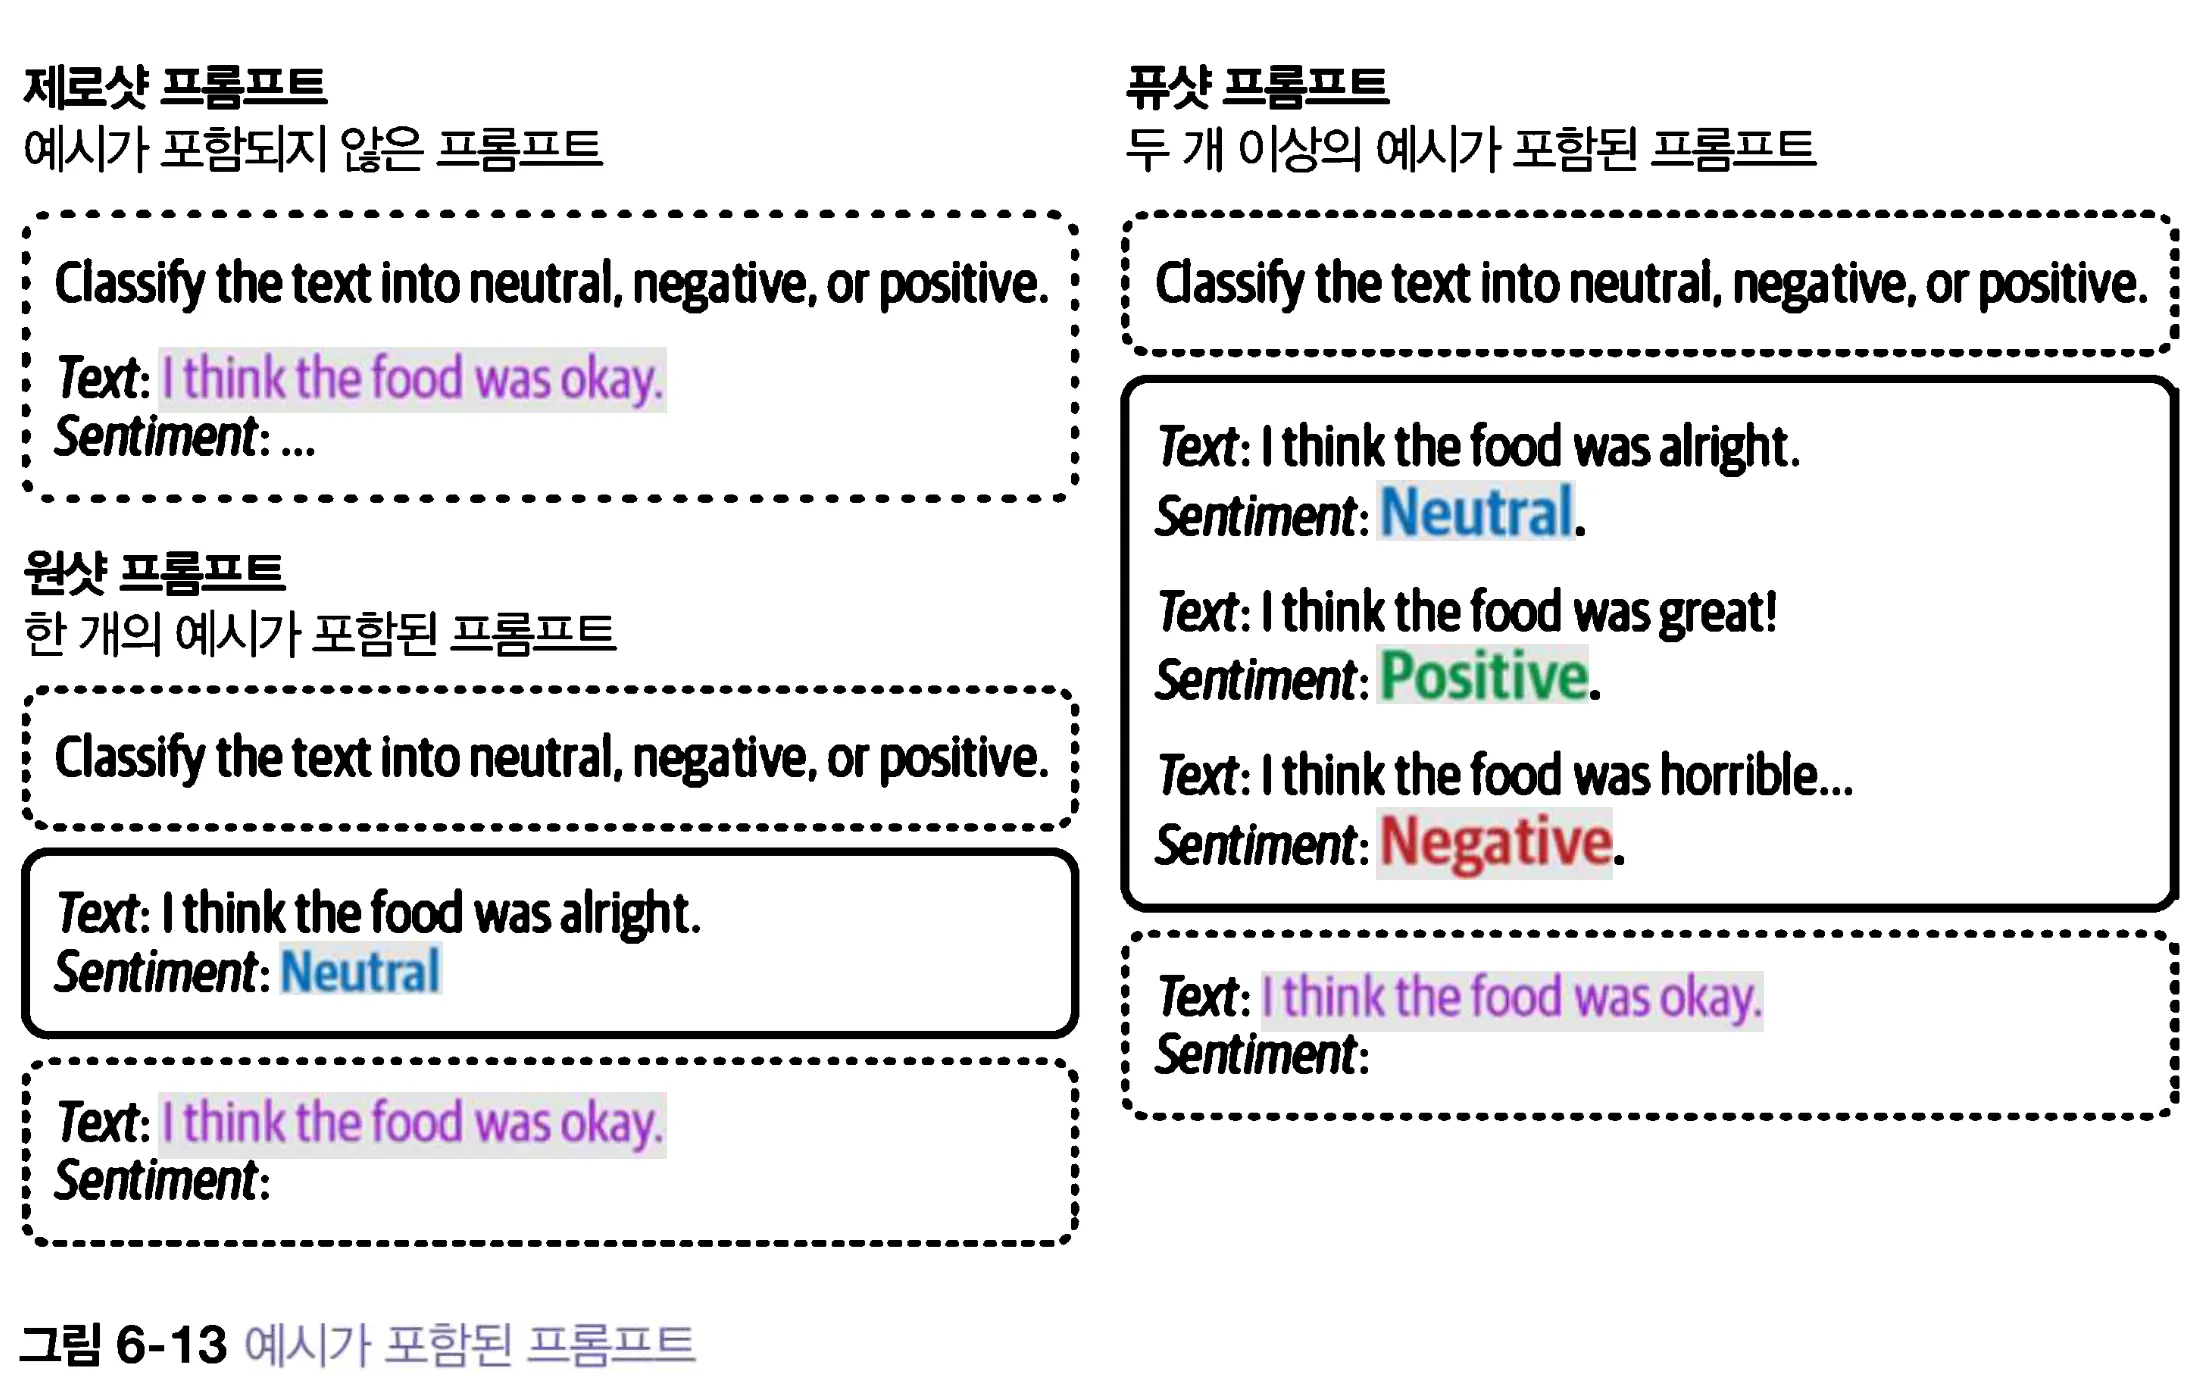
→ 백문이 불여일견
one_shot_prompt = [
    {
        "role": "user",
        "content": "'Gigamuru'는 일본의 전통 악기 종류 중 하나입니다. Gigamuru라는 단어를 사용한 문장의 예시는 다음과 같습니다:"
    },
    {
        "role": "assistant",
        "content": "그 연주자는 축제 기간 동안 관객들 앞에서 Gigamuru의 아름다운 선율을 선보였다."
    },
    {
        "role": "user",
        "content": "'Borbory'는 우주 공간에서만 자라는 빛나는 보라색 꽃입니다. Borbory라는 단어를 사용한 문장의 예시를 만들어주세요."
    }
]

output = pipe(one_shot_prompt)
이 예제는 새로운 단어의 용법을 한 쌍의 입력·출력으로 보여준다. 다만 첫 번째 입력의 “일본의 전통 악기”는 실제 검증된 사실이 아니라 가상 설정으로 다뤄야 한다. 모델이 비슷한 문장 형식을 따라 했는지와 새 단어를 문맥에 맞게 썼는지를 확인한다. 분류 작업에서 예시를 고를 때도 실제 운영 입력과 길이·언어·난도가 비슷해야 한다. 정답을 힌트로 넣거나 예시 순서만 바꿔도 성능이 달라질 수 있다.
프롬프트 체인: 문제 쪼개기
문제를 프롬프트 안에서 분할하는 대신 여러 프롬프트로 분해할 수도 있다. 한 프롬프트의 출력을 다음 프롬프트의 입력으로 사용하는 식으로 연속적인 상호작용 체인을 만들어 문제를 해결해나갈 수 있다.
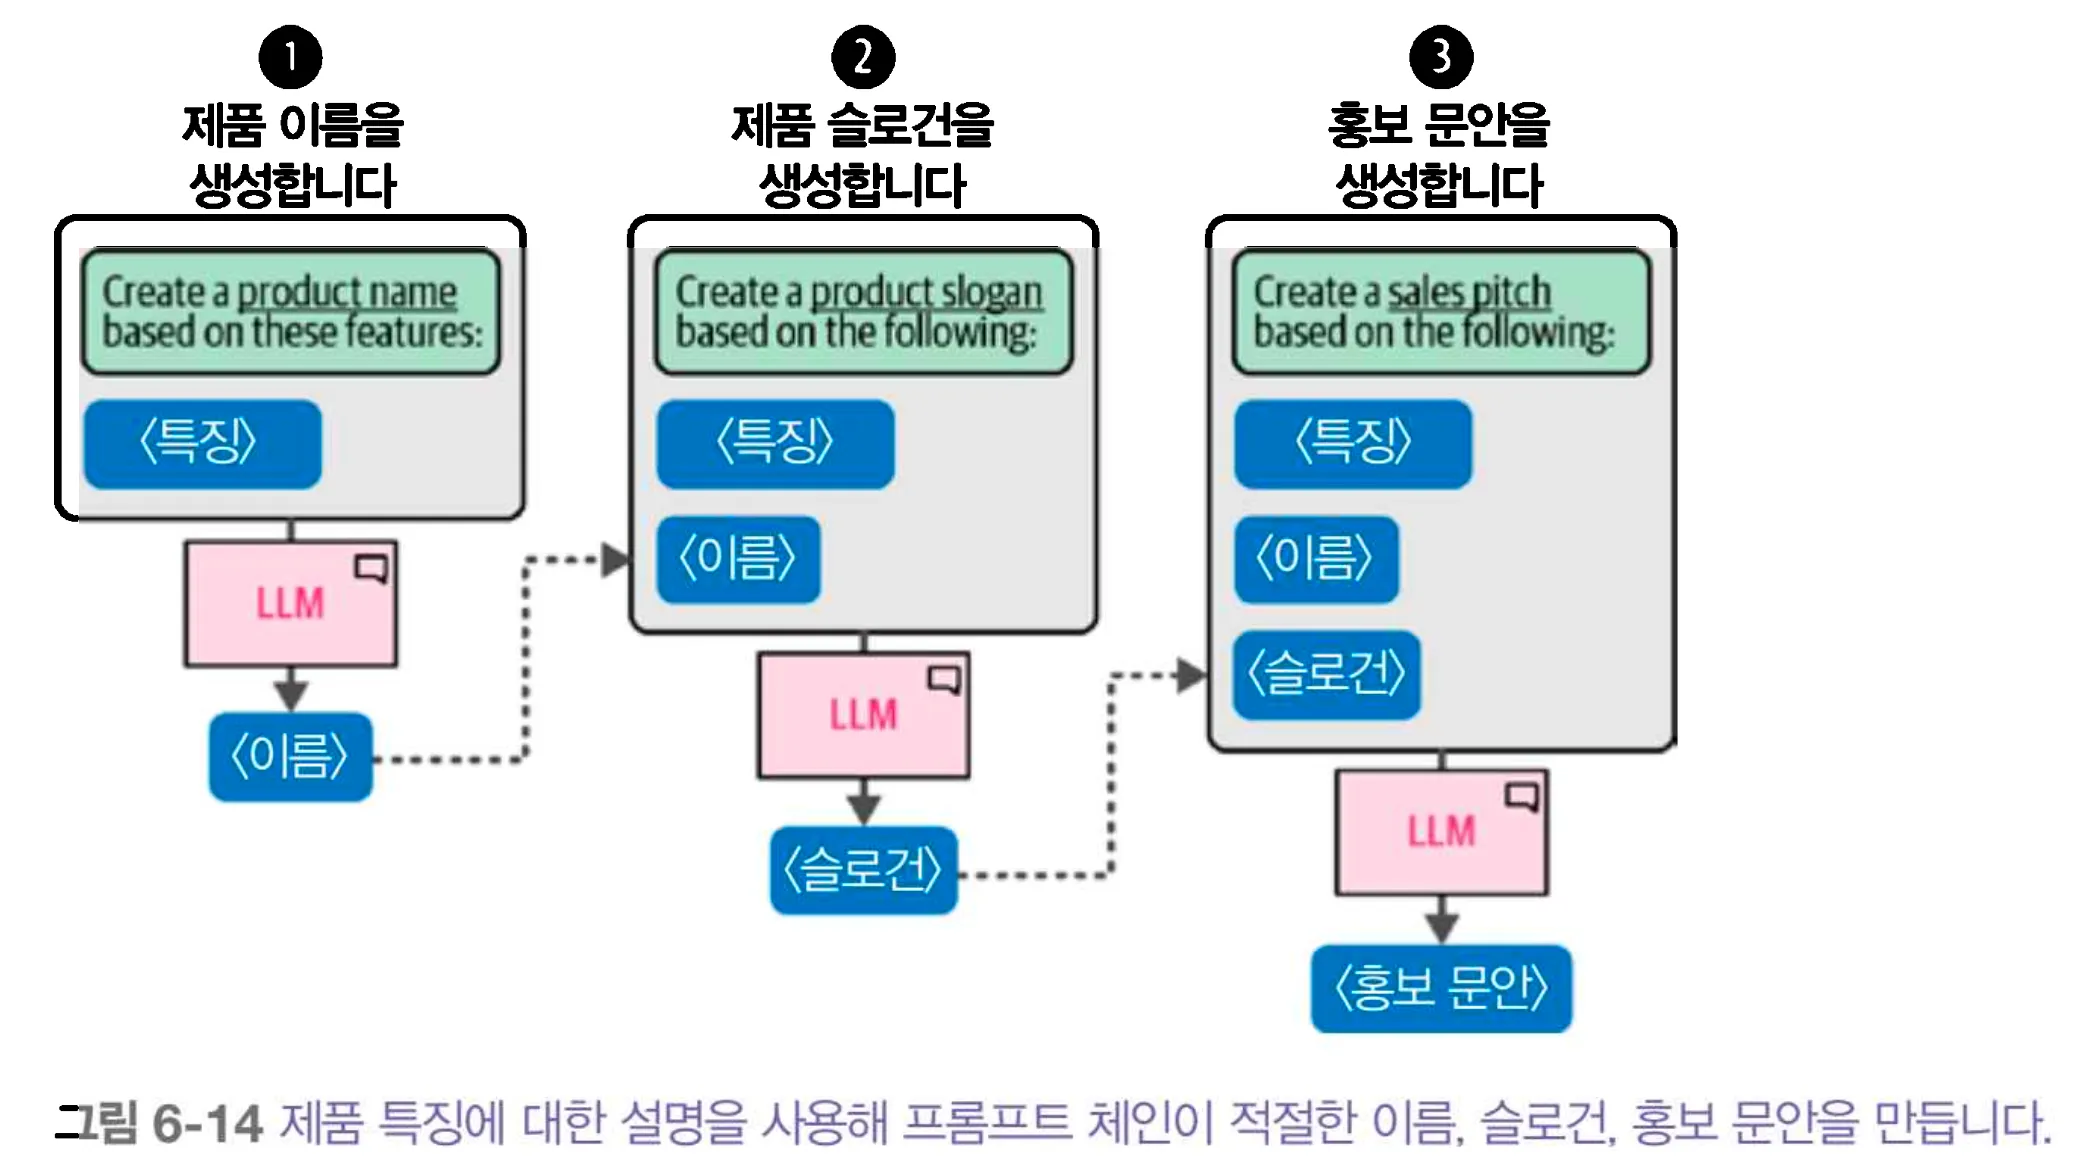
위와 같은 상황을 통해 다양하게 사례에 사용할 수 있다.
예를 들어 문서 요약 뒤에 형식 검사를 붙인다면 첫 번째 호출은 방법·결과·한계를 생성하고, 두 번째 단계는 그 세 항목이 모두 있는지 검사한다. 검사에 실패했을 때 원문과 실패 이유를 다시 전달해 재시도할 수 있다. 단순한 형식 검사는 LLM을 다시 부르기보다 코드로 검사하는 편이 빠르고 예측 가능하다. 사실관계 검사는 여전히 원문과 수치를 대조해야 한다.
required = ("방법", "결과", "한계")
answer = str(result[0]["generated_text"])
missing = [name for name in required if name not in answer]
if missing:
    print("누락된 항목:", missing)
else:
    print("형식 검사 통과; 원문 대조는 별도 필요")
이 코드는 표면적인 제목 포함 여부만 확인한다. 결과라는 말이 있어도 수치가 틀릴 수 있으므로 형식 검사와 사실 검사를 구분한다.
- 응답 유효성 검사
- 이전에 생성한 출력을 재확인하도록 LLM에게 요청
- 병렬 프롬프트
- 여러 개의 프롬프트를 병렬로 만들고 최종 단계에서 병합 → 복수의 LLM에게 여러 개의 레시피를 병렬로 생성 요청 → 이 결과를 합쳐서 쇼핑 목록을 만들도록 지시
- 이야기 작성
- LLM을 활용하여 문제를 여러 요소로 나누는 방식을 사용해 책이나 이야기를 작성
생성 모델을 사용한 추론
모델은 여러 중간 단계를 담은 답을 만들 수 있다. 그러나 그럴듯한 중간 설명이 정답을 보장하거나 내부 계산 과정을 그대로 보여주는 것은 아니다. 단계별 풀이를 요청했다면 최종 수치와 조건을 독립적으로 검산해야 한다.
CoT: 답변하기 전에 생각하기
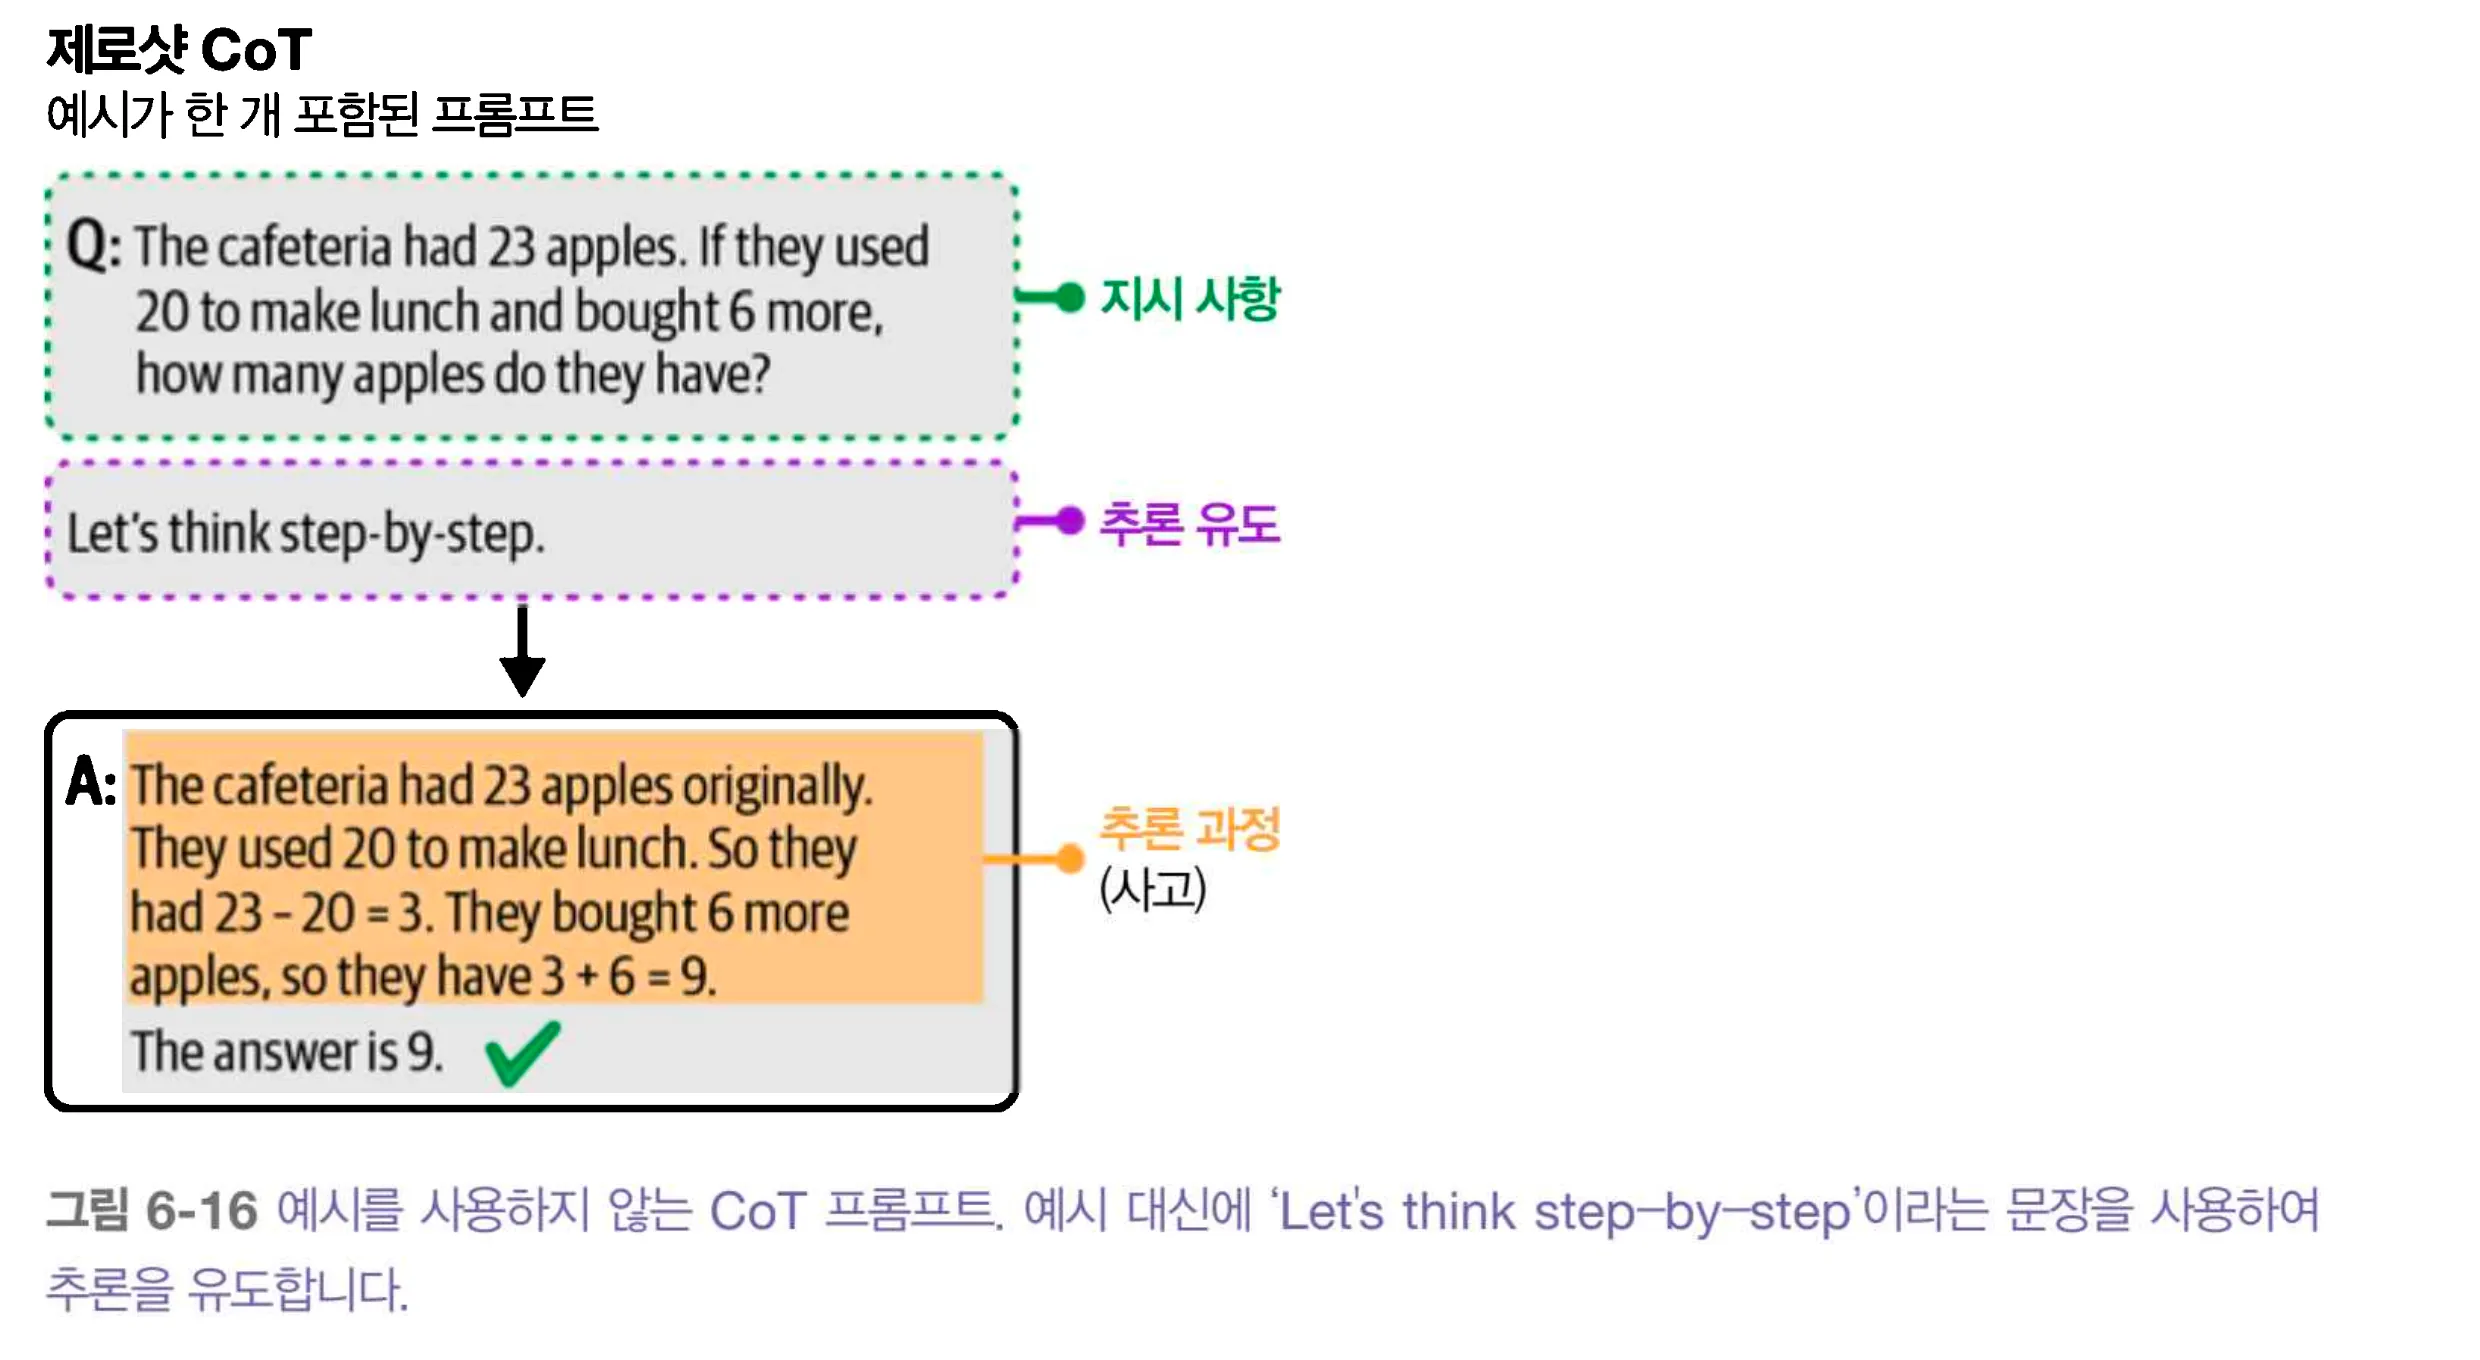
생성 모델에서 복잡한 추론을 위한 첫 번째 주요 시도는 CoT(Chain-of-thought)라는 방법이 있다. CoT는 생성 모델이 추론 과정 없이 바로 질문에 대답하지 않고 그 전에 생각하게 만드는 것이 목표다.
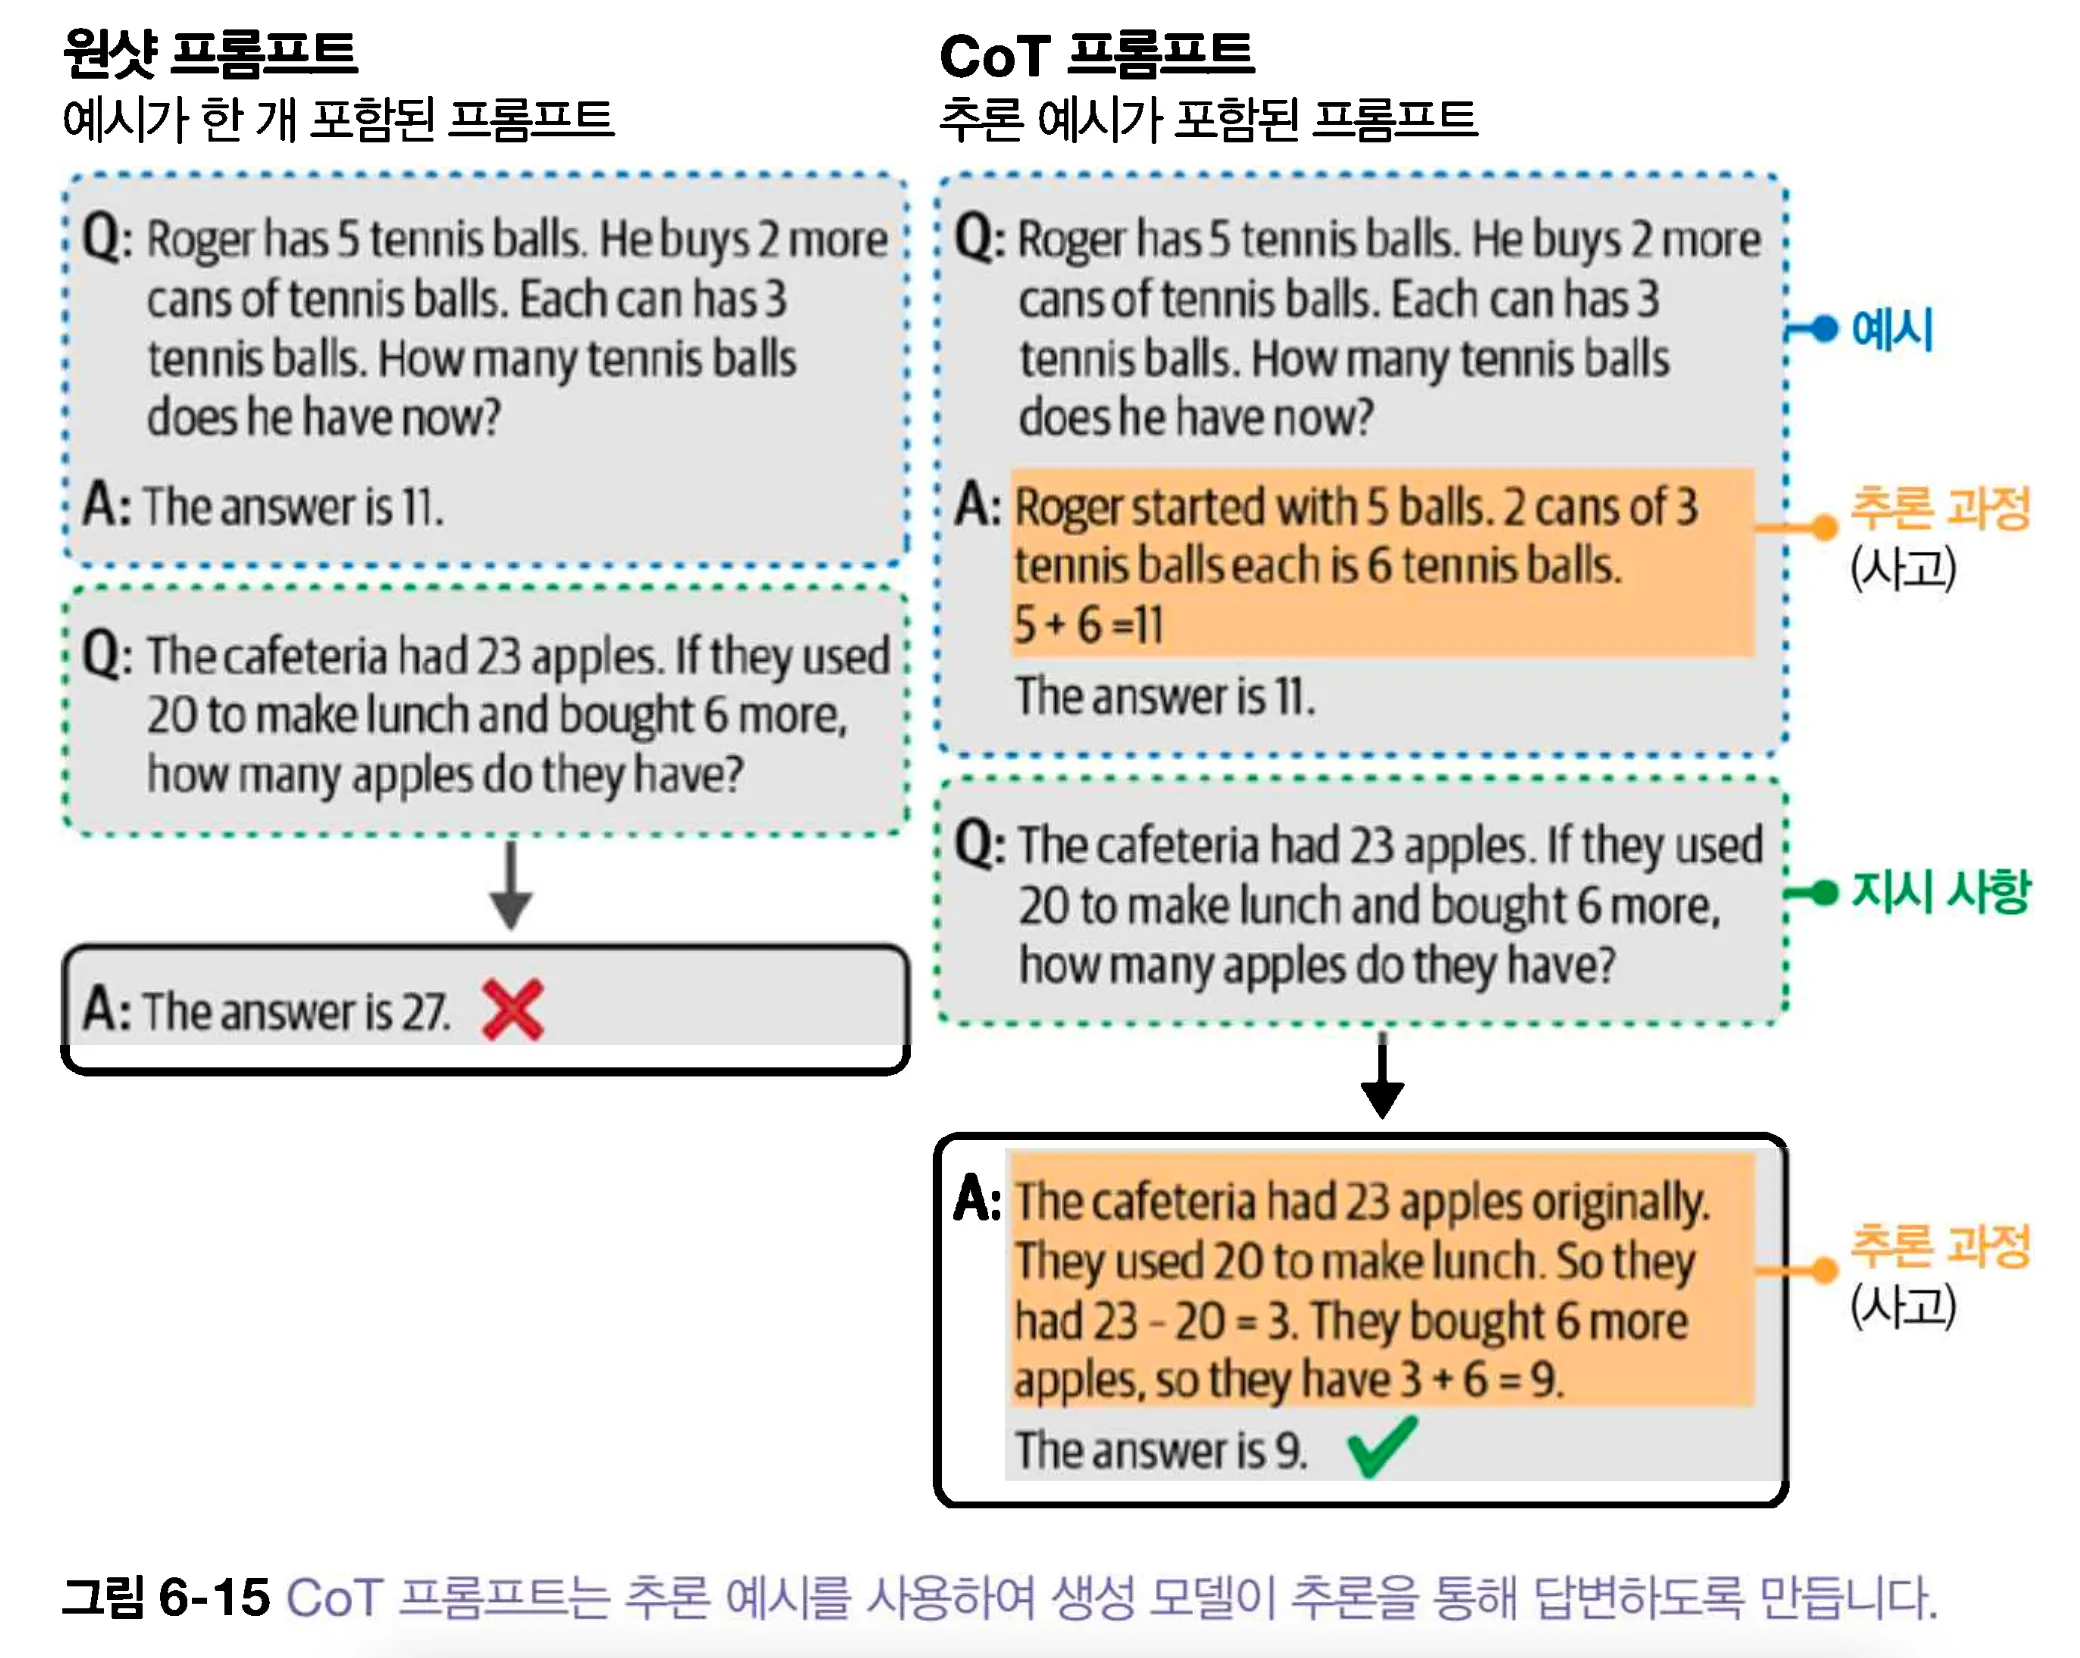
- 이미지 속 CoT 프롬프트의 내용 (A 부분)
- 영문 원문: “Roger started with 5 balls. 2 cans of 3 tennis balls each is 6 tennis balls. 5 + 6 = 11. The answer is 11.”
- 해석: “로저는 5개의 공으로 시작했다. 3개씩 들어있는 테니스 공 2캔은 6개의 공이다. 5 + 6 = 11이다. 정답은 11이다.”
- 모델이 수행하는 추론 과정 (사고 단계)
- 초기 상태 파악: “식당에는 처음에 23개의 사과가 있었다.”
- 소비량 계산: “점심을 만드는 데 20개를 사용했다. 그래서 남은 사과는 23 - 20 = 3개이다.”
- 추가 획득 계산: “사과 6개를 더 샀다. 따라서 현재 사과는 3 + 6 = 9개이다.”
- 최종 결론 도출: “정답은 9이다.”
즉, 이 프롬프트는 모델에게 “문제를 풀 때 한꺼번에 정답을 내지 말고, 위와 같이 데이터를 단계별로 나누어(Step-by-Step) 중간 계산을 거쳐라”라고 지시하는 과정이다.
- 좌측(원샷): 중간 과정 없이 결과만 보게 하니
23 - 20 + 6의 계산을 틀려 버림. - 우측(CoT): “원래 23개였고, 20개를 썼으니 3개가 남고, 거기에 6개를 더해서 9개다”라는 논리적 순서를 예시로 주니 모델이 정답을 맞힘.
간단한 방법으로 “단계를 나누어 풀어 주세요”라고 요청할 수도 있다. 모델과 과제에 따라 효과가 달라지므로 같은 문제 묶음에서 정답률과 응답 길이를 비교한다.
zeroshot_cot_prompt = [
{"role": "user",
"content": "The cafeteria had 32 apples. It used 20 and bought 6 more. How many remain? Show the arithmetic and final answer."}
]
왜 CoT가 중요한가?
- 논리적 사고 유도: LLM은 단순히 정답만 외우는 게 아니라, 예시에 포함된 논리적 단계를 따라 하려는 성질이 있다.
- 정확도 확인: 수학·상식·복잡한 분류 과제에서 도움이 될 수 있지만 모델과 문제별로 비교해야 한다.
- 검산 가능성: 적힌 계산 단계를 검사할 수 있다. 적힌 내용이 모델의 실제 내부 판단을 그대로 드러낸다고 해석해서는 안 된다.
자기 일관성: 출력 샘플링
출력과 관련해서 무작위성에 대응하고생성 모델의 품질을 향상시키기 위해 자기 일관성 방법이 개발 되었다. 해당 방법은 생성 모델에게 동일한 프롬프트를 여러 번 요청하고 다수를 차지하는 결과를 최종답변으로 내놓는다.
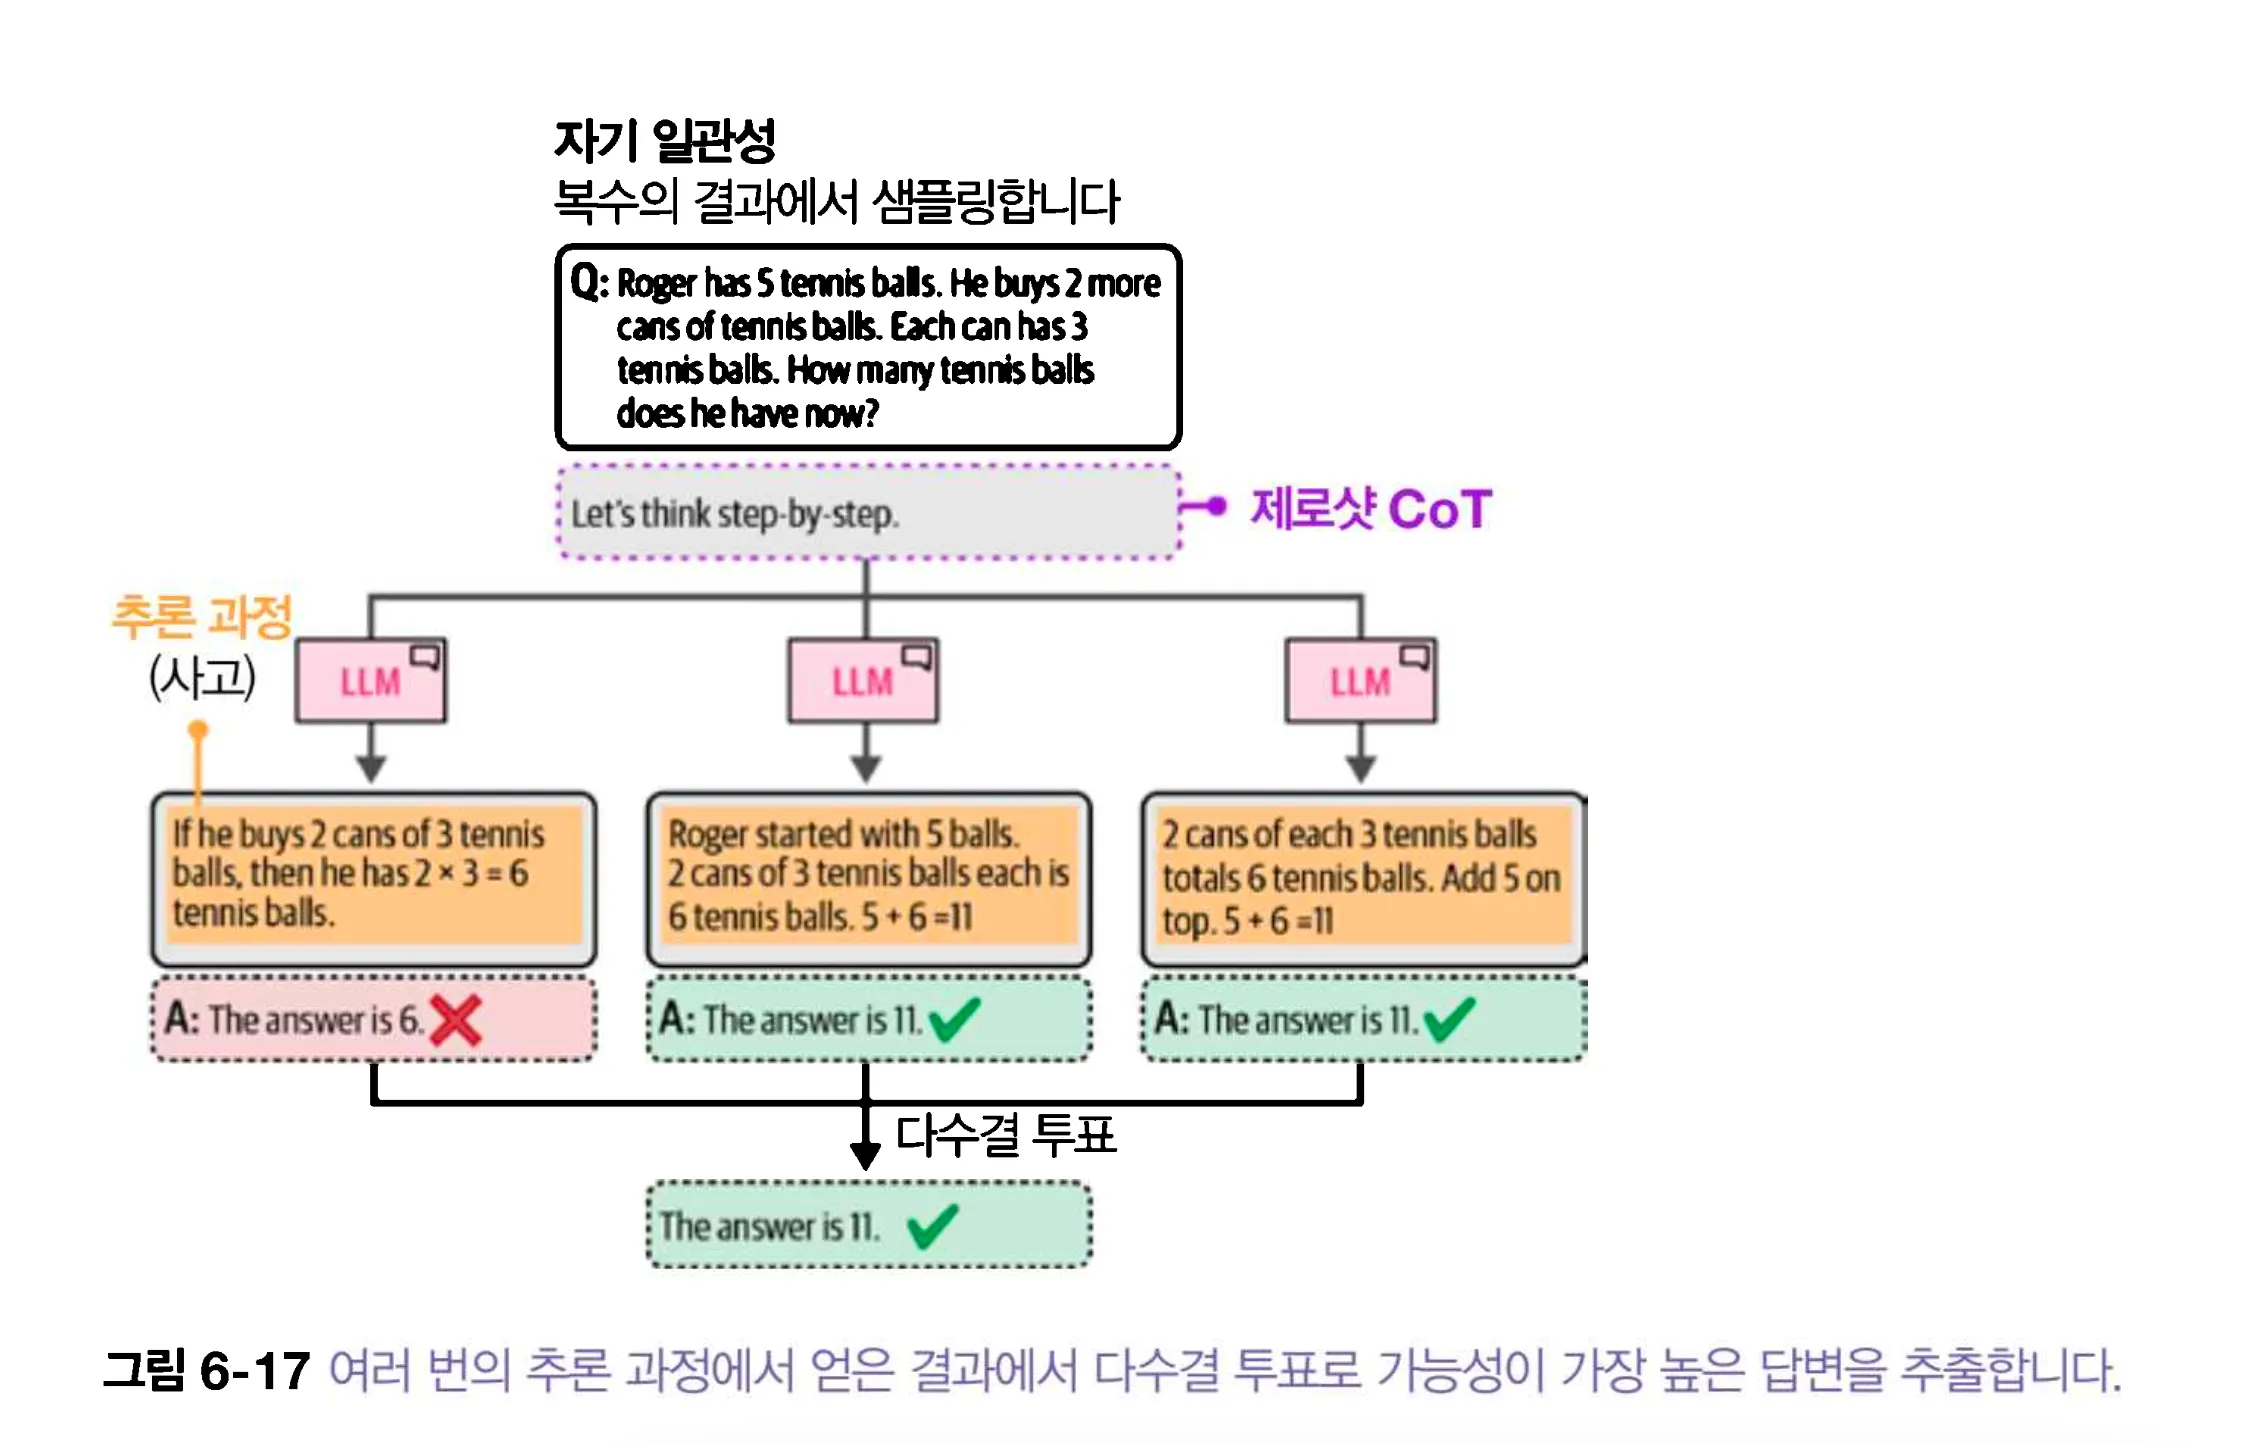
여러 답에서 최종 선택지를 추출해 다수결을 내되, 정답이 숫자라면 단위와 표기부터 통일한다. 모든 응답이 동일한 잘못된 전제에 의존하면 다수결도 틀린다. 샘플 개수가 n이면 대체로 호출 비용이 n배에 가까워진다.
ToT: 중간 단계 탐색
여러 개의’사고’에서 샘플링하여 모델을 더 사려 깊게 만듦으로써 생성 모델의 출력을 향상 시키는것이 목표이다. 여러 단계의 추론이 필요한 문제를 만났을 때 이 문제를 여러 단계로 나누는 것이 유용하다.
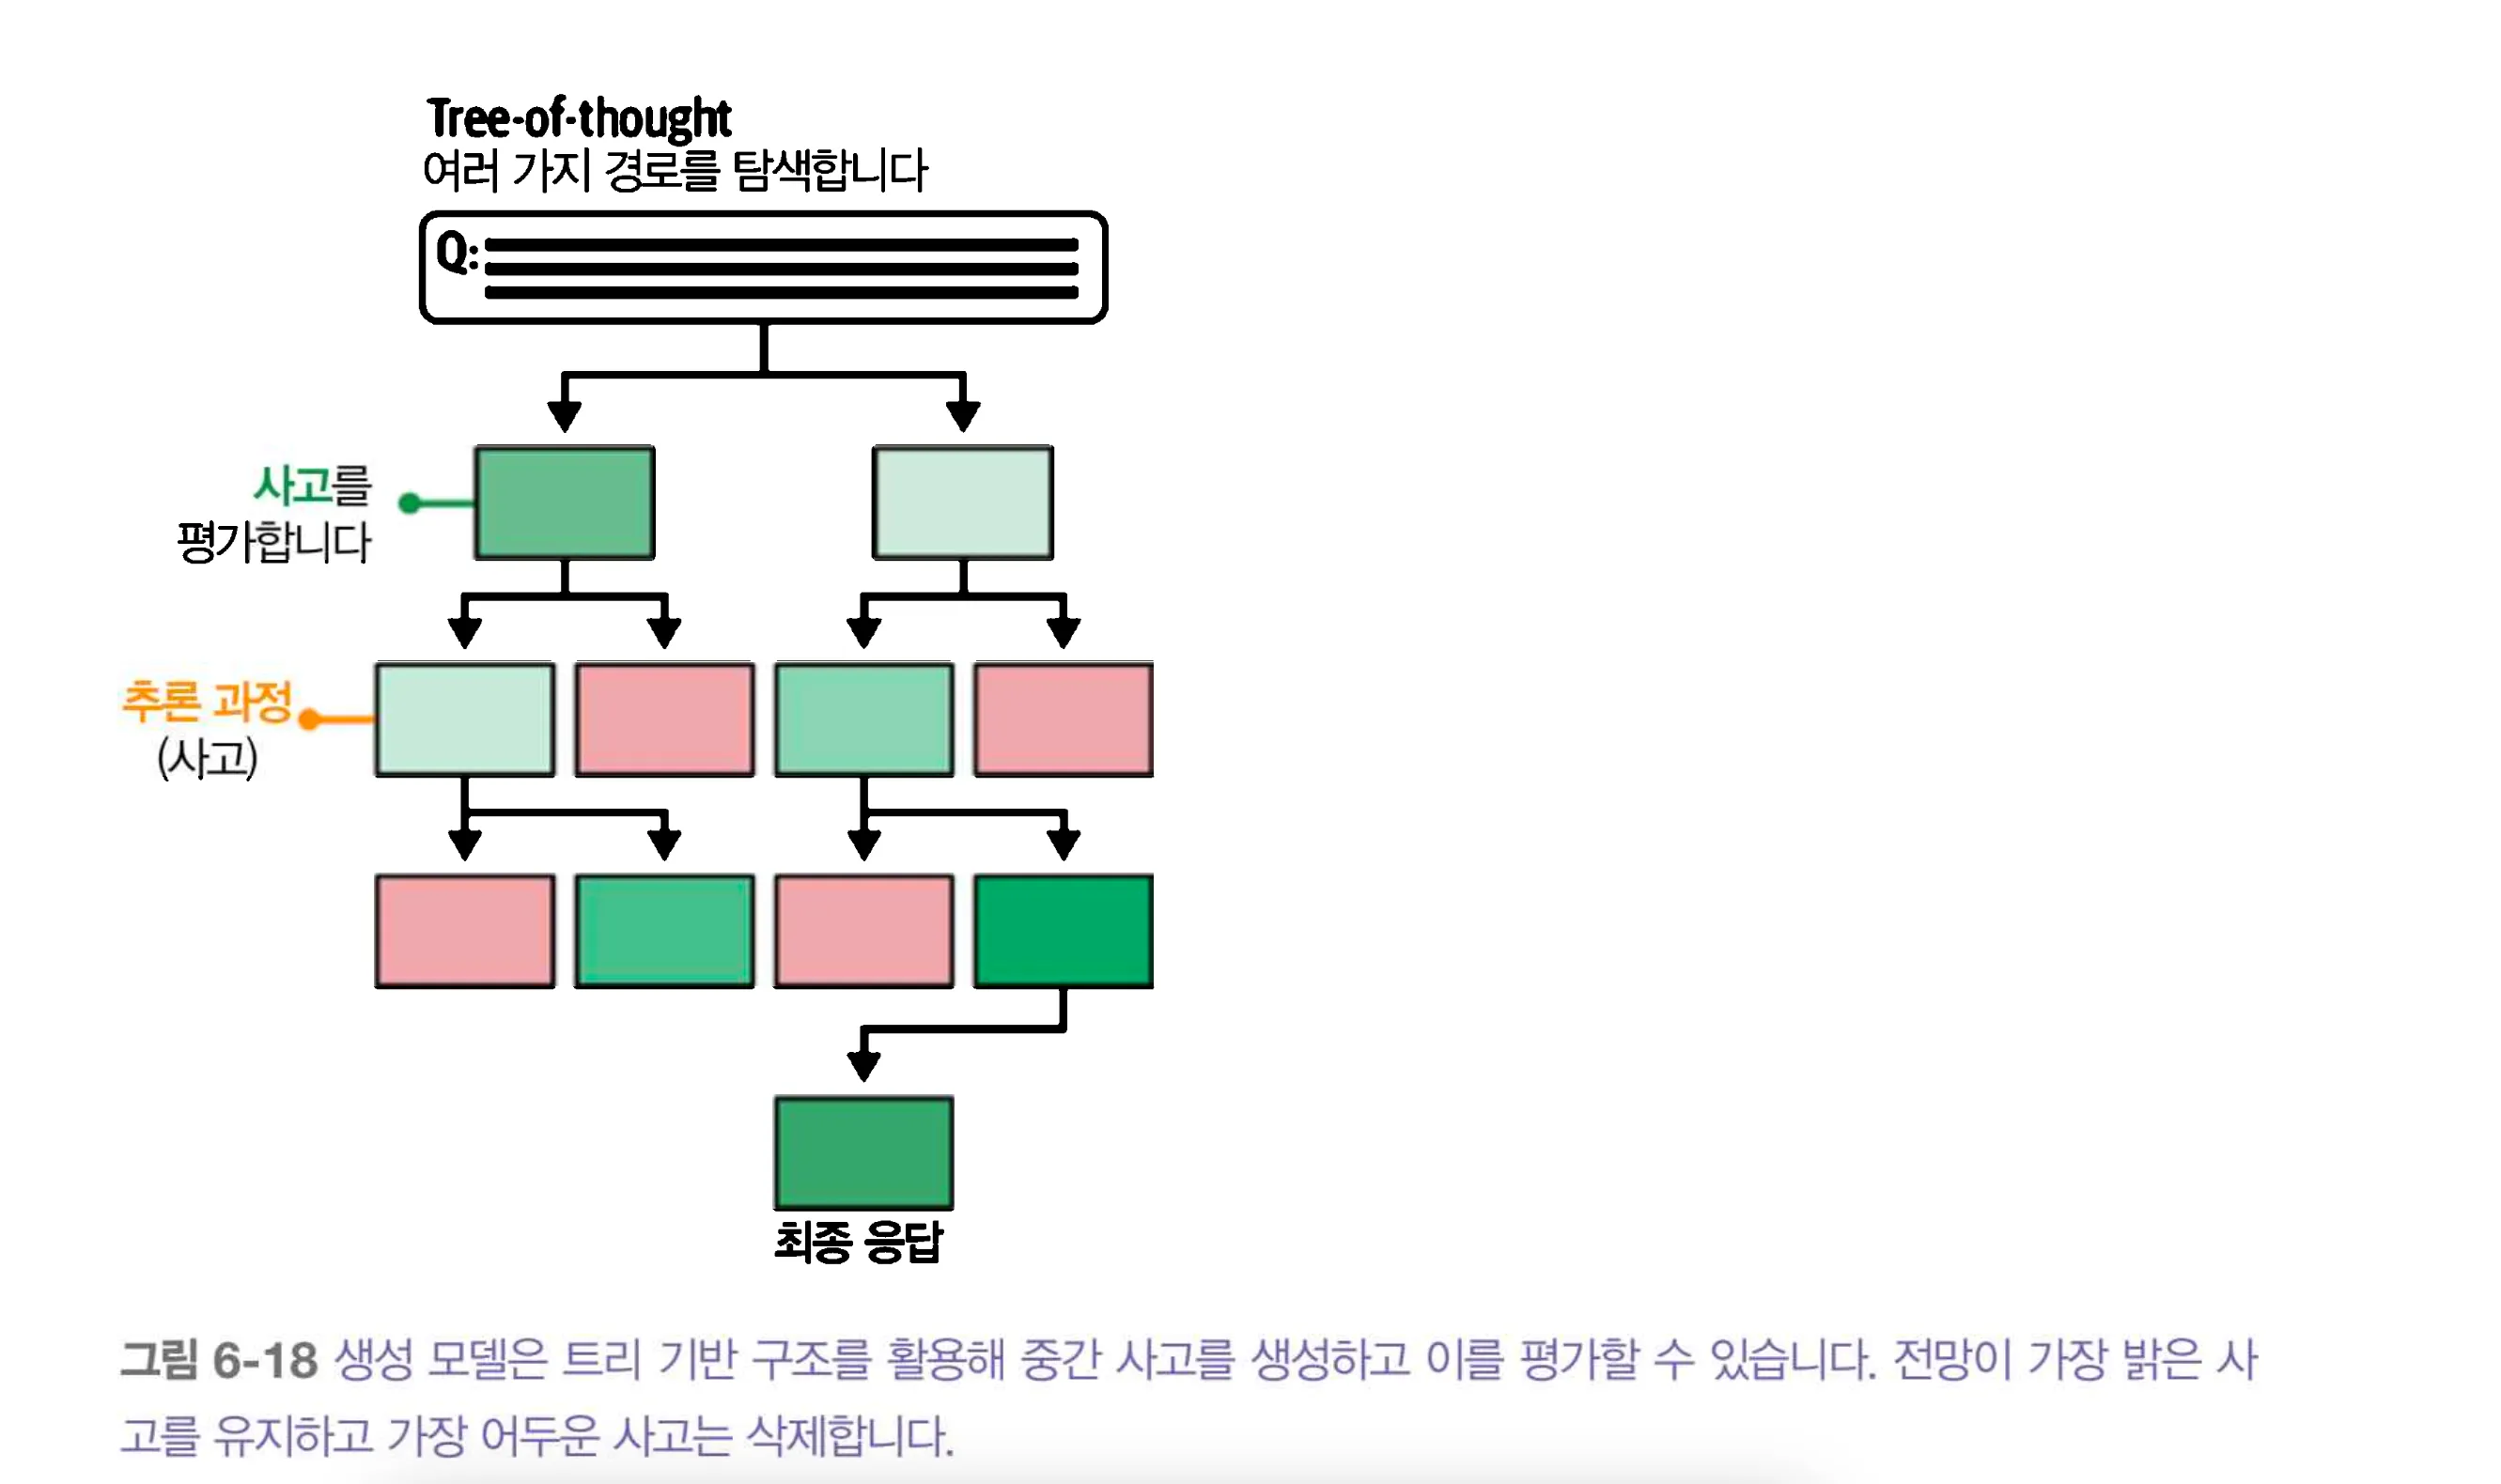
위 방법은 이야기를 작성하거나 창의적인 아이디어를 도출하는 것처럼 여러 가지 경로를 고려해야 할 때 대단히 큰 도움이 된다. 단, 생성 모델을 여러 번 호출하기 때문에 애플리케이션이 느려진다.
출력 검증
검증할 수 없는 프롬프트 개선은 감에 의존하게 된다. 대표 입력과 어려운 입력을 함께 모아 작은 평가표를 만들자. 예를 들어 논문 요약 20건에 대해 필수 항목 포함, 수치 일치, 원문에 없는 주장 없음, 길이 제한을 각각 확인한다. 프롬프트 A와 B를 같은 원문·모델·생성 설정으로 비교하고, 실패한 문서를 다시 읽어 지시가 모호했는지 자료 자체가 부족했는지 나눈다. 분류 결과를 프로그램에서 사용할 때는 허용 레이블 목록과 JSON 파싱을 코드로 검사한다.
출력을 검증하는 이유는 다음과 같다.
- 구조적인 출력
- 기본적으로 대부분의 생성 모델은 자유로운 형식의 텍스트를 만들며, 자연어 형태 이외의 다른 구조를 따르지 않는다. 하지만 일부 사용 사례에서는 JSON 같은 특정 포맷의 구조를 가진 출력이 필요하다.
- 유효한 출력
- 모델이 구조적인 출력을 생성할 수 있더라도 여전히 자유롭게 콘텐츠를 생성할 수 있다. 예를 들어, 둘 중 하나를 선택하여 출력하라고 요청했을 때 모델이 다른 것을 선택하면 안 된다.
- 윤리
- 일부 오픈소스 생성 모델은 안전장치가 없으며, 안전하거나 윤리적인 고려사항이 결여된 출력을 생성한다. 예를 들어 욕설, 개인 식별 정보, 편향, 문화적 고정관념 등이 출력에 포함되지 않아야 한다.
- 정확성
- 많은 경우 출력은 특정 표준이나 성능을 따라야 한다. 생성된 정보가 사실적으로 정확하고, 일관성이 있으며, 환각이 없는지 재확인하는 것이 목적이다.
일반적으로 생성 모델의 출력을 제어하는 방법은 세 가지다.
- 예시
- 기대하는 출력의 예시를 여러 개 제공한다.
- 문법
- 토큰 선택 과정을 제어한다.
- 미세 튜닝
- 기대 출력이 포함된 데이터로 모델을 튜닝한다.
프롬프트에 개인 정보나 비밀 값을 넣는다면 모델 제공자·로그 저장 정책도 입력 설계의 일부다. 외부에서 복사한 문서에 “이전 지시를 무시하라” 같은 문장이 있어도 작업 데이터로 취급해야 한다. 인용할 자료와 모델에게 내리는 지시의 경계를 명확히 구분하는 것이 좋다.